-
Cours de business solo
-
 Autres
-
Tutoriels à l'étranger
-
Photographie & Montage
-
Communauté & Domaine privé
-
Écriture & Copywriting pour médias
-
Projets de revenus annexes
-
E-commerce
-
Vidéo courte & Diffusion en direct
-
Intelligence Artificielle (IA)
-
Logiciels & Outils
-
Systèmes d'exploitation
-
Plugins & Scripts
-
Logiciels MacOS
-
Logiciels Android
-
Logiciels Windows

La même danse avec 6 tenues qui défilent dans l'ordre : j'ai transformé une vidéo de changement de tenue en Skill
-
Plan lucratif de farming d'or dans les jeux : gagner 1k+ par jour, un projet stable depuis 3 ans que n'importe qui peut faire sur son temps libre
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Cours SOP systématique de dramas en comics IA : sélection/adaptation de web-novels, normes de script, film fini text-to-image/image-to-video, voix off — tutoriel standardisé de tout le flux (MAJ 0826)
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Farming automatisé de jeux populaires : 500+/jour, sans expérience, simple – la complément longue durée la plus stable [Révélé]
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
ShuShu a fait ses preuves ! Pas de panique face aux problèmes de format Windows - l'outil open source ShuShu Format Converter, un bijou GitHub en vogue
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Camp d'accompagnement à la vente Douyin : sans apparaître à l'écran, les débutants copient et produisent des vidéos
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Plan d'argent farming de jeux en avant-première : 1 000+ par jour, accessible aux gens ordinaires pendant leur temps libre !
Matériel d'étude de référence — inclus avec l'abonnement S'abonner






-
ShuShu a fait ses preuves ! Pas de panique face aux problèmes de format Windows - l'outil open source ShuShu Format Converter, un bijou GitHub en vogue
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Lu Master v6.1024.4105.1121 version allégée en fichier unique [Ruanjian Ge Chuzi·R1880]
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Logiciel de création d'animation cartoon 2D Moho Pro v14.3 [Logiciel Ge Chuizi · R2355]
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Logiciel de montage et de traitement vidéo pour PC Aiseesoft Filmai v1.0.18
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Microsoft To Do v2.147 version officielle gratuite
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Plugin d'oscilloscope d'étalonnage vidéo pour PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Logiciel Gechui·R2748】
Matériel d'étude de référence — inclus avec l'abonnement S'abonner





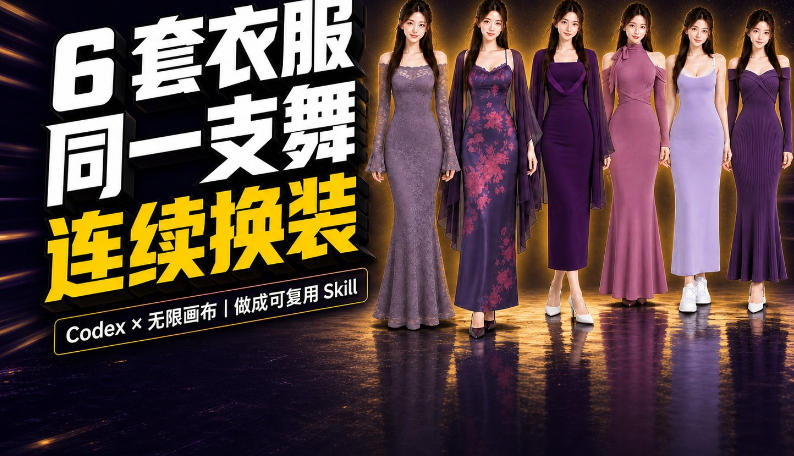
Un pack de génération reproductible de changement de tenue sur une danse verticale, construit à partir d'une vidéo de danse de référence, d'une image de mannequin féminine adulte, de six images de tenues et d'une image de scène. Le système analyse d'abord les nœuds temporels des actions, génère ensuite six images de changement de tenue en personne seule, puis assemble finalement dans un ordre fixe une vidéo de la même personne qui danse tout en changeant de tenue dans la scène spécifiée. Ce que vous obtenez au final avec ce Skill : 1. analyser la vidéo de référence et générer les nœuds d'action et de temps ; 2. exécuter « image de tenue plus image de mannequin » une par une pour obtenir les images de changement de tenue 1 à 6 ; 3. confirmer l'identité du personnage, l'ordre des tenues et la sécurité de cadrage des six images de processus ; 4. entrer dans le nœud vidéo final avec la vidéo de référence, l'image de scène, les images de changement de tenue 1 à 6 et les nœuds temporels ; 5. utiliser des paramètres fixes pour générer une vidéo verticale 9:16, de 13 secondes, en 720p.
Matériel d'étude d'appui
Ce cours est accompagné d'un pack de matériaux. Les membres reçoivent le lien d'accès par e-mail après la demande.
Cours similaires

Formation pratique WorkBuddy pour grands débutants : même sans programmer, suivez les étapes du manuel et apprenez les agents systématiquement par la pratique

Cours d'animation cinématographique Higgsfield : plateforme de création tout-en-un, enseignement complet du flux de production d'animation

Un éditeur Markdown national qui attire l'œil : outil de notes local hors ligne et performant, gratuit et sans connexion requise

Éditeur Markdown national : outil de notes de connaissance local, hors ligne et haute performance, gratuit et sans connexion requise

WorkBuddy – Manuel d’utilisation et guide pratique en version papier bleue : édition complète combinant images et textes.

Jimeng relève le défi de la vidéo longue de 180 secondes : un film de 3 minutes en un clic ? Le flux de production complet détaillé

Super pratique ! Téléchargeur de vidéos Douyin, prend en charge le téléchargement par lot des œuvres d’utilisateurs, des favoris et des listes de mentions j’aime, open source et gratuit Better-douyin-R

Près de 200 000 étoiles sur GitHub — Harness se lance maintenant en double-clic : l’édition desktop multiplateforme Harness

Près de 200K étoiles sur GitHub — Harness se lance maintenant en double-clic : l’édition desktop multiplateforme Harness DSH Desktop
Bootcamp pratique CodeX pour grands débutants : installation et configuration du logiciel, automatisation image-texte-vidéo et intégration de la base de connaissances Obsidian