


-
Solounternehmens-Kurse
-
 Sonstiges
-
Auslandskurse
-
Fotografie & Schnitt
-
Community & Private Domain
-
Schreiben & Texten für Medien
-
Nebenverdienst-Projekte
-
E-Commerce
-
Kurzvideos & Live-Streaming
-
Künstliche Intelligenz (KI)
-
Software & Tools
-
Betriebssysteme
-
Plugins & Skripte
-
MacOS-Software
-
Android-Software
-
Windows-Software


Multifunktionales Bildgenerierungsmodell-Komplettpaket OmniGen, kostenlos und Open Source, Start mit einem Klick, keine Bereitstellung oder Lizenzierung nötig (Software-Hammer - R2255)
-
Goldfarming-Geldverdienplan für Spiele: täglich über 1.000 verdienen – ein stabiles 3-Jahres-Projekt, das jeder in der Freizeit umsetzen kann
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
AI-Comic-Drama-SOP-Systemkurs: Web-Novel-Auswahl und -Adaption, Drehbuchnormen, Text-zu-Bild/Bild-zu-Video-Fertigfilm, Voice-over und Schnitt – standardisiertes Full-Flow-Umsetzungs-Tutorial (Update 0826)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Hot-Game-vollautomatisiertes Verdienen: 500+ pro Tag, keine Erfahrung, einfache Bedienung – das stetigste langfristige Game-Verdienst-Nebenprojekt (enthüllt)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Douyin-Verkaufs-Begleitcamp: kein echtes Auftreten nötig, Anfänger kopieren Vorlagen und produzieren Verkaufsvideos
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Premier-Game-Farming-Geldplan: 1.000+ täglich, für Normalverdiener in der Freizeit machbar! [Enthüllung]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten






-
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Lu Master v6.1024.4105.1121 schlanke Single-File-Version [Software Ge Chuzi · R1880]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Software zur Erstellung zweidimensionaler Cartoon-Animationen Moho Pro v14.3 [Software Gezhi Chuzi · R2355]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PC-Videobearbeitungssoftware Aiseesoft Filmai v1.0.18 【Software Gezhi·R2470】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Microsoft To Do v2.147 Offizielle kostenlose Version [Software Gechui·R2618]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PR/AE/DaVinci/FCPX Video-Farbkorrektur-Oszilloskop-Plugin Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Gechui·R2748】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten





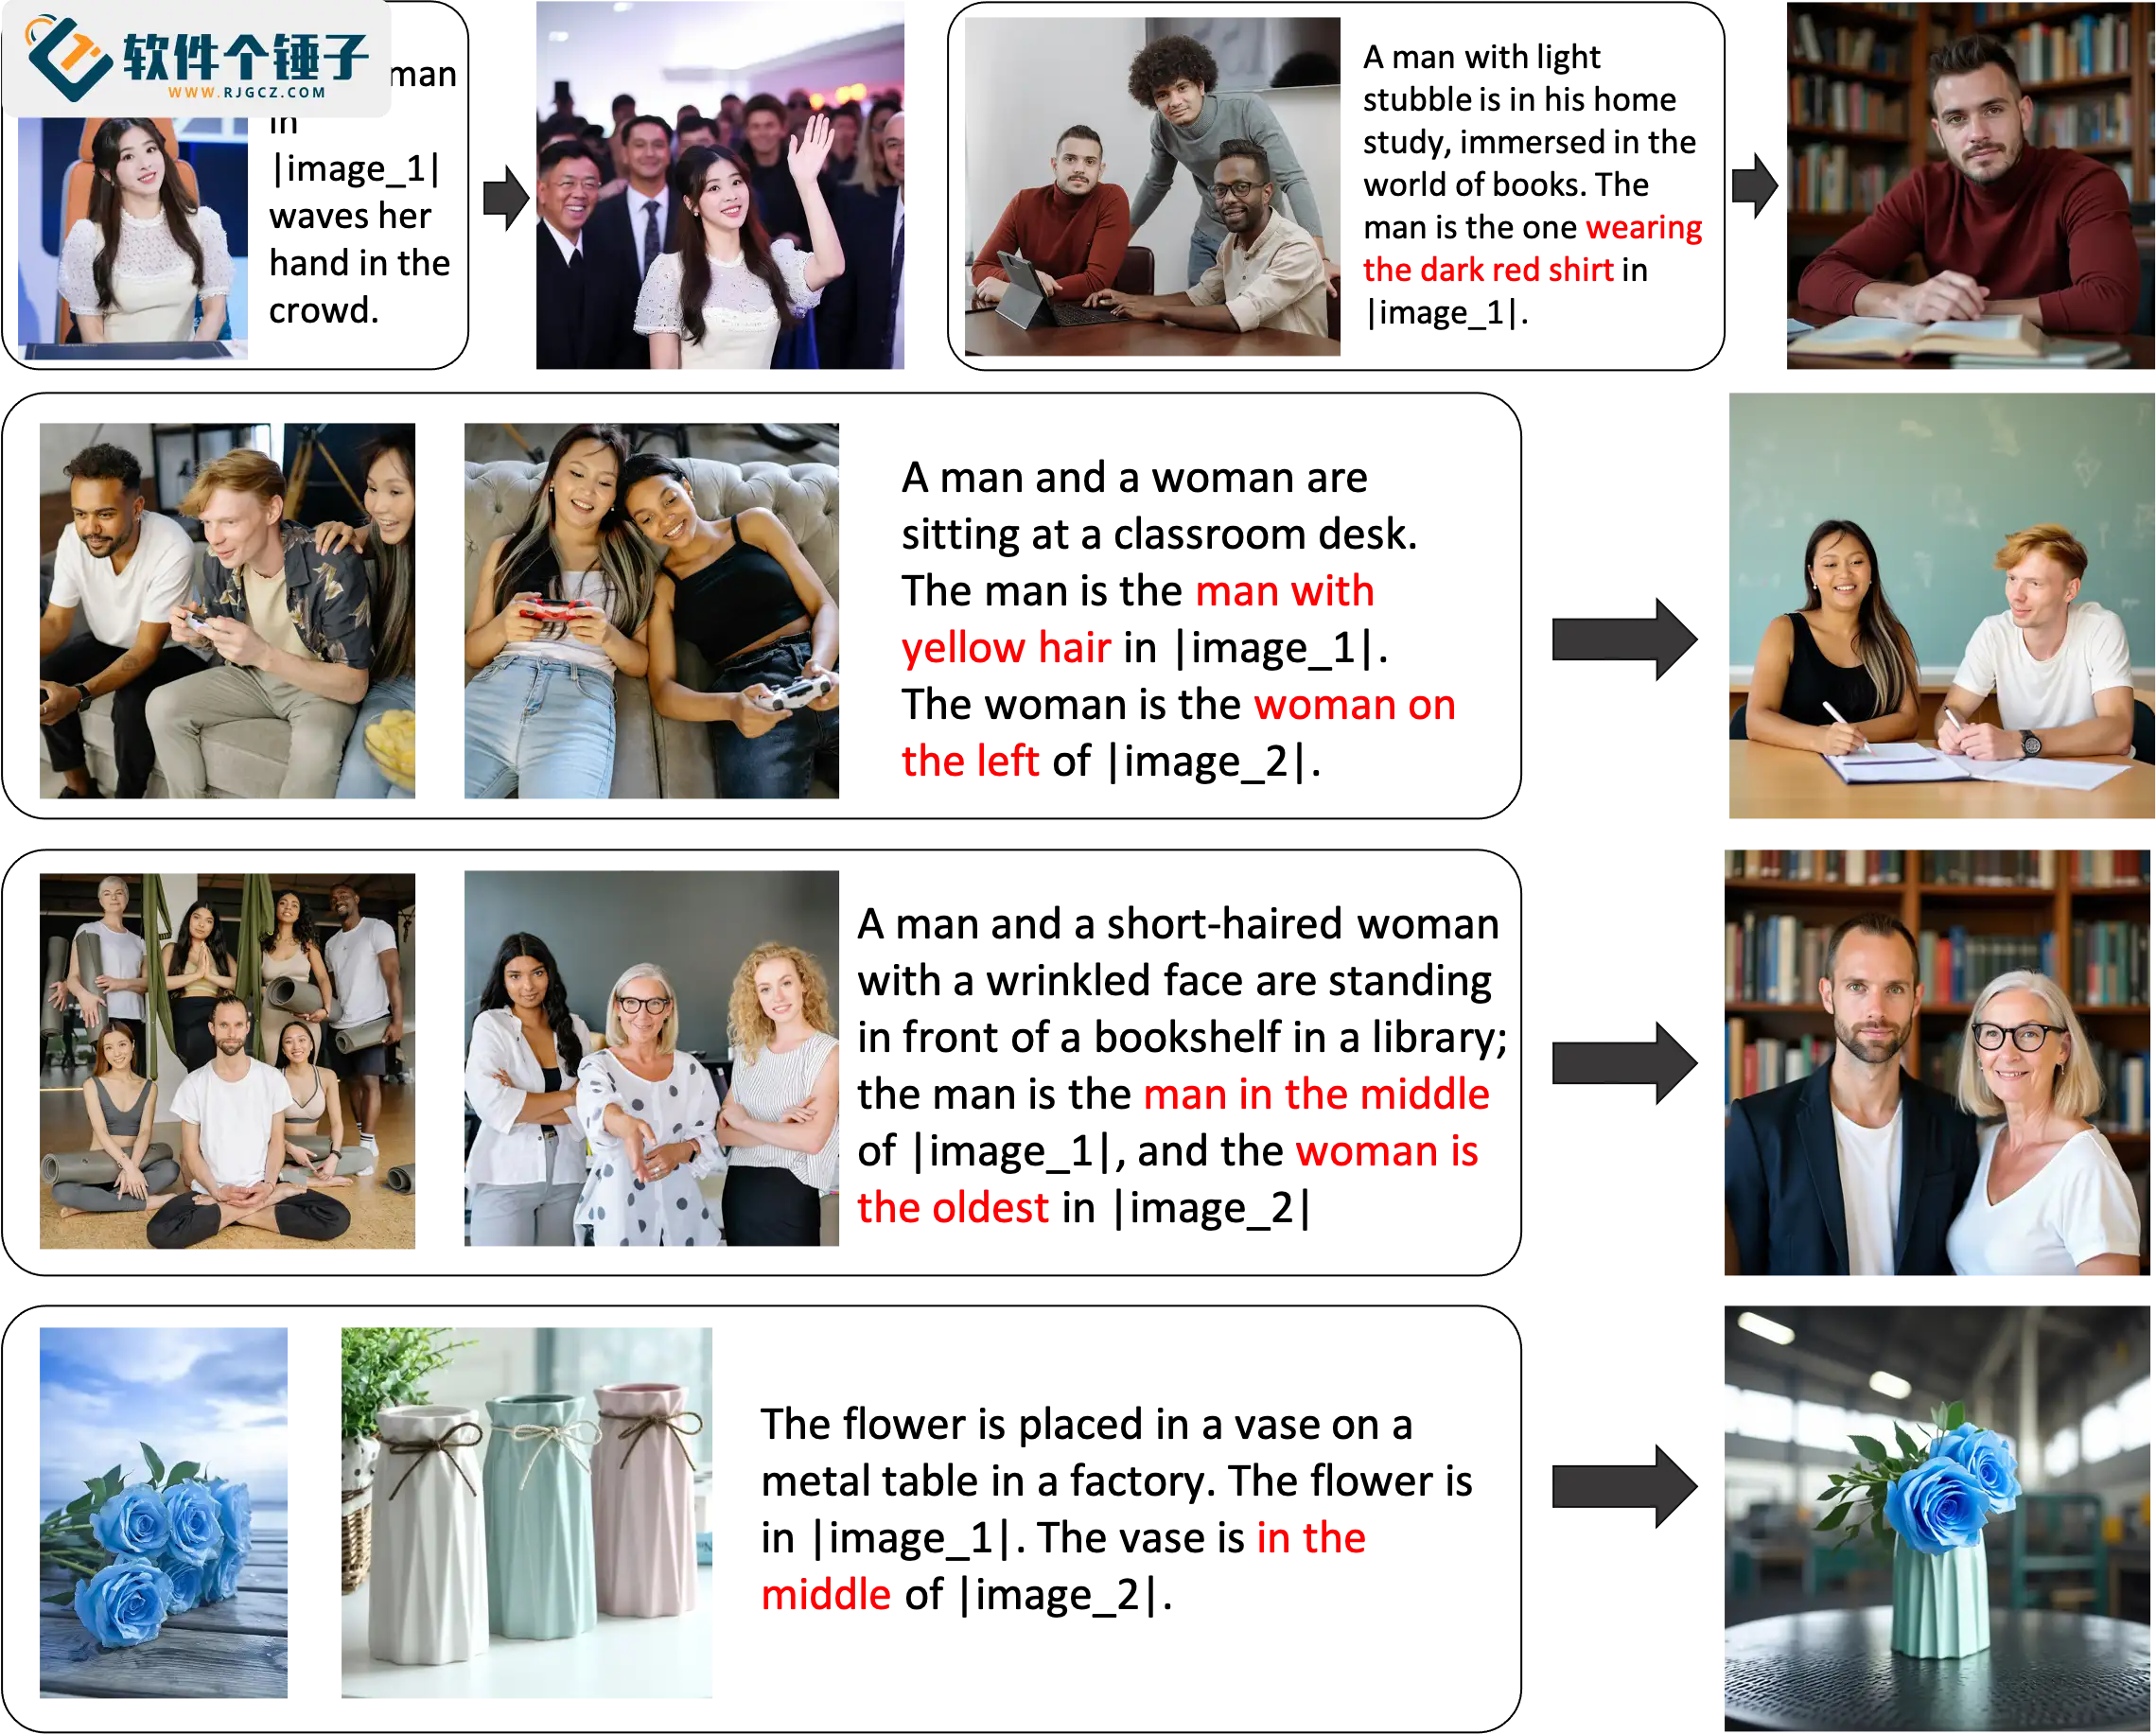
OmniGen ist eine von BAAI vorgestellte neuartige Diffusionsmodell-Architektur, die sich auf die einheitliche Bilderzeugung konzentriert. Sie vereinfacht den komplexen Ablauf der Bilderzeugung und verarbeitet mit einem einzigen Framework verschiedene Aufgaben wie Text-zu-Bild, Bildbearbeitung und die Erzeugung auf Basis visueller Bedingungen. Darüber hinaus ermöglicht OmniGen durch eine einheitliche Lernstruktur den Wissenstransfer und kann sich so an unterschiedliche Aufgaben und Domänenanforderungen anpassen. Das Modell ist nicht nur hochgradig vereinfacht und benutzerfreundlich, sondern zeigt im Bereich der Bilderzeugung auch eine starke Flexibilität.

Software-Merkmale:
Einheitlichkeit: OmniGen kann verschiedene Aufgaben der Bilderzeugung integriert verarbeiten, darunter Text-zu-Bild, themengesteuerte Erzeugung, Bildbearbeitung und Erzeugung auf Basis visueller Bedingungen. Die Innovation liegt darin, traditionelle Aufgaben der Computer Vision in Aufgaben der Bilderzeugung umzuwandeln und so ein integriertes Erlebnis der Bilderzeugung zu bieten.
Einfachheit: OmniGen verzichtet auf die bei anderen Modellen üblichen umständlichen Abläufe und benötigt keine Plugin-Unterstützung wie ControlNet oder IP-Adapter, wodurch die Aufgabenverarbeitung intuitiver wird. Nutzer können komplexe Aufgaben mit knappen Anweisungen erledigen, was die Einstiegshürde enorm senkt.
Wissenstransfer: Durch Lernen in einem einheitlichen Format kann OmniGen Wissen zwischen verschiedenen Aufgaben übertragen, was besonders für unbekannte Aufgaben oder Domänen geeignet ist. Dabei untersucht OmniGen die Anwendung des Mechanismus der Gedankenkette und verleiht ihm so eine flexiblere Argumentations- und Kontextlernfähigkeit bei der Bilderzeugung.
Softwarefunktionen:
Text-zu-Bild: Aus einer Textbeschreibung wird ein entsprechendes Bild erzeugt.
Bildbearbeitung: Bilder werden nach den Wünschen des Nutzers teilweise oder vollständig bearbeitet.
Konsistente Zeichenerzeugung: Das Aussehen einer Figur bleibt über mehrere Bilder hinweg gleich.
Erzeugung auf Basis visueller Bedingungen: Anhand visueller Bedingungen wie Pose oder Kanteninformationen werden Bilder erzeugt, die bestimmten Anforderungen entsprechen.
Systemanforderungen:
Empfohlene Computerkonfiguration:
Betriebssystem: Windows 10/11 64 Bit
Grafikkarte: 8 GB VRAM sind nutzbar, die Erzeugung ist dann aber eher langsam; empfohlen wird eine NVIDIA-Grafikkarte mit mehr als 8 GB VRAM,
CUDA >= 11.8
Das gesamte Paket umfasst nach dem Entpacken etwa 24,5 GB, ausreichend Festplattenspeicher sollte vorhanden sein
Falls CUDA auf dem Computer nicht installiert ist, finden Sie die Installationsanleitung unter:
So prüfen Sie Marke, Modell und VRAM der Grafikkarte:
Task-Manager öffnen
Auf "Leistung" klicken
Auf "GPU" klicken
Oben rechts ist das Grafikkartenmodell zu sehen, darunter die Größe des VRAM

Anleitung:
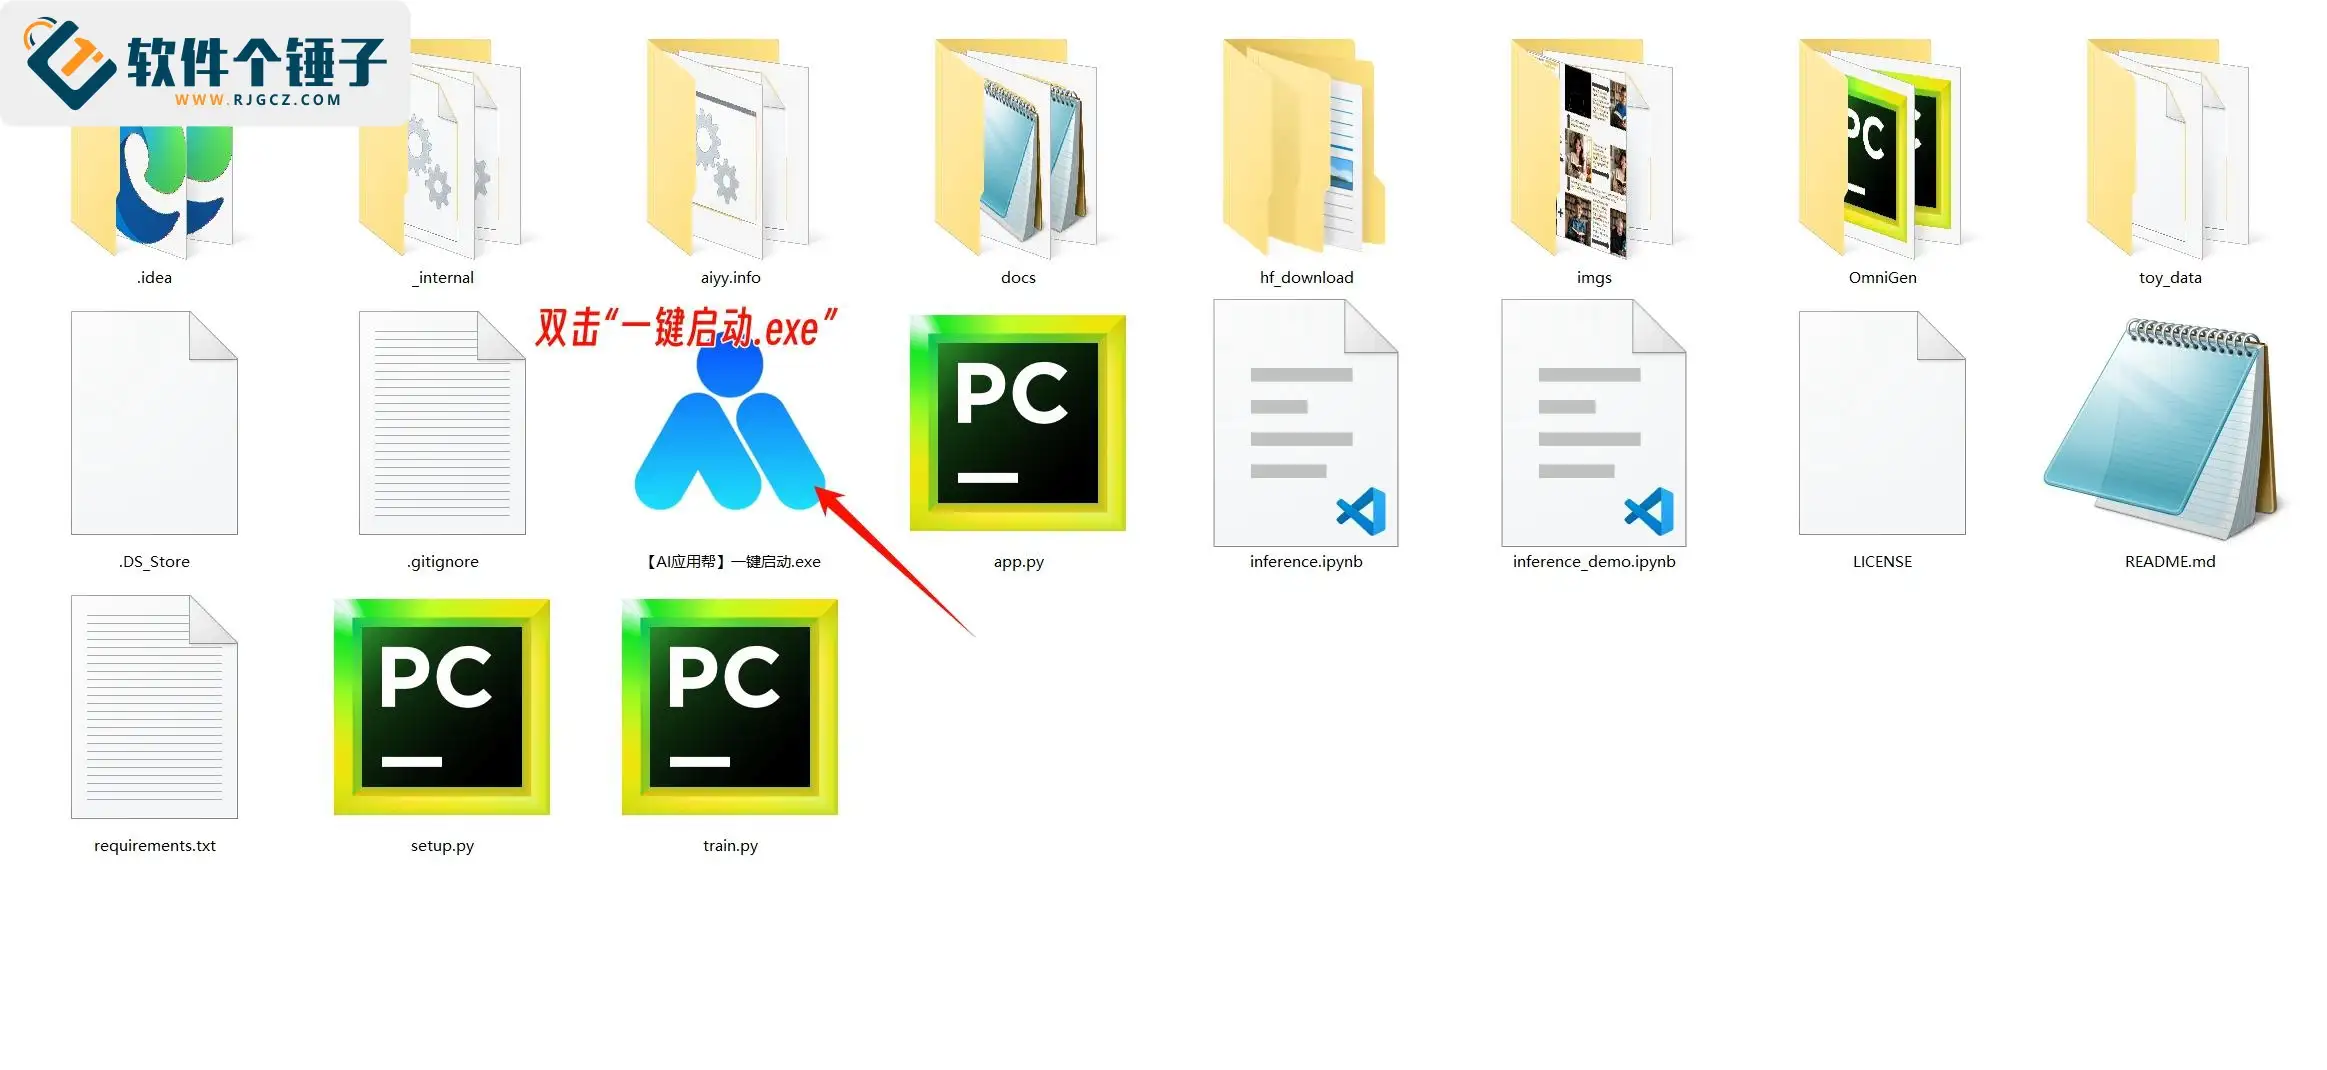
① Integrationspaket herunterladen und anschließend entpacken;
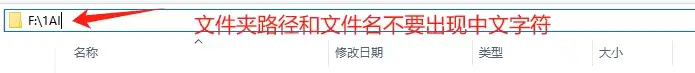
Hinweis: Im Ordnerpfad und in Dateinamen (einschließlich der Namen von Audiodateien, Bildern, Videos usw.) dürfen keine chinesischen Zeichen vorkommen, da sonst manche Software sie nicht erkennt und Fehler meldet

② Doppelklick auf "Ein-Klick-Start.exe", kurz warten, dann öffnet sich die Bedienoberfläche automatisch im Browser

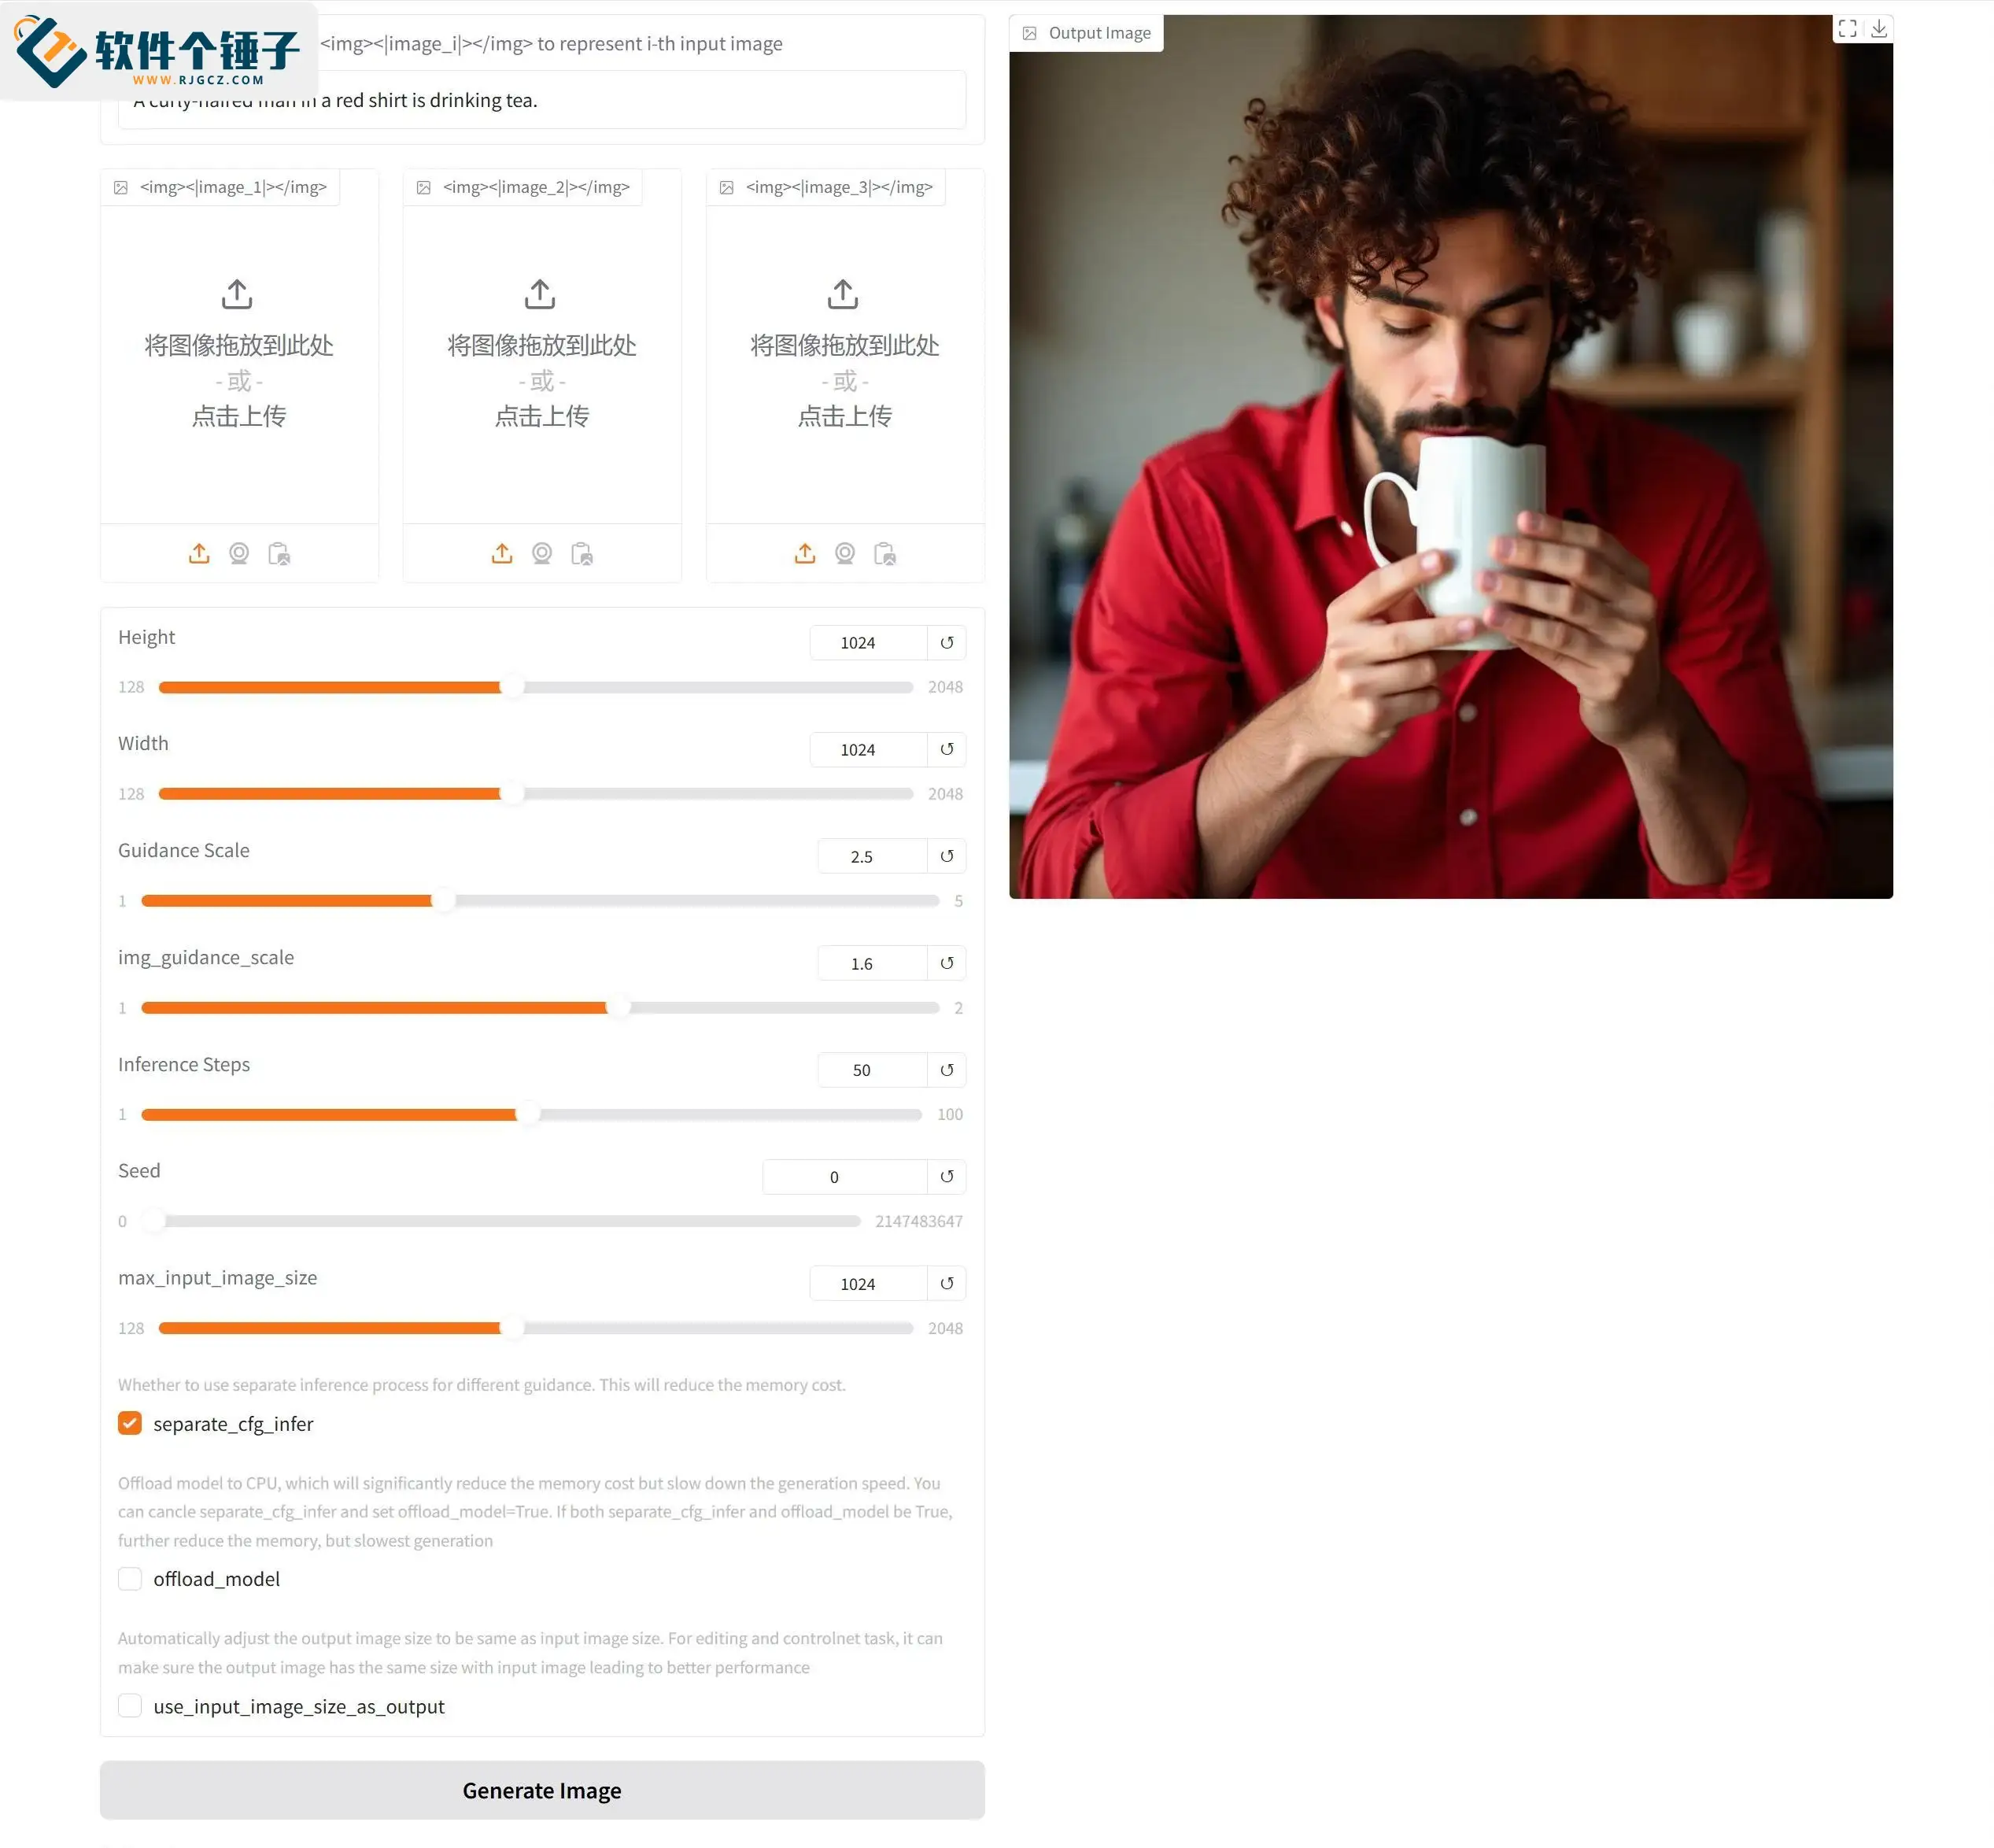
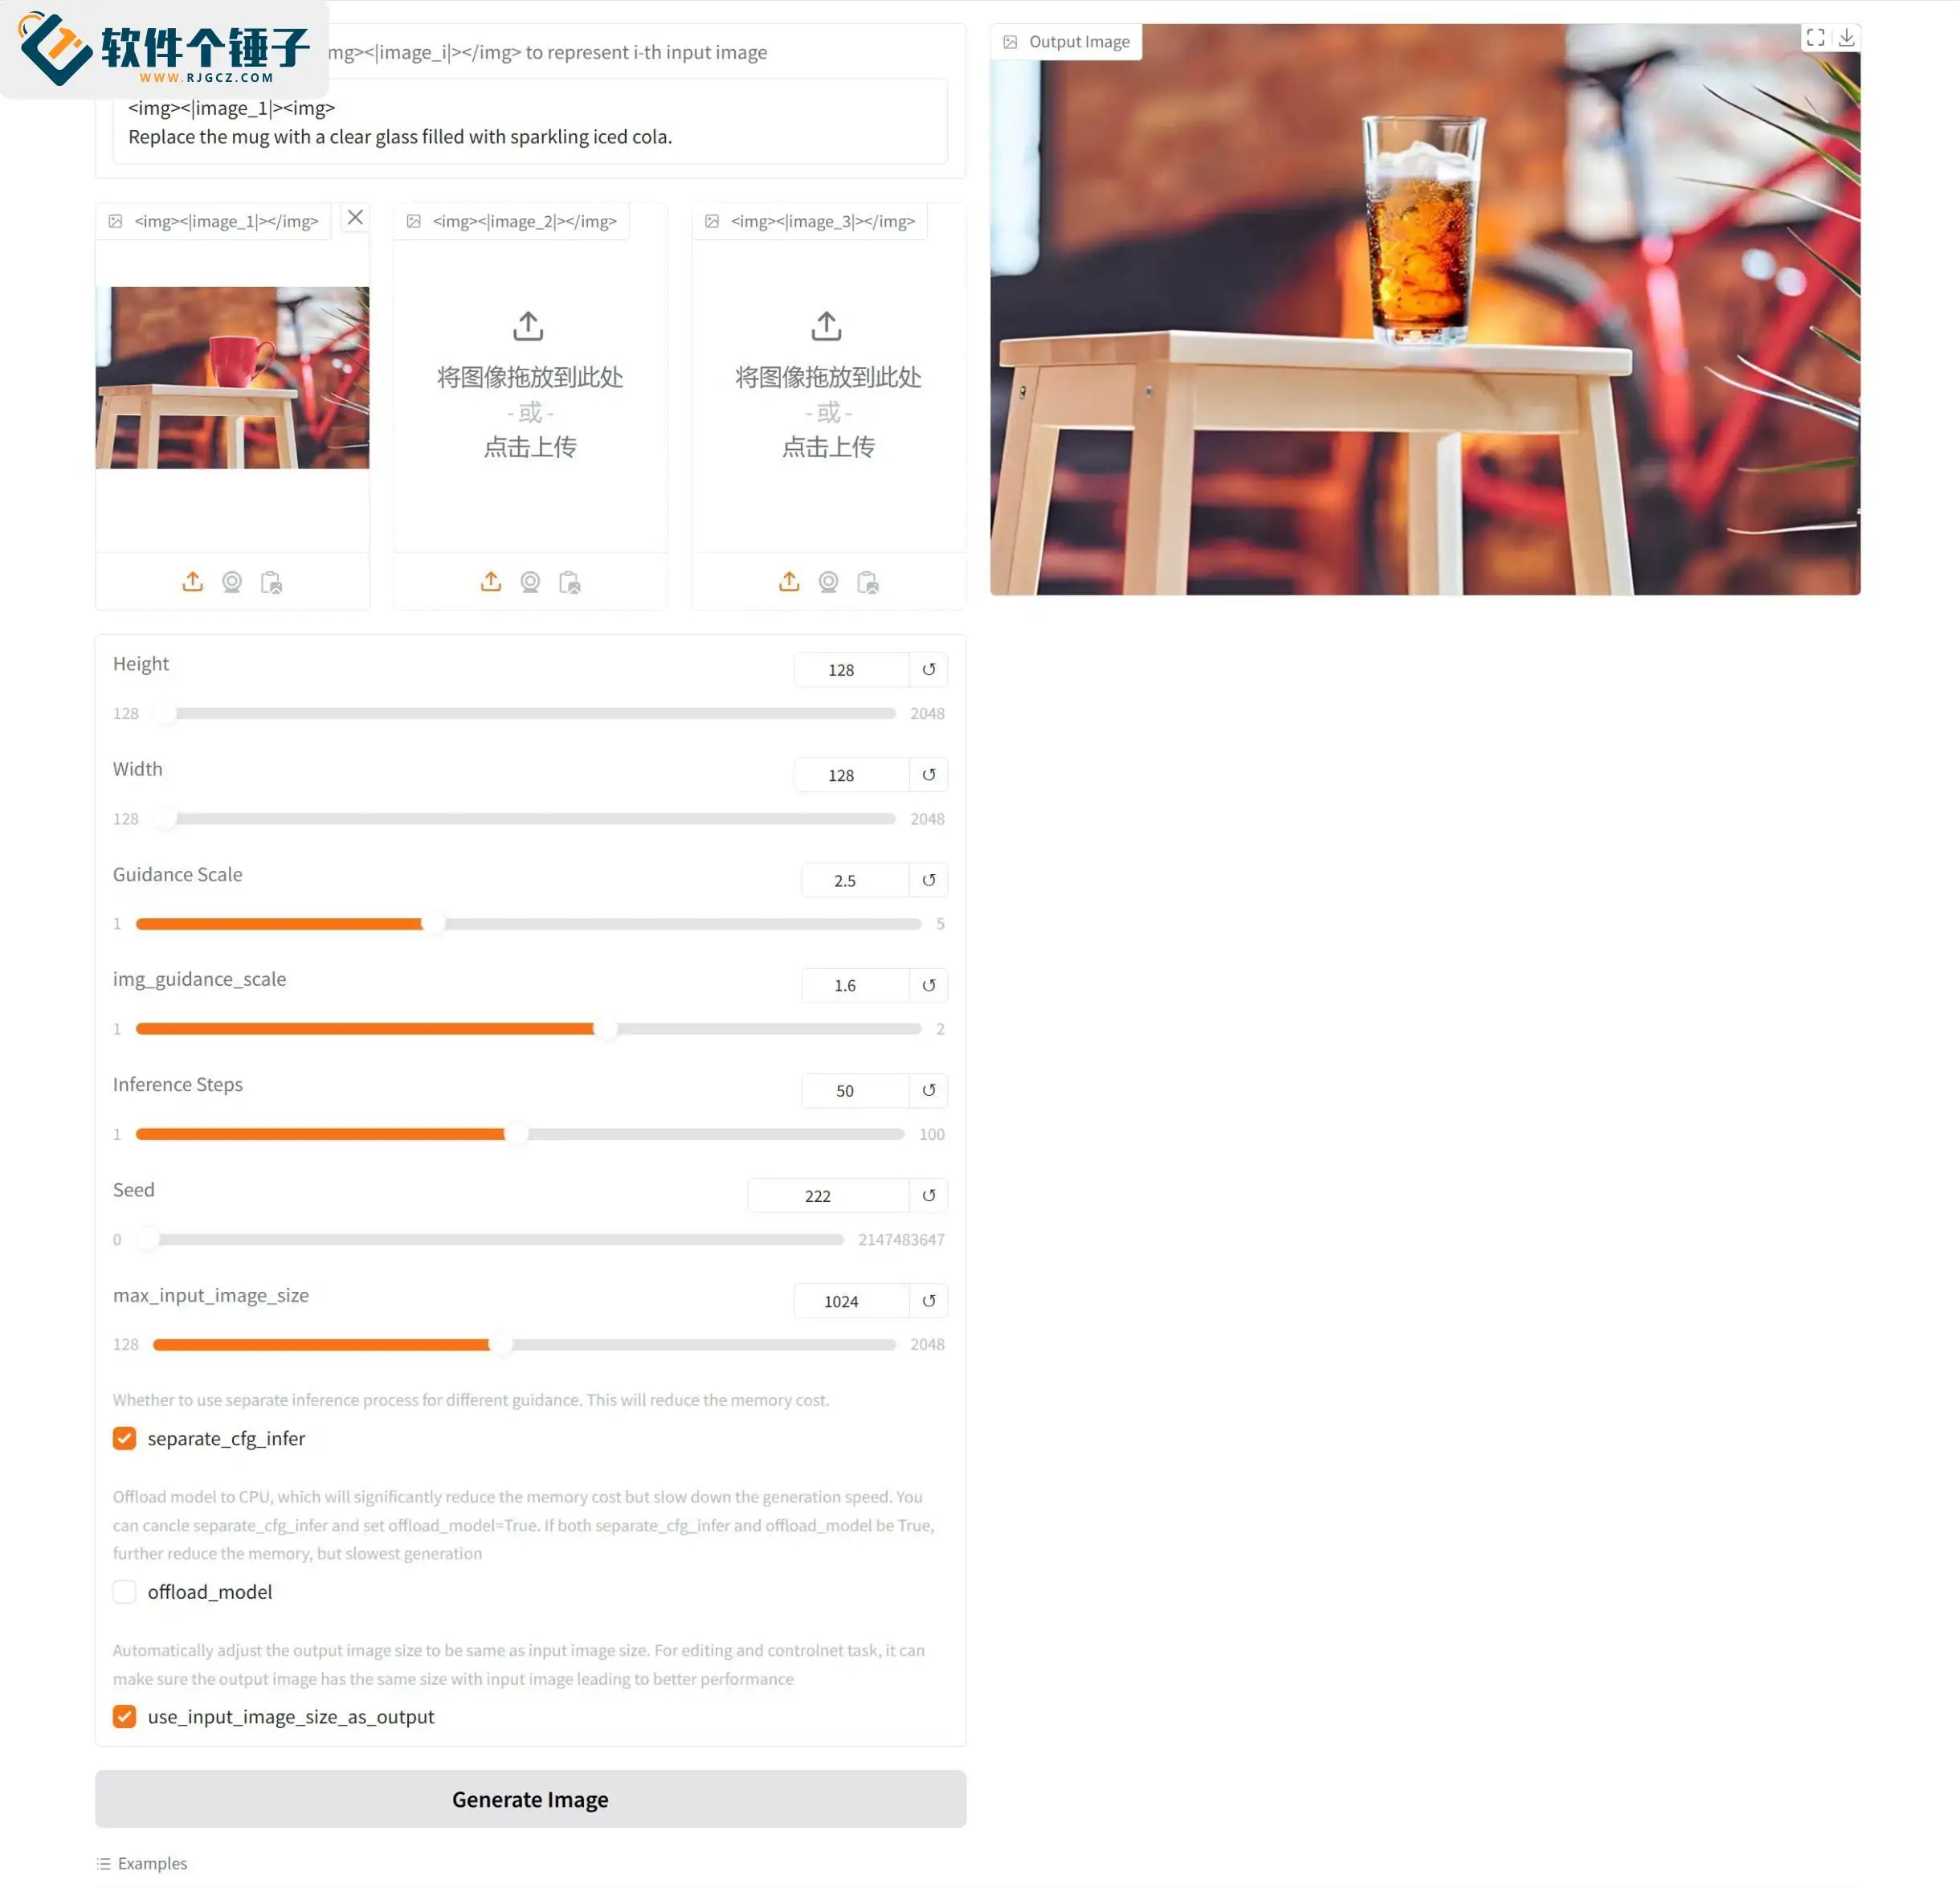
③ Bild hochladen (optional), Prompt eingeben (wenn im Prompt auf ein hochgeladenes Bild Bezug genommen wird, muss der Bildname exakt dem Format <img><|image_i|></img> entsprechen, sonst wird er nicht erkannt und es kommt zu einem Fehler; i kann durch die Nummern 1, 2, 3 ersetzt werden), anschließend Parameter wie Breite und Höhe anpassen oder die Standardwerte beibehalten und schließlich auf Absenden klicken; das Ergebnis erscheint rechts

1、Bilder per Prompt erzeugen
Prompt: A curly-haired man in a red shirt is drinking tea.
Übersetzung: Ein lockiger Mann in einem roten Hemd trinkt Tee.

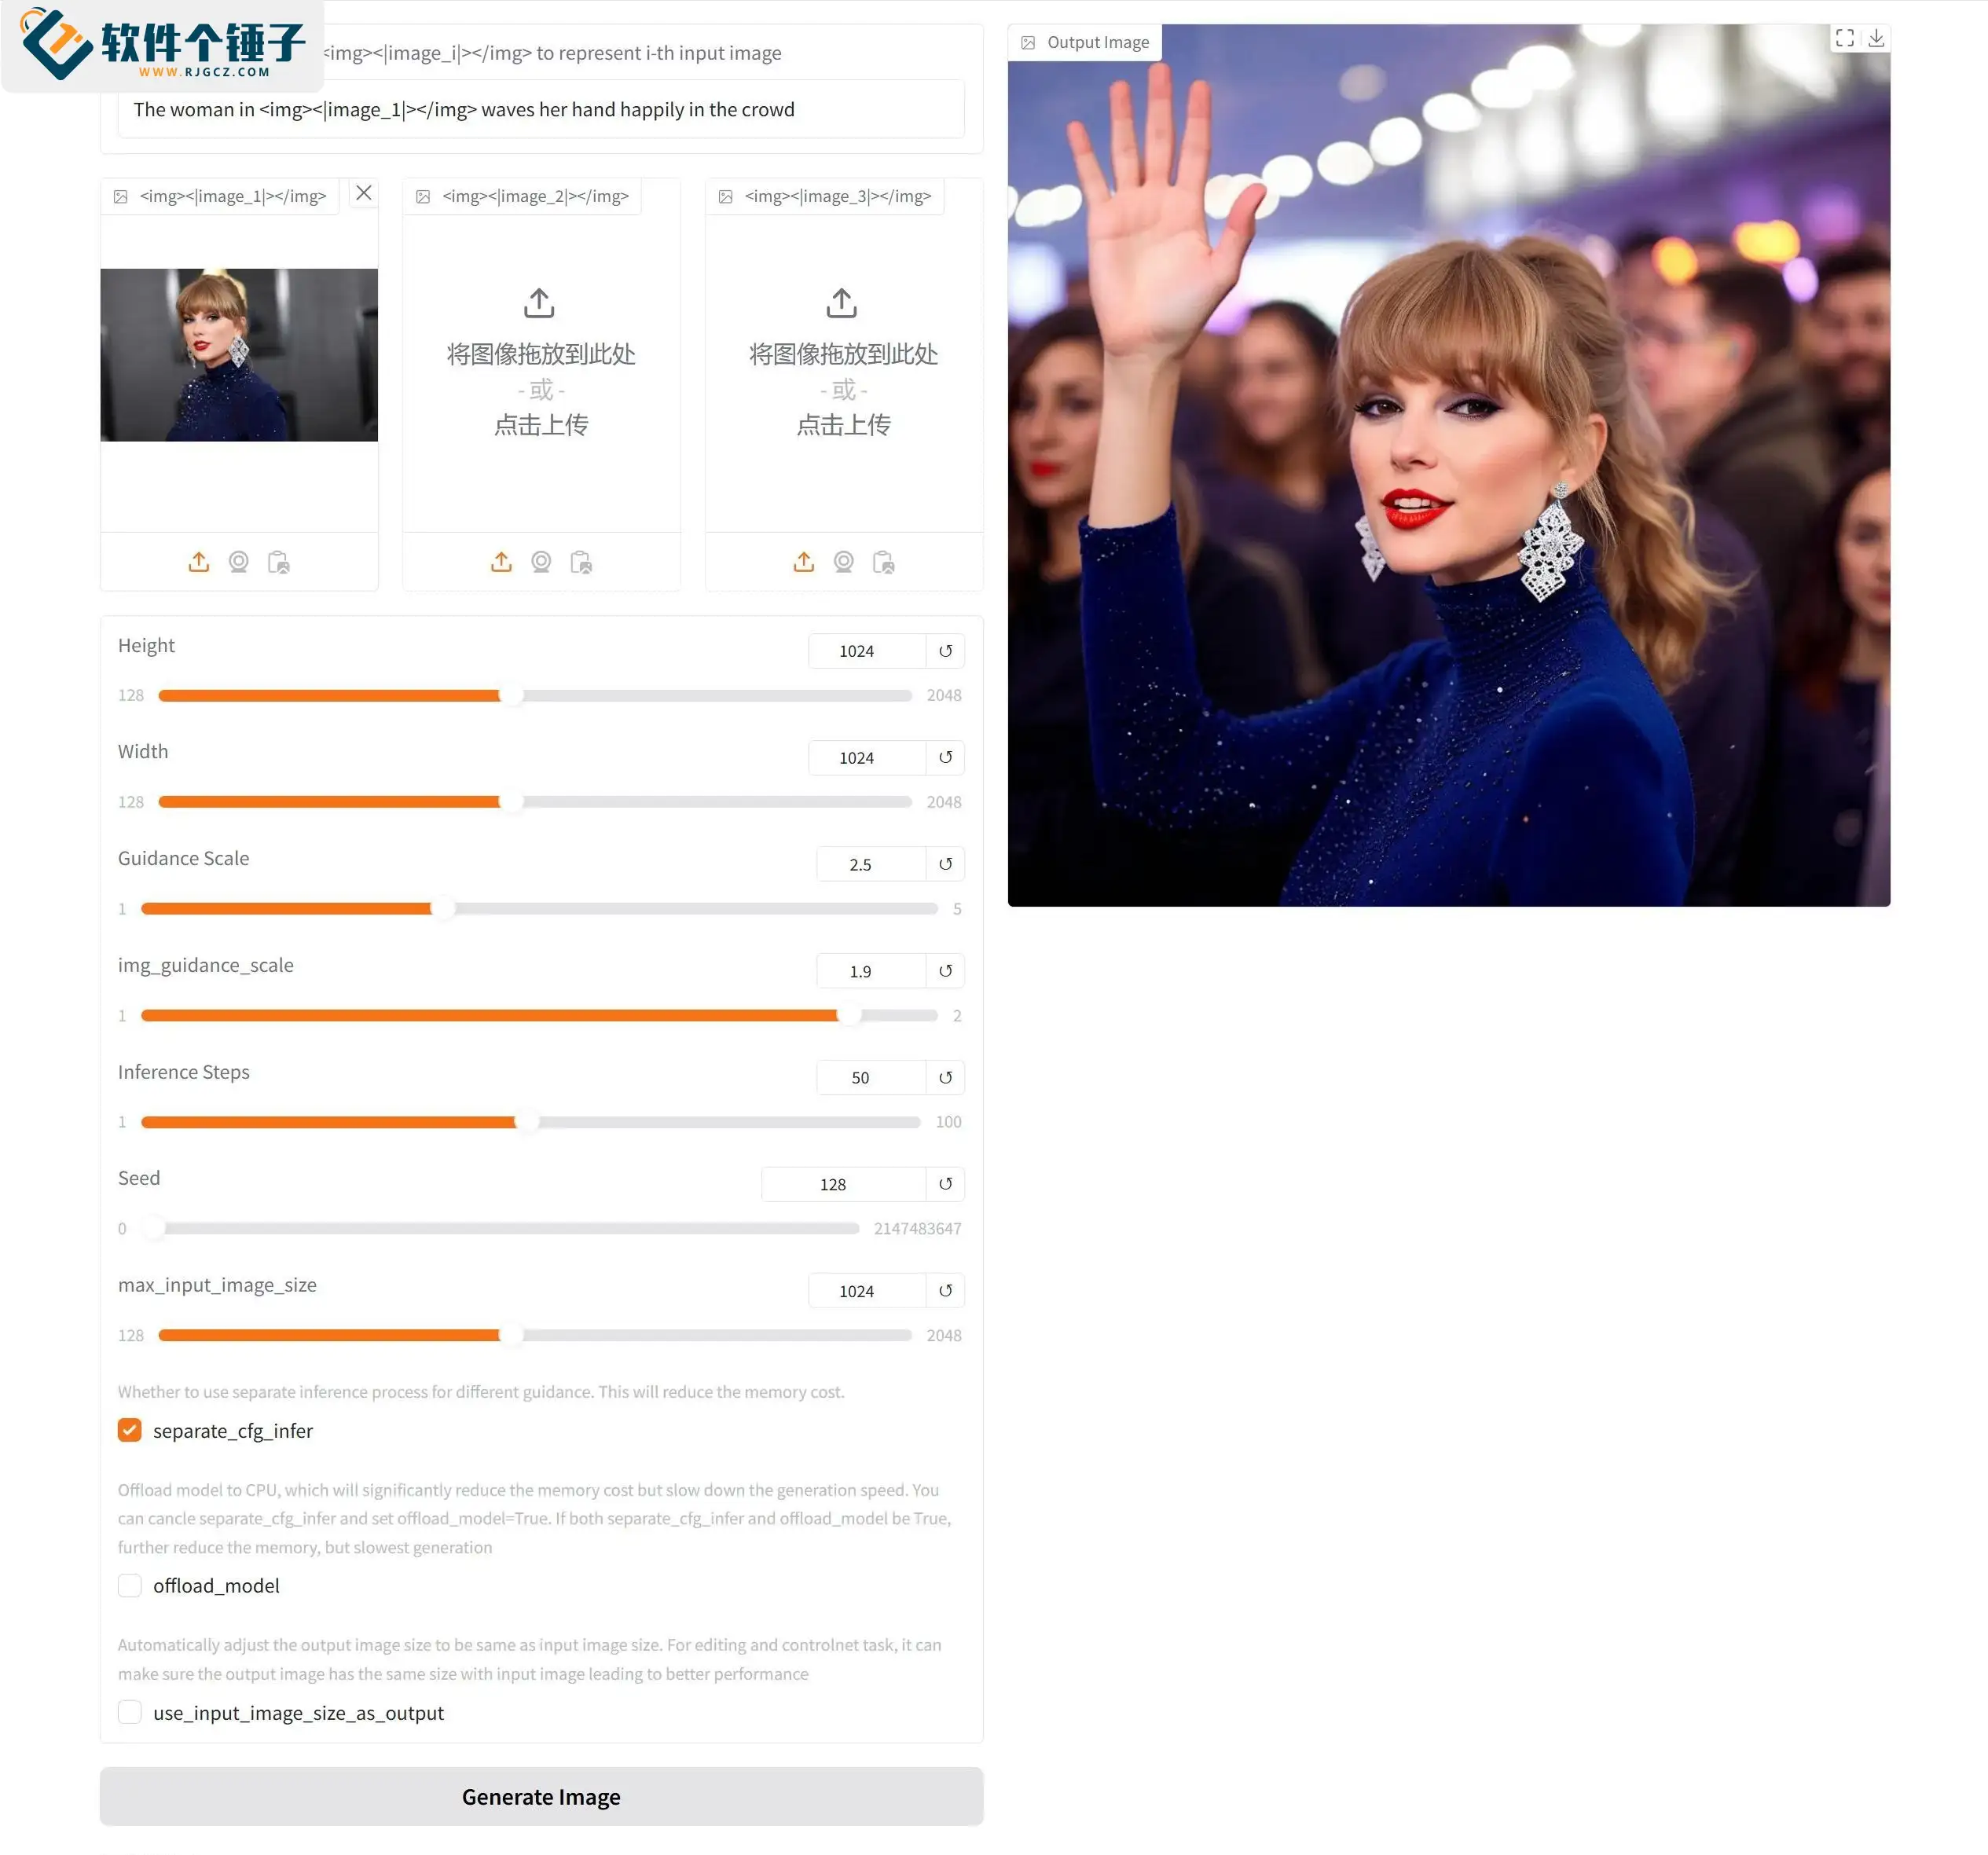
2、Bilder mit einem einzelnen Referenzbild erzeugen
Eingabeaufforderung: Die Frau in <img><|image_1|></img> winkt in der Menge fröhlich.
Übersetzung: Die Frau in <img><|image_1|></img> winkt in der Menge fröhlich.

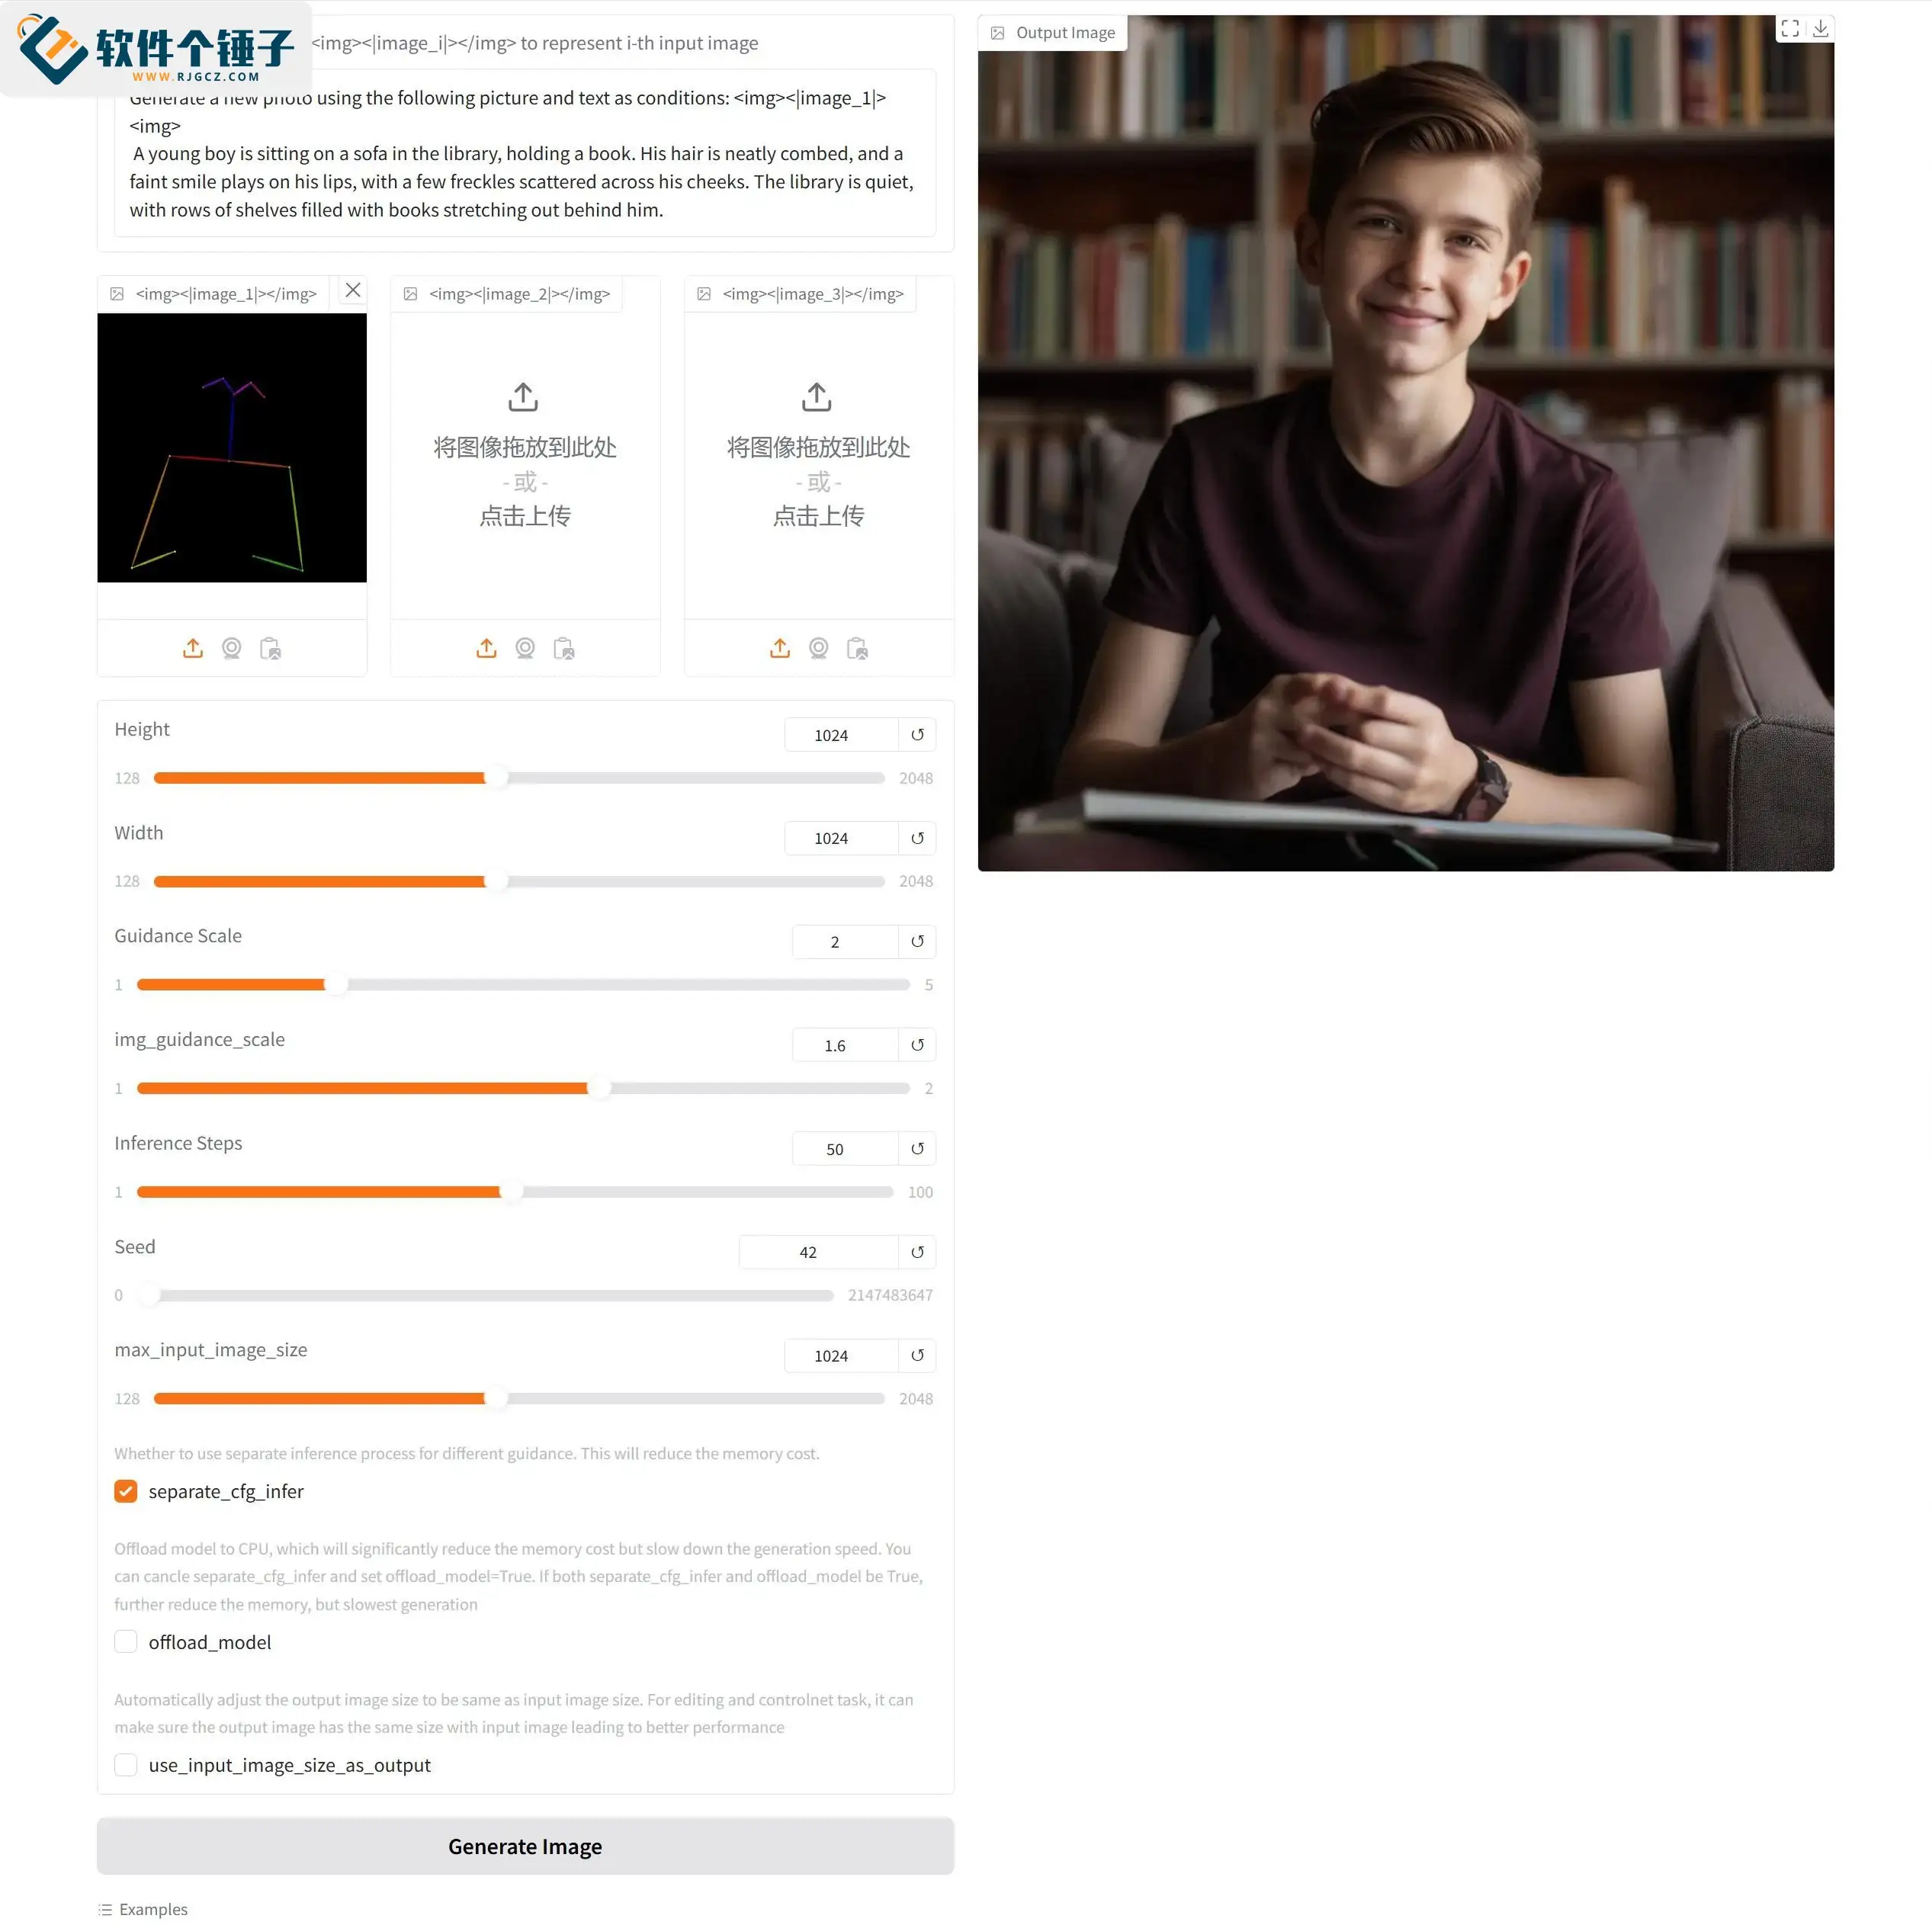
3. Generierung basierend auf der Pose
Eingabeaufforderung: Generiere ein neues Foto mit dem folgenden Bild und Text als Bedingungen: <img><|image_1|><img>
Ein kleiner Junge sitzt auf einem Sofa in der Bibliothek und hält ein Buch. Sein Haar ist ordentlich gekämmt, und ein leichtes Lächeln liegt auf seinen Lippen, mit ein paar Sommersprossen auf seinen Wangen. Die Bibliothek ist ruhig, und hinter ihm erstrecken sich reihenweise Regale voller Bücher.
Übersetzung: Generiere ein neues Bild mit dem folgenden Bild und Text als Bedingungen: <img><|image_1|></img> Ein kleiner Junge sitzt auf einem Sofa in der Bibliothek und hält ein Buch. Sein Haar ist ordentlich gekämmt, und ein leichtes Lächeln liegt auf seinen Lippen, mit ein paar Sommersprossen auf seinen Wangen. Die Bibliothek ist ruhig, und hinter ihm erstrecken sich reihenweise Regale voller Bücher.

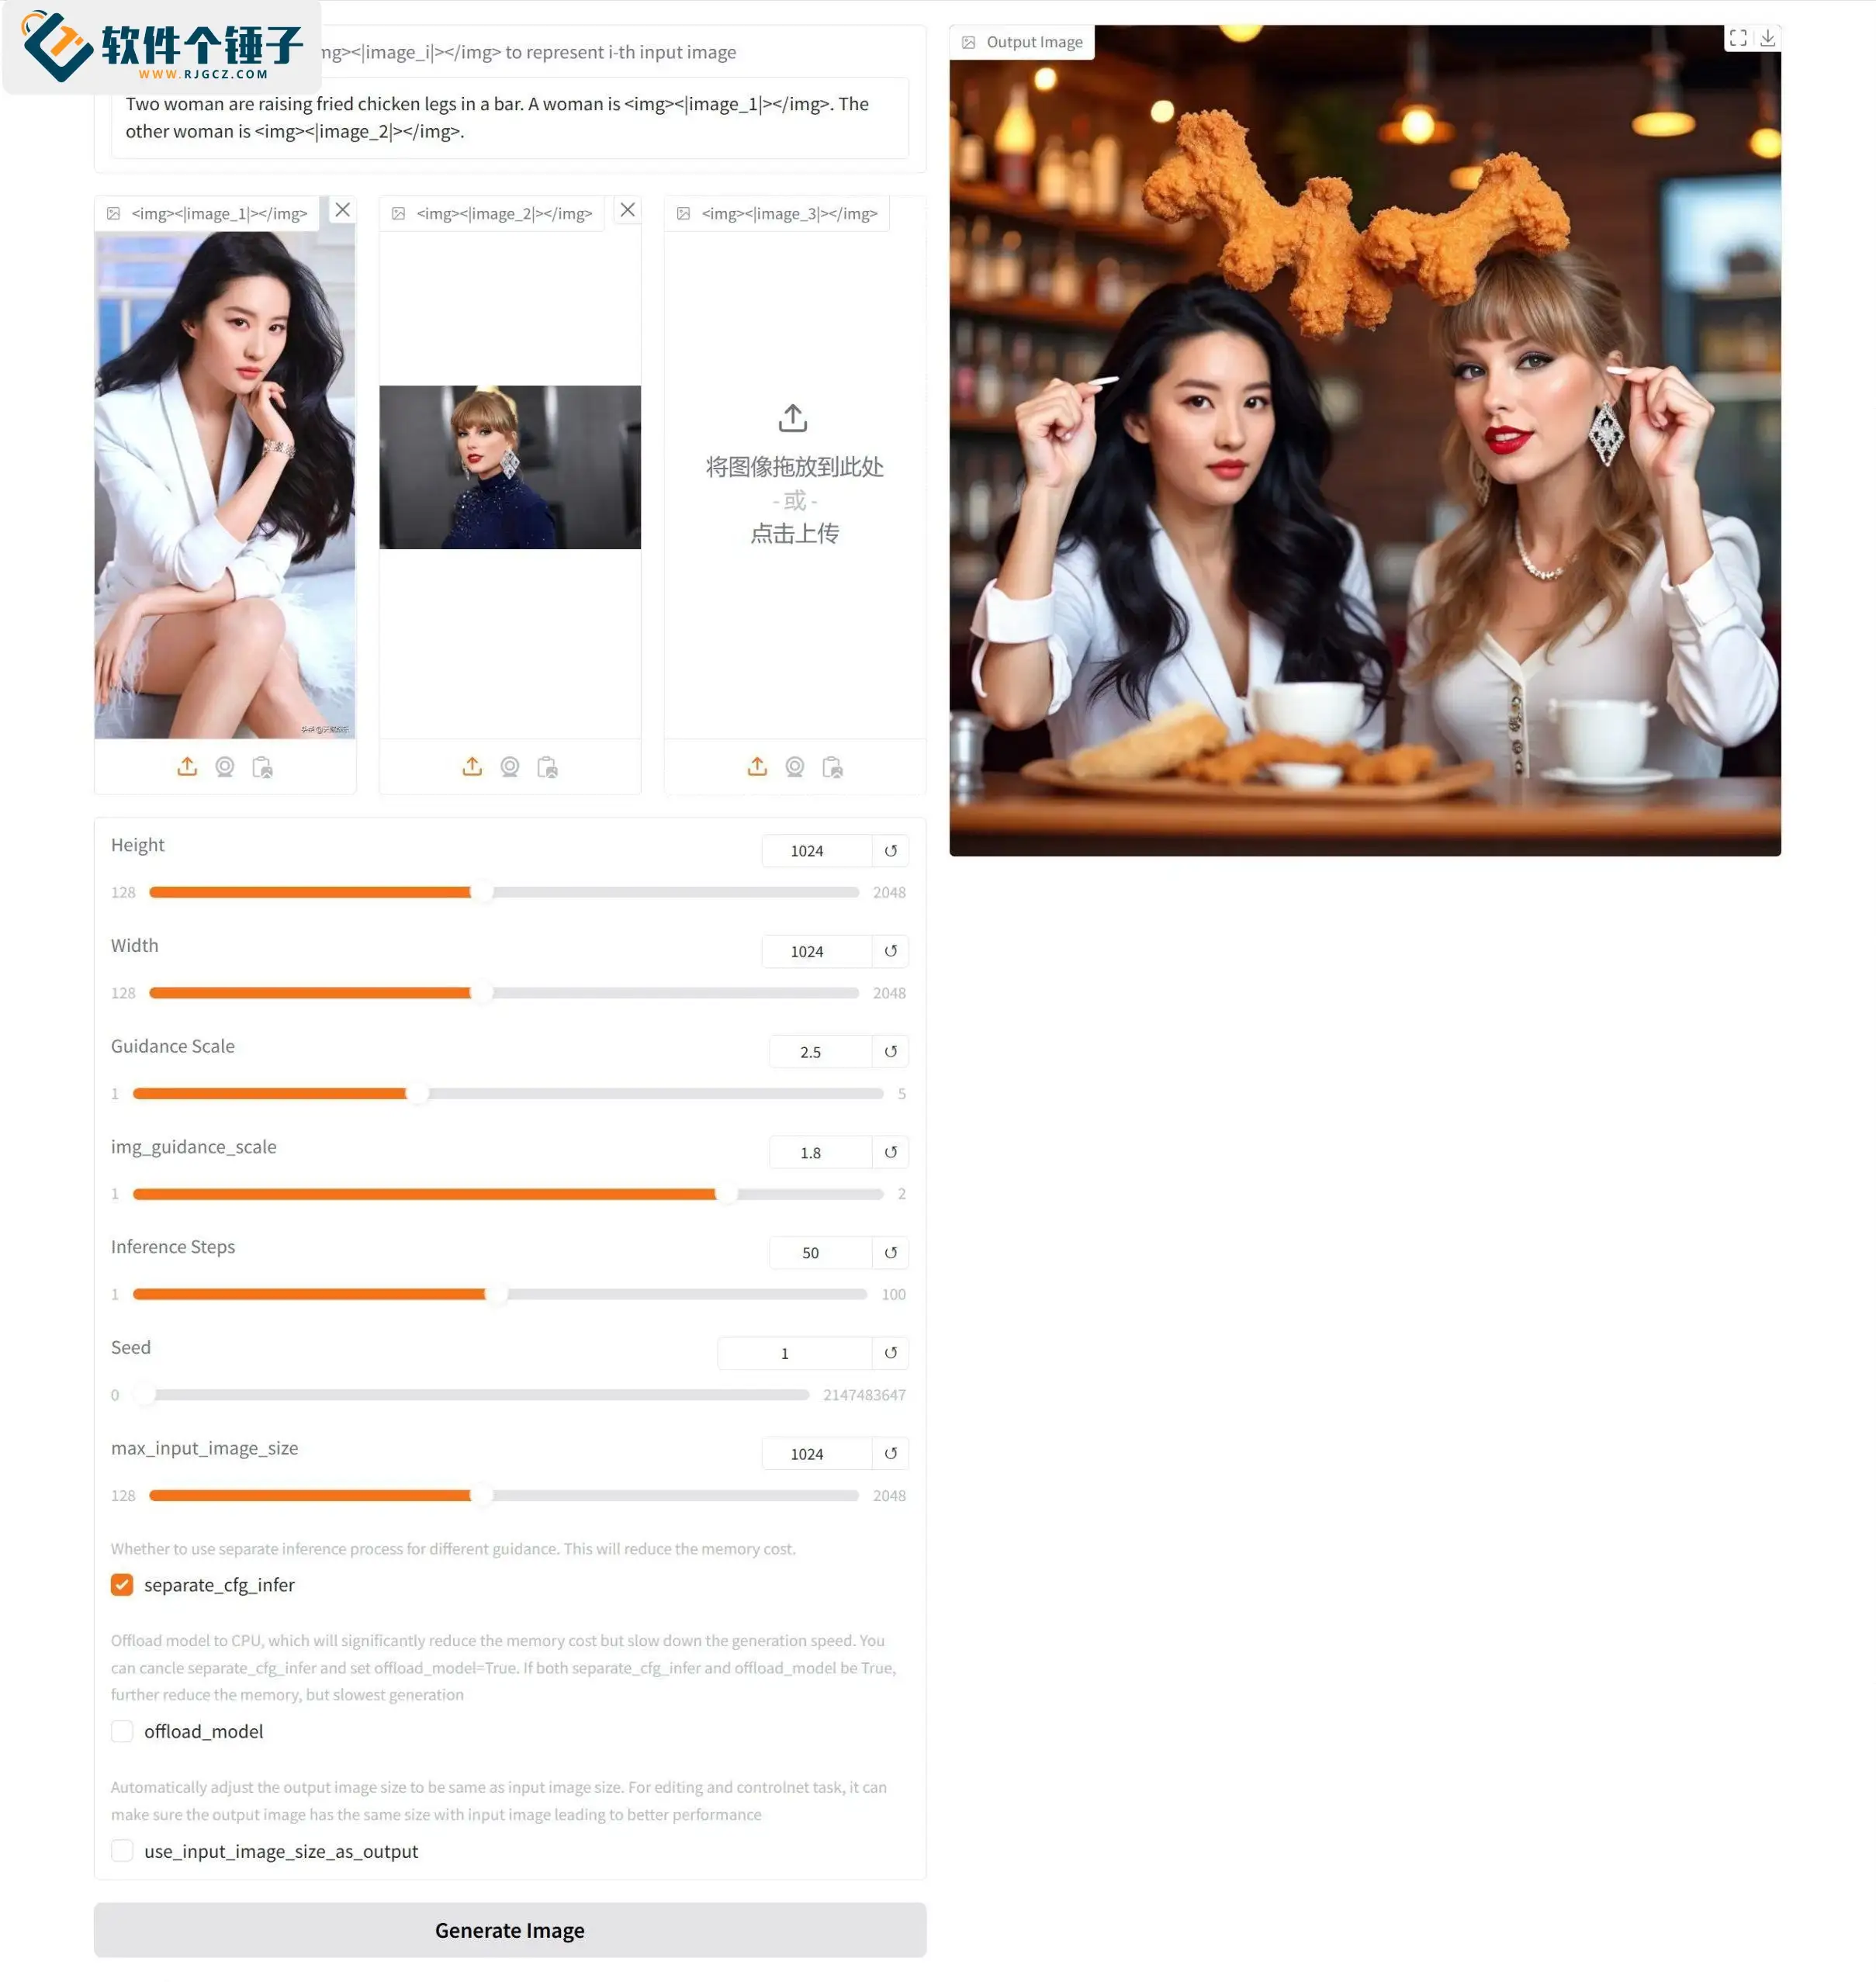
4. Die Personen aus zwei Bildern in ein Bild setzen
Eingabeaufforderung: Zwei Frauen halten in einer Bar frittierte Hähnchenschenkel hoch. Eine Frau ist <img><|image_1|></img>. Die andere Frau ist <img><|image_2|></img>.
Übersetzung: Zwei Frauen halten in einer Bar frittierte Hähnchenschenkel hoch. Eine Frau ist <img><|image_1|></img>. Die andere Frau ist <img><|image_2|></img>.

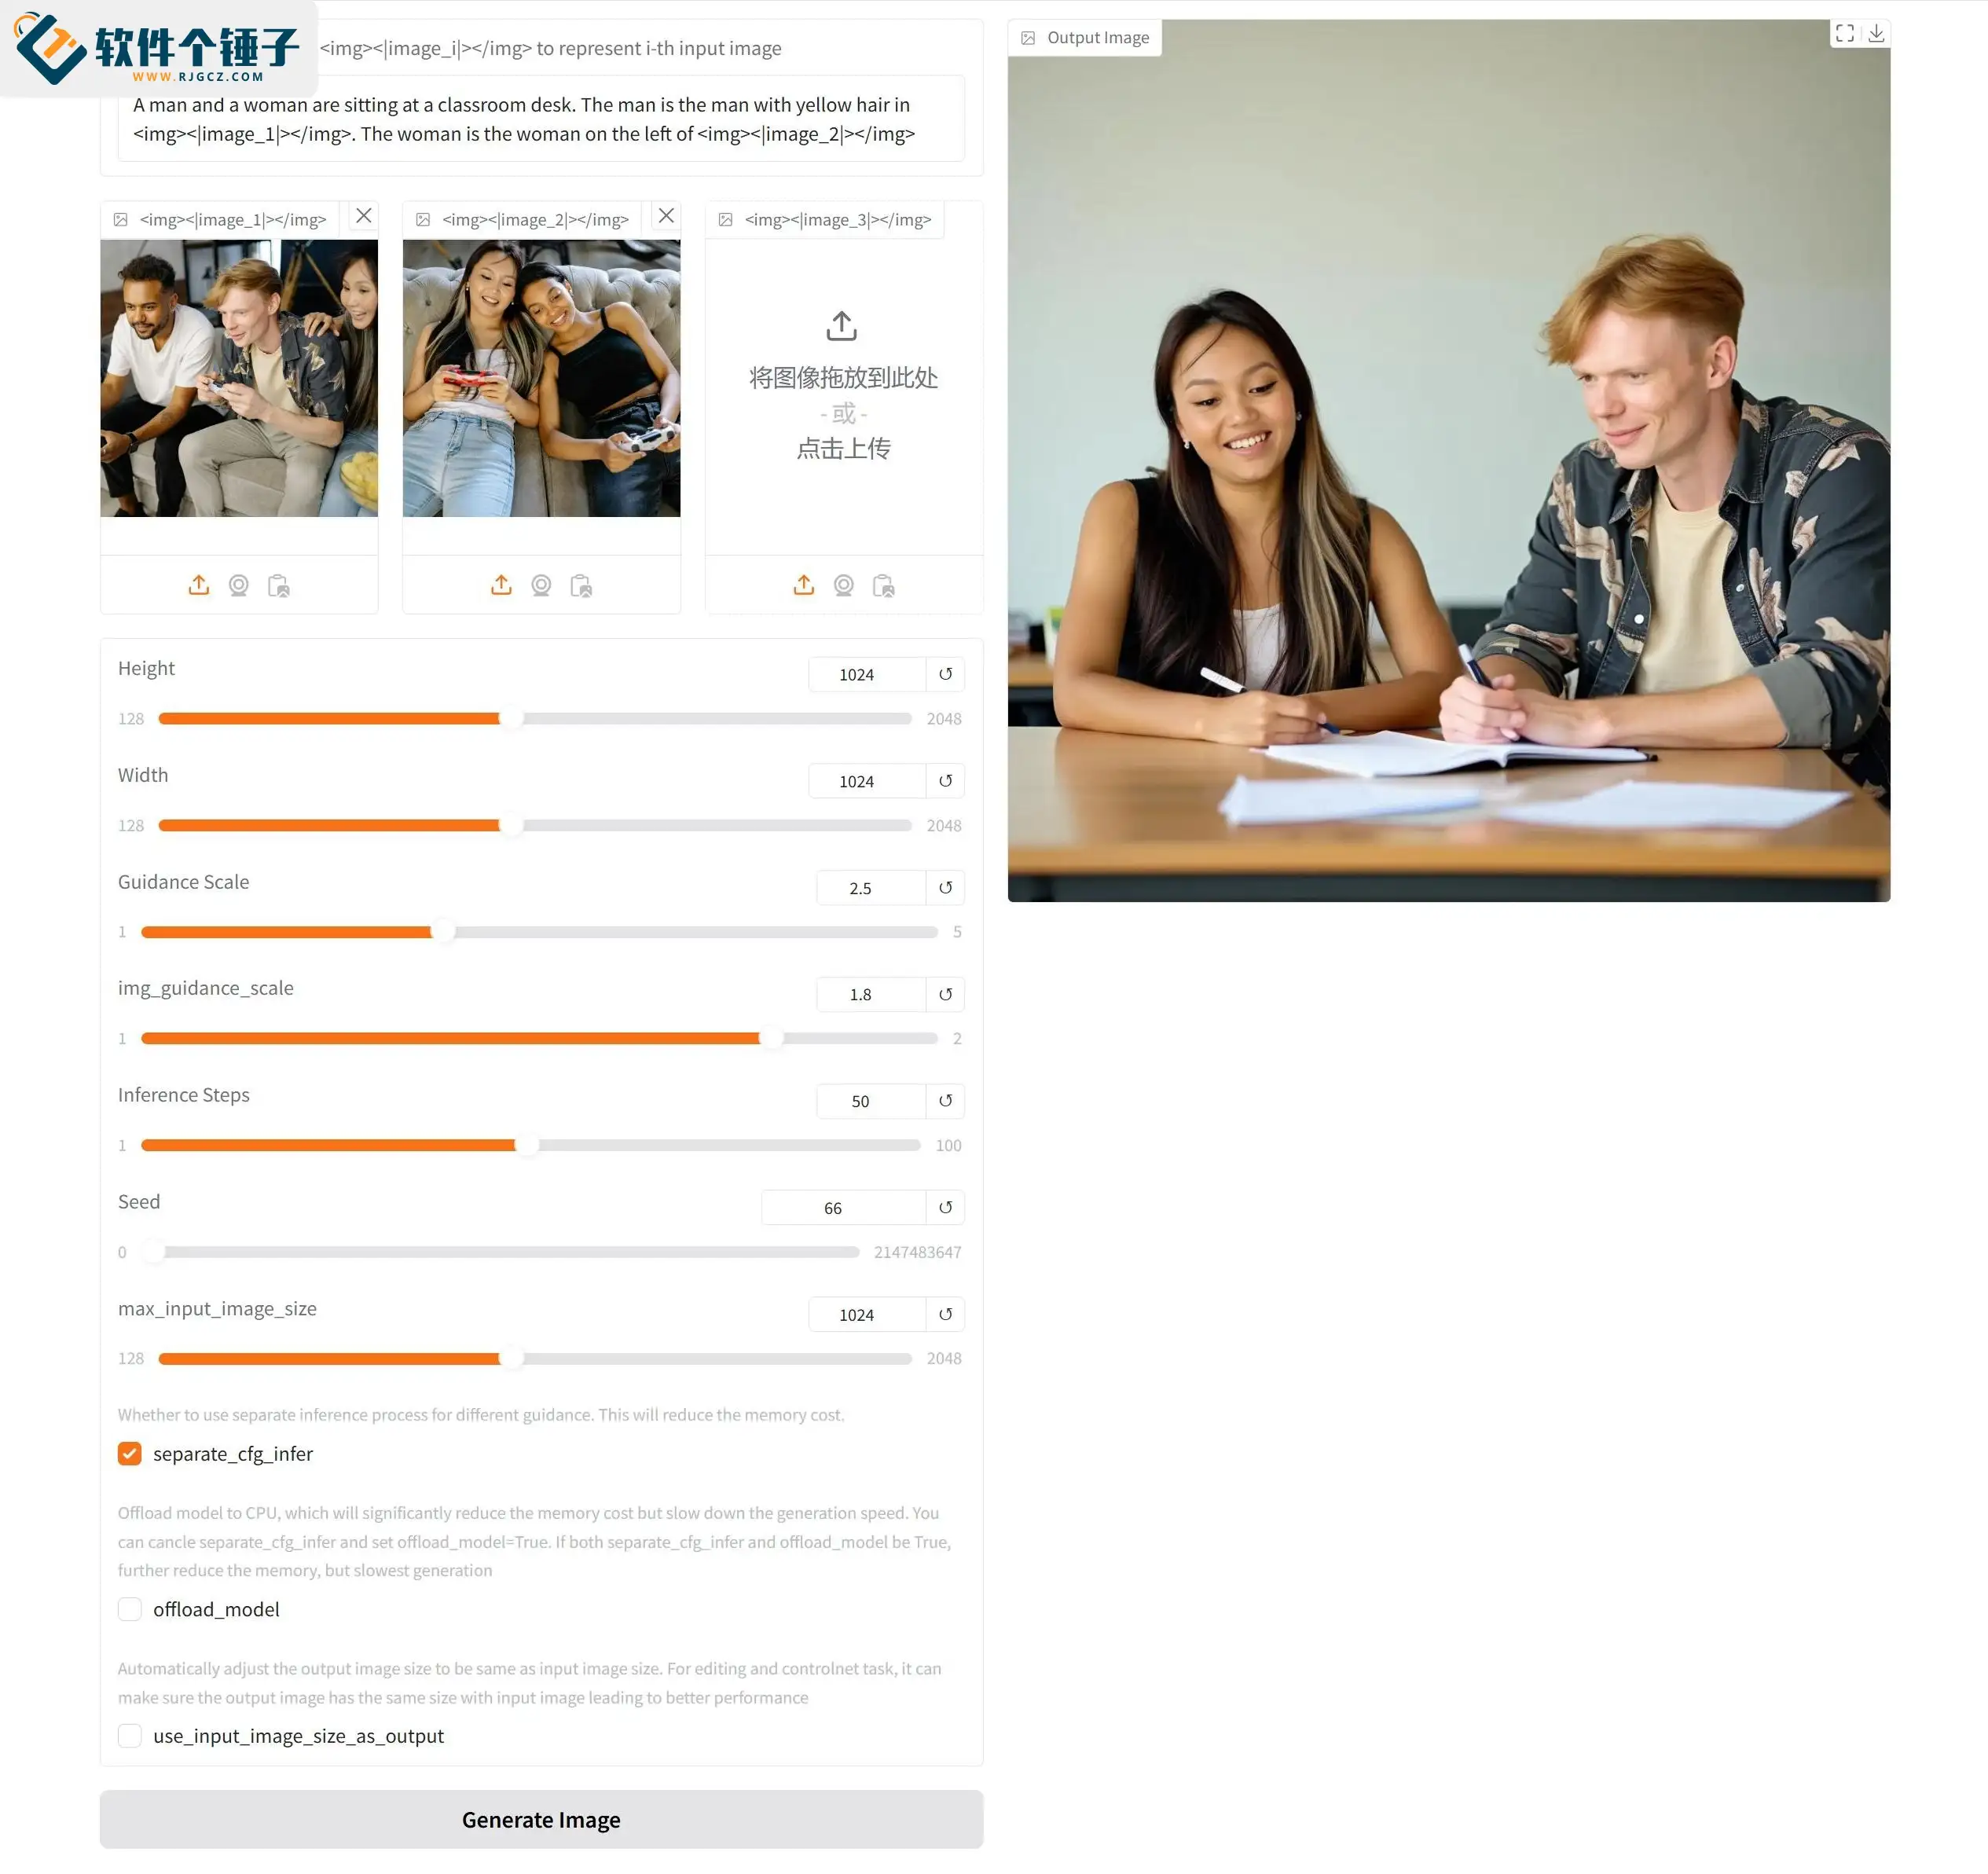
5. Eine bestimmte Person aus einer Menschenmenge herauslösen und in ein Bild setzen
Eingabeaufforderung: Ein Mann und eine Frau sitzen an einem Tisch in einem Klassenzimmer. Der Mann ist der Mann mit gelbem Haar in <img><|image_1|></img>. Die Frau ist die Frau links von <img><|image_2|></img>.
Übersetzung: Ein Mann und eine Frau sitzen an einem Tisch in einem Klassenzimmer. Der Mann ist der Mann mit gelbem Haar in <img><|image_1|></img>. Die Frau ist die Frau links von <img><|image_2|></img>.

6. Objekte im Bild ändern
Eingabeaufforderung: <img><|image_1|><img>
Ersetze den Becher durch ein klares Glas voller sprudelnder Eis-Cola.
Übersetzung: <img><|image_1|><img>
Ersetze den Becher durch ein klares Glas voller sprudelnder Eis-Cola.

Open-Source-Link
[Offizielle OmniGen-Adresse]
Ähnliche Kurse

Super lokale Toolbox! Integrierte Bildschirmaufnahme, Audio-/Video-Schnitt & -Zusammenführung, Video-Komprimierung & -Extraktion, für immer gratis – Kedou Video Converter

100%% perfektes Gratis-Tool! Alles-in-einem-Multifunktions-PDF-Software: PDF konvertieren, komprimieren, bearbeiten etc., minimalistisch, keine Werbung, so schön – JOPDF

Open-Source-Desktop-Fernzugriffstool, weit besser als kostenpflichtige Versionen! Kostenlos und unbegrenzt für Privat und Gewerbe nutzbar, plattformübergreifend, Desktop-Fernsteuerung – HopToDesk

Neuestes Tool zum Herunterladen von Lehrmaterialien für Grund- und Mittelschule: komplette Jahrgangsstufen, mit begleitenden Folien, Videos und Audios auf einen Klick

Den ganzen Tag auf den Bildschirm, ohne Augenschutz-Tool? Kostenlose Blaulicht-Schutz-App für PC, mit Haustier, das dich an Pausen erinnert, Huyanbao

PyIsland: Modernes System-Control-Center mit Desktop-Dynamic-Island für Windows

3D-Simulation-Manju-Produktion: Seedance 2.0 Komplettprozess-Praxis, von 0 bis zur hochwertigen Manju-Kreation

Für Win und Mac! Neueste lebenslange Version: Restaurierung alter Fotos, Bildklarheit und verlustfreie Vergrößerung - Aiarty Image Enhancer

Github Open-Source-Bilibili-Downloader: Stapel-Download von Bilibili-Videos mit 8K und Dolby Vision-Unterstützung – einfach zu bedienen, Bilidown

Windows-Desktop-Werkzeugsammlung: 50+ praktische, schlichte Desktop-Widgets, mit Screenshot, Screenrecording, Übersetzung, Wetter u.v.m. – Duomi-Toolbox

Contact Info
- E-Mail: massivesidehustles@outlook.com
