


-
Cursos de negocio en solitario
-
 Otros
-
Tutoriales en el extranjero
-
Fotografía & Edición
-
Comunidad & Dominio privado
-
Escritura & Redacción para medios
-
Proyectos de ingresos extra
-
Comercio electrónico
-
Vídeo corto & Transmisión en vivo
-
Inteligencia Artificial (IA)
-
Software & Herramientas
-
Sistemas operativos
-
Plugins & Scripts
-
Software MacOS
-
Software Android
-
Software Windows


Paquete integrado del modelo multimodal de generación de imágenes OmniGen, gratuito y de código abierto, arranque con un solo clic, sin necesidad de despliegue ni autorización [Ruanjian Ge Chuizi · R2255]
-
Plan para ganar dinero con la cría de oro en juegos: gana más de 1000 al día, un proyecto estable de 3 años que cualquiera puede hacer en su tiempo libre
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Curso sistemático con SOP de drama de cómic con IA: selección y adaptación de novelas web, normas de guion, película terminada de texto a imagen e imagen a video, edición de locución: tutorial estanda
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Farming automatizado de juegos populares: 500+/día, sin experiencia, sencillo – el extra estable a largo plazo más fiable [Revelado]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
ShuShu esta vez sí cumplió! No te asustes con los problemas de formato de Windows: la herramienta open source ShuShu Format Converter, una joya popular en GitHub
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Campamento de acompañamiento de ventas en Douyin: sin aparecer en cámara, principiantes copian plantillas y producen videos
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Plan de ingresos por farming de juegos en su estreno: más de 1.000 al día, ¡apto para gente normal en su tiempo libre! [Revelación]
Material de estudio de referencia — incluido con la membresía Obtener membresía






-
ShuShu esta vez sí cumplió! No te asustes con los problemas de formato de Windows: la herramienta open source ShuShu Format Converter, una joya popular en GitHub
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Master Lu v6.1024.4105.1121 versión simplificada de archivo único [Software Ge Chuizi · R1880]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Software de creación de animación de dibujos animados 2D Moho Pro v14.3 [Software Ge Chuzi · R2355]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Software de edición y procesamiento de video para PC Aiseesoft Filmai v1.0.18
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Microsoft To Do v2.147 versión oficial gratuita【Software Ge Chuizi·R2618】
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Plugin de osciloscopio de corrección de color de vídeo para PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138 [Software Gechuzi·R2748]
Material de estudio de referencia — incluido con la membresía Obtener membresía





OmniGen es una nueva arquitectura de modelo de difusión presentada por BAAI, centrada en la generación unificada de imágenes. Simplifica el complejo proceso de generación de imágenes al abordar múltiples tareas con un solo marco, como la generación de imágenes a partir de texto, la edición de imágenes y la generación basada en condiciones visuales. Además, OmniGen logra la transferencia de conocimiento mediante una estructura de aprendizaje unificada, lo que le permite adaptarse a distintas tareas y necesidades de dominio. El modelo no solo es muy simplificado y fácil de usar, sino que también demuestra una gran flexibilidad en el campo de la generación de imágenes.

Características del software:
Unificación: OmniGen puede abordar de forma integral diversas tareas de generación de imágenes, como la generación de imágenes a partir de texto, la generación guiada por temas, la edición de imágenes y la generación basada en condiciones visuales. Su innovación radica en convertir tareas tradicionales de visión por computador en tareas de generación de imágenes, ofreciendo así una experiencia de generación de imágenes integrada.
Sencillez: OmniGen prescinde de los engorrosos flujos de trabajo habituales de otros modelos y no necesita complementos como ControlNet o IP-Adapter, por lo que el tratamiento de las tareas es más intuitivo. Los usuarios pueden completar tareas complejas con instrucciones sencillas, lo que reduce enormemente la barrera de uso.
Transferencia de conocimiento: gracias al aprendizaje con un formato unificado, OmniGen puede transferir conocimiento entre distintas tareas, y resulta especialmente útil en tareas o dominios nunca vistos. En este proceso, OmniGen explora la aplicación del mecanismo de "cadena de pensamiento", lo que le confiere una capacidad más flexible de razonamiento y aprendizaje en contexto en la generación de imágenes.
Funciones del software:
Generación de imágenes a partir de texto: genera las imágenes correspondientes a partir de una descripción textual.
Edición de imágenes: edita una imagen de forma parcial o total según las necesidades del usuario.
Generación con consistencia de personaje: mantiene coherente la apariencia del personaje en varias imágenes.
Generación basada en condiciones visuales: genera imágenes que cumplen requisitos específicos a partir de condiciones visuales (como la postura o la información de bordes).
Requisitos de configuración:
Se recomienda que el equipo cumpla la siguiente configuración:
Sistema operativo: Windows 10/11 de 64 bits
Tarjeta gráfica: 8 GB de memoria de vídeo son utilizables, pero la generación es más lenta; se recomienda una tarjeta NVIDIA con más de 8 GB de memoria de vídeo,
CUDA >= 11.8
El paquete completo ocupa unos 24,5 GB tras descomprimirlo, así que hay que reservar suficiente espacio en disco
Si el equipo no tiene CUDA instalado, puede consultar el tutorial de instalación:
Cómo consultar la marca, el modelo y la memoria de la tarjeta gráfica:
Abre el Administrador de tareas
Haz clic en "Rendimiento"
Haz clic en "GPU"
En la esquina superior derecha se ve el modelo de la tarjeta gráfica y, debajo, el tamaño de la memoria de vídeo

Tutorial de uso:
① Descarga el paquete integrado y descomprímelo;
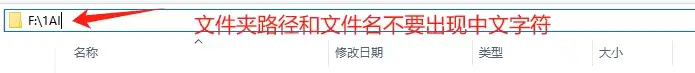
Nota: la ruta de las carpetas y los nombres de archivo (incluidos los nombres de archivos de audio, imágenes, vídeos, etc.) no deben contener caracteres chinos; de lo contrario, algunos programas darán error al no poder reconocerlos

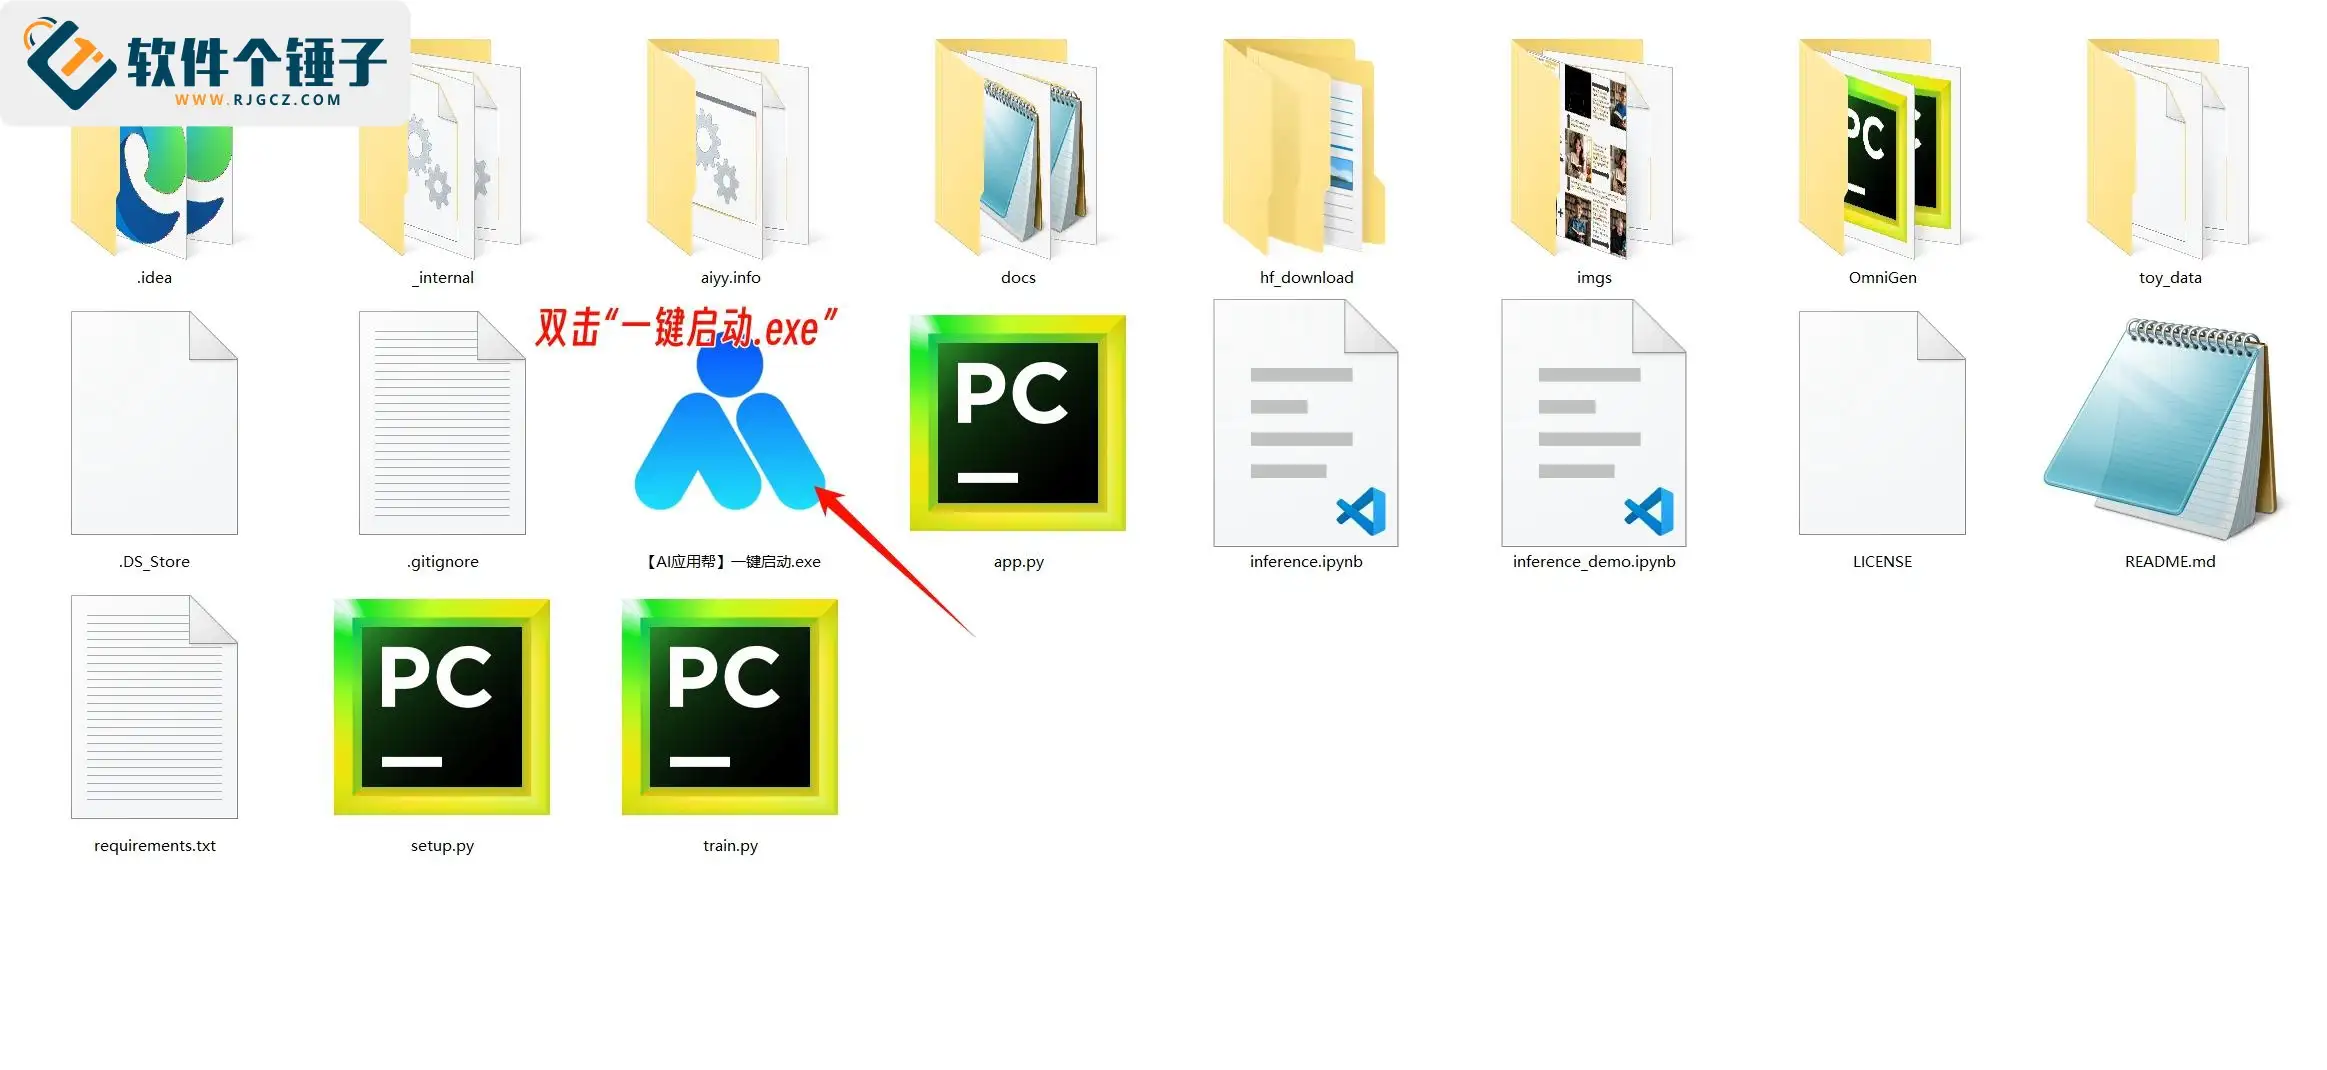
② Haz doble clic en "一键启动.exe" y, tras unos instantes, la interfaz de operación se abrirá automáticamente en el navegador

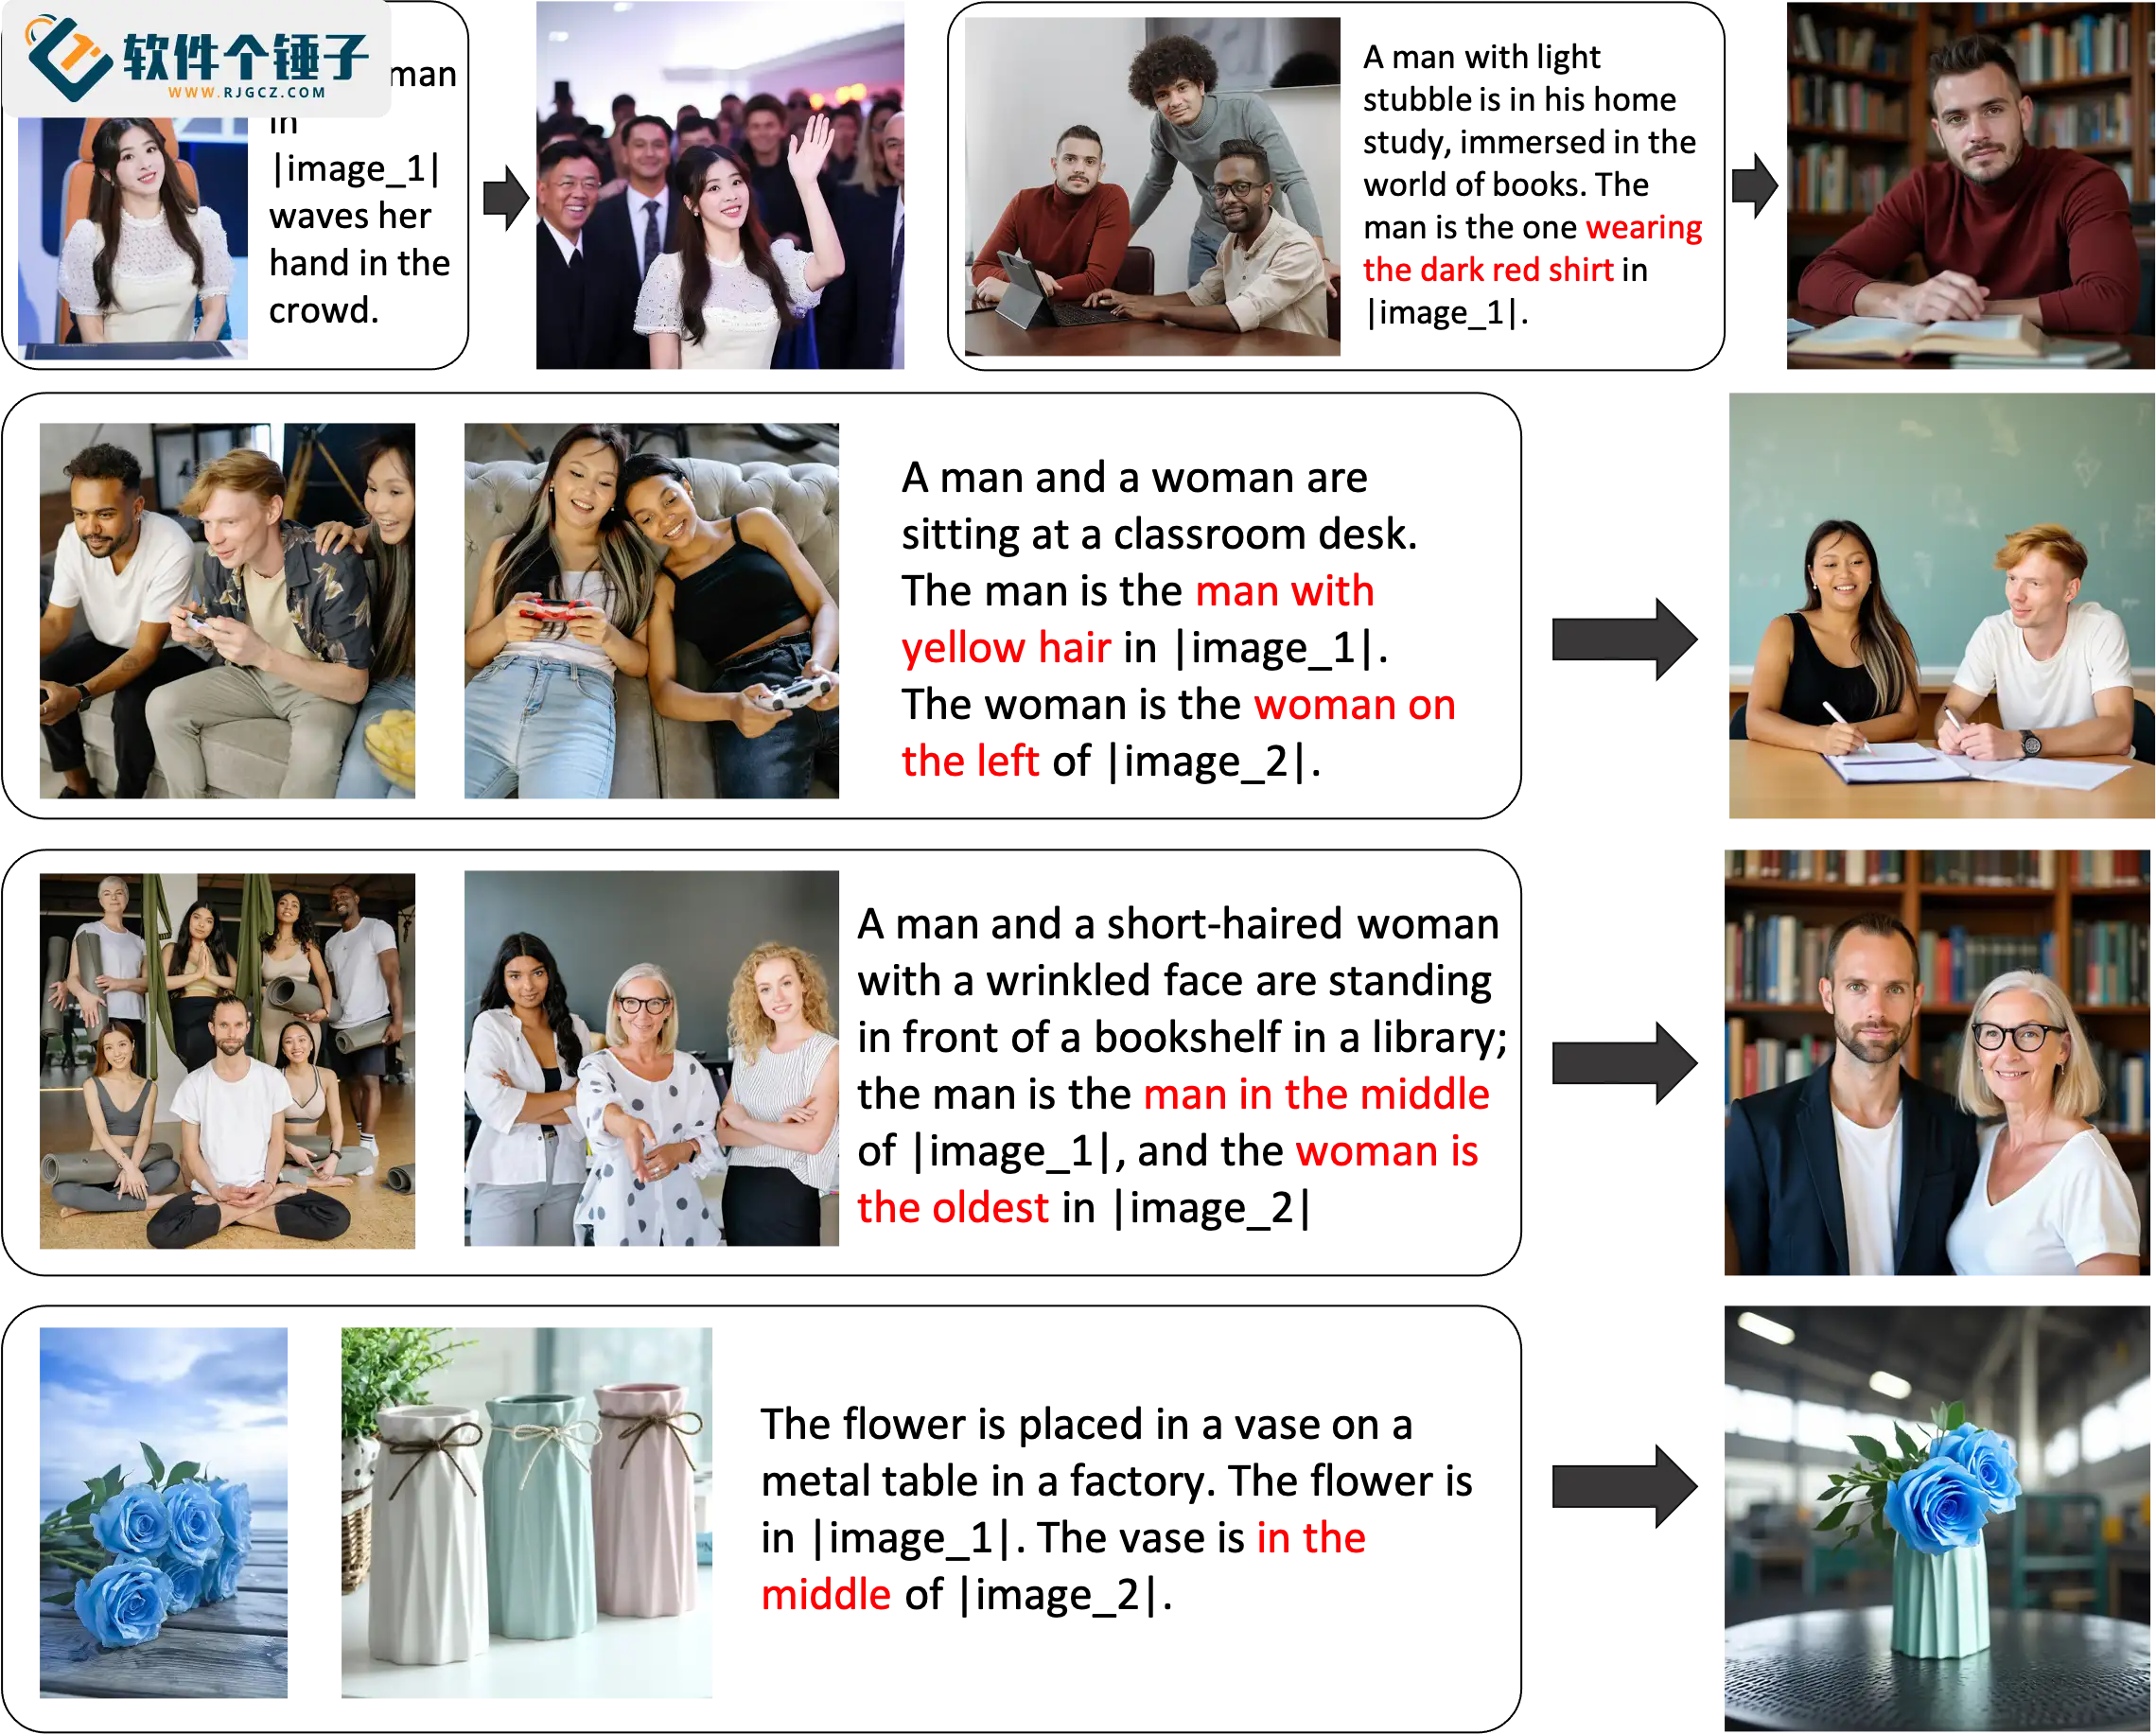
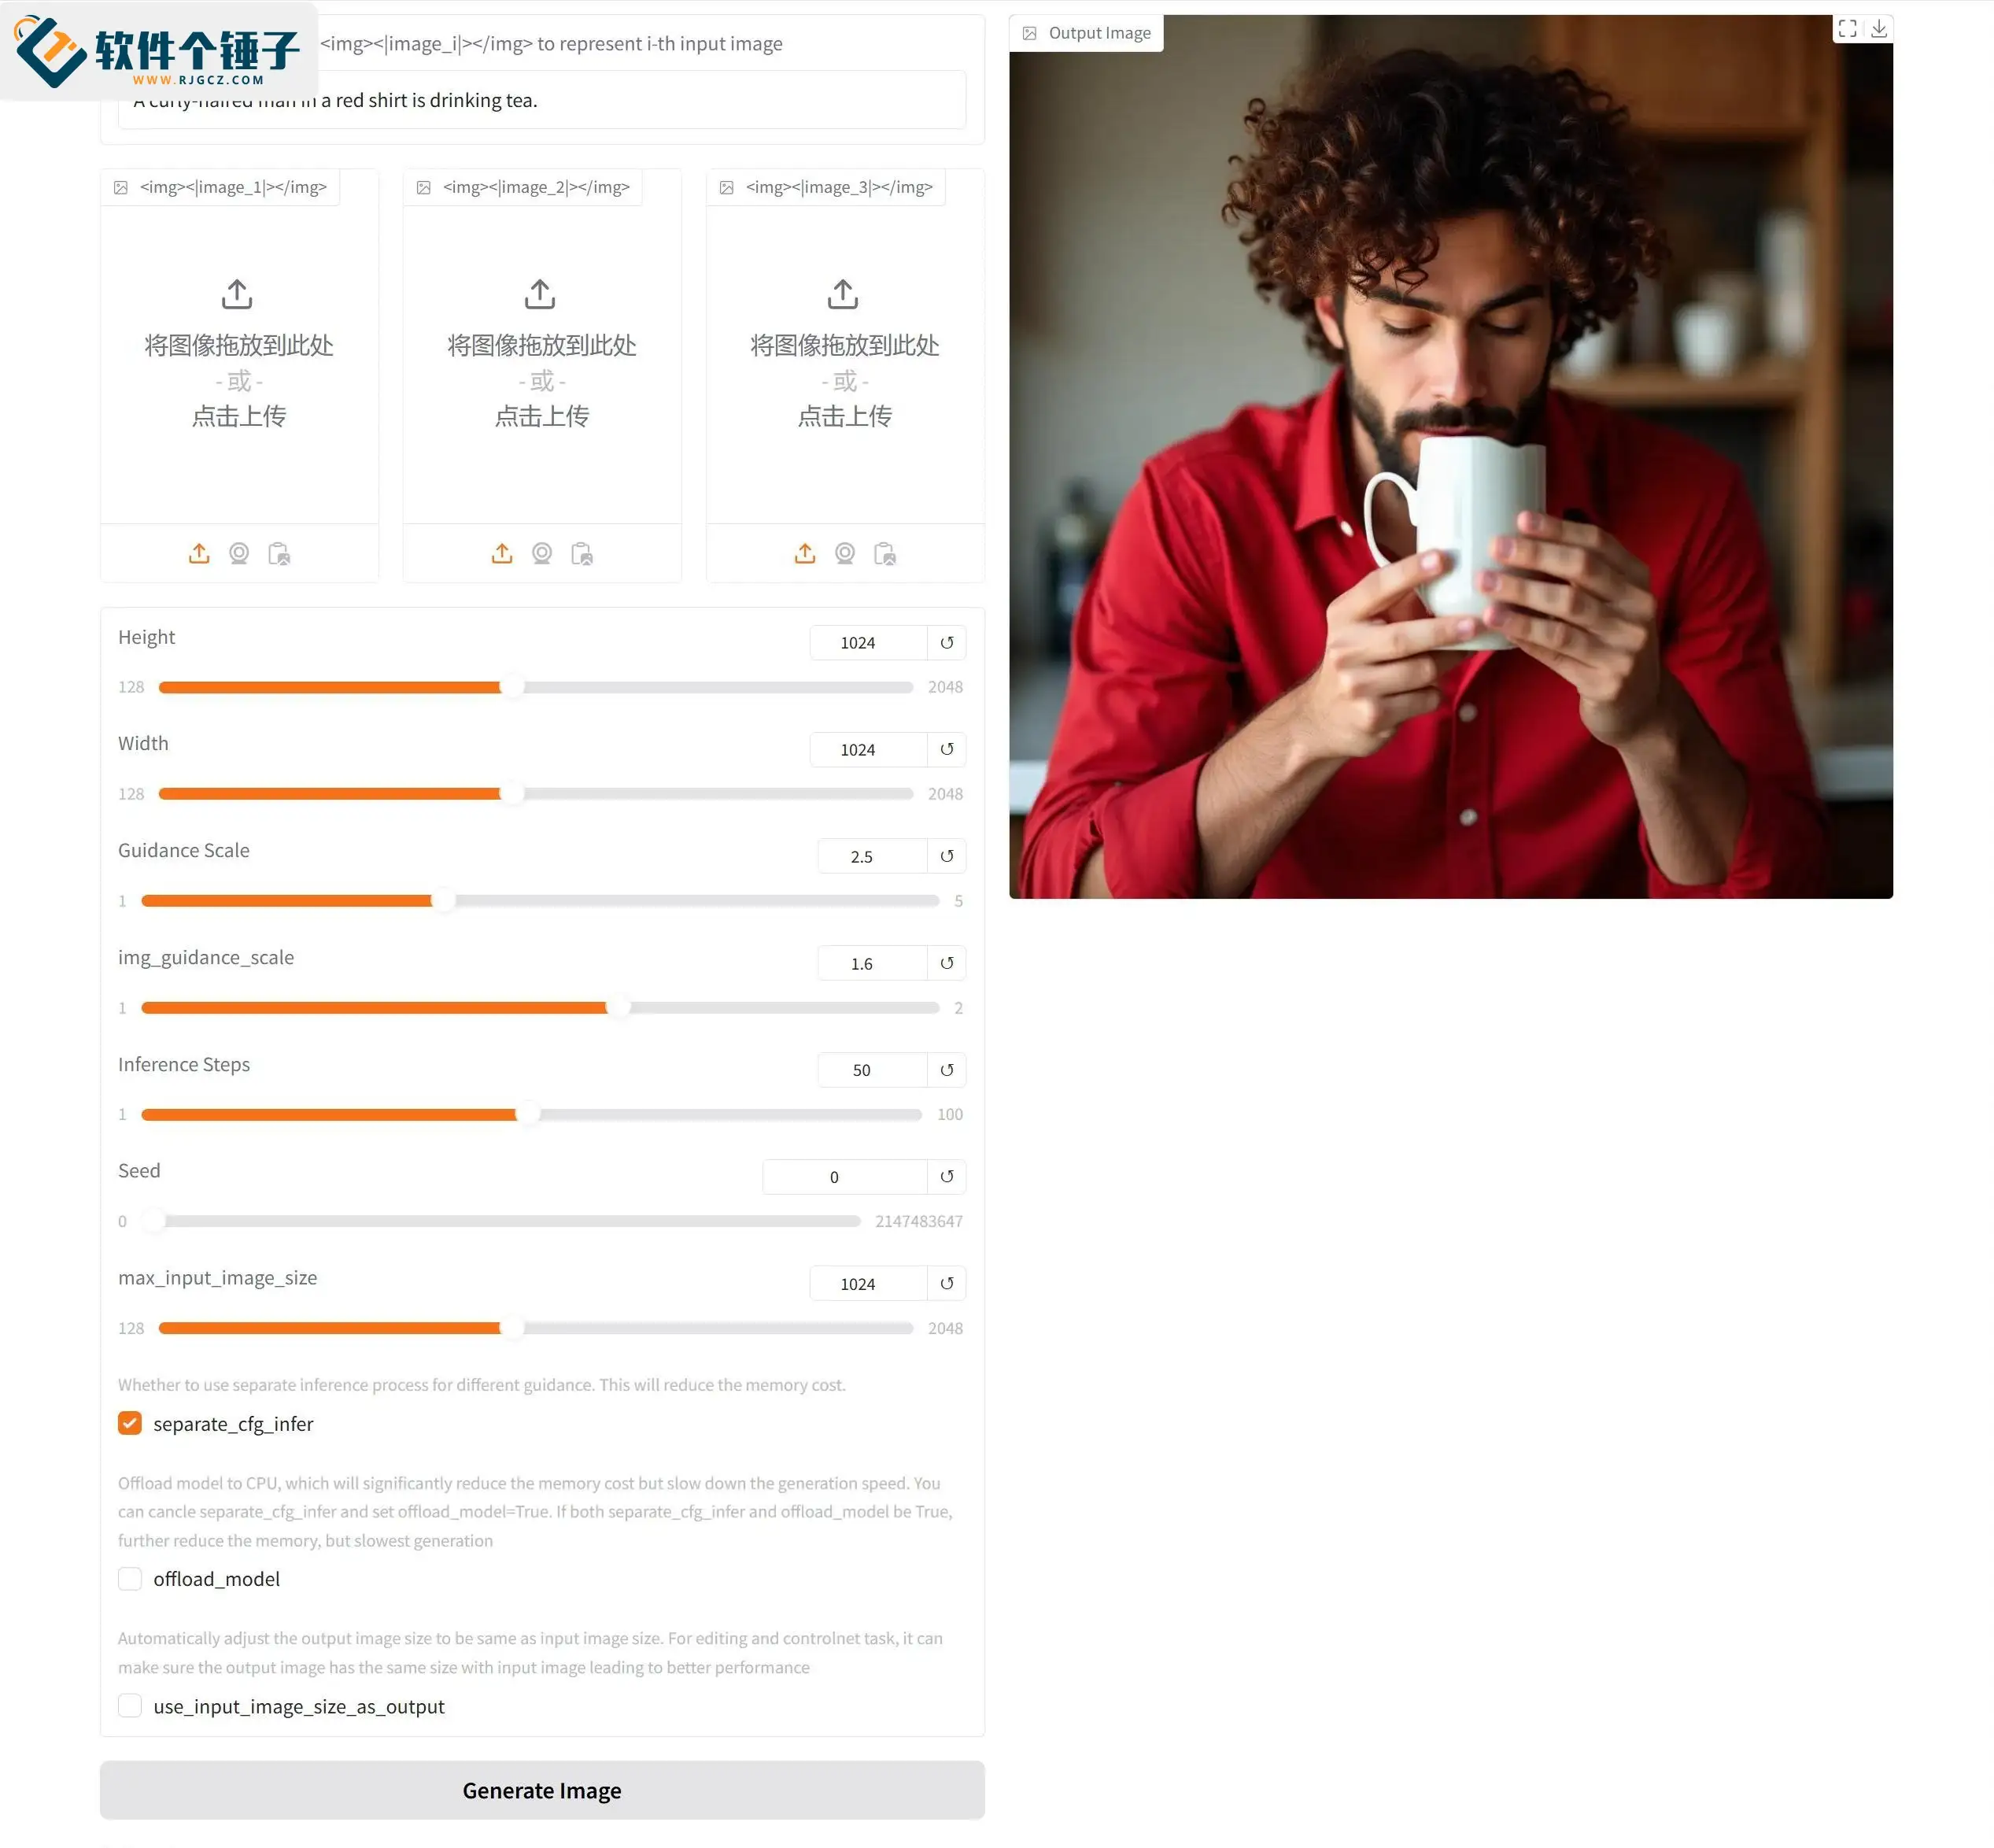
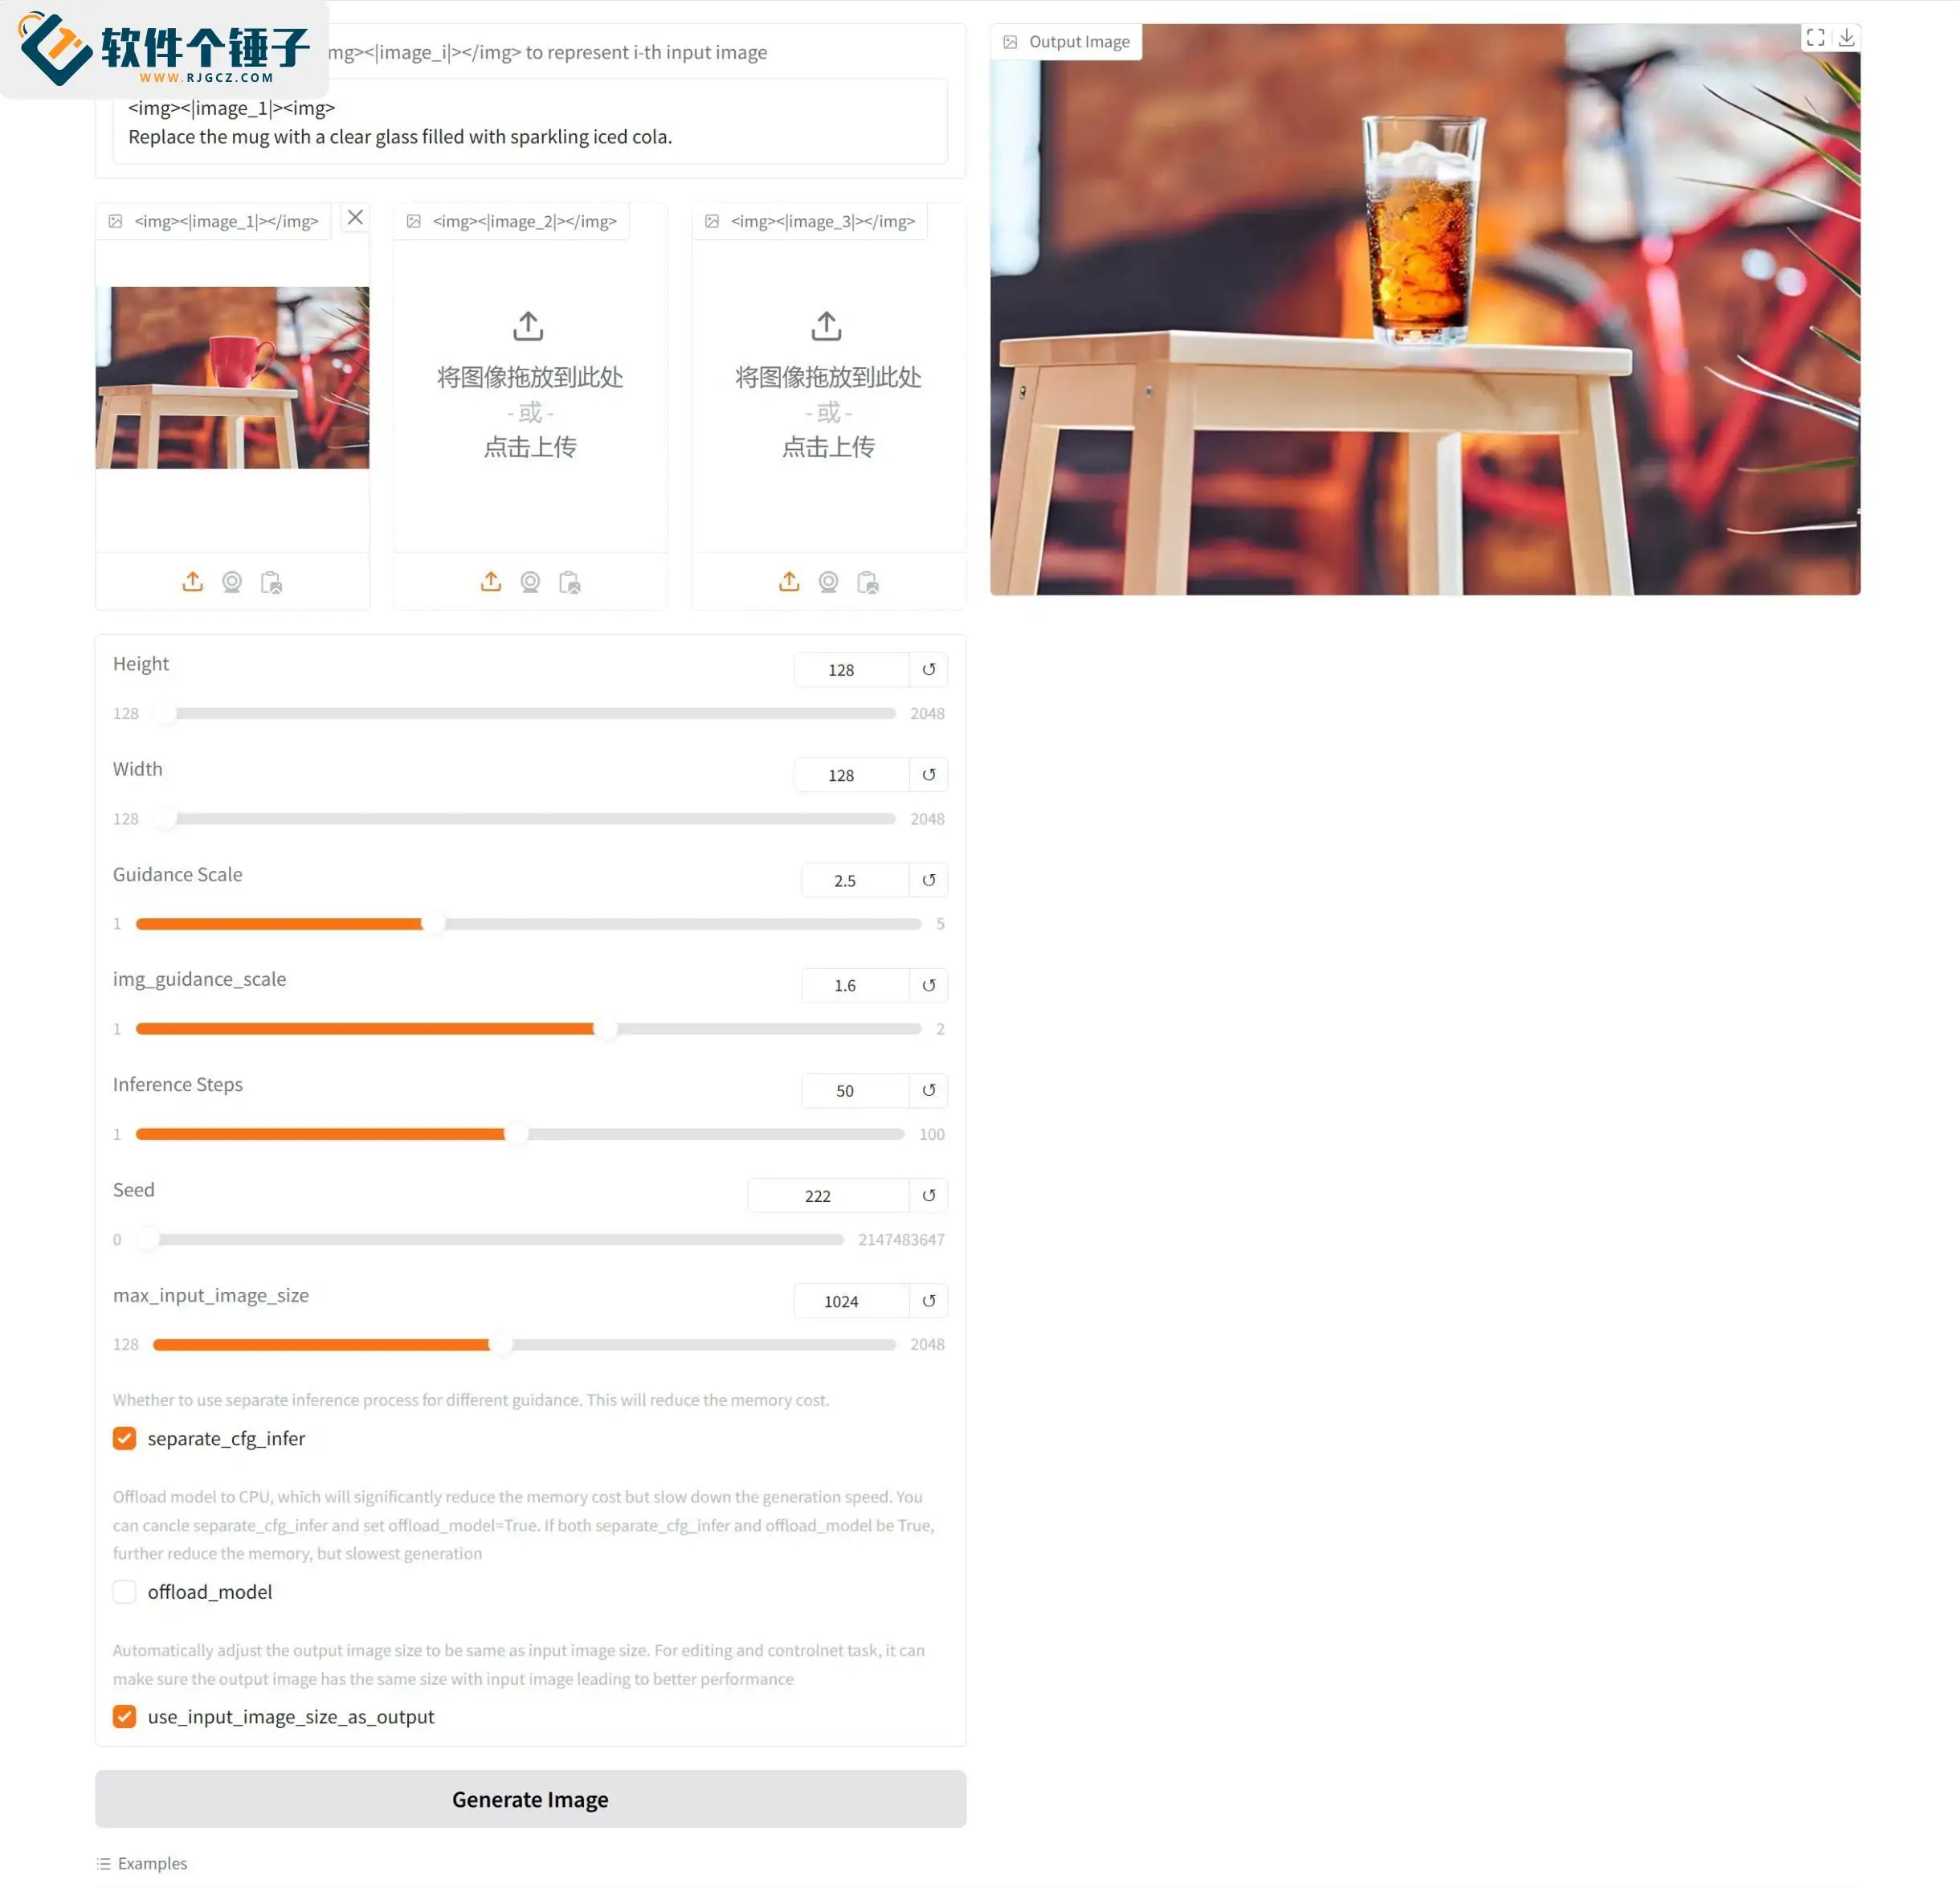
③ Sube una imagen (también puedes no subir ninguna), introduce el prompt (si en el prompt necesitas hacer referencia a una imagen subida, el formato del nombre de la imagen debe seguir estrictamente esta forma: <img><|image_i|></img> , de lo contrario no se reconocerá y dará error; la i puede cambiarse por los números 1, 2, 3), luego ajusta parámetros como el ancho y el alto, o mantén los valores predeterminados, y por último haz clic en enviar; el resultado generado aparecerá a la derecha

1. Generar una imagen a partir de un prompt
Prompt: A curly-haired man in a red shirt is drinking tea.
Traducción: Un hombre de pelo rizado con camisa roja está bebiendo té.

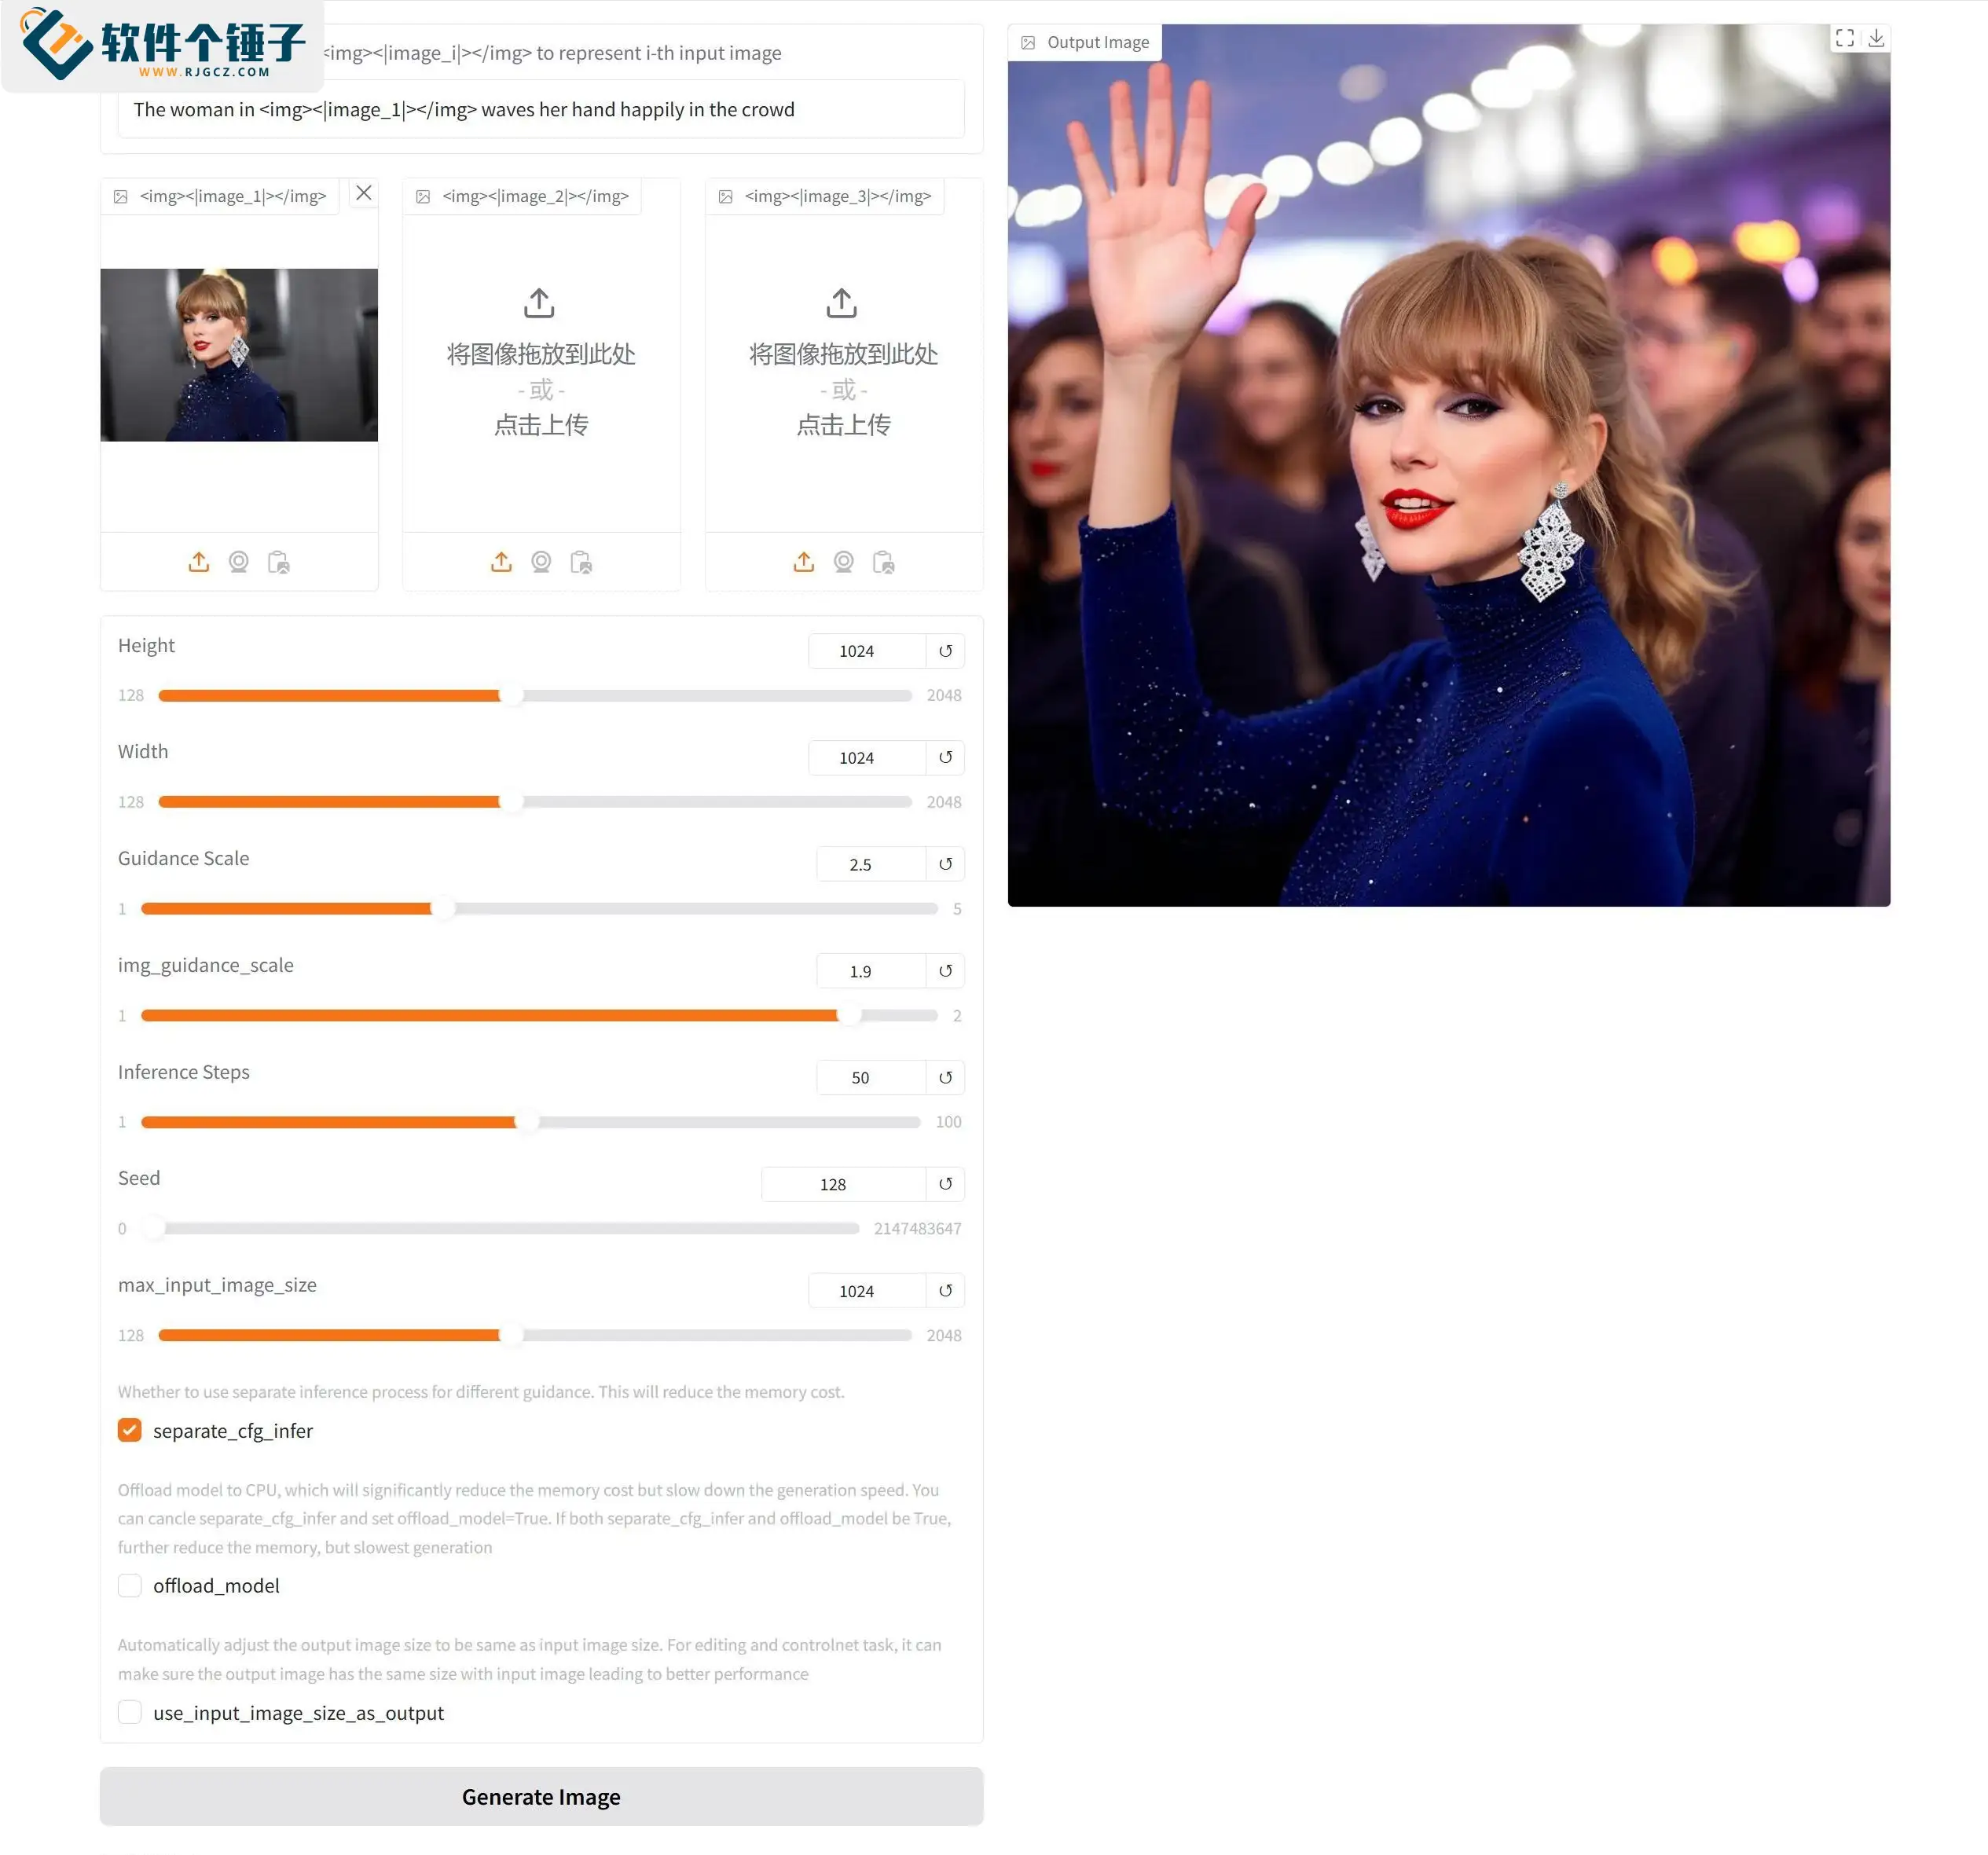
2. Generar una imagen con una sola imagen de referencia
Prompt: The woman in <img><|image_1|></img> waves her hand happily in the crowd.
Traducción: La mujer de <img><|image_1|></img> saluda alegremente con la mano entre la multitud.

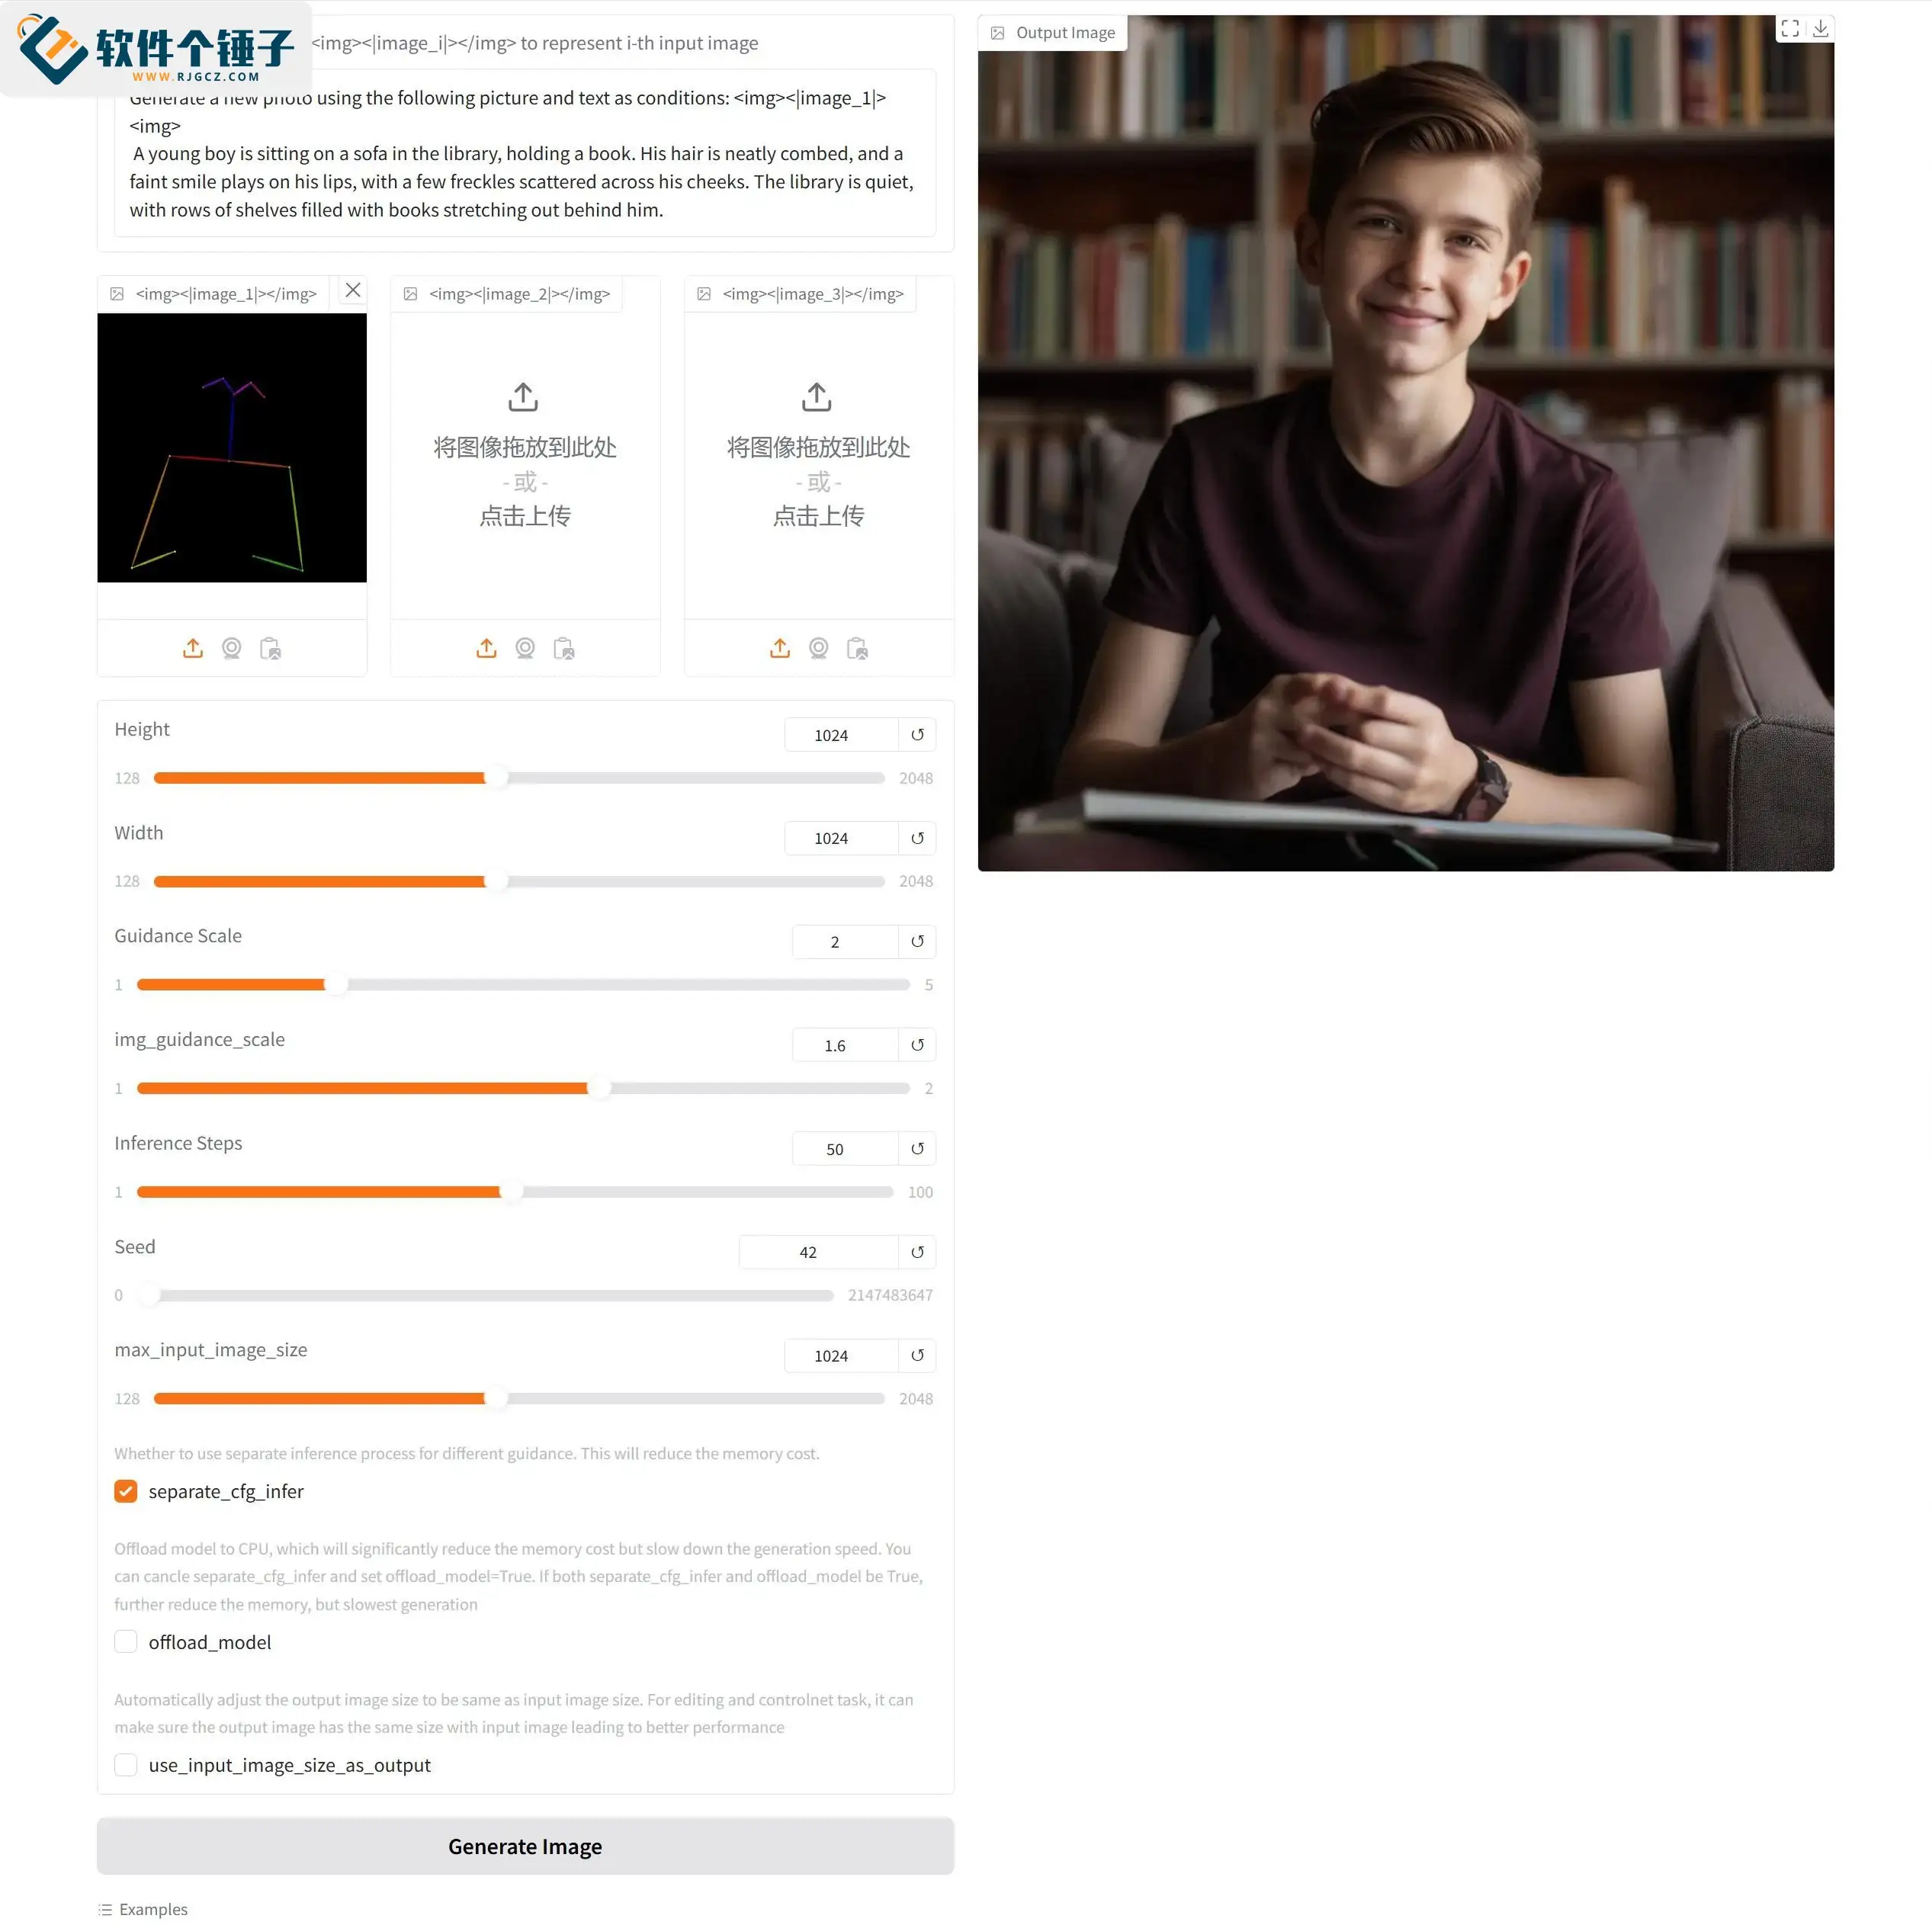
3. Generación basada en la postura
Prompt: Generate a new photo using the following picture and text as conditions: <img><|image_1|><img>
Un niño pequeño está sentado en un sofá de la biblioteca con un libro en las manos. Tiene el pelo bien peinado y una leve sonrisa en los labios, con algunas pecas repartidas por las mejillas. La biblioteca está en silencio, con hileras de estanterías repletas de libros que se extienden detrás de él.
Traducción: Genera una nueva foto usando la siguiente imagen y texto como condiciones: <img><|image_1|></img> Un niño pequeño está sentado en un sofá de la biblioteca con un libro en las manos. Tiene el pelo bien peinado y una leve sonrisa en los labios, con algunas pecas repartidas por las mejillas. La biblioteca está en silencio, con hileras de estanterías repletas de libros que se extienden detrás de él.

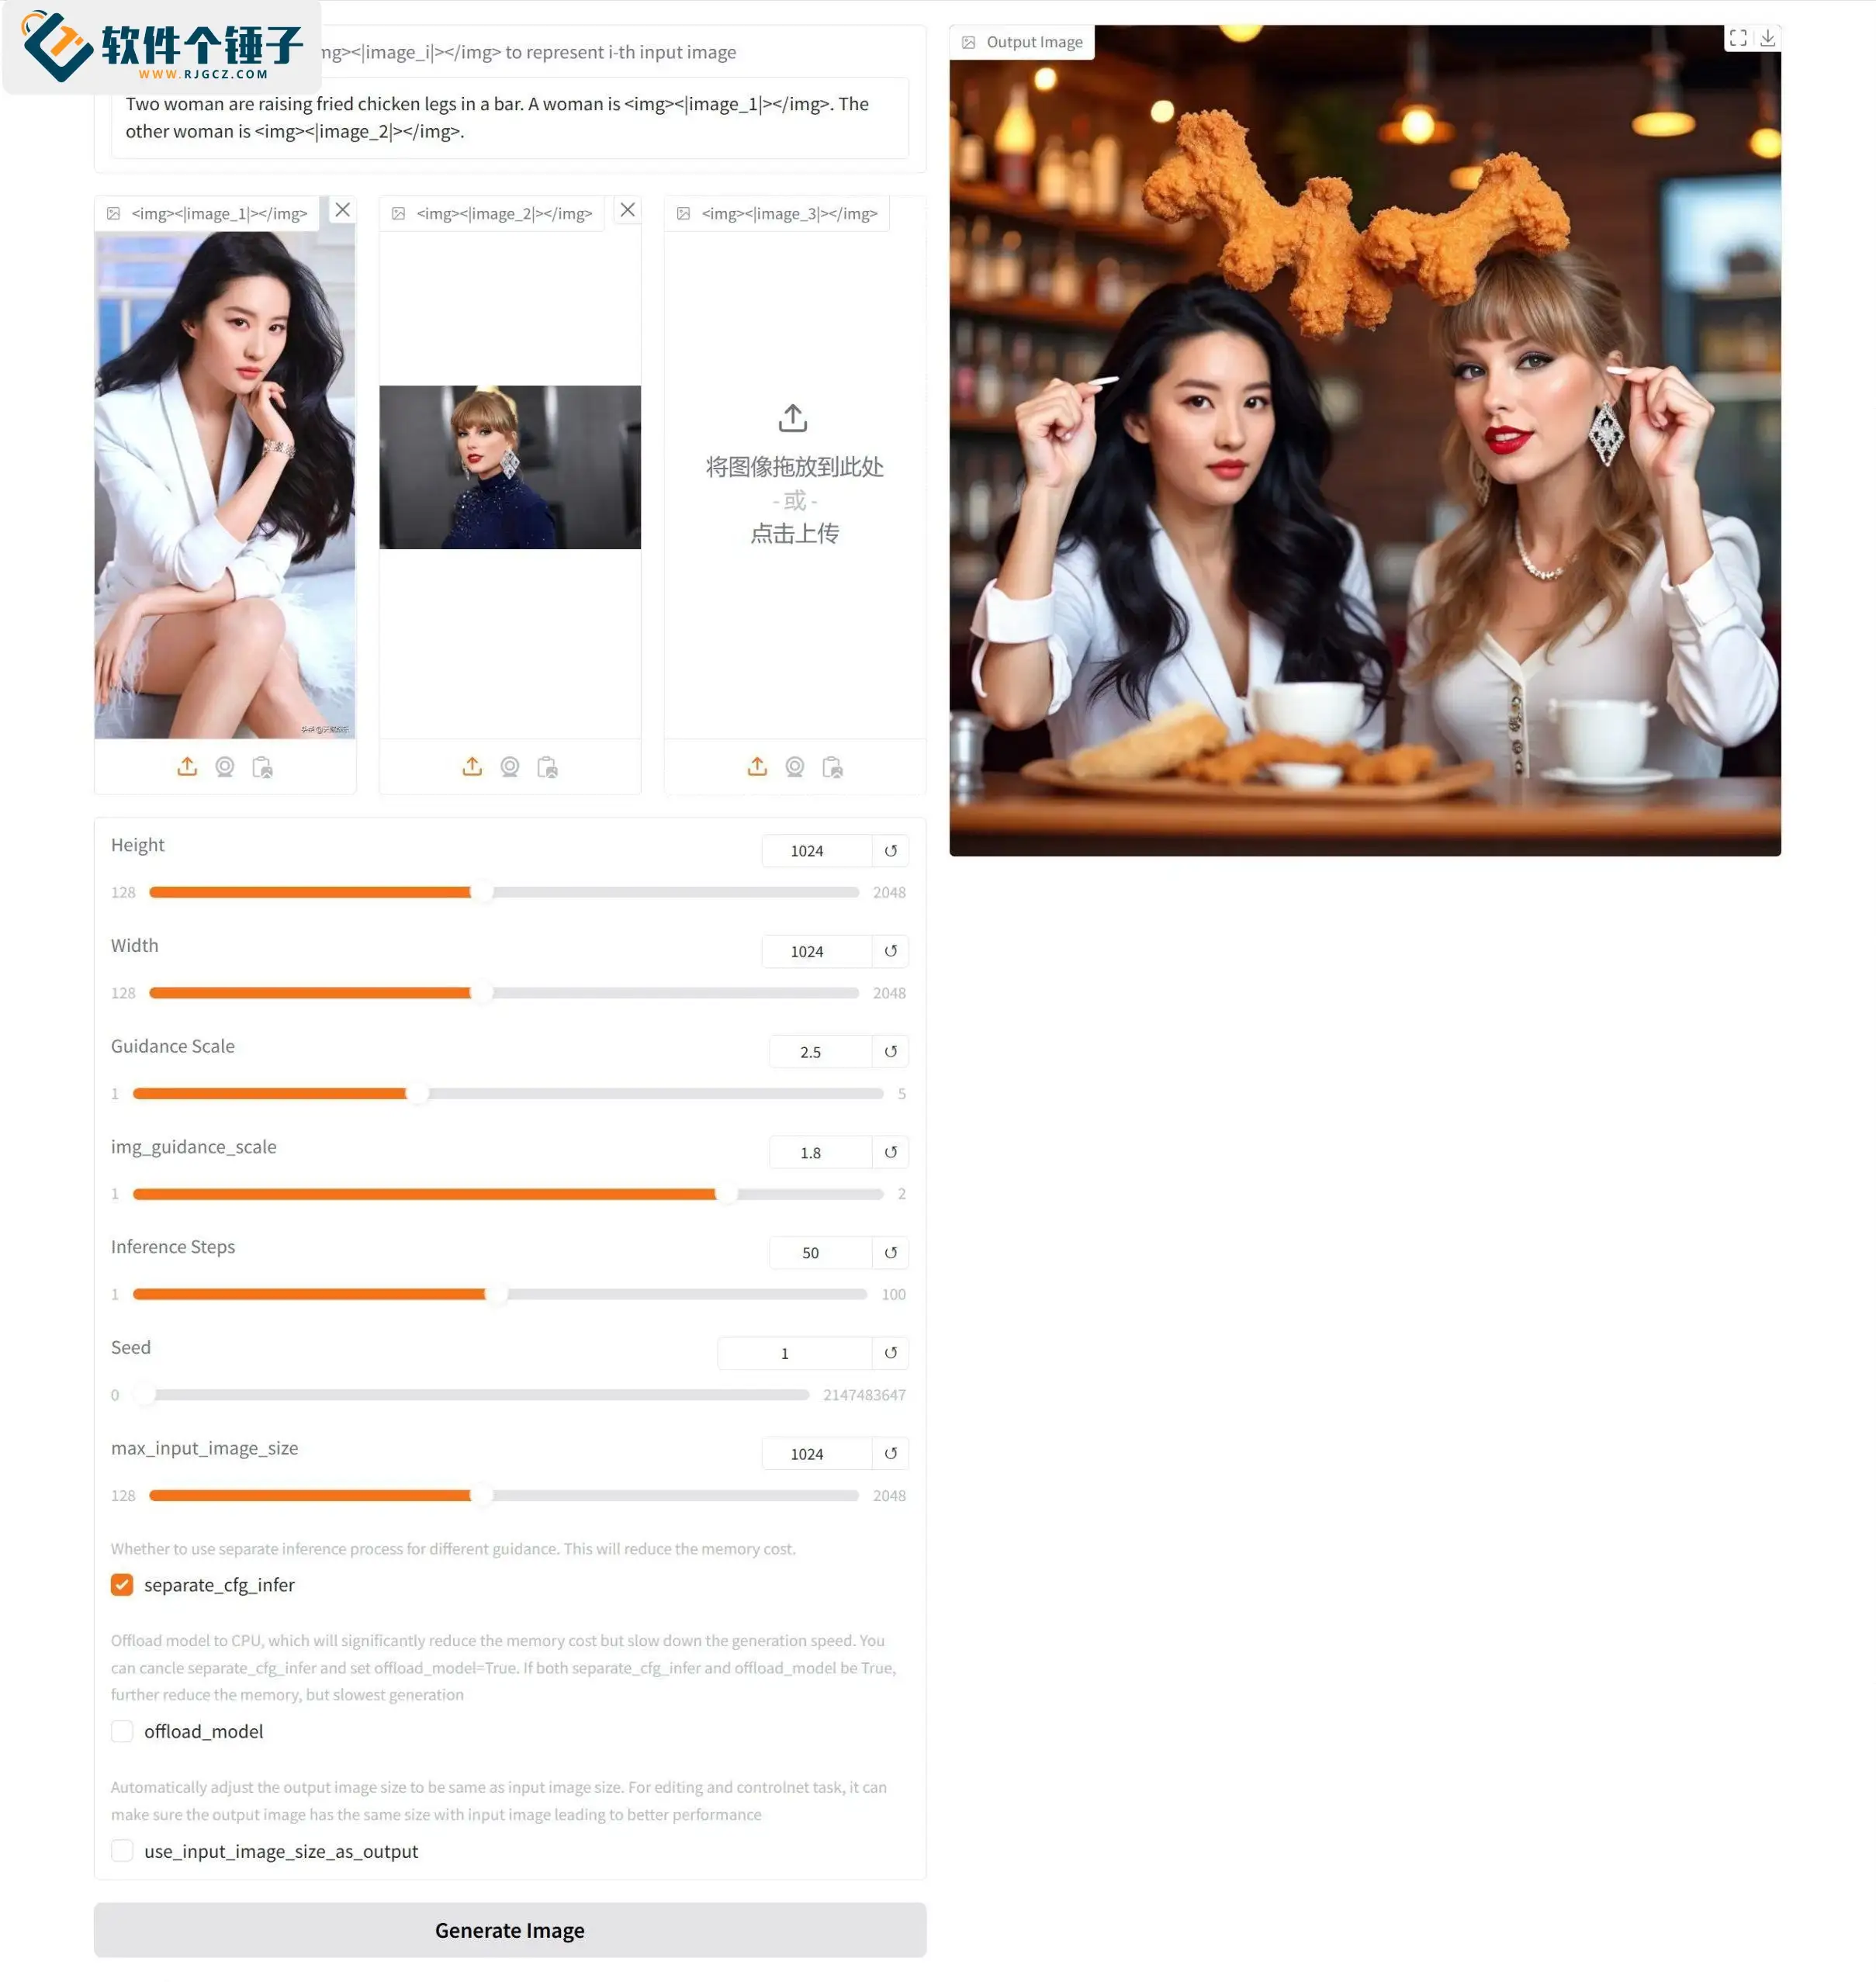
4. Colocar a los personajes de dos imágenes en una sola imagen
Prompt: Two woman are raising fried chicken legs in a bar. A woman is <img><|image_1|></img>. The other woman is <img><|image_2|></img>.
Traducción: Dos mujeres levantan muslos de pollo frito en un bar. Una mujer es <img><|image_1|></img>. La otra mujer es <img><|image_2|></img>.

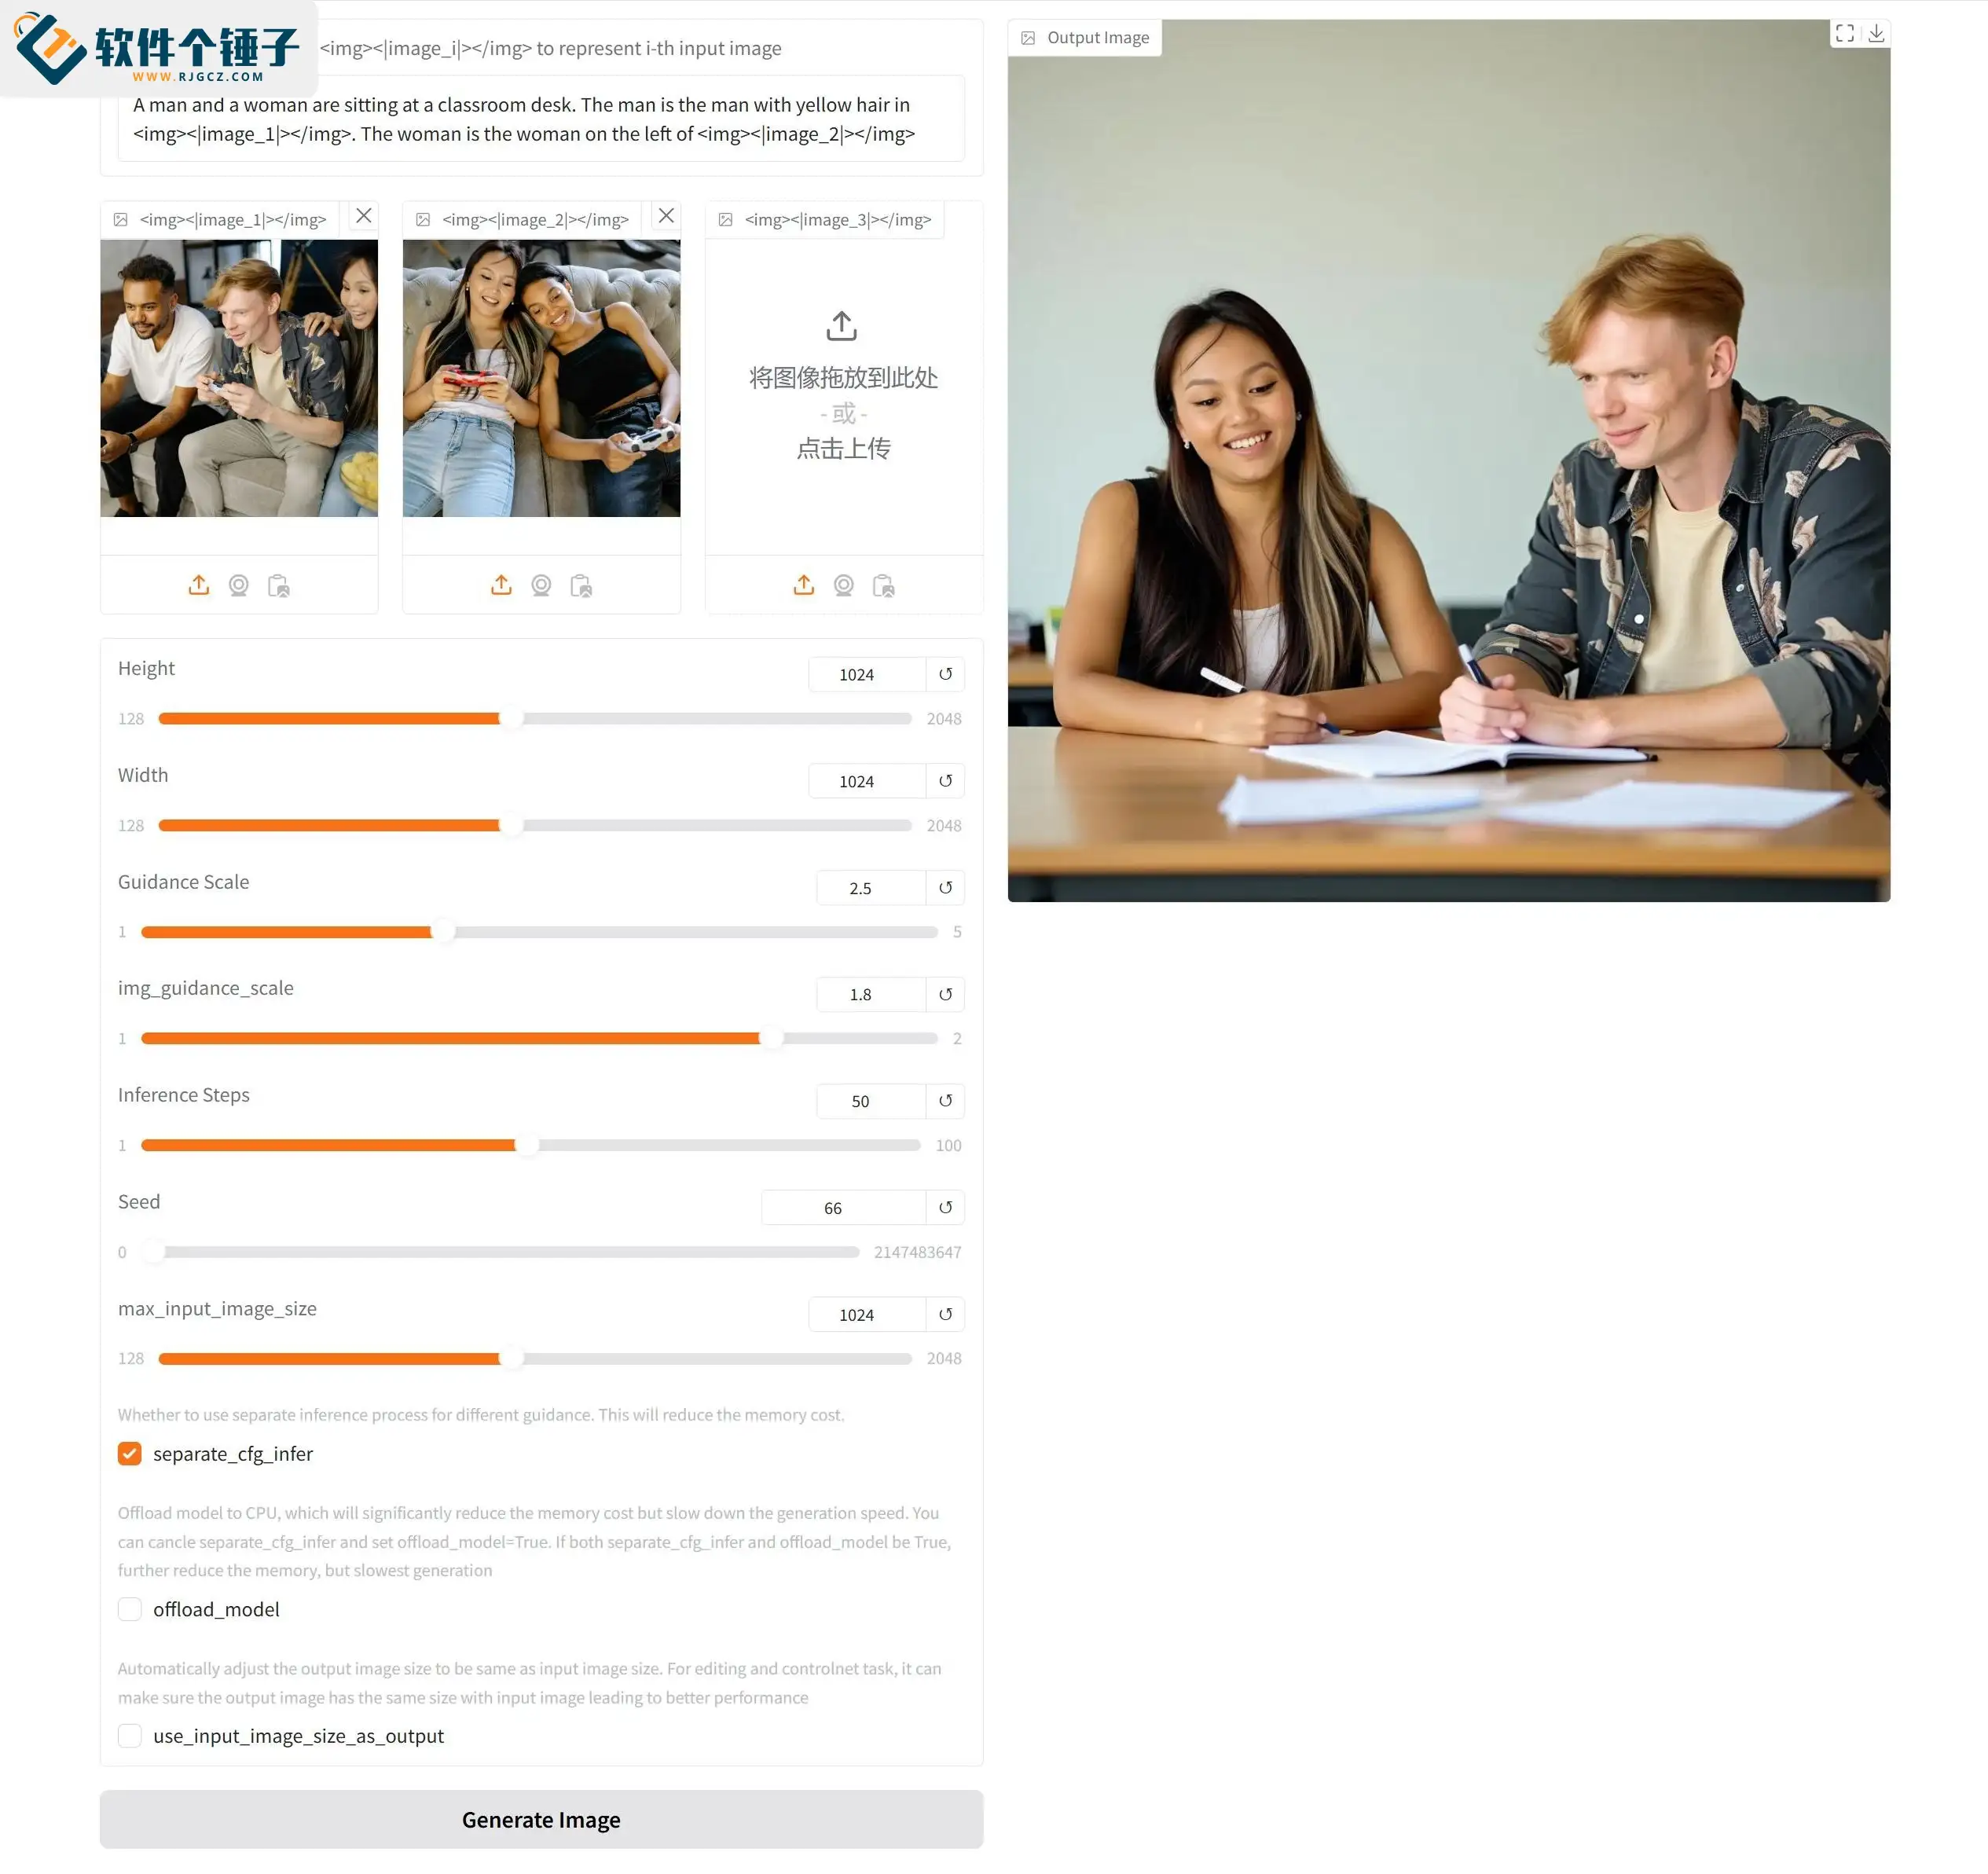
5. Extraer a una persona concreta de una multitud y colocarla en una imagen
Prompt: A man and a woman are sitting at a classroom desk. The man is the man with yellow hair in <img><|image_1|></img>. The woman is the woman on the left of <img><|image_2|></img>.
Traducción: Un hombre y una mujer están sentados en un pupitre de un aula. El hombre es el de pelo amarillo de <img><|image_1|></img>. La mujer es la que está a la izquierda de <img><|image_2|></img>.

6. Cambiar un objeto de la imagen
Prompt: <img><|image_1|><img>
Sustituye la taza por un vaso transparente lleno de cola helada con gas.
Traducción: <img><|image_1|><img>
Cambia la taza por un vaso transparente lleno de cola helada con gas.

Dirección de código abierto
[Dirección oficial de OmniGen]
Cursos relacionados

¡Súper caja de herramientas local! Grabación de pantalla integrada, corte y unión de audio y vídeo, compresión y extracción de vídeo, gratis para siempre - Kedou Video Converter

¡Herramienta gratis 100% perfecta! Software PDF multifunción todo en uno: convertir, comprimir y editar PDF, minimalista, sin anuncios, tan bueno - JOPDF

¡Herramienta de escritorio remoto de código abierto, superior a las versiones de pago! Gratis e ilimitada para uso personal y comercial, multiplataforma – HopToDesk

Última herramienta de descarga de libros de primaria y secundaria: recursos de un curso completo, diapositivas, videos y audio con un clic

Todo el día frente a la pantalla, ¿sin una herramienta de protección ocular? Llega una aplicación gratuita de protección contra la luz azul para PC, con una mascota que te recuerda descansar, Huyanbao

PyIsland: centro de control del sistema moderno con Dynamic Island en el escritorio de Windows

Producción de manhua 3D simulada: práctica completa de Seedance 2.0, te lleva de 0 a 1 a crear manhuas de alta calidad

¡Compatible con Win/Mac! Última versión de por vida: restaura fotos antiguas, mejora la nitidez y amplía sin pérdida - Aiarty Image Enhancer

Herramienta de descarga de Bilibili de código abierto en Github: descarga por lotes de vídeos de Bilibili con soporte 8K y Dolby Vision, fácil de usar, Bilidown

Colección de herramientas de escritorio para Windows: más de 50 widgets prácticos y minimalistas, con captura de pantalla, grabación, traducción, clima, etc., caja de herramientas Duomi

Datos de contacto
- Correo electrónico: massivesidehustles@outlook.com
