




多機能画像生成モデル統合パッケージ OmniGen 無料オープンソース ワンクリック起動 デプロイ・認証不要【ソフトのハンマー・R2255】
-

热門游戏全自動搬砖、日入500+、无需経験操作簡単、目前最稳定的長期搬砖副業「揭秘」
会員向け参考学習資料 会員になる






-
PC版 動画編集処理ソフト Aiseesoft Filmai v1.0.18
会員向け参考学習資料 会員になる -
Microsoft To Do v2.147 公式無料版
会員向け参考学習資料 会員になる





OmniGenは智源が発表した新しい拡散モデルアーキテクチャで, 統合的な画像生成に特化しています. 画像生成の複雑な流れを簡素化し, 1つのフレームワークでテキストからの画像生成, 画像編集, 視覚条件に基づく生成など多様なタスクを処理します. さらにOmniGenは統一的な学習構造により知識の転移を実現し, さまざまなタスクや領域のニーズに適応できます. このモデルは高度に簡素化され使いやすいだけでなく, 画像生成の分野で強い柔軟性を示しています.

ソフトの特徴:
統一性: OmniGenはテキストからの画像生成, テーマ駆動生成, 画像編集, 視覚条件に基づく生成など, 多様な画像生成タスクを一体的に処理できます. その革新性は, コンピュータビジョンの従来タスクを画像生成タスクへ変換し, 一体化した画像生成体験を提供する点にあります.
簡素性: OmniGenは他のモデルに多い煩雑な操作フローを排し, ControlNetやIP-Adapterなどのプラグインを必要とせず, タスク処理がより直感的です. ユーザーは簡潔な指示で複雑なタスクを完了でき, 操作のハードルが大幅に下がります.
知識の転移: 統一形式での学習により, OmniGenは異なるタスク間で知識を転移でき, 特に見たことのないタスクや領域に適しています. この過程でOmniGenは"思考の連鎖"メカニズムの応用を探求し, 画像生成においてより柔軟な推論と文脈学習の能力を持ちます.
ソフト機能:
テキストからの画像生成: テキストの記述から対応する画像を生成します.
画像編集: ユーザーのニーズに応じて画像を部分的または全体的に編集します.
キャラクター一貫性の生成: 複数の画像間でキャラクターの外見を一致させます.
視覚条件に基づく生成: 視覚条件(姿勢や輪郭情報など)に基づき, 特定の要件に合う画像を生成します.
動作環境:
パソコンは以下の構成を満たすことを推奨します:
OS: Windows 10/11 64ビット
グラフィックカード: 8Gのビデオメモリでも使用可能ですが生成速度は遅く, 8G以上のビデオメモリを搭載したNVIDIAのグラフィックカードを推奨,
CUDA >= 11.8
パッケージ全体は解凍後約24.5Gなので, 十分なハードディスク容量を確保してください
パソコンにCUDAがインストールされていない場合はインストールのチュートリアルを参照:
グラフィックカードのブランド·型番とビデオメモリを確認する方法:
タスクマネージャーを開く
"パフォーマンス"をクリック
"GPU"をクリック
右上にグラフィックカードの型番, 下部にビデオメモリの容量が表示されます

使用チュートリアル:
① 統合パッケージをダウンロードして解凍;
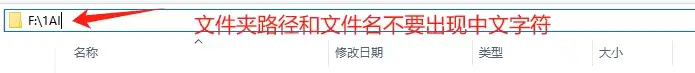
注意: フォルダーのパスとファイル名(音声, 画像, 動画などのファイル名を含む)に中国語の文字を使わないでください. 一部のソフトが認識できずエラーになります

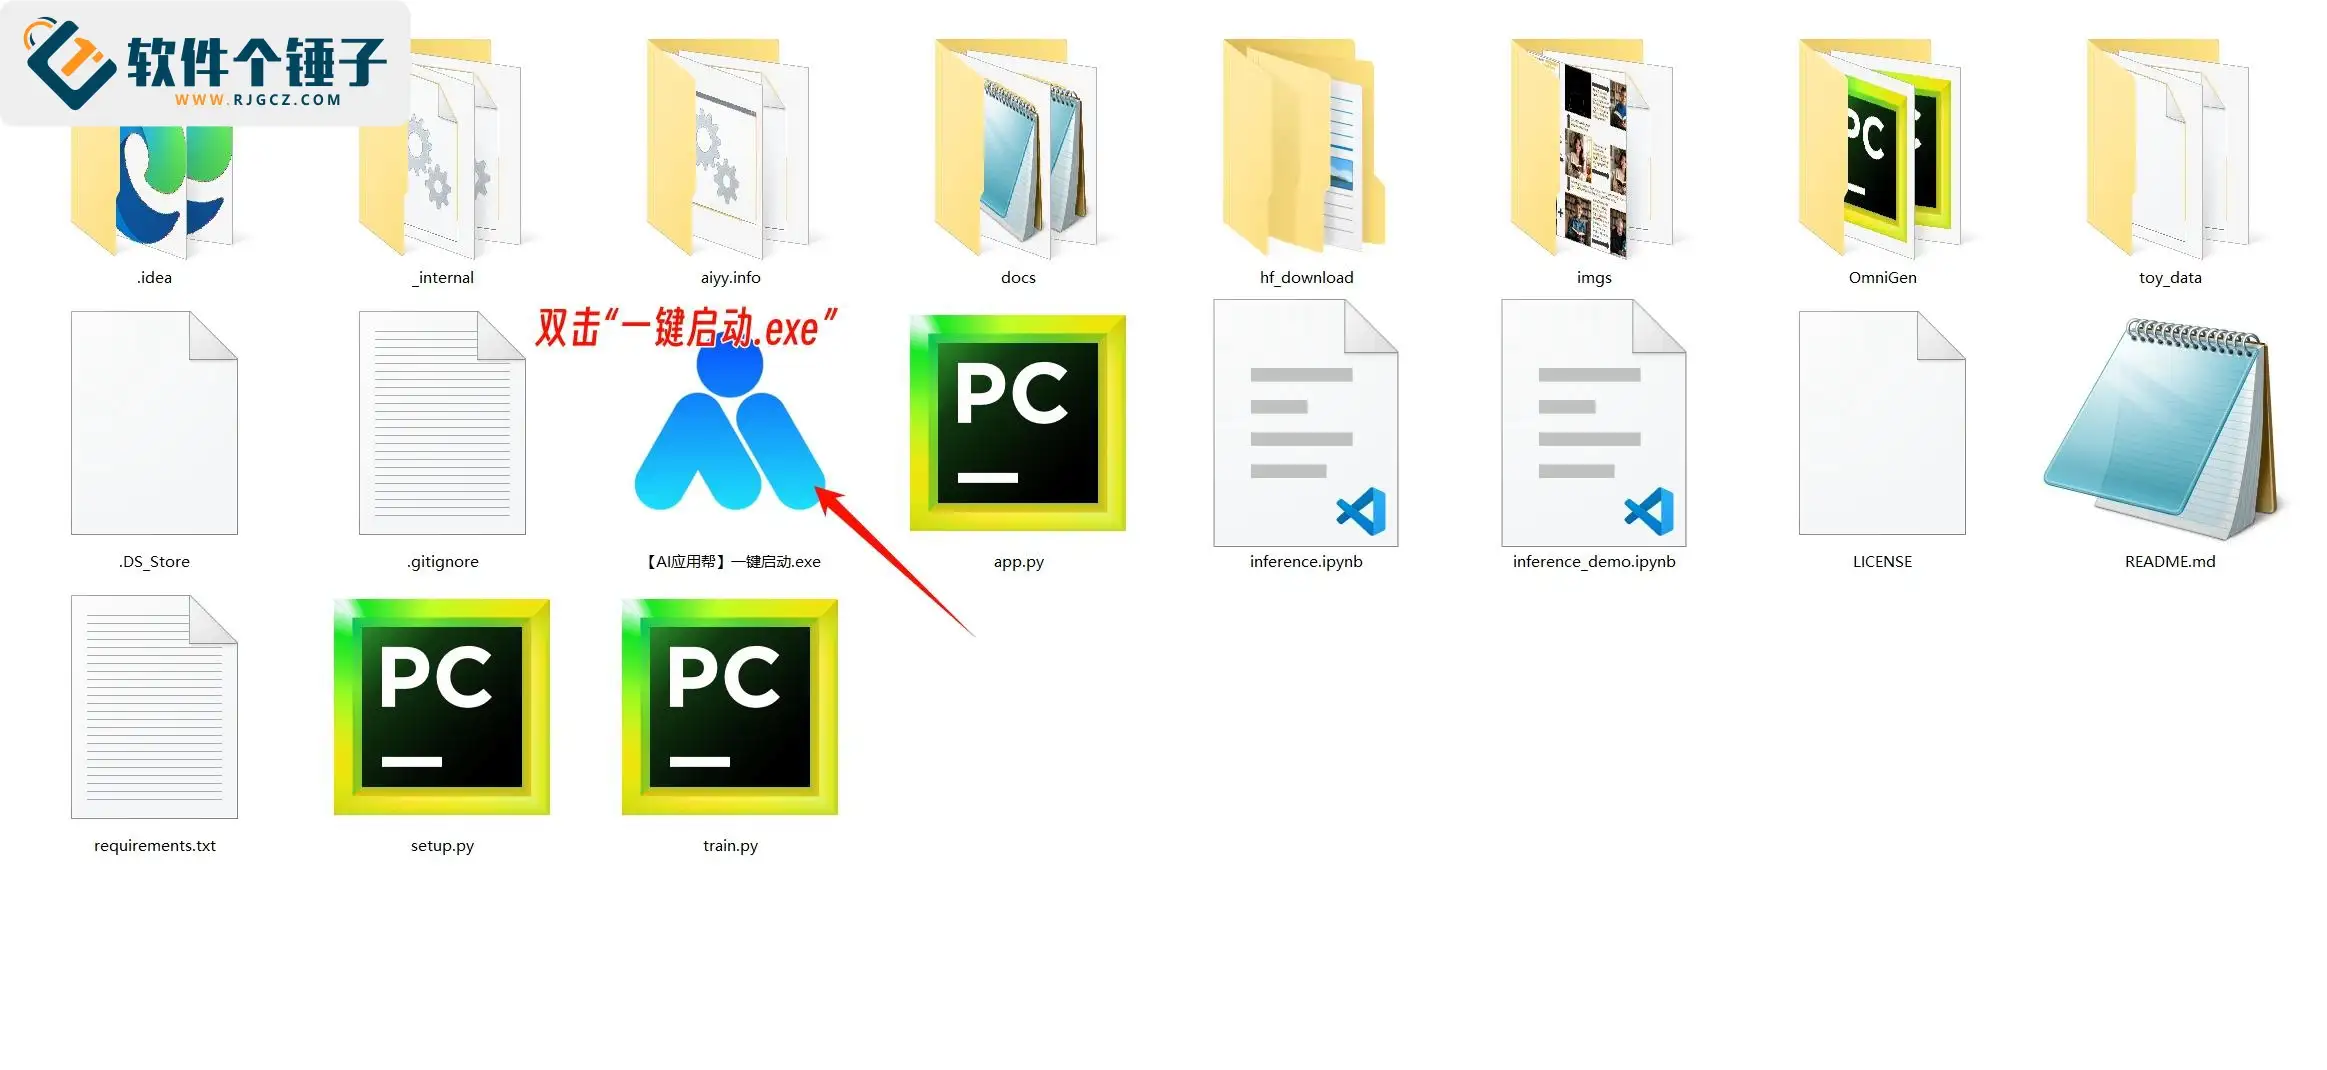
(2) "ワンクリック起動.exe"をダブルクリックし, しばらく待つとブラウザで操作画面が自動的に開きます

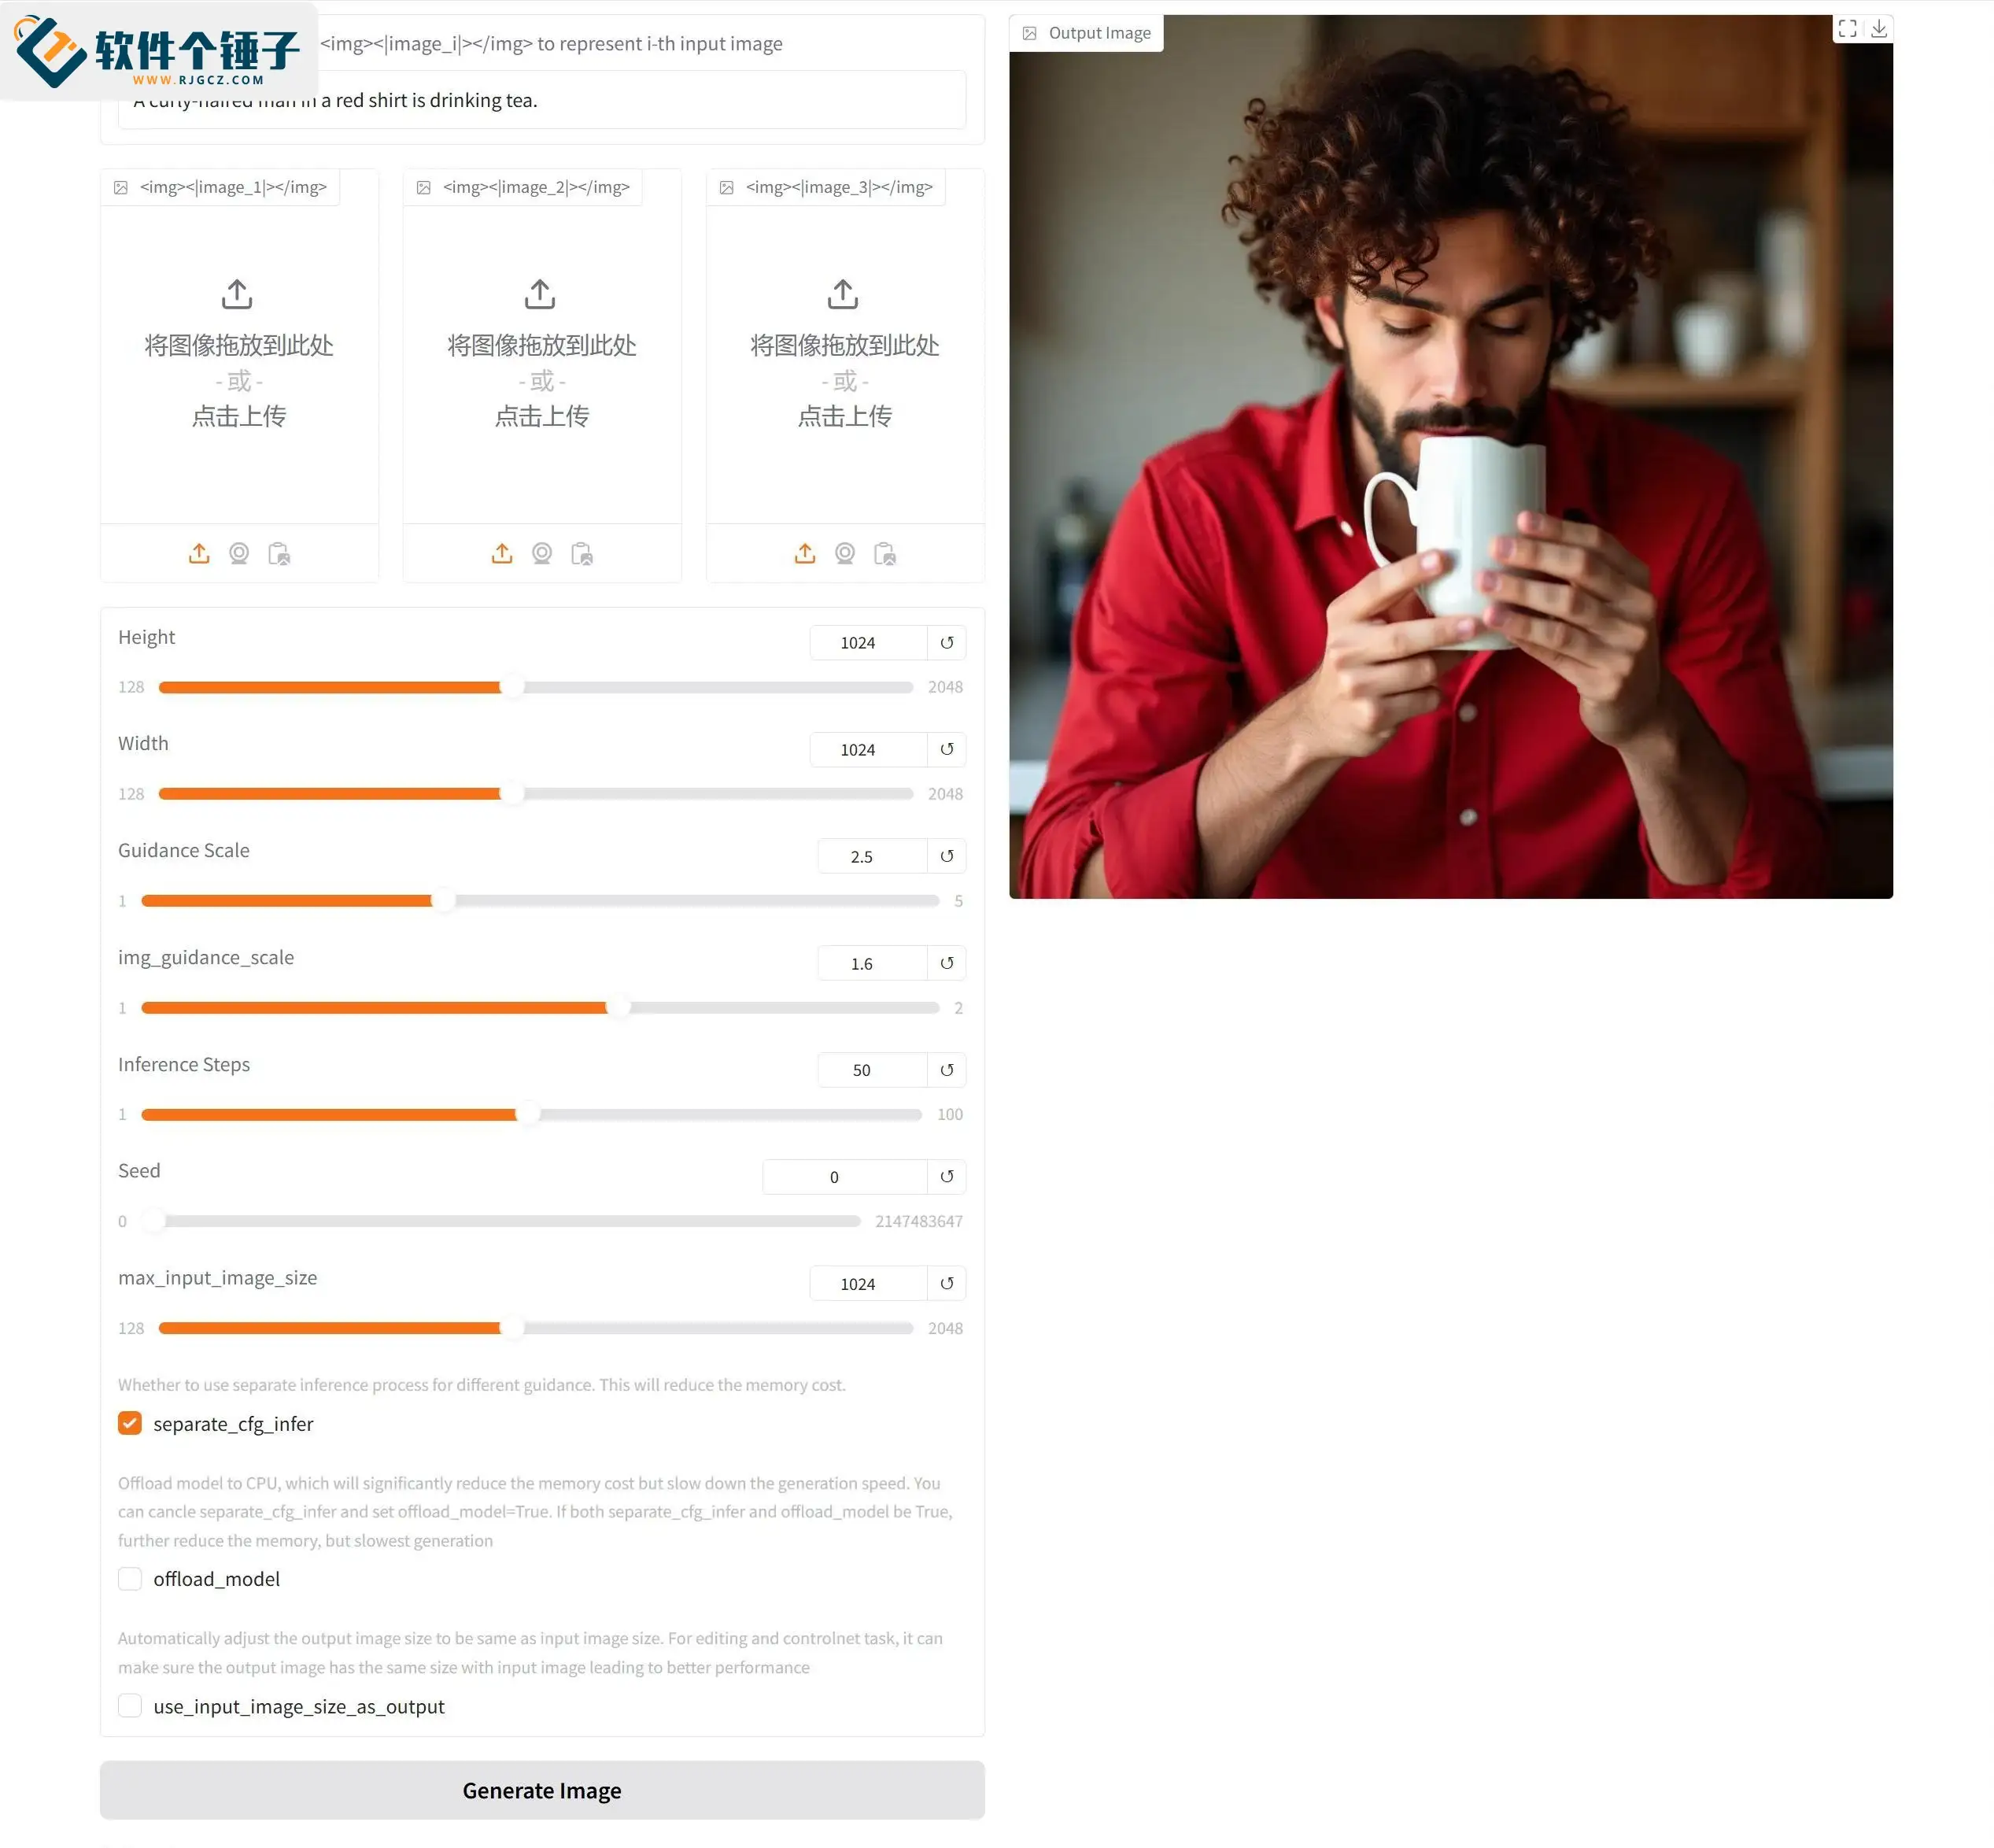
(3) 画像をアップロードし(アップロードしなくても可), プロンプトを入力し(プロンプト内でアップロード画像を参照する場合, 画像名の形式は<img><|image_i|></img>の形式を厳守してください. そうでないと認識されずエラーになります. iは番号1, 2, 3に変更できます), その後幅や高さなどのパラメータを調整し, 既定のままでも構いません. 最後に送信をクリックすると, 生成結果が右側に表示されます

1. プロンプトで画像を生成
プロンプト: A curly-haired man in a red shirt is drinking tea.
翻訳: 赤いシャツを着た巻き毛の男性がお茶を飲んでいます.

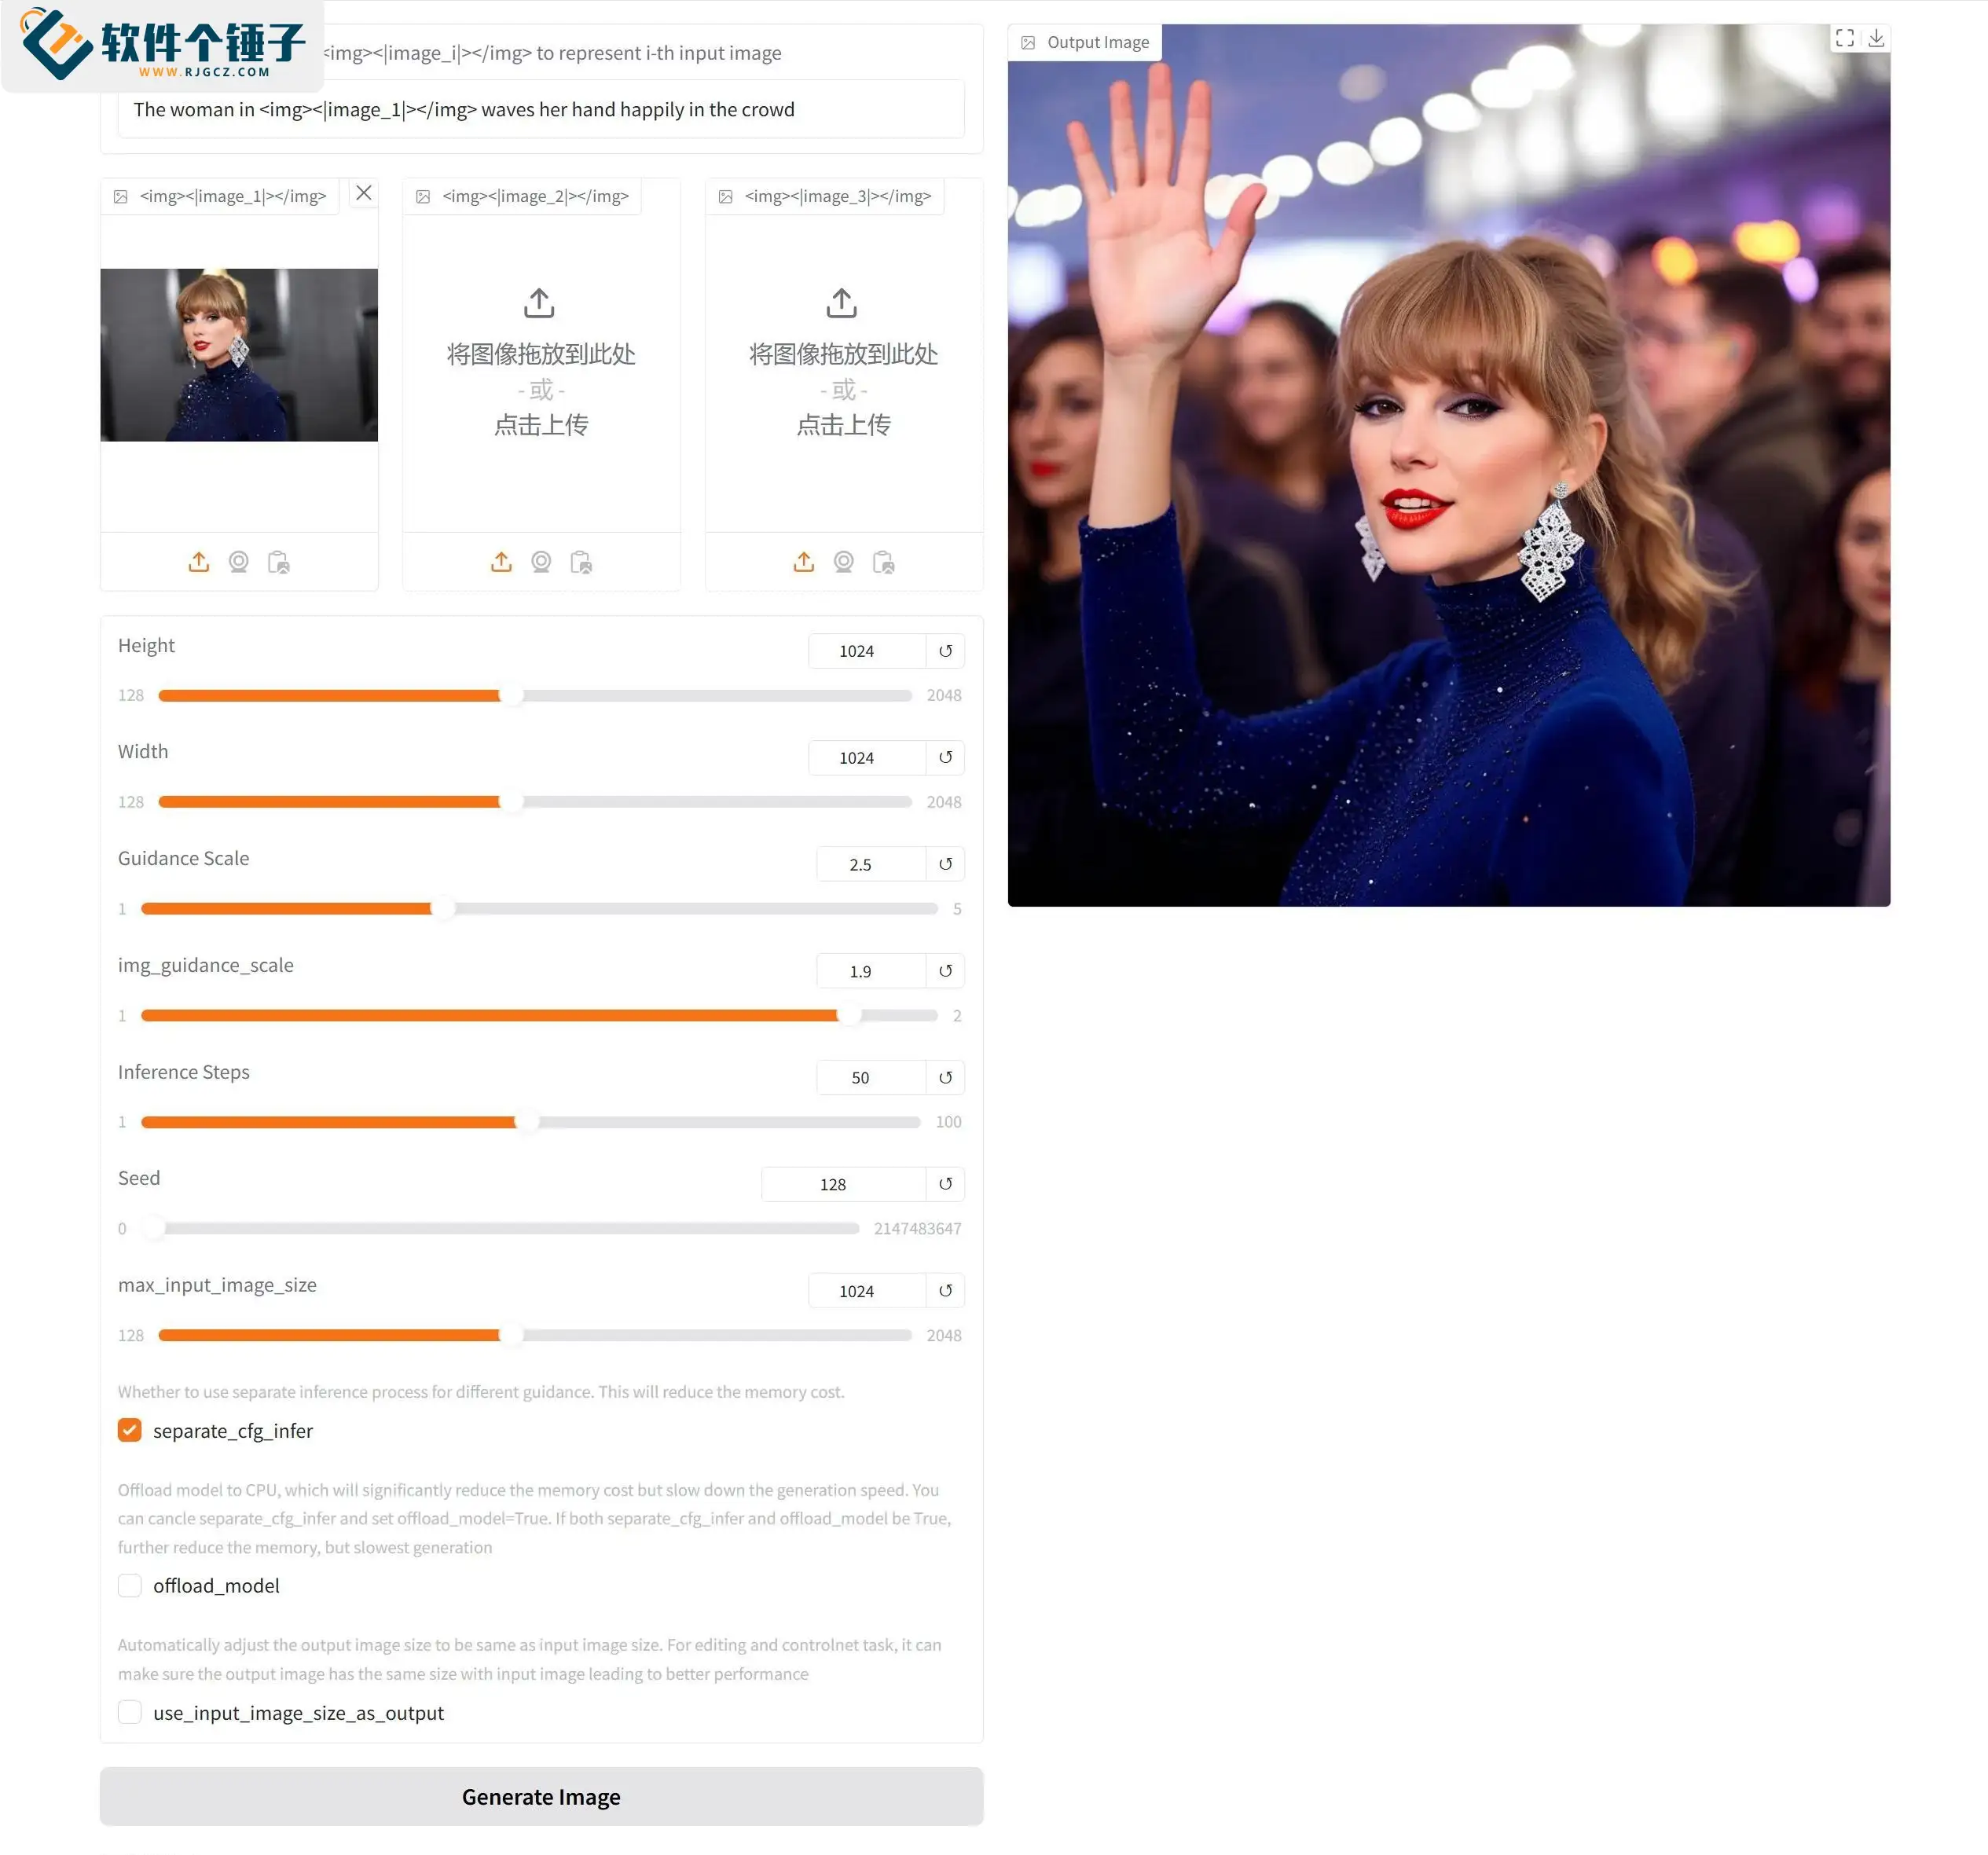
2. 1枚の参照画像で画像を生成
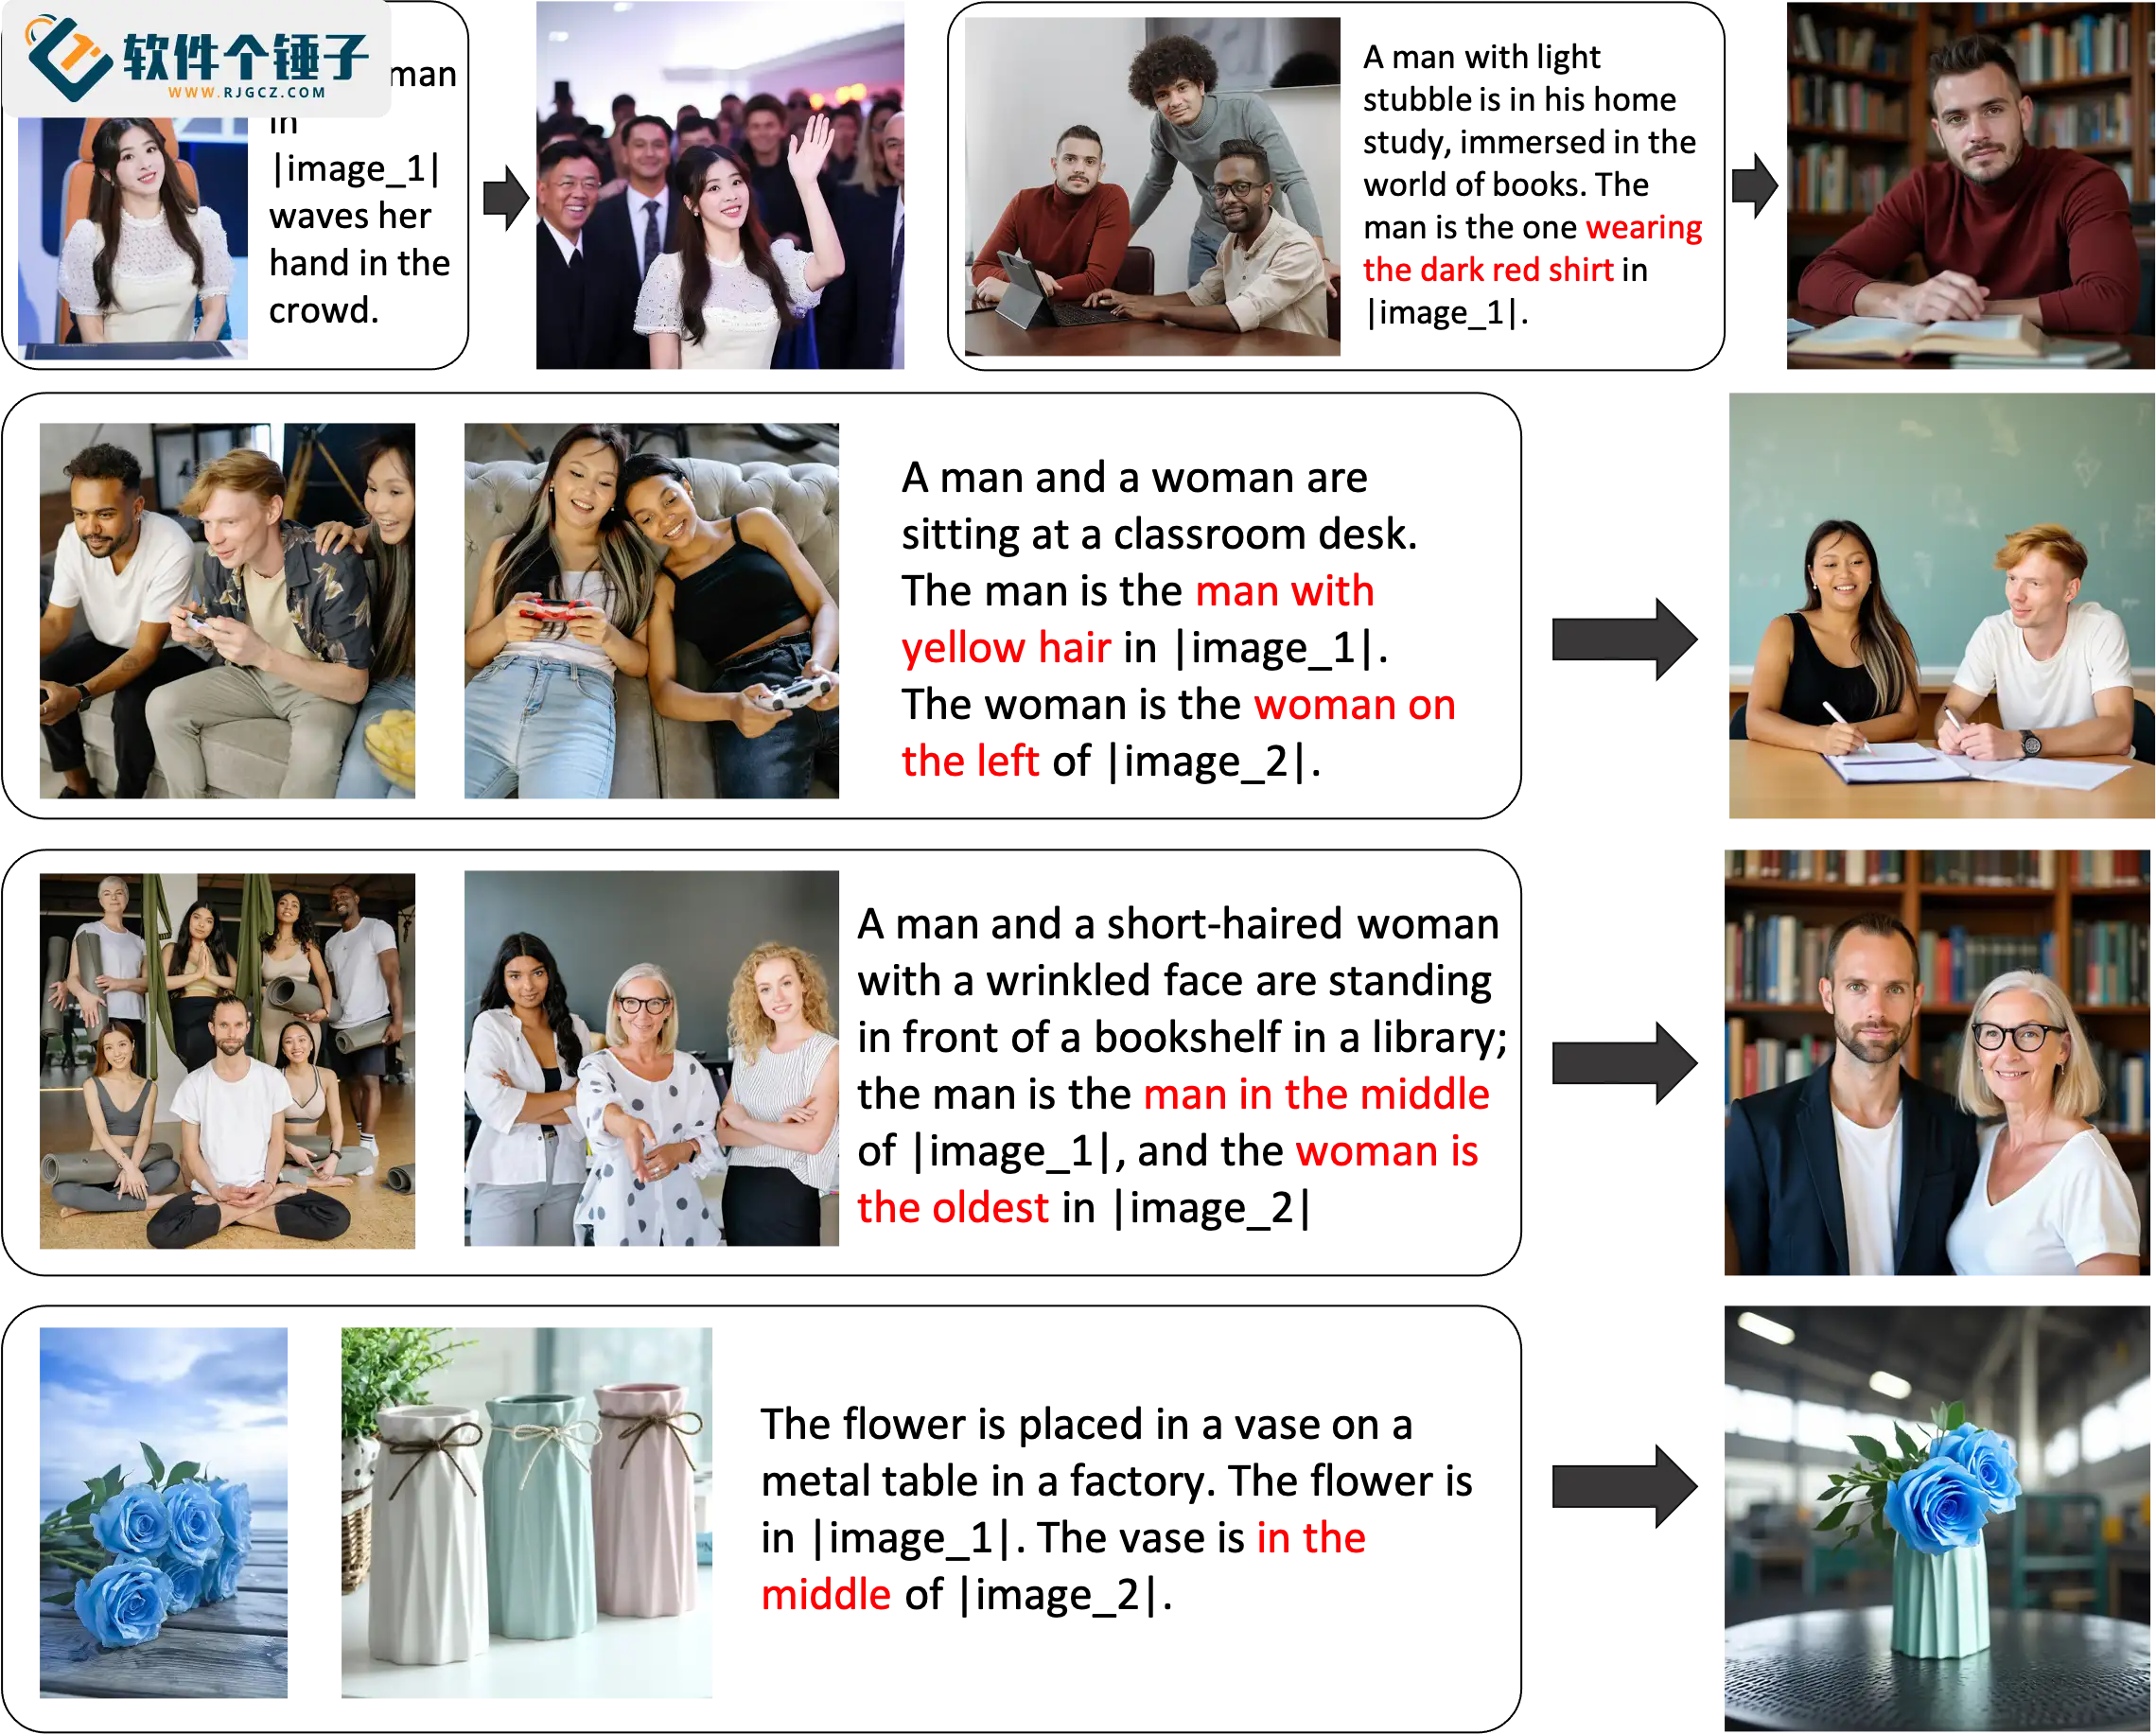
プロンプト: The woman in <img><|image_1|></img> waves her hand happily in the crowd.
翻訳: <img><|image_1|></img>の中の女性が群衆の中で嬉しそうに手を振っている。

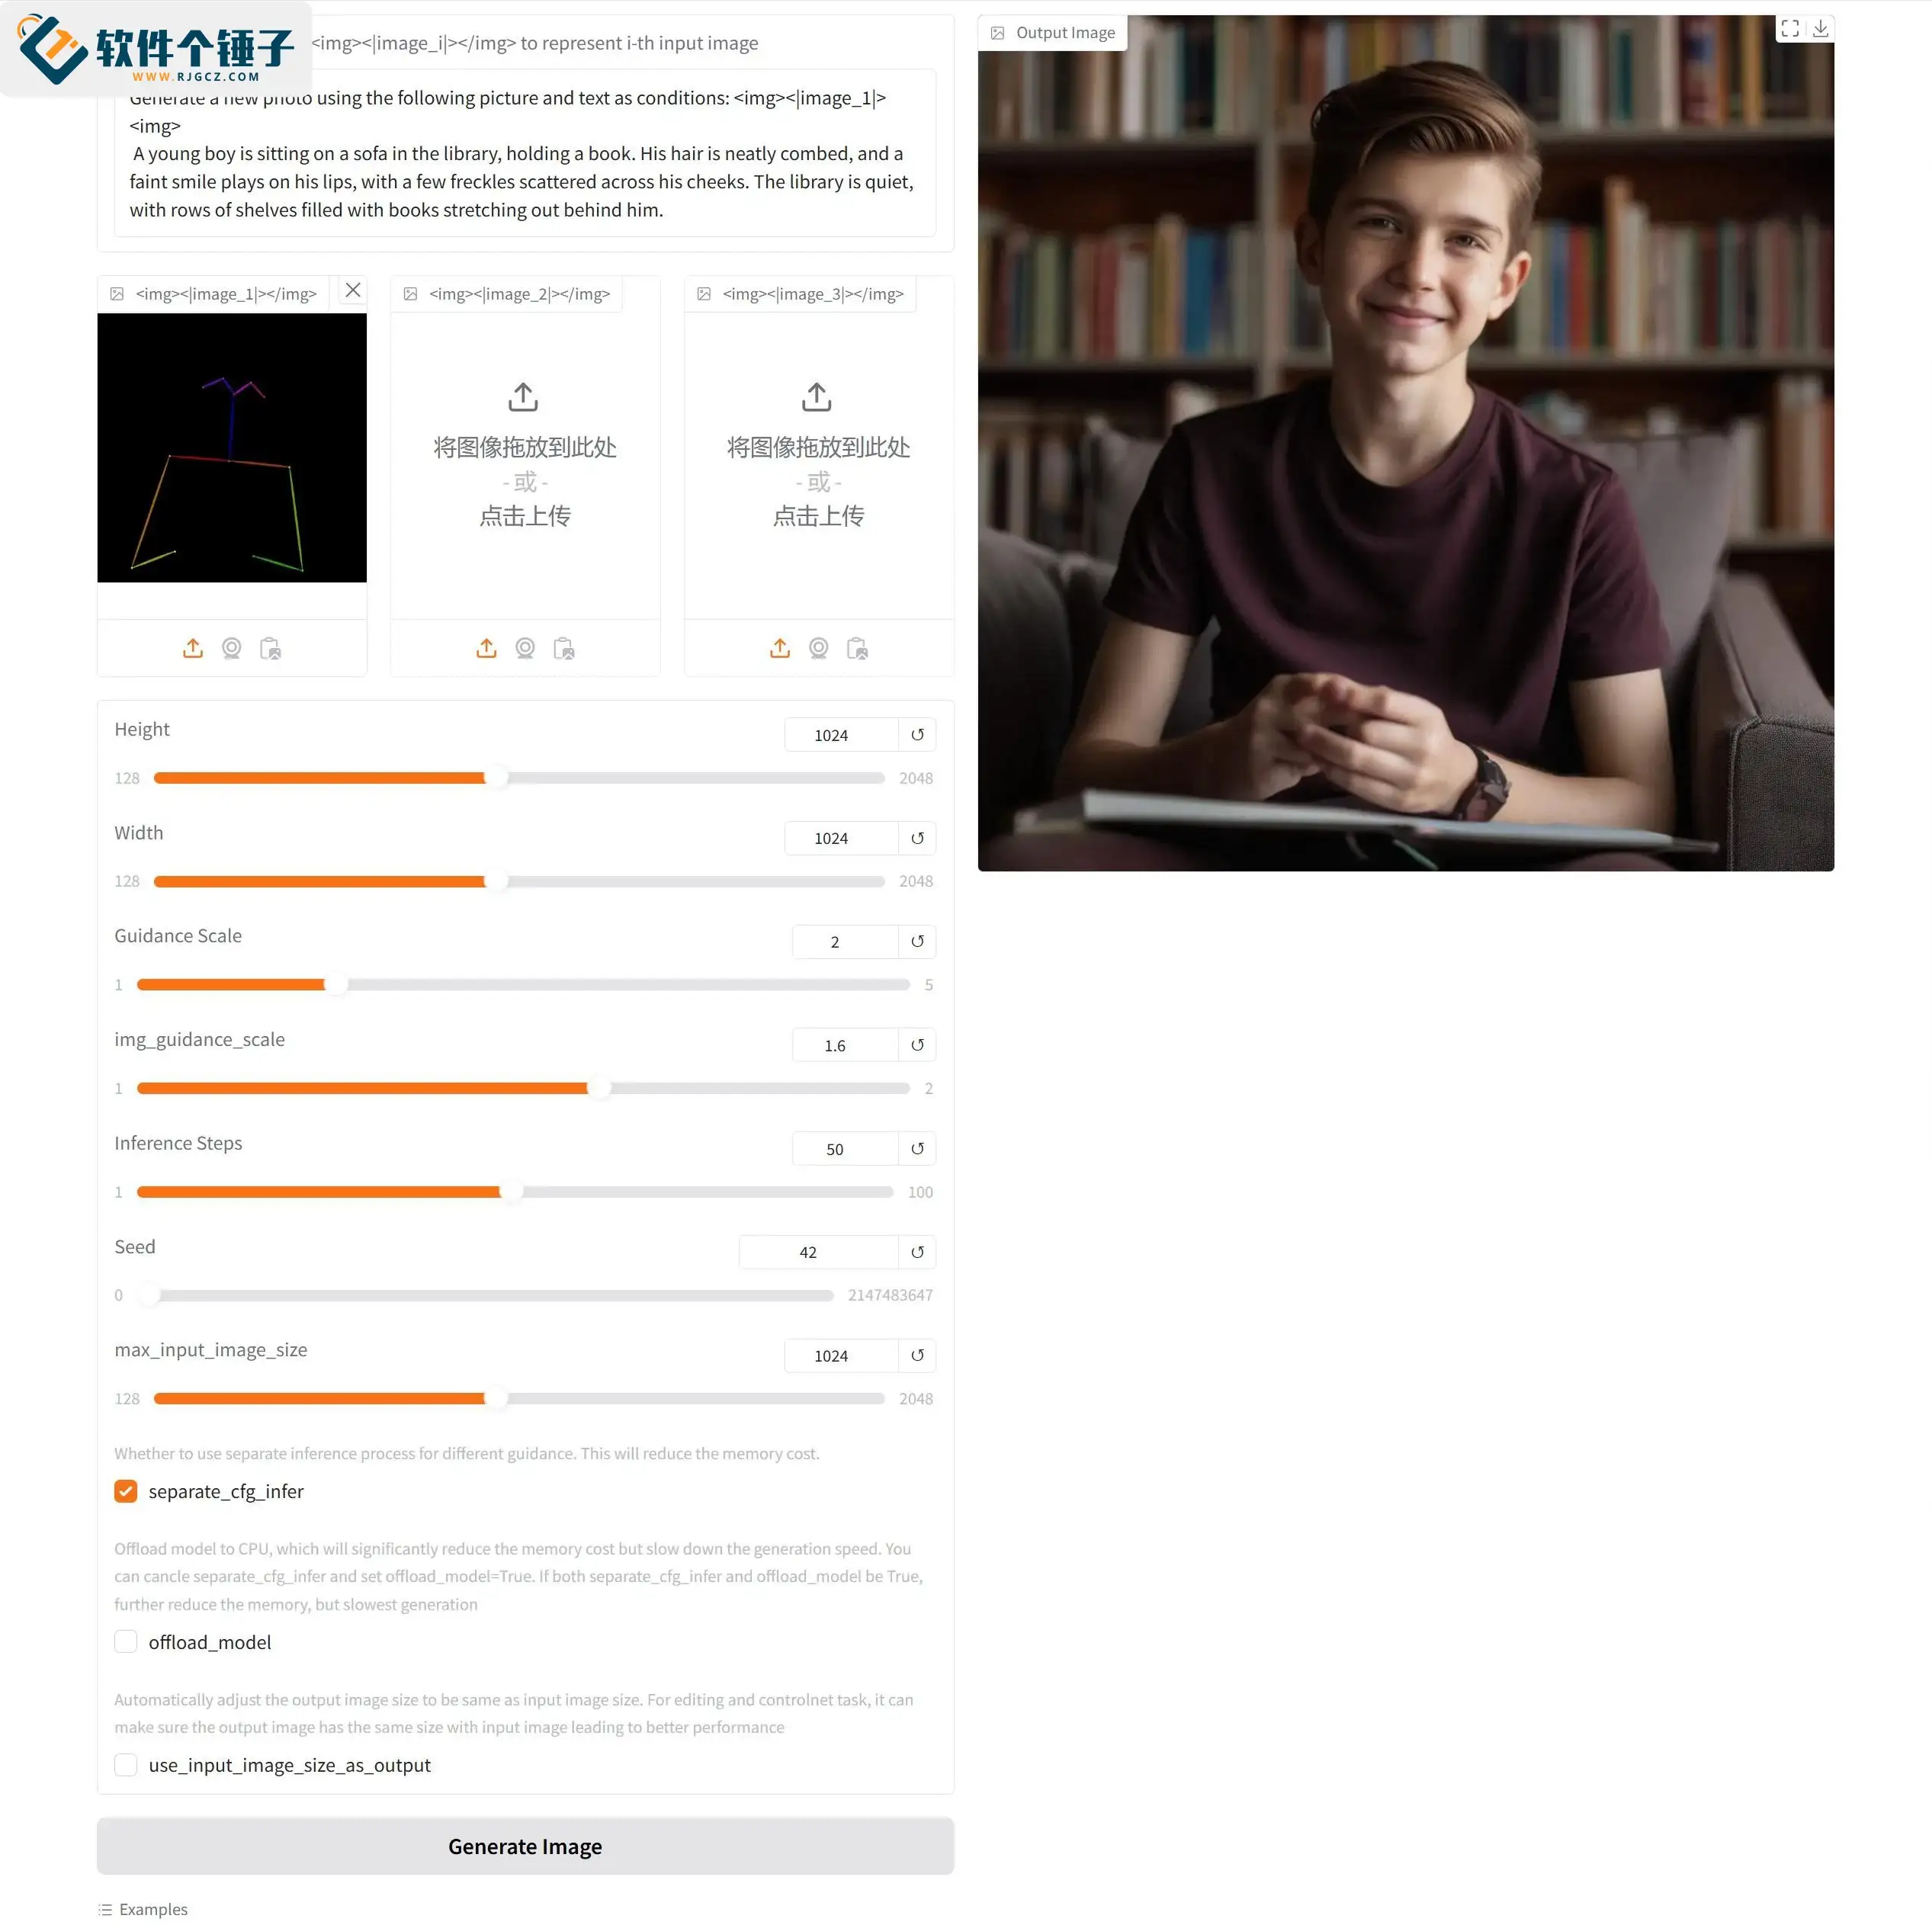
3. ポーズに基づく生成
プロンプト: Generate a new photo using the following picture and text as conditions: <img><|image_1|><img>
A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him.
翻訳: 以下の画像とテキストを条件に新しい画像を生成する: <img><|image_1|></img> 小さな男の子が図書館のソファに座り、手に本を持っている。髪はきちんと整えられ、唇にはかすかな微笑みが浮かび、頬にはいくつかのそばかすが散っている。図書館は静かで、背後には本でいっぱいの棚が何列も並んでいる。

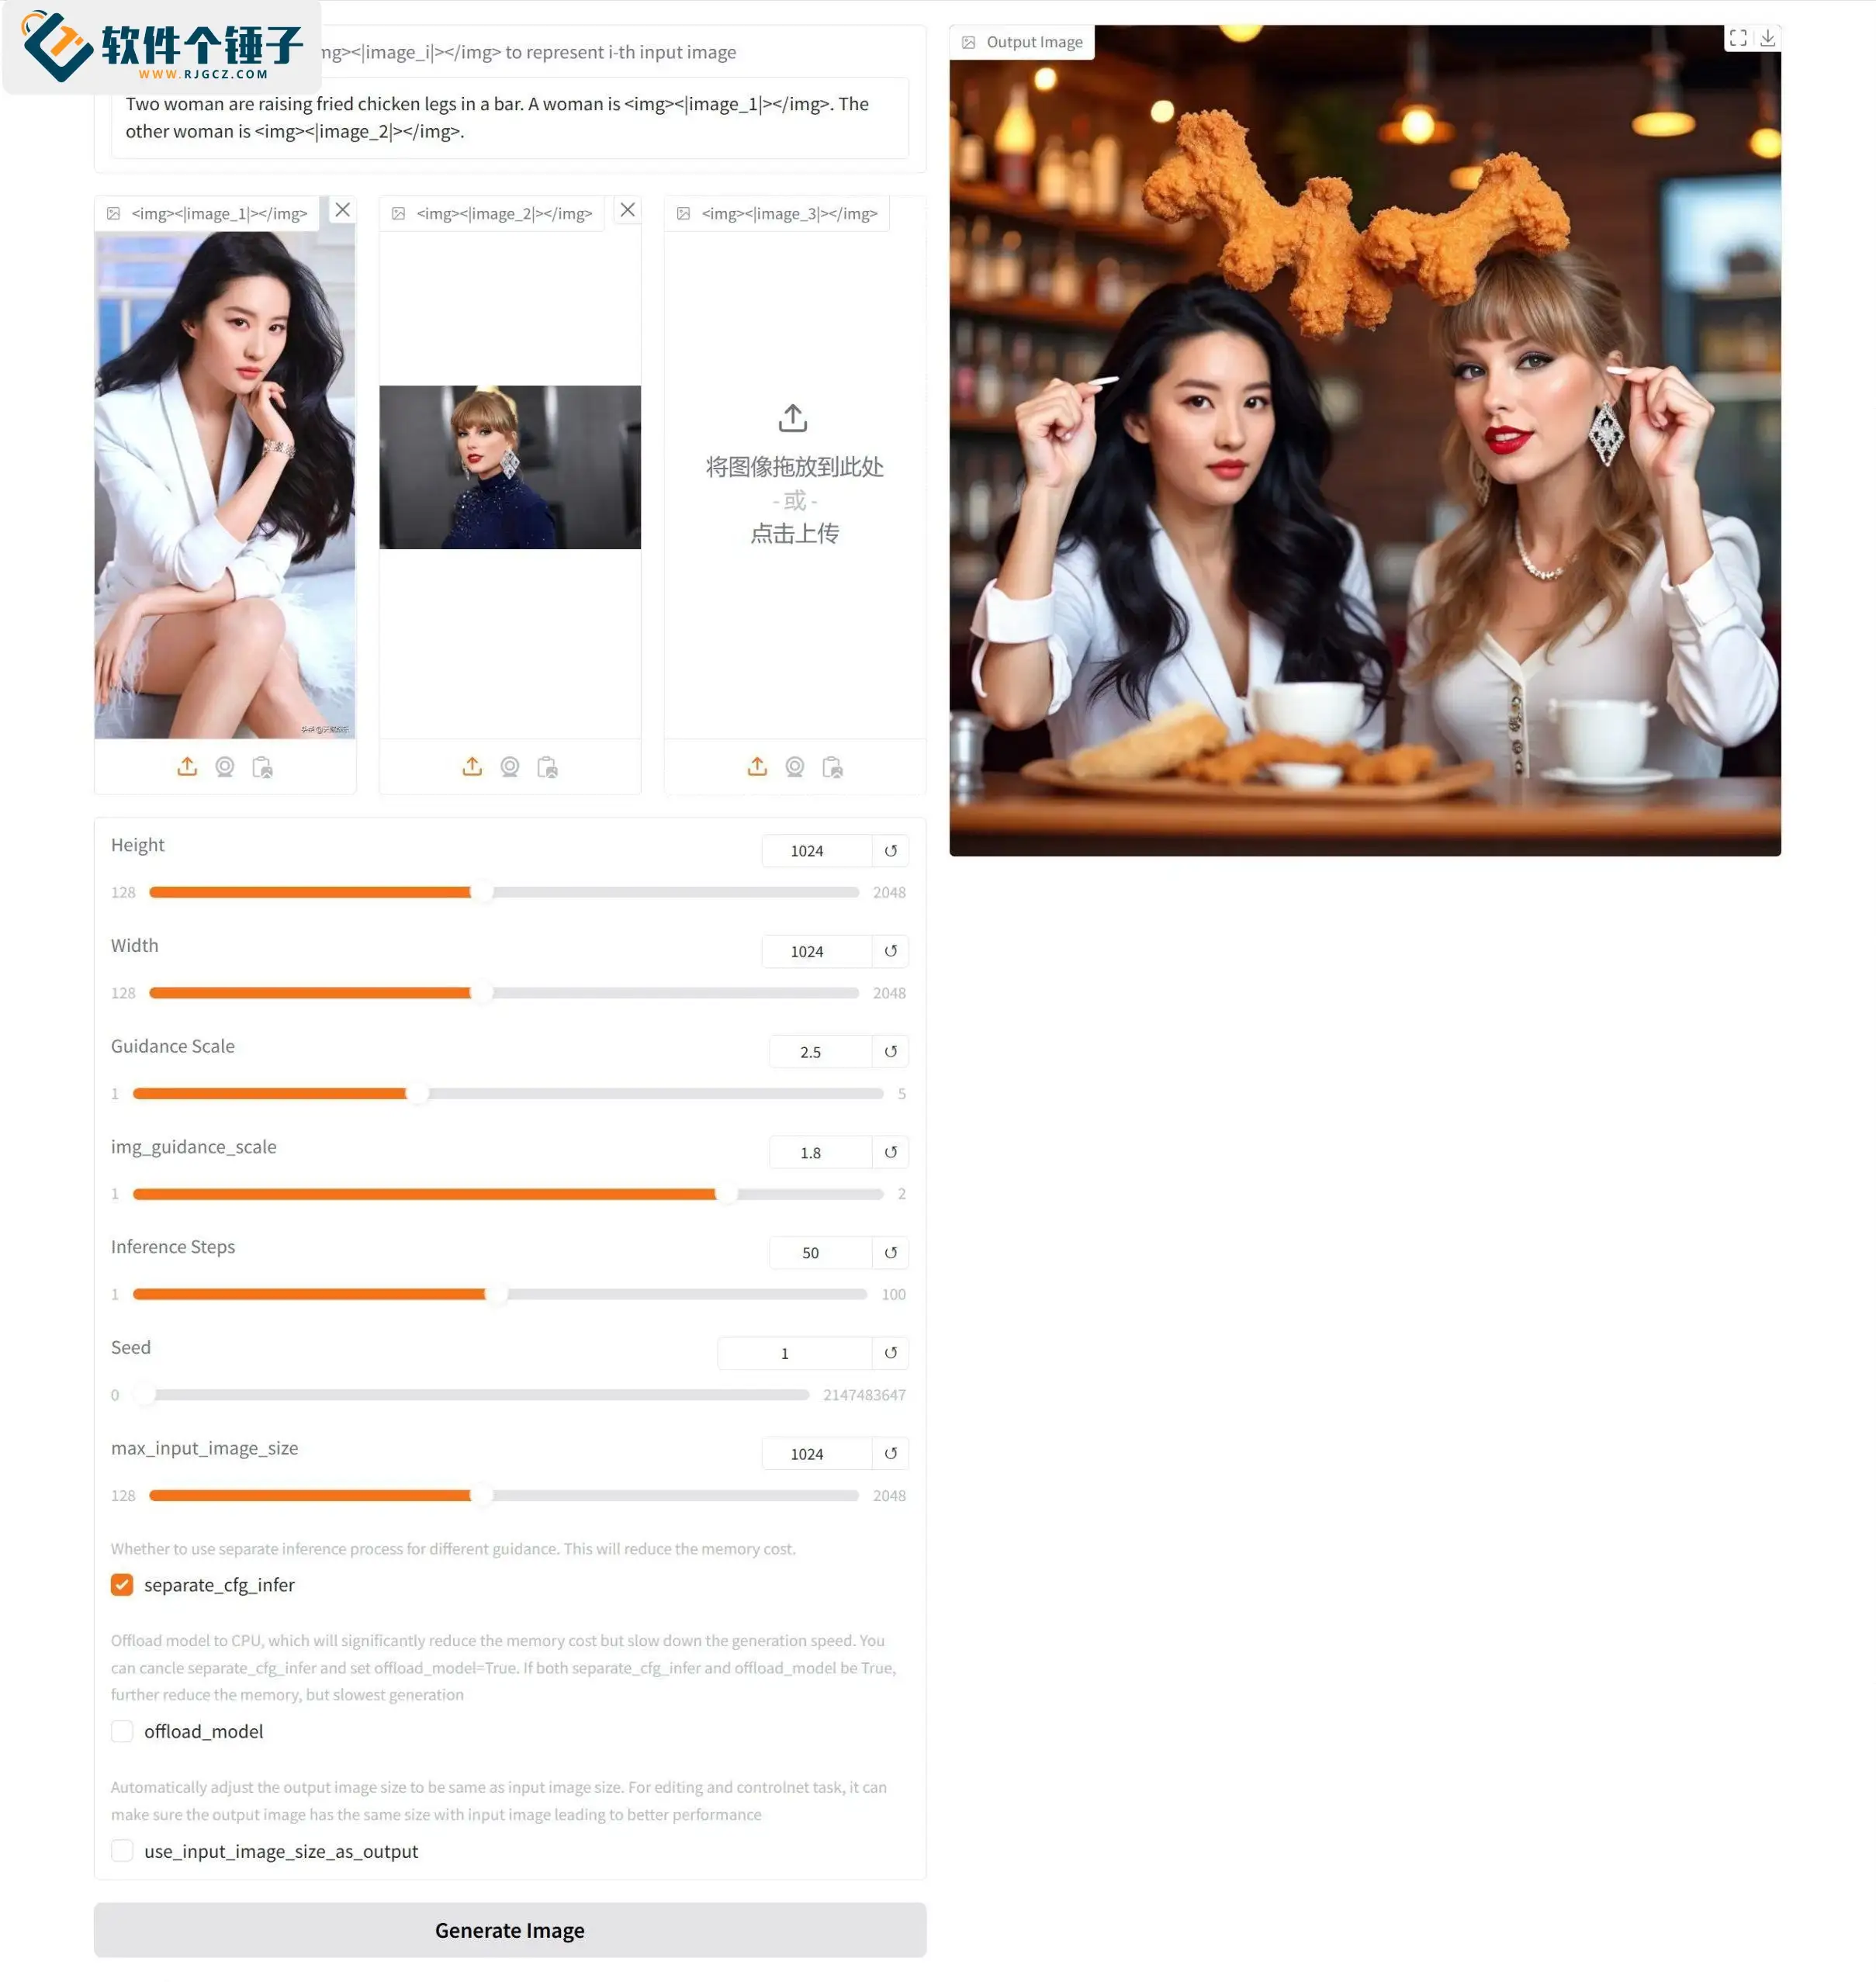
4. 2枚の画像に写る人物を1枚の画像にまとめる
プロンプト: Two woman are raising fried chicken legs in a bar. A woman is <img><|image_1|></img>. The other woman is <img><|image_2|></img>.
翻訳: 2人の女性がバーでフライドチキンの脚を掲げている。1人は <img><|image_1|></img>。もう1人は <img><|image_2|></img>。

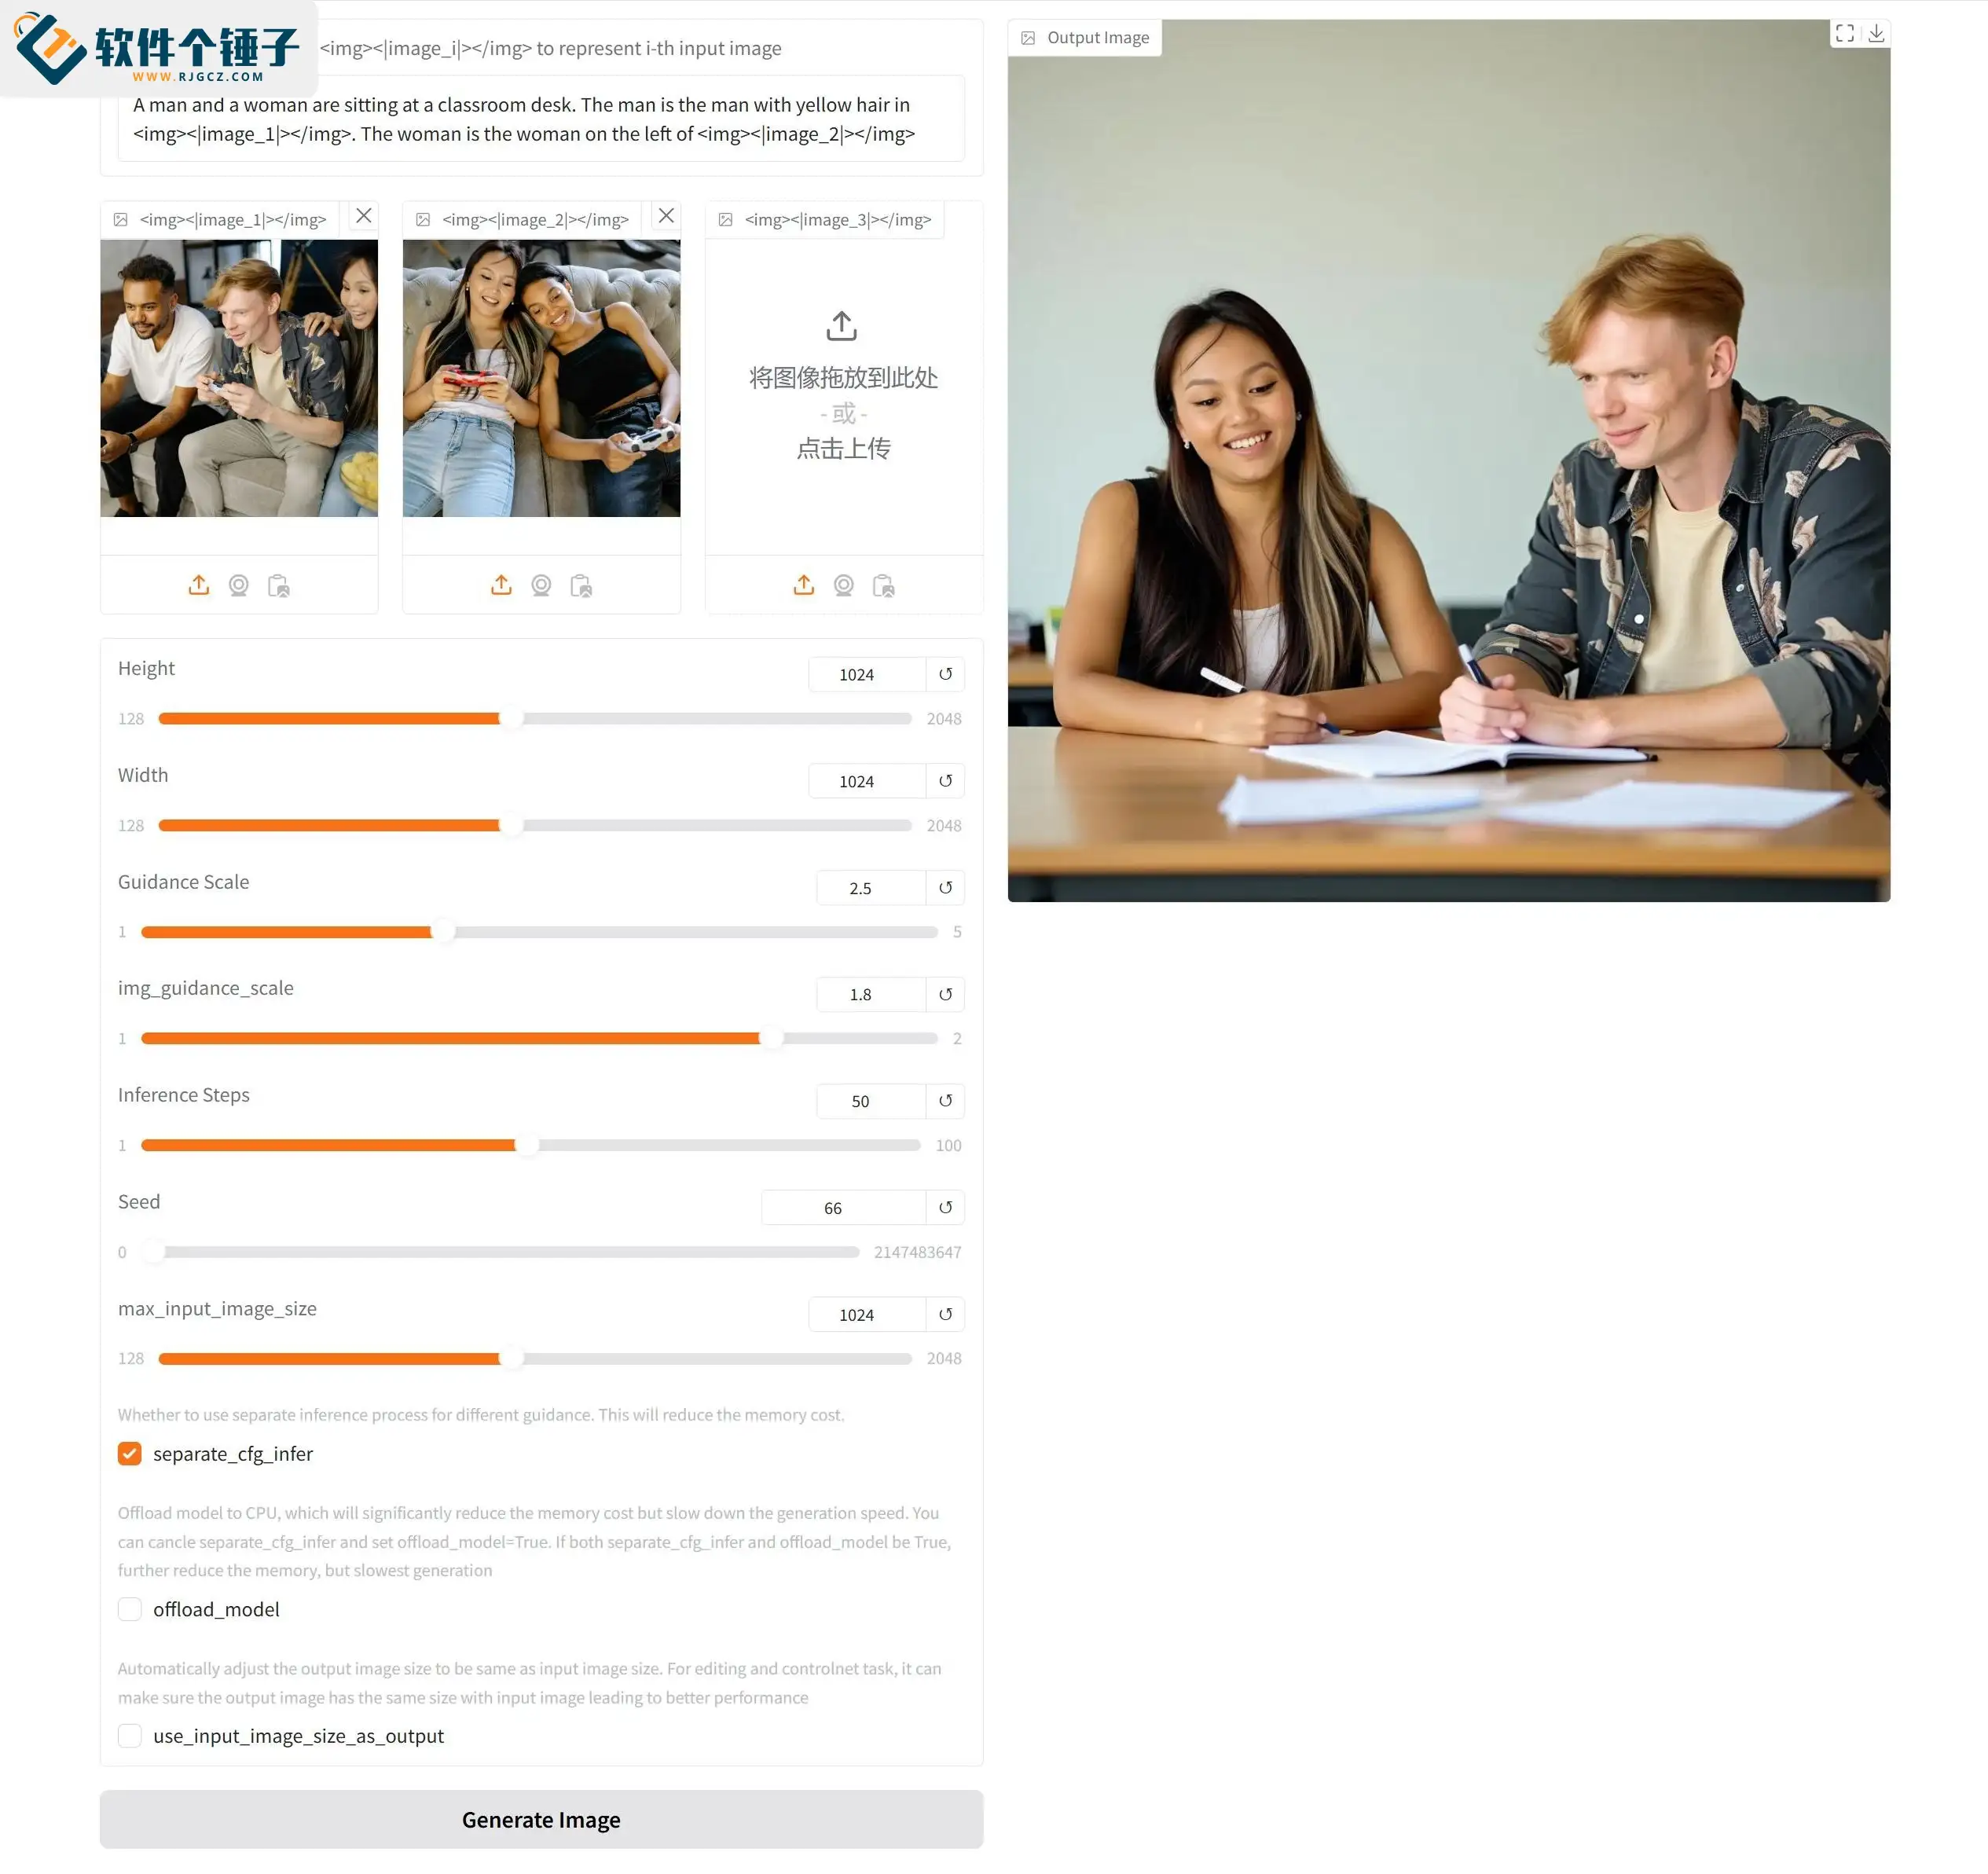
5. 群衆の中の特定の人物を抽出して1枚の画像にまとめる
プロンプト: A man and a woman are sitting at a classroom desk. The man is the man with yellow hair in <img><|image_1|></img>. The woman is the woman on the left of <img><|image_2|></img>.
翻訳: 男性と女性が教室の机に座っている。男性は <img><|image_1|></img> の中の金髪の男性。女性は <img><|image_2|></img> の左側の女性。

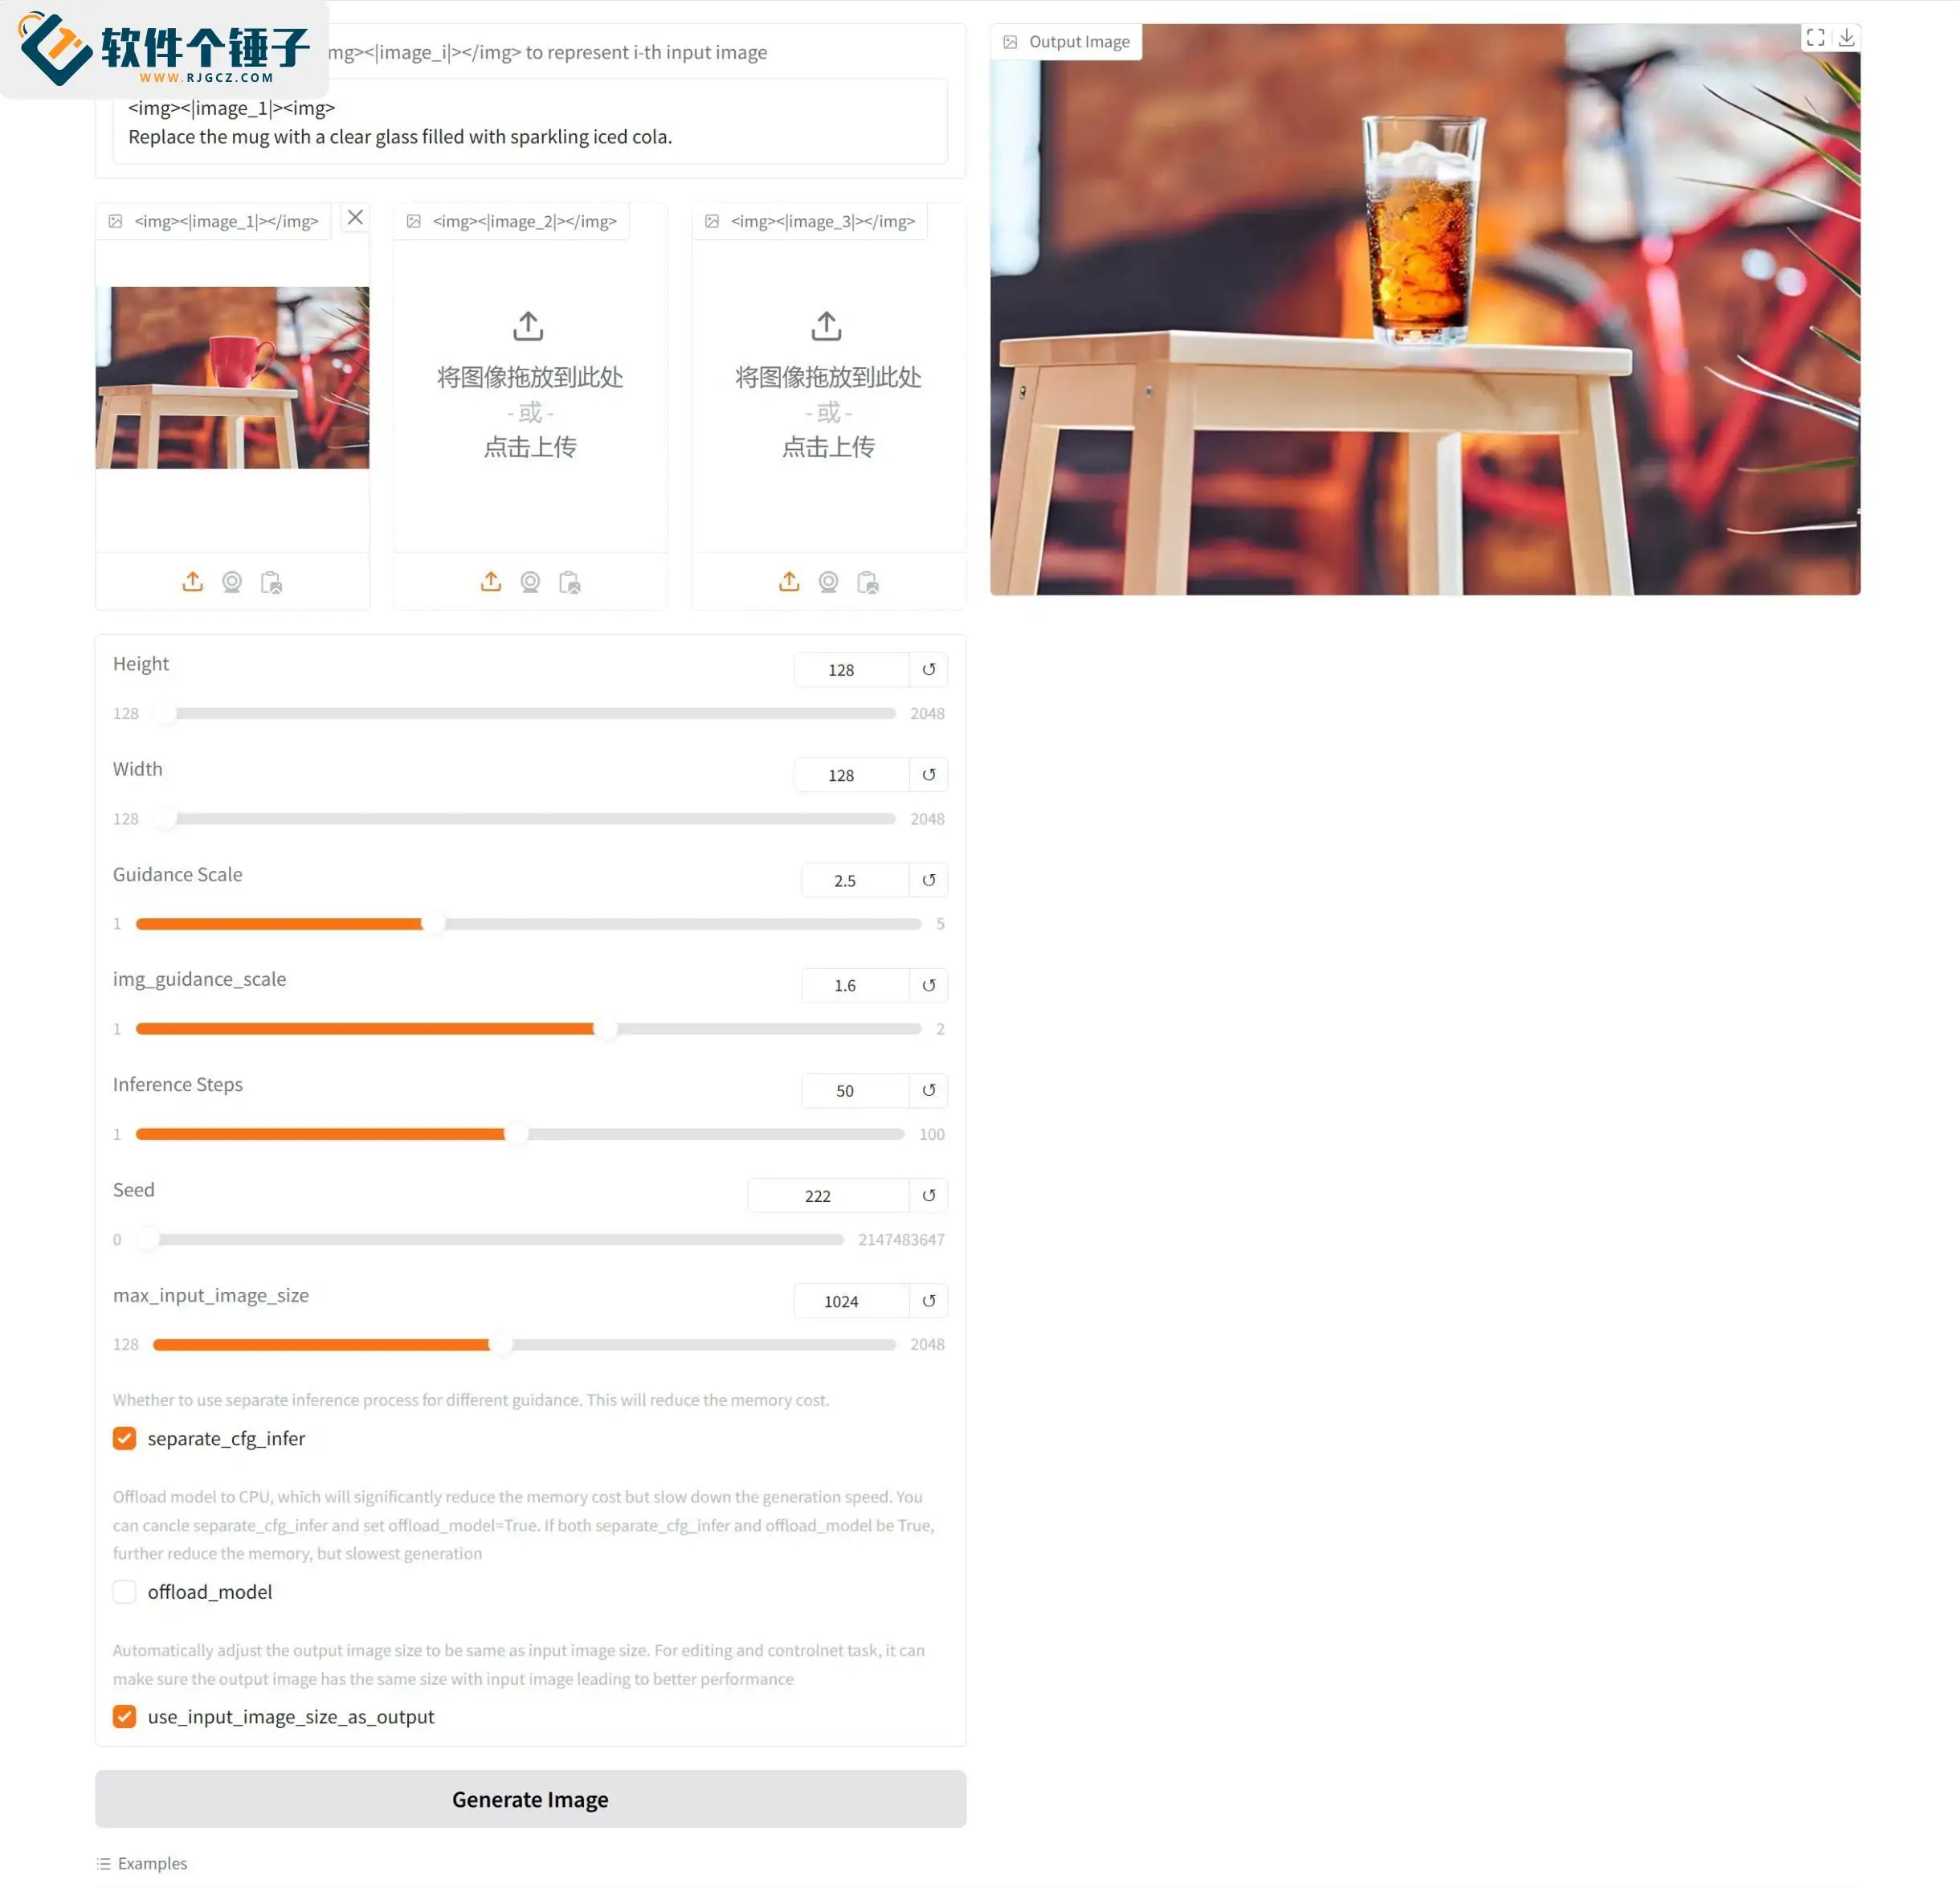
6. 画像内の物体を変更する
プロンプト: <img><|image_1|><img>
Replace the mug with a clear glass filled with sparkling iced cola.
翻訳: <img><|image_1|><img>
マグカップを、炭酸の効いたアイスコーラが入った透明なグラスに置き換える。

オープンソースリポジトリ
[OmniGen 公式サイト]
関連コース











