


-
Cursos de negócio solo
-
 Outros
-
Tutoriais no exterior
-
Fotografia & Edição
-
Comunidade & Domínio privado
-
Escrita & Copywriting para mídias
-
Projetos de renda extra
-
Comércio eletrônico
-
Vídeo curto & Transmissão ao vivo
-
Inteligência Artificial (IA)
-
Software & Ferramentas
-
Sistemas operacionais
-
Plugins & Scripts
-
Software MacOS
-
Software Android
-
Software Windows


Pacote integrado de modelo de geração de imagens multifuncional OmniGen, gratuito e de código aberto, inicialização com um clique, sem necessidade de implantação ou autorização [Ruanjian Ge Chuizi·R2255]
-
Plano de Renda com Farm de Ouro em Jogos: ganhe mais de mil por dia, um projeto estável de 3 anos que qualquer pessoa faz no tempo livre
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Curso SOP sistemático de mangá-drama de IA: seleção de webnovels, roteiro, texto para imagem, imagem para vídeo, dublagem e edição – tutorial padronizado de ponta a ponta (atual. 26/08)
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Farming automatizado de jogos populares: 500+/dia, sem experiência, simples – o extra estável a longo prazo mais fiável [Revelado]
Material de estudo de referência — incluído com a assinatura Obter assinatura -
ShuShu desta vez se safou! Não entre em pânico com problemas de formato do Windows: a ferramenta de código aberto ShuShu Format Converter, uma joia popular no GitHub
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Campo de acompanhamento de vendas no Douyin: sem aparecer, iniciantes copiam modelos e produzem vídeos
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Plano de renda com farming de jogos no lançamento: mais de 1.000 por dia, viável para pessoas comuns no tempo livre! [Revelado]
Material de estudo de referência — incluído com a assinatura Obter assinatura






-
ShuShu desta vez se safou! Não entre em pânico com problemas de formato do Windows: a ferramenta de código aberto ShuShu Format Converter, uma joia popular no GitHub
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Lu Master v6.1024.4105.1121, versão enxuta em arquivo único【Software Ge Chui Zi·R1880】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Software de criação de animação de cartoon 2D Moho Pro v14.3 [Software Ge Chuzi · R2355]
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Software de edição e processamento de vídeo para computador Aiseesoft Filmai v1.0.18 【Software Ge Chuzi·R2470】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Microsoft To Do v2.147 Versão oficial gratuita【Software Ge Chuizi·R2618】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Plugin de osciloscópio de correção de cor de vídeo para PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Ge Chui Zi·R2748】
Material de estudo de referência — incluído com a assinatura Obter assinatura





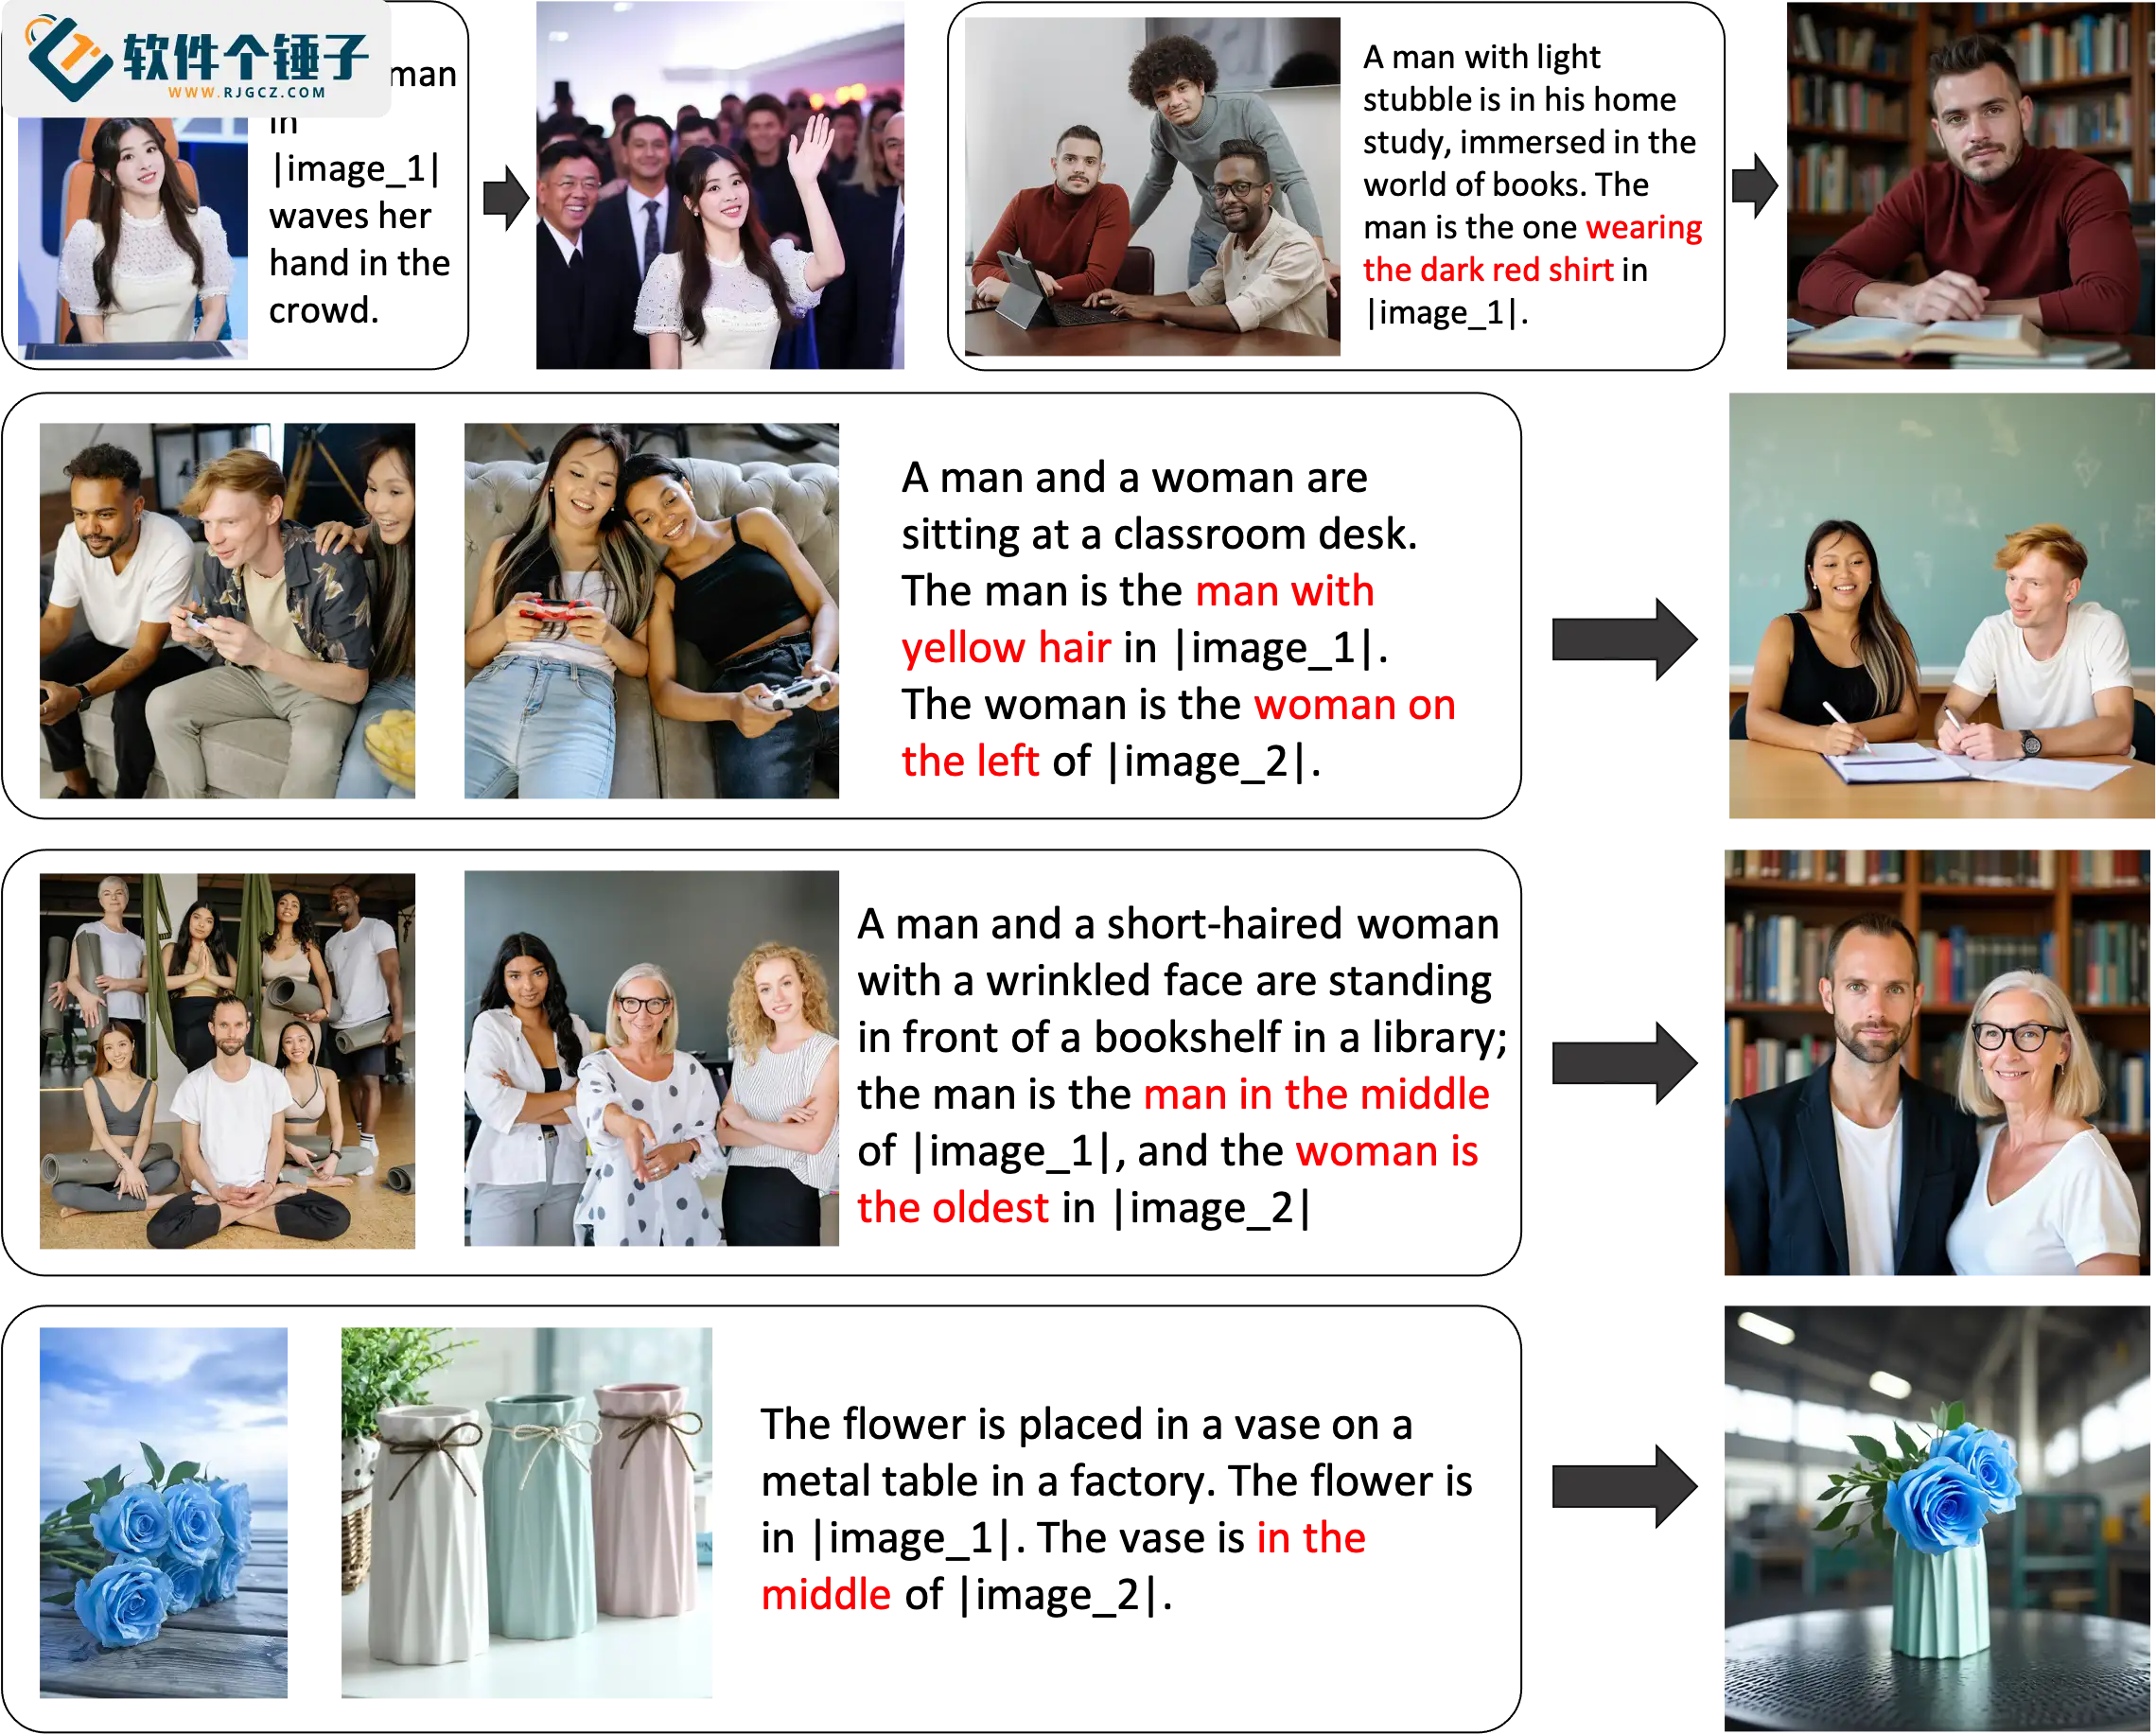
O OmniGen é uma nova arquitetura de modelo de difusão lançada pela BAAI, focada na geração unificada de imagens. Ele simplifica o fluxo complexo de geração de imagens, tratando diversas tarefas por meio de um único framework, como geração de imagens a partir de texto, edição de imagens e geração baseada em condições visuais. Além disso, o OmniGen realiza transferência de conhecimento por meio de uma estrutura de aprendizado unificada, adaptando-se a diferentes tarefas e necessidades de domínio. O modelo não apenas é altamente simplificado e fácil de usar, como também demonstra grande flexibilidade no campo da geração de imagens.

Características do software:
Unificação: o OmniGen consegue tratar de forma integrada diversas tarefas de geração de imagens, incluindo texto para imagem, geração orientada por tema, edição de imagens e geração baseada em condições visuais. Sua inovação está em converter tarefas tradicionais de visão computacional em tarefas de geração de imagens, proporcionando uma experiência integrada de geração de imagens.
Simplicidade: o OmniGen abandona os fluxos de operação complicados comuns em outros modelos, não exigindo suporte a plugins como ControlNet e IP-Adapter, e tornando o processamento de tarefas mais intuitivo. O usuário pode concluir tarefas complexas com comandos simples, reduzindo muito a barreira de operação.
Transferência de conhecimento: por meio de aprendizado em formato unificado, o OmniGen pode transferir conhecimento entre diferentes tarefas, sendo especialmente adequado para tarefas ou domínios nunca vistos. Nesse processo, o OmniGen explorou a aplicação do mecanismo de "cadeia de pensamento", conferindo-lhe maior capacidade de raciocínio e aprendizado em contexto na geração de imagens.
Funções do software:
Texto para imagem: gera a imagem correspondente a partir de uma descrição textual.
Edição de imagens: realiza edições locais ou totais em imagens conforme a necessidade do usuário.
Geração com consistência de personagem: mantém a aparência consistente de um personagem em várias imagens.
Geração baseada em condições visuais: gera imagens que atendem a requisitos específicos com base em condições visuais (como informações de pose ou bordas).
Requisitos de configuração:
Recomenda-se que o computador atenda à seguinte configuração:
Sistema operacional: Windows 10/11 64 bits
Placa de vídeo: 8G de VRAM é utilizável, mas a geração é mais lenta; recomenda-se uma placa NVIDIA com mais de 8G de VRAM,
CUDA >= 11.8
O pacote completo, depois de descompactado, tem cerca de 24,5G; reserve espaço suficiente no disco
Se o computador não tiver o CUDA instalado, consulte o tutorial de instalação:
Como verificar a marca e o modelo da placa de vídeo e a VRAM:
Abra o Gerenciador de Tarefas
Clique em "Desempenho"
Clique em "GPU"
No canto superior direito é possível ver o modelo da placa de vídeo e, na parte inferior, o tamanho da VRAM

Tutorial de uso:
① Baixe o pacote integrado e descompacte;
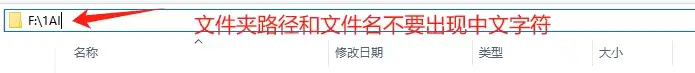
Atenção: caminhos de pastas e nomes de arquivos (incluindo nomes de arquivos de áudio, imagem, vídeo etc.) não devem conter caracteres chineses, caso contrário alguns softwares podem apresentar erro por não reconhecê-los

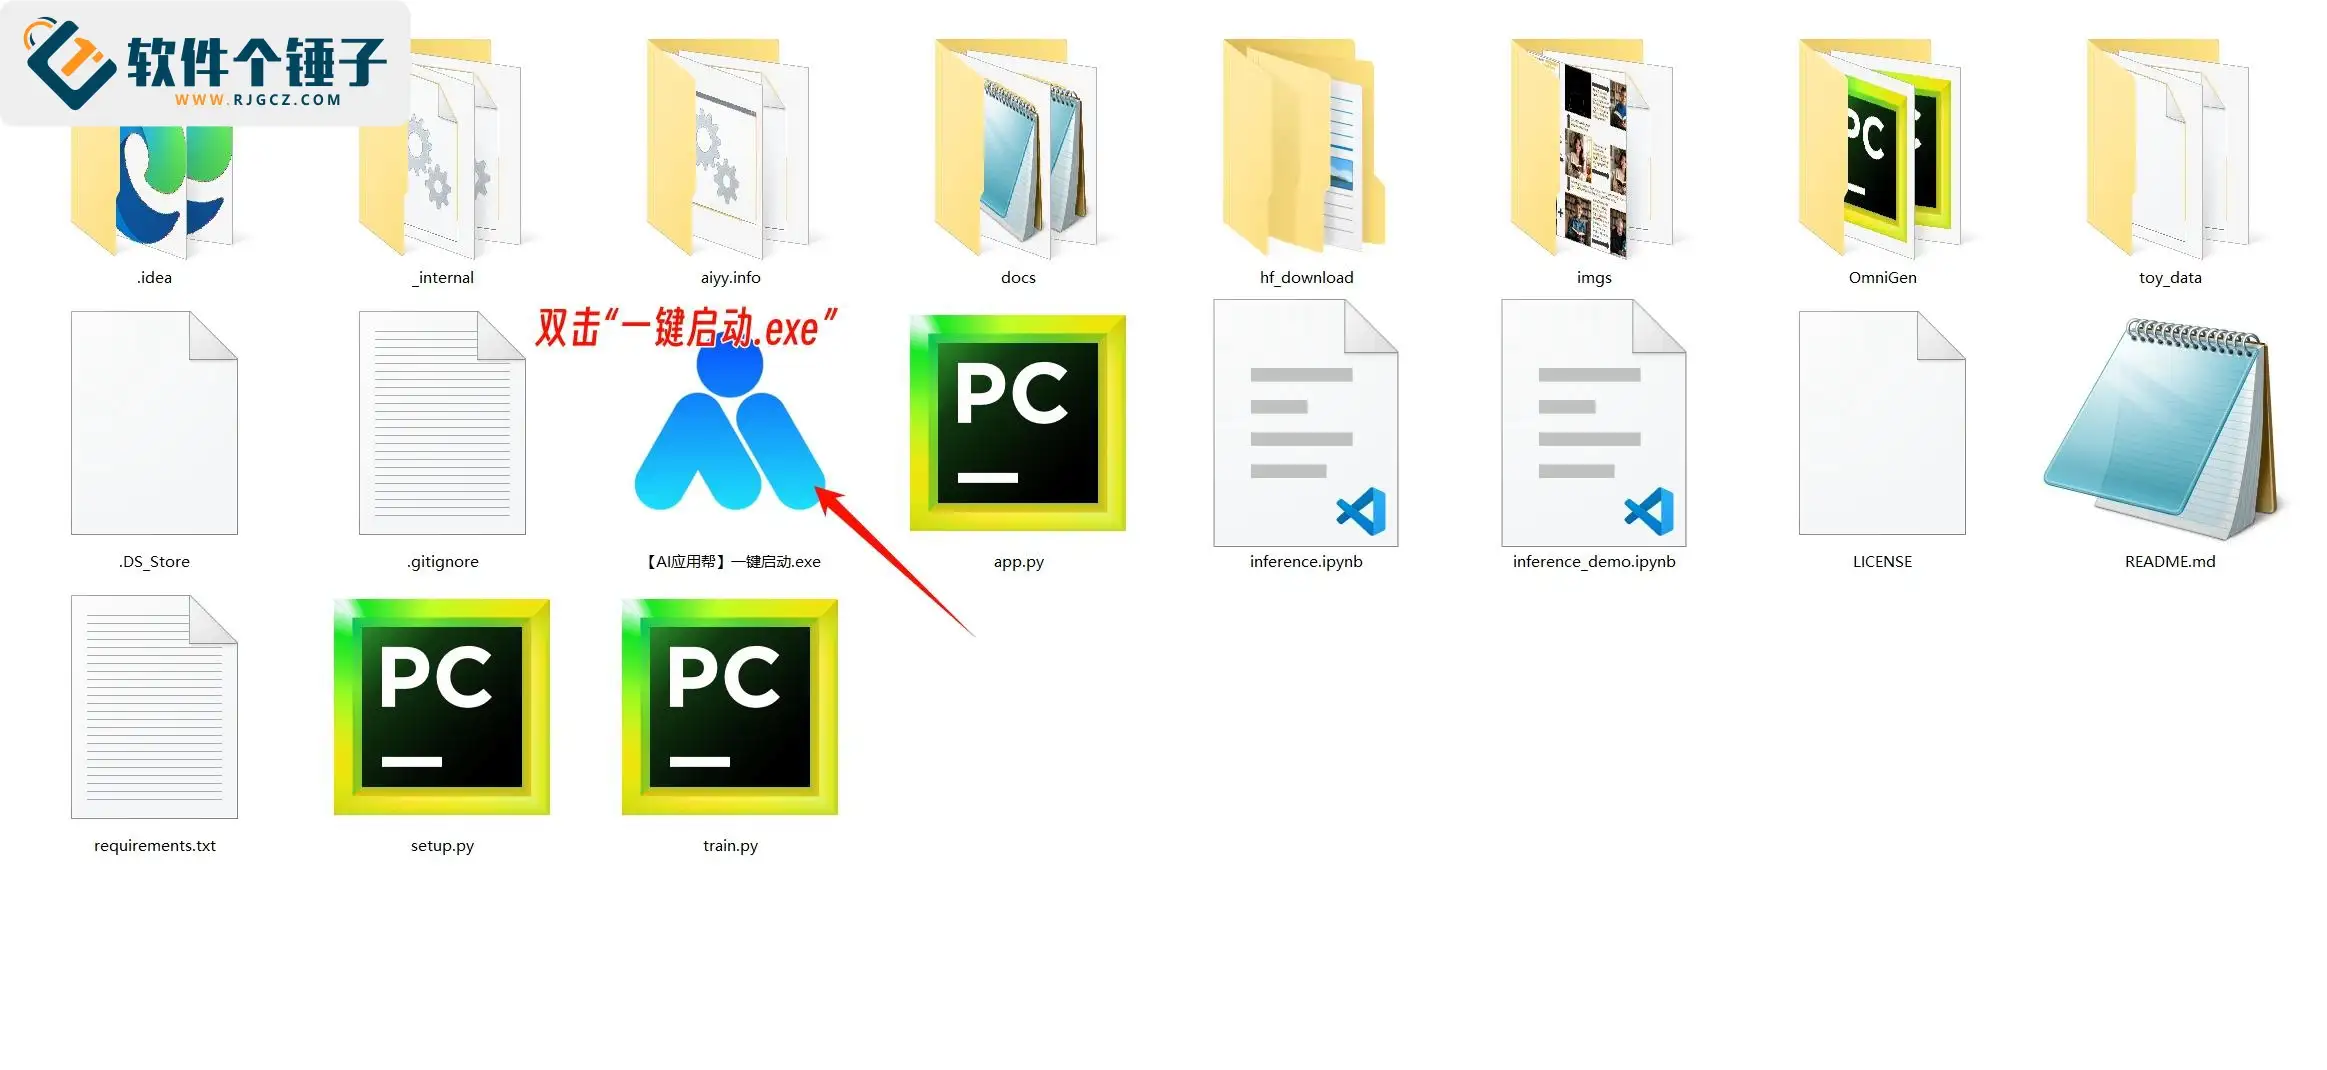
② Dê um duplo clique em "Inicialização com um clique.exe" e, após alguns instantes, a interface de operação será aberta automaticamente no navegador

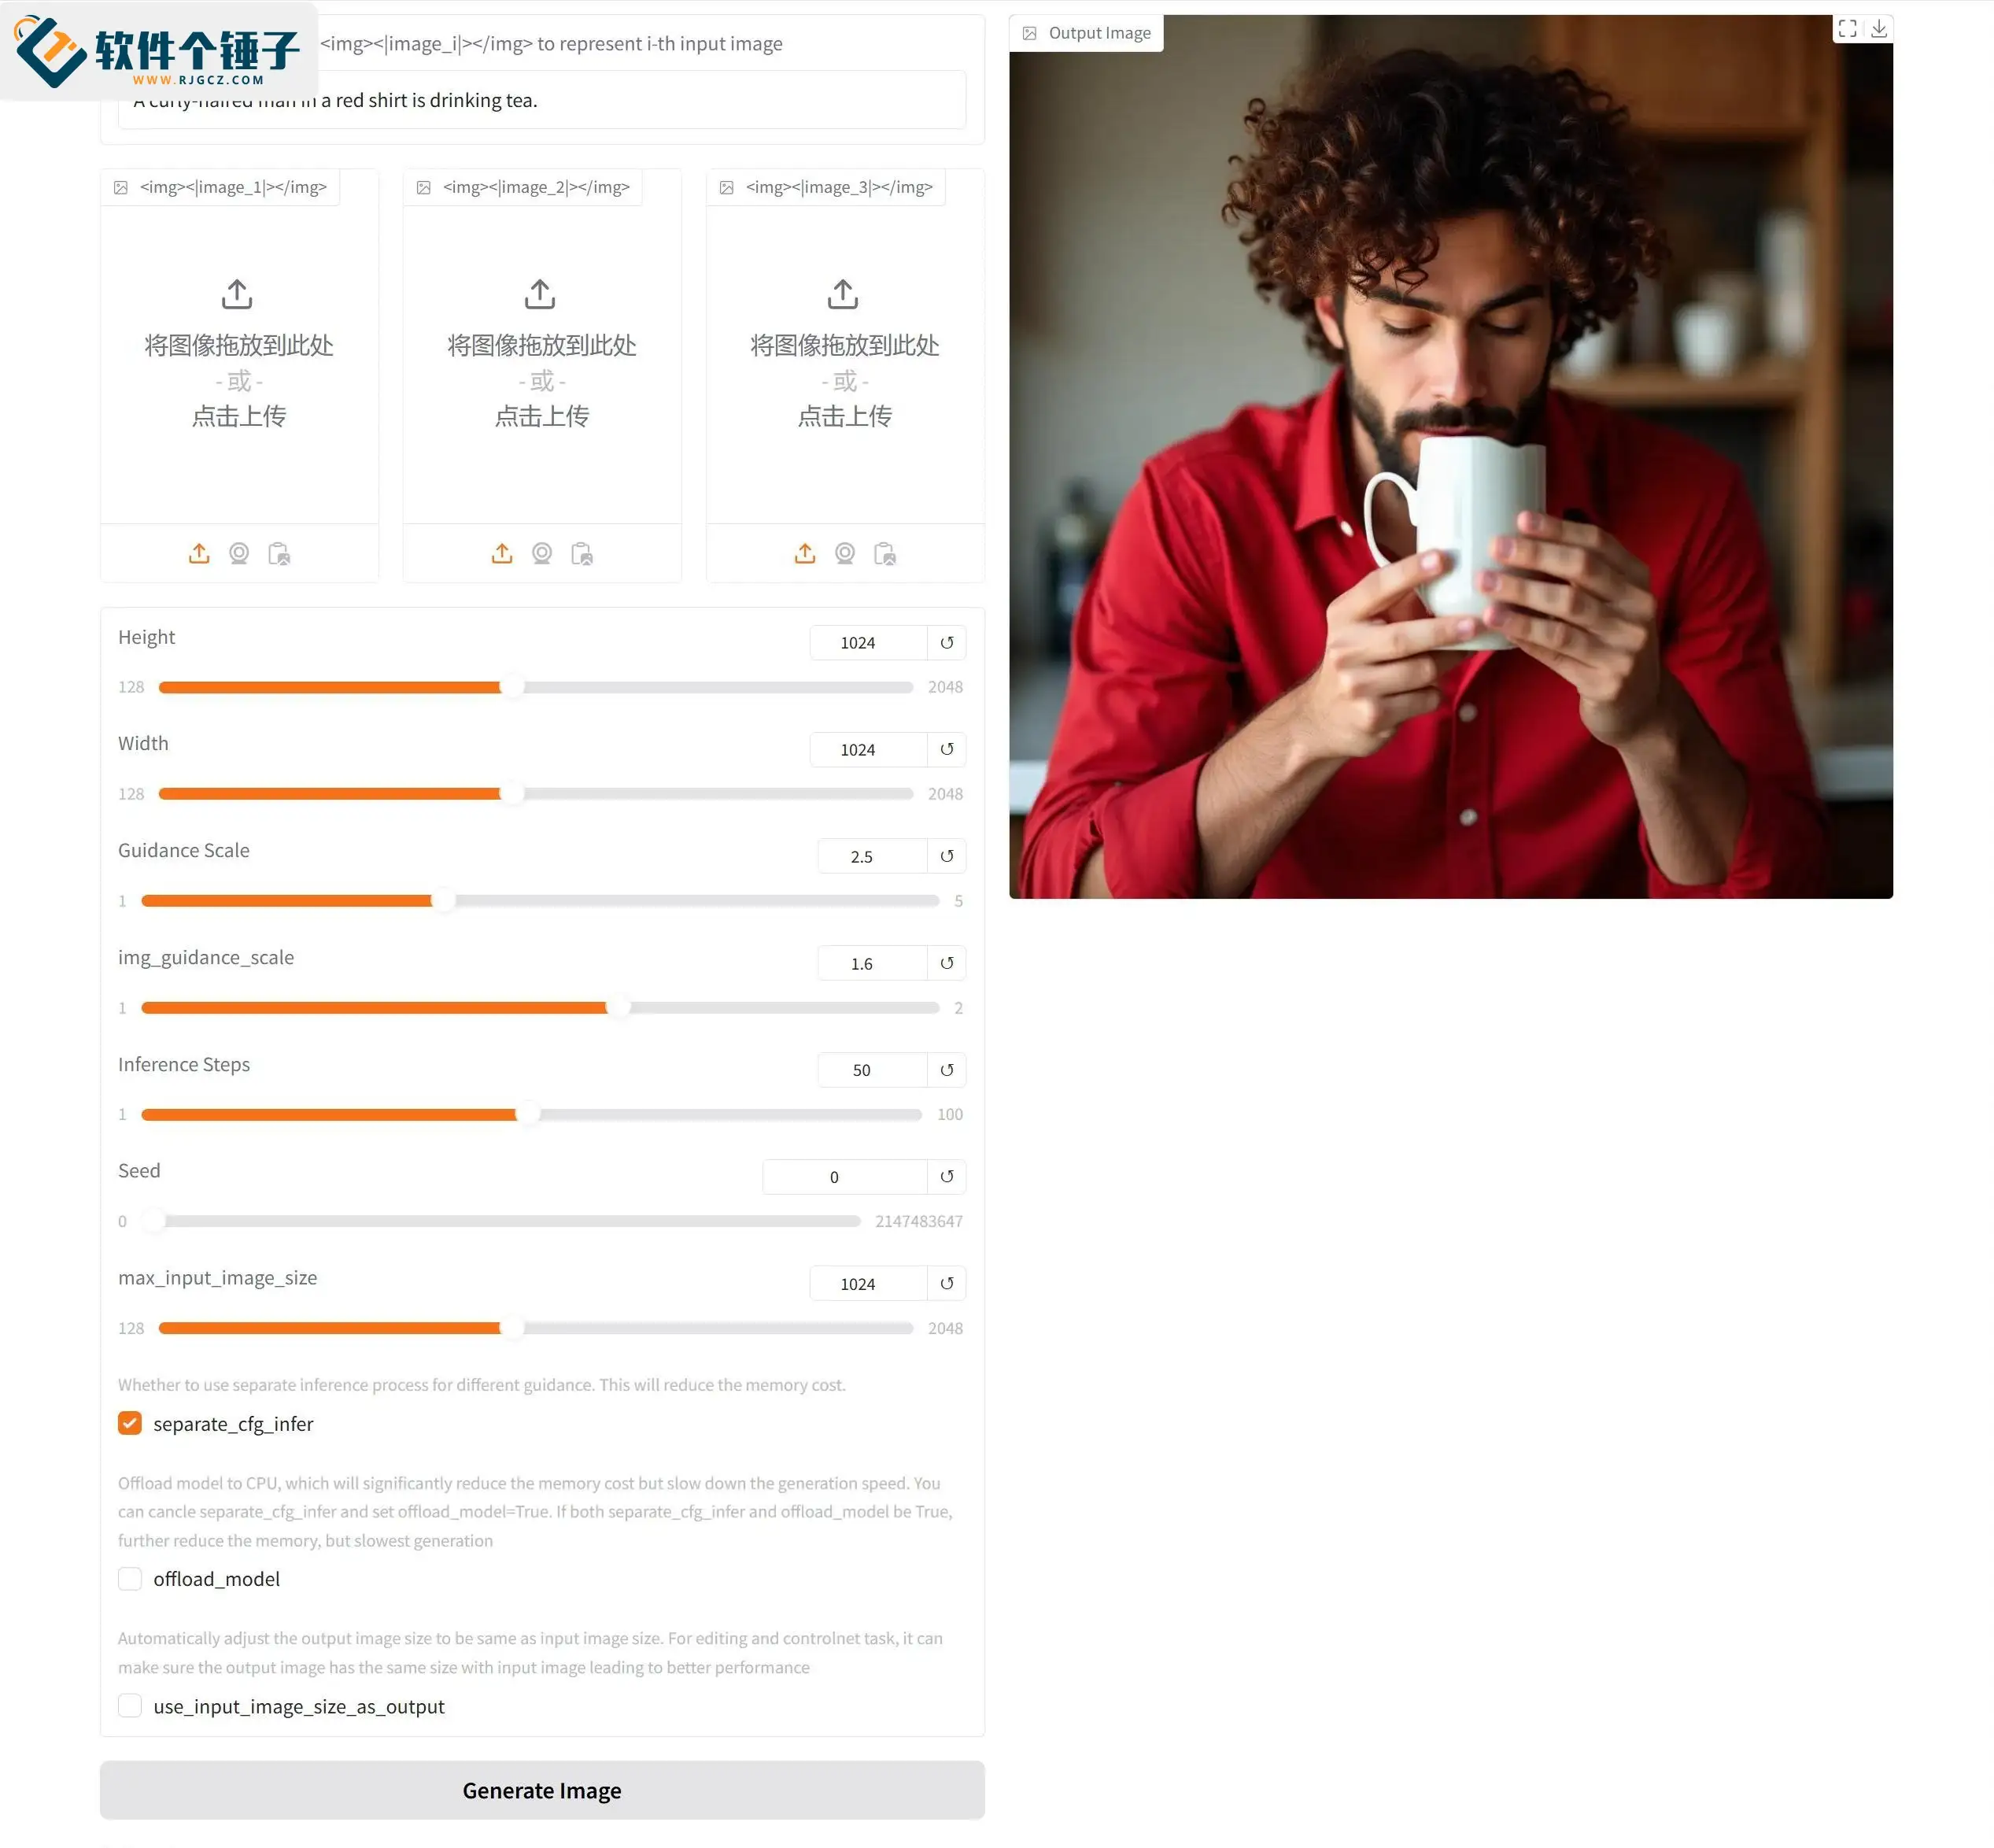
③ Envie uma imagem (também é possível não enviar), insira o prompt (caso o prompt precise fazer referência à imagem enviada, o formato do nome da imagem deve seguir rigorosamente este formato <img><|image_i|></img>, caso contrário não será reconhecido e dará erro; o i pode ser alterado para o número 1, 2, 3), depois ajuste parâmetros como largura e altura, ou mantenha o padrão, e por fim clique em enviar; o resultado gerado ficará à direita

1. Gerar imagem a partir de prompt
Prompt: A curly-haired man in a red shirt is drinking tea.
Tradução: Um homem de cabelo cacheado com uma camisa vermelha está bebendo chá.

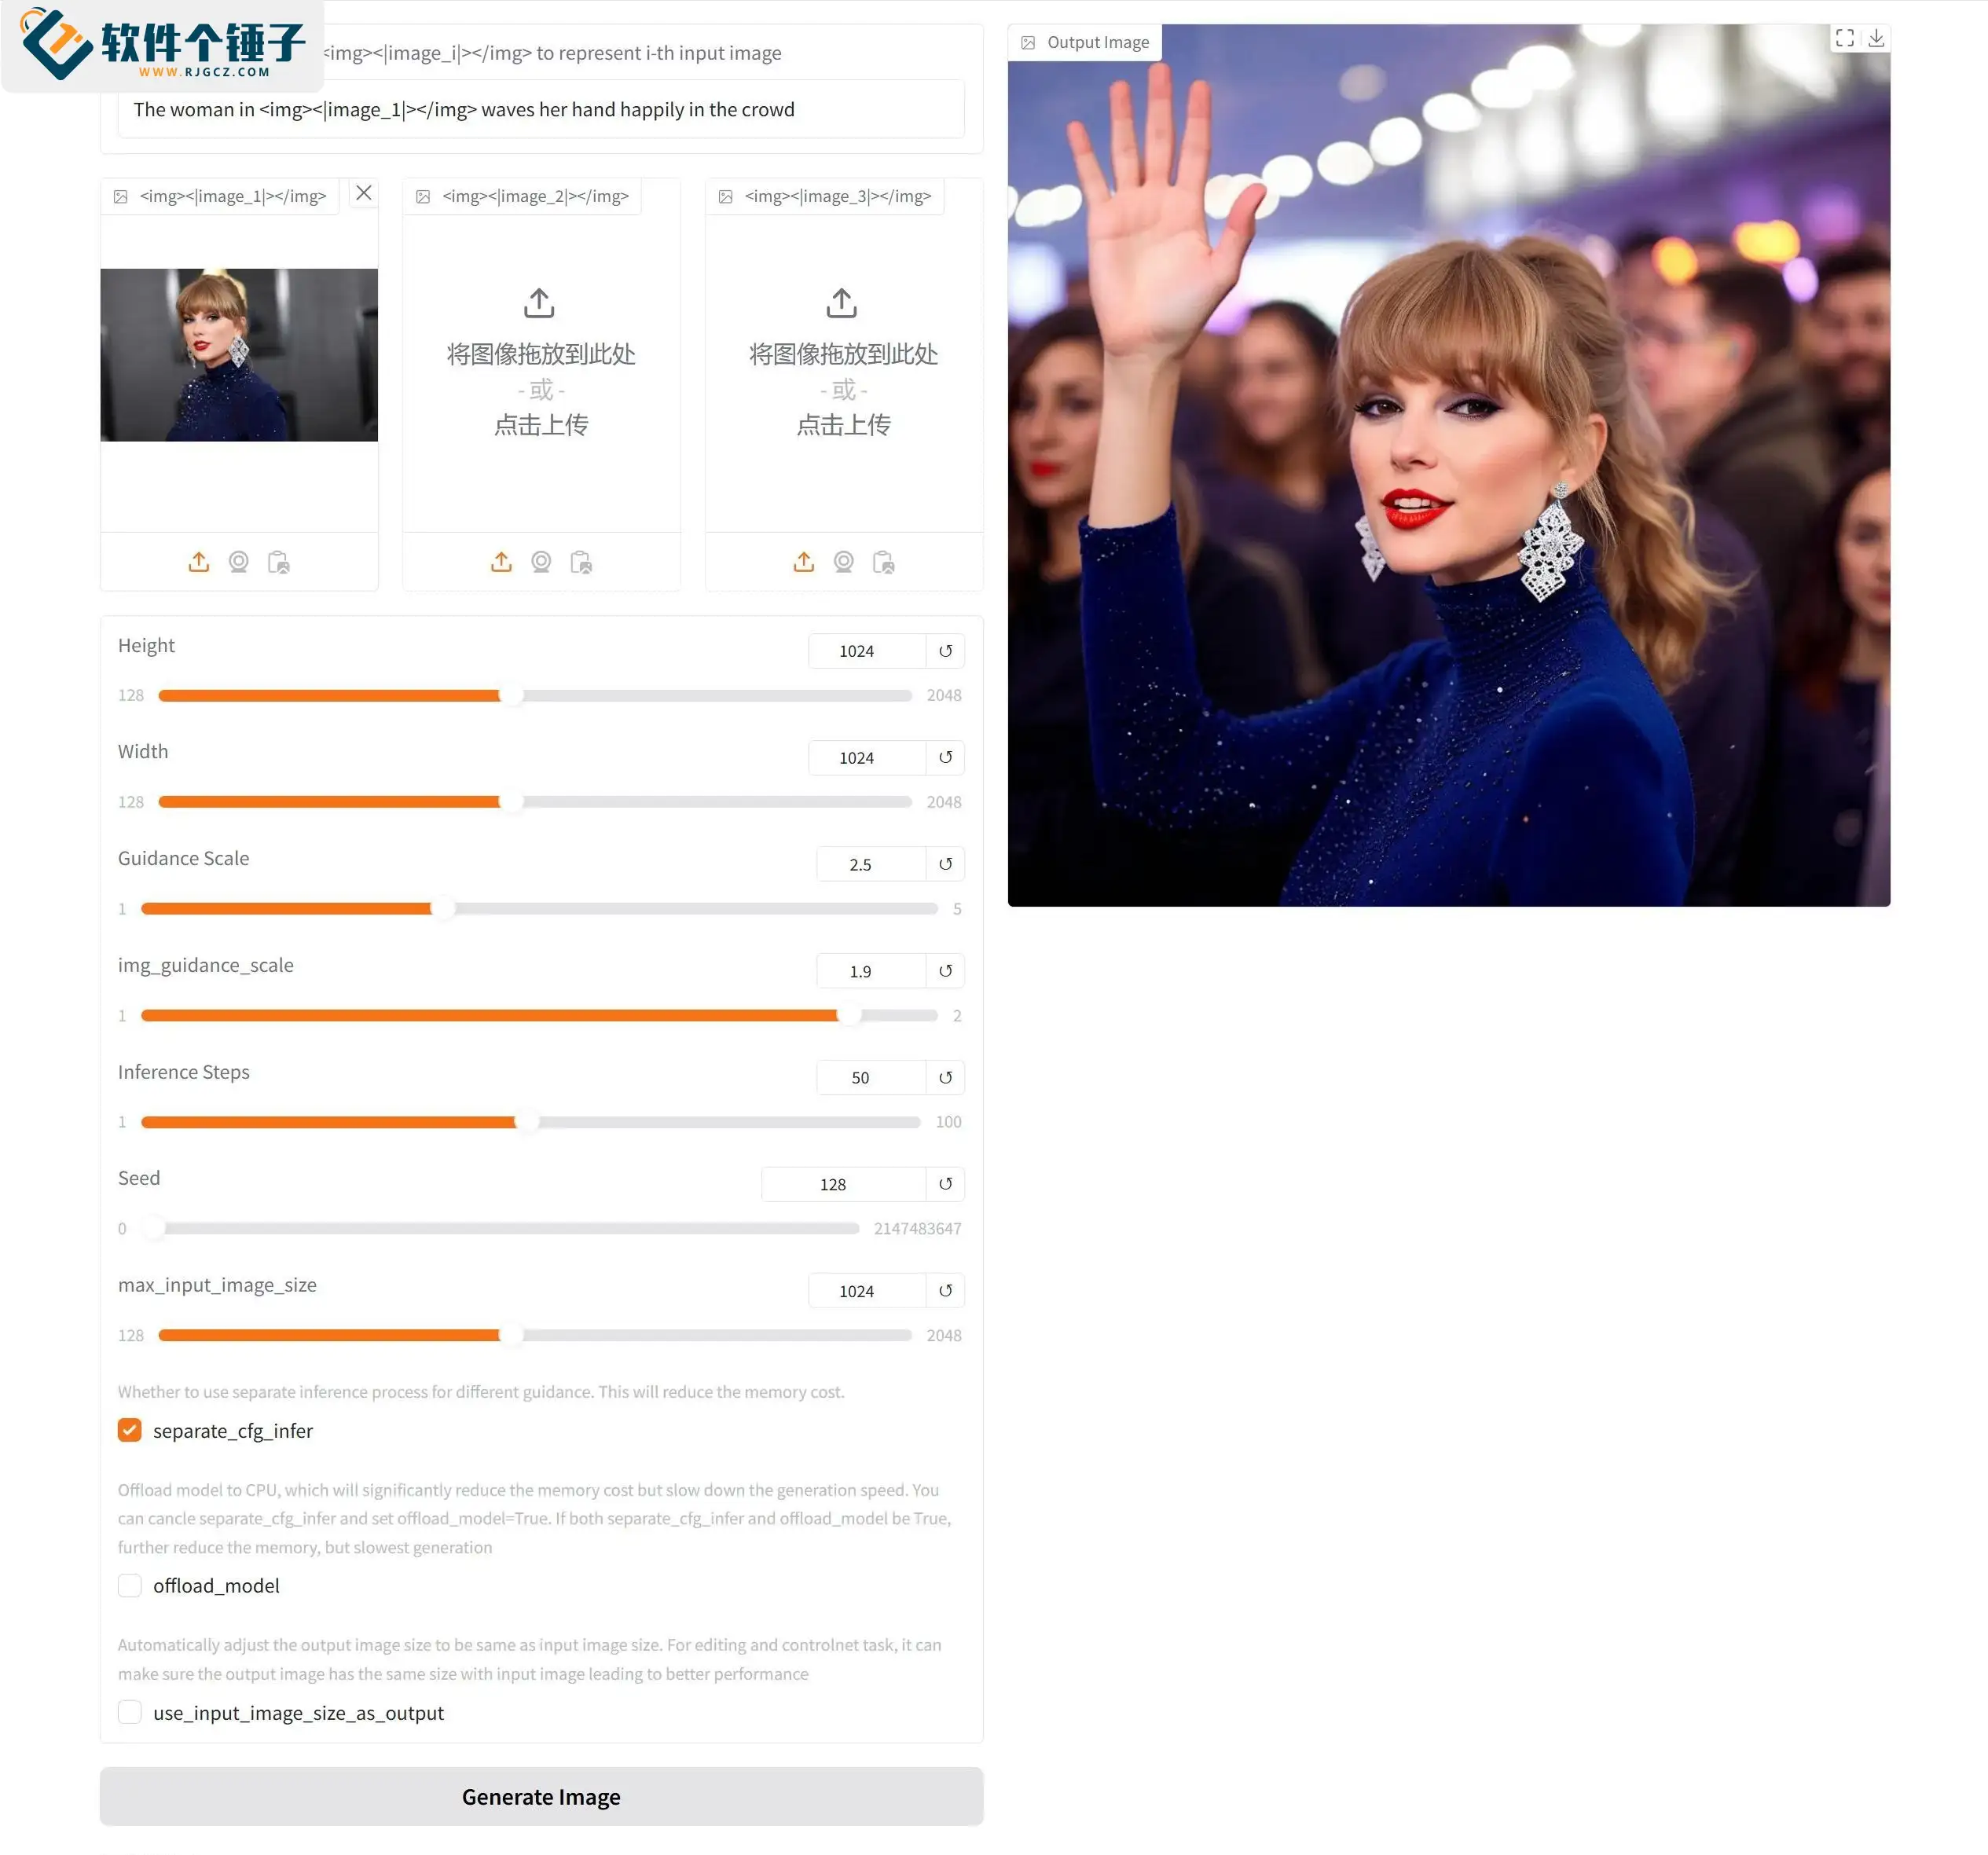
2. Gerar imagem usando uma única imagem de referência
Prompt: The woman in <img><|image_1|></img> waves her hand happily in the crowd.
Tradução: A mulher em <img><|image_1|></img> acena alegremente com a mão no meio da multidão.

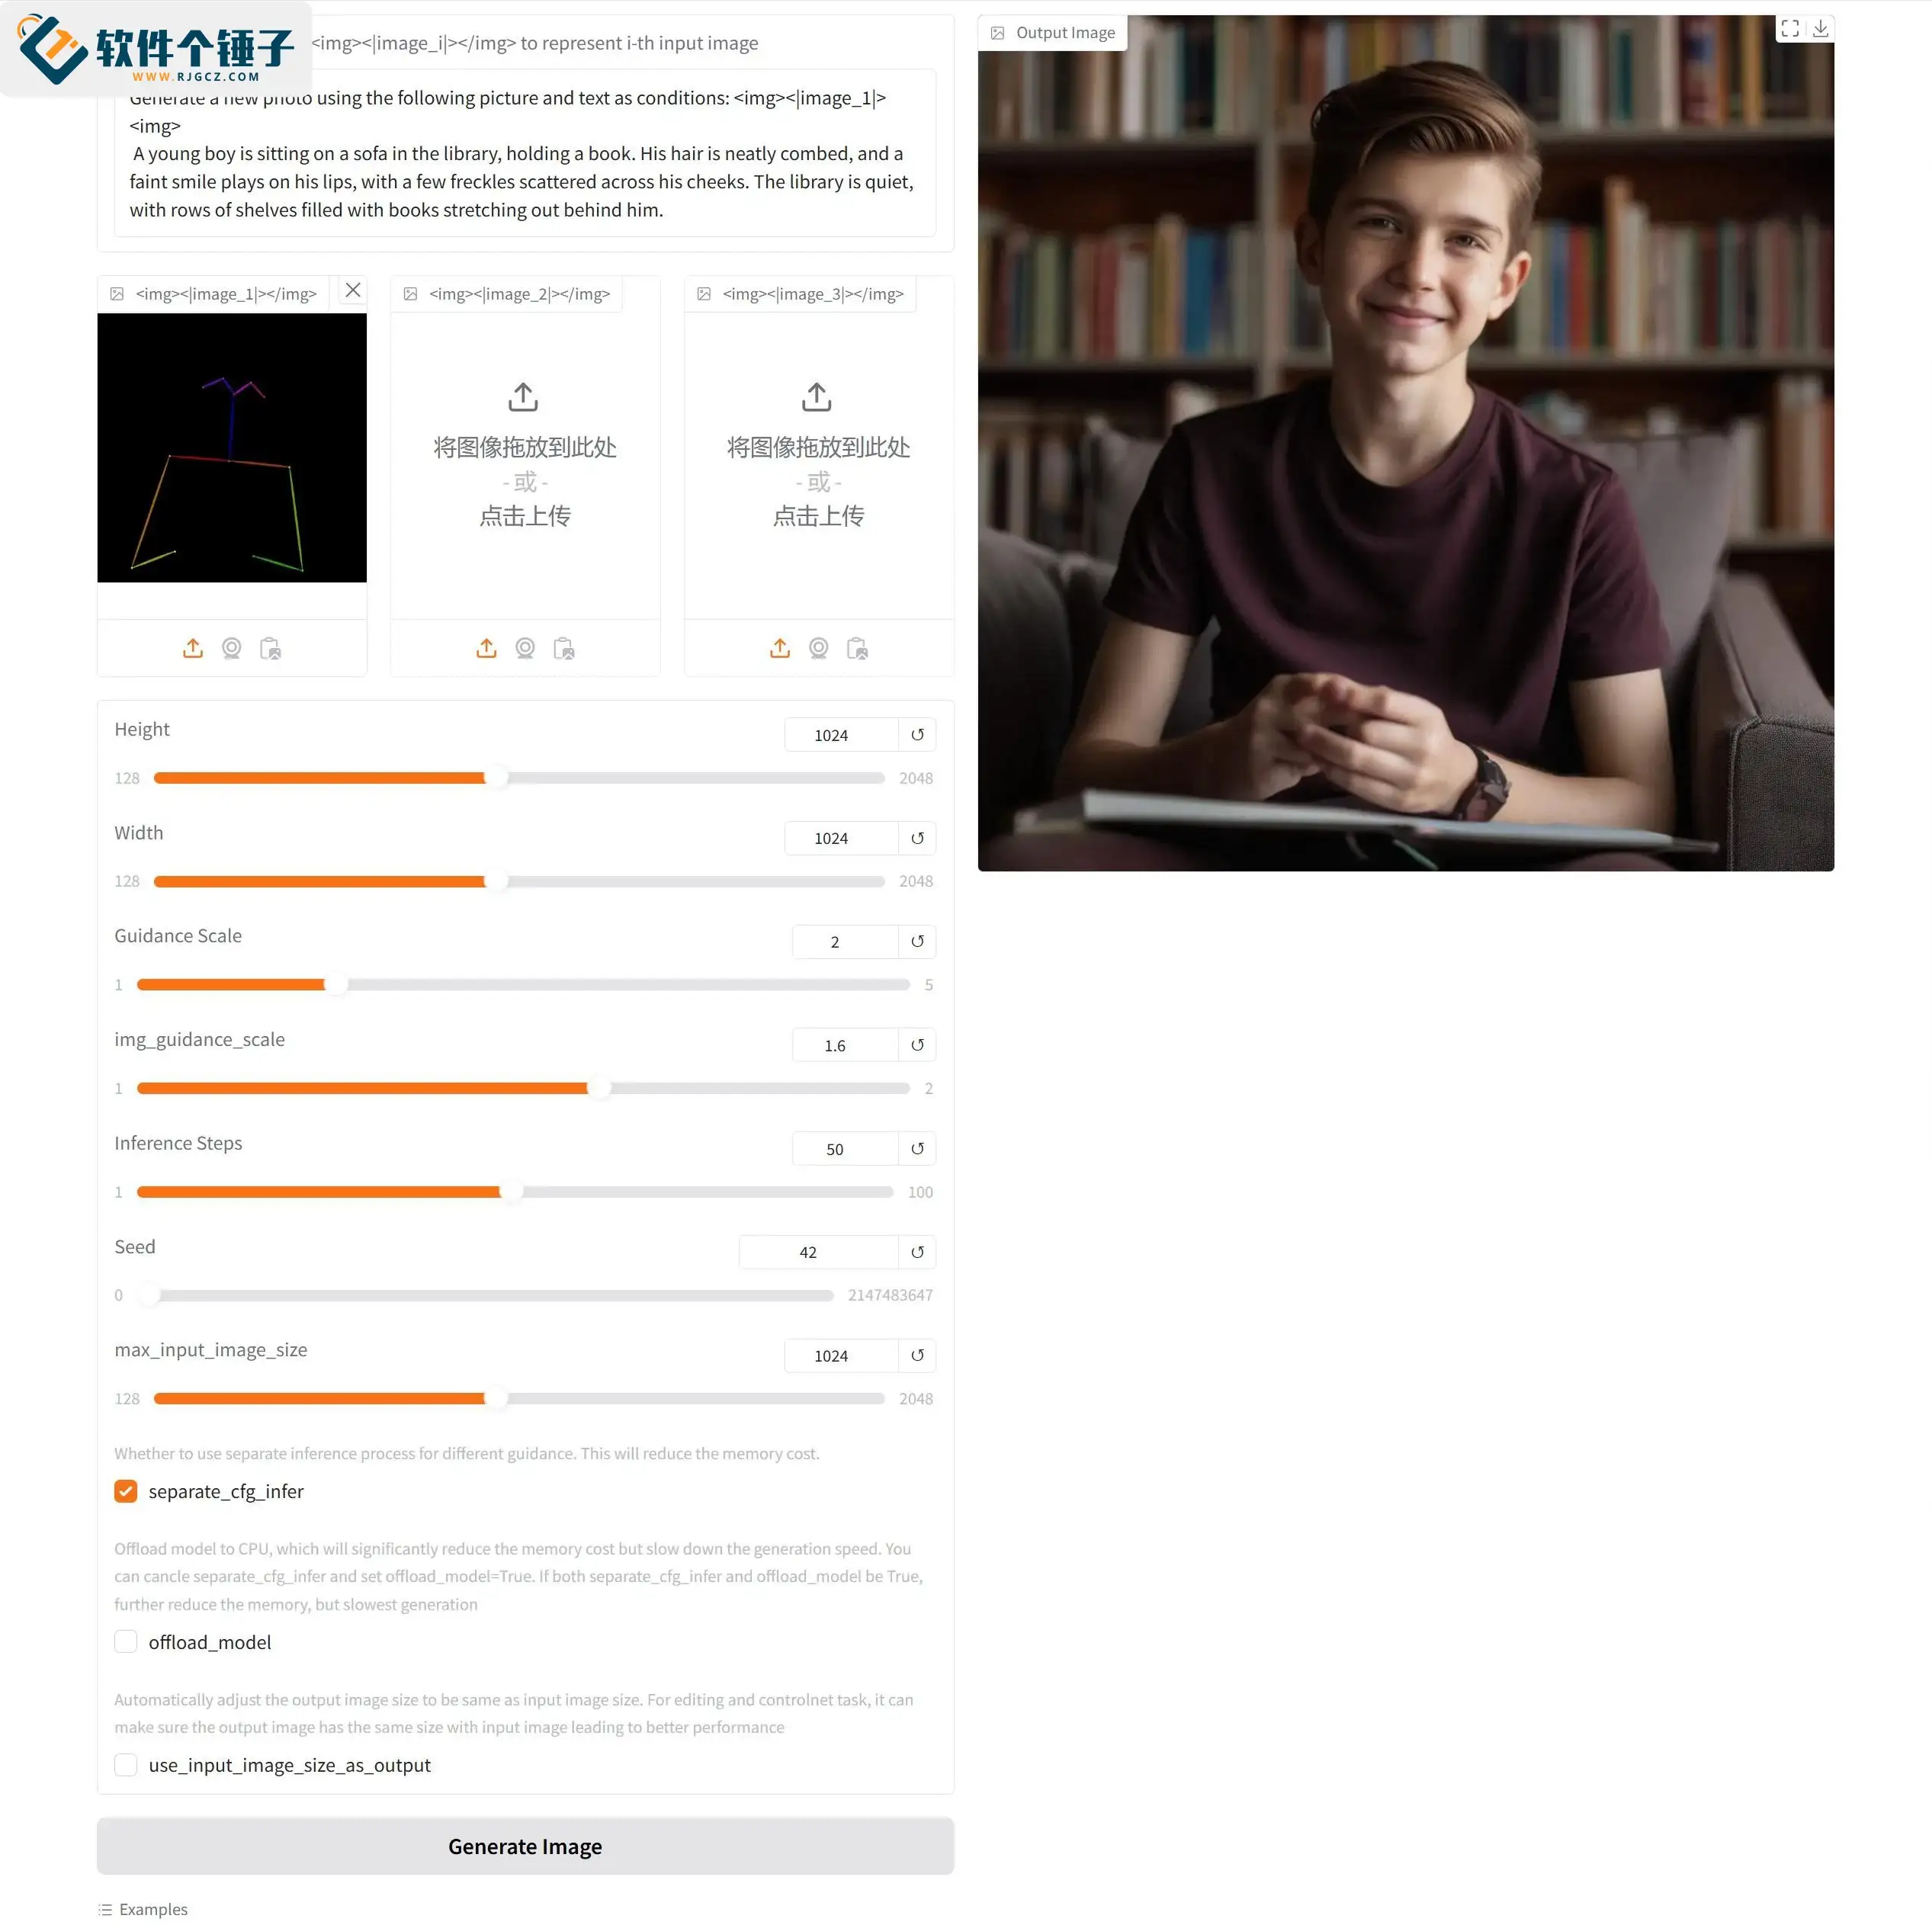
3. Geração baseada em pose
Prompt: Generate a new photo using the following picture and text as conditions: <img><|image_1|><img>
A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him.
Tradução: Gere uma nova imagem usando a imagem e o texto a seguir como condições: <img><|image_1|></img> Um menino está sentado num sofá na biblioteca, com um livro nas mãos. O cabelo dele está bem penteado e um leve sorriso brinca em seus lábios, com algumas sardas espalhadas pelas bochechas. A biblioteca está silenciosa, com fileiras de estantes cheias de livros se estendendo atrás dele.

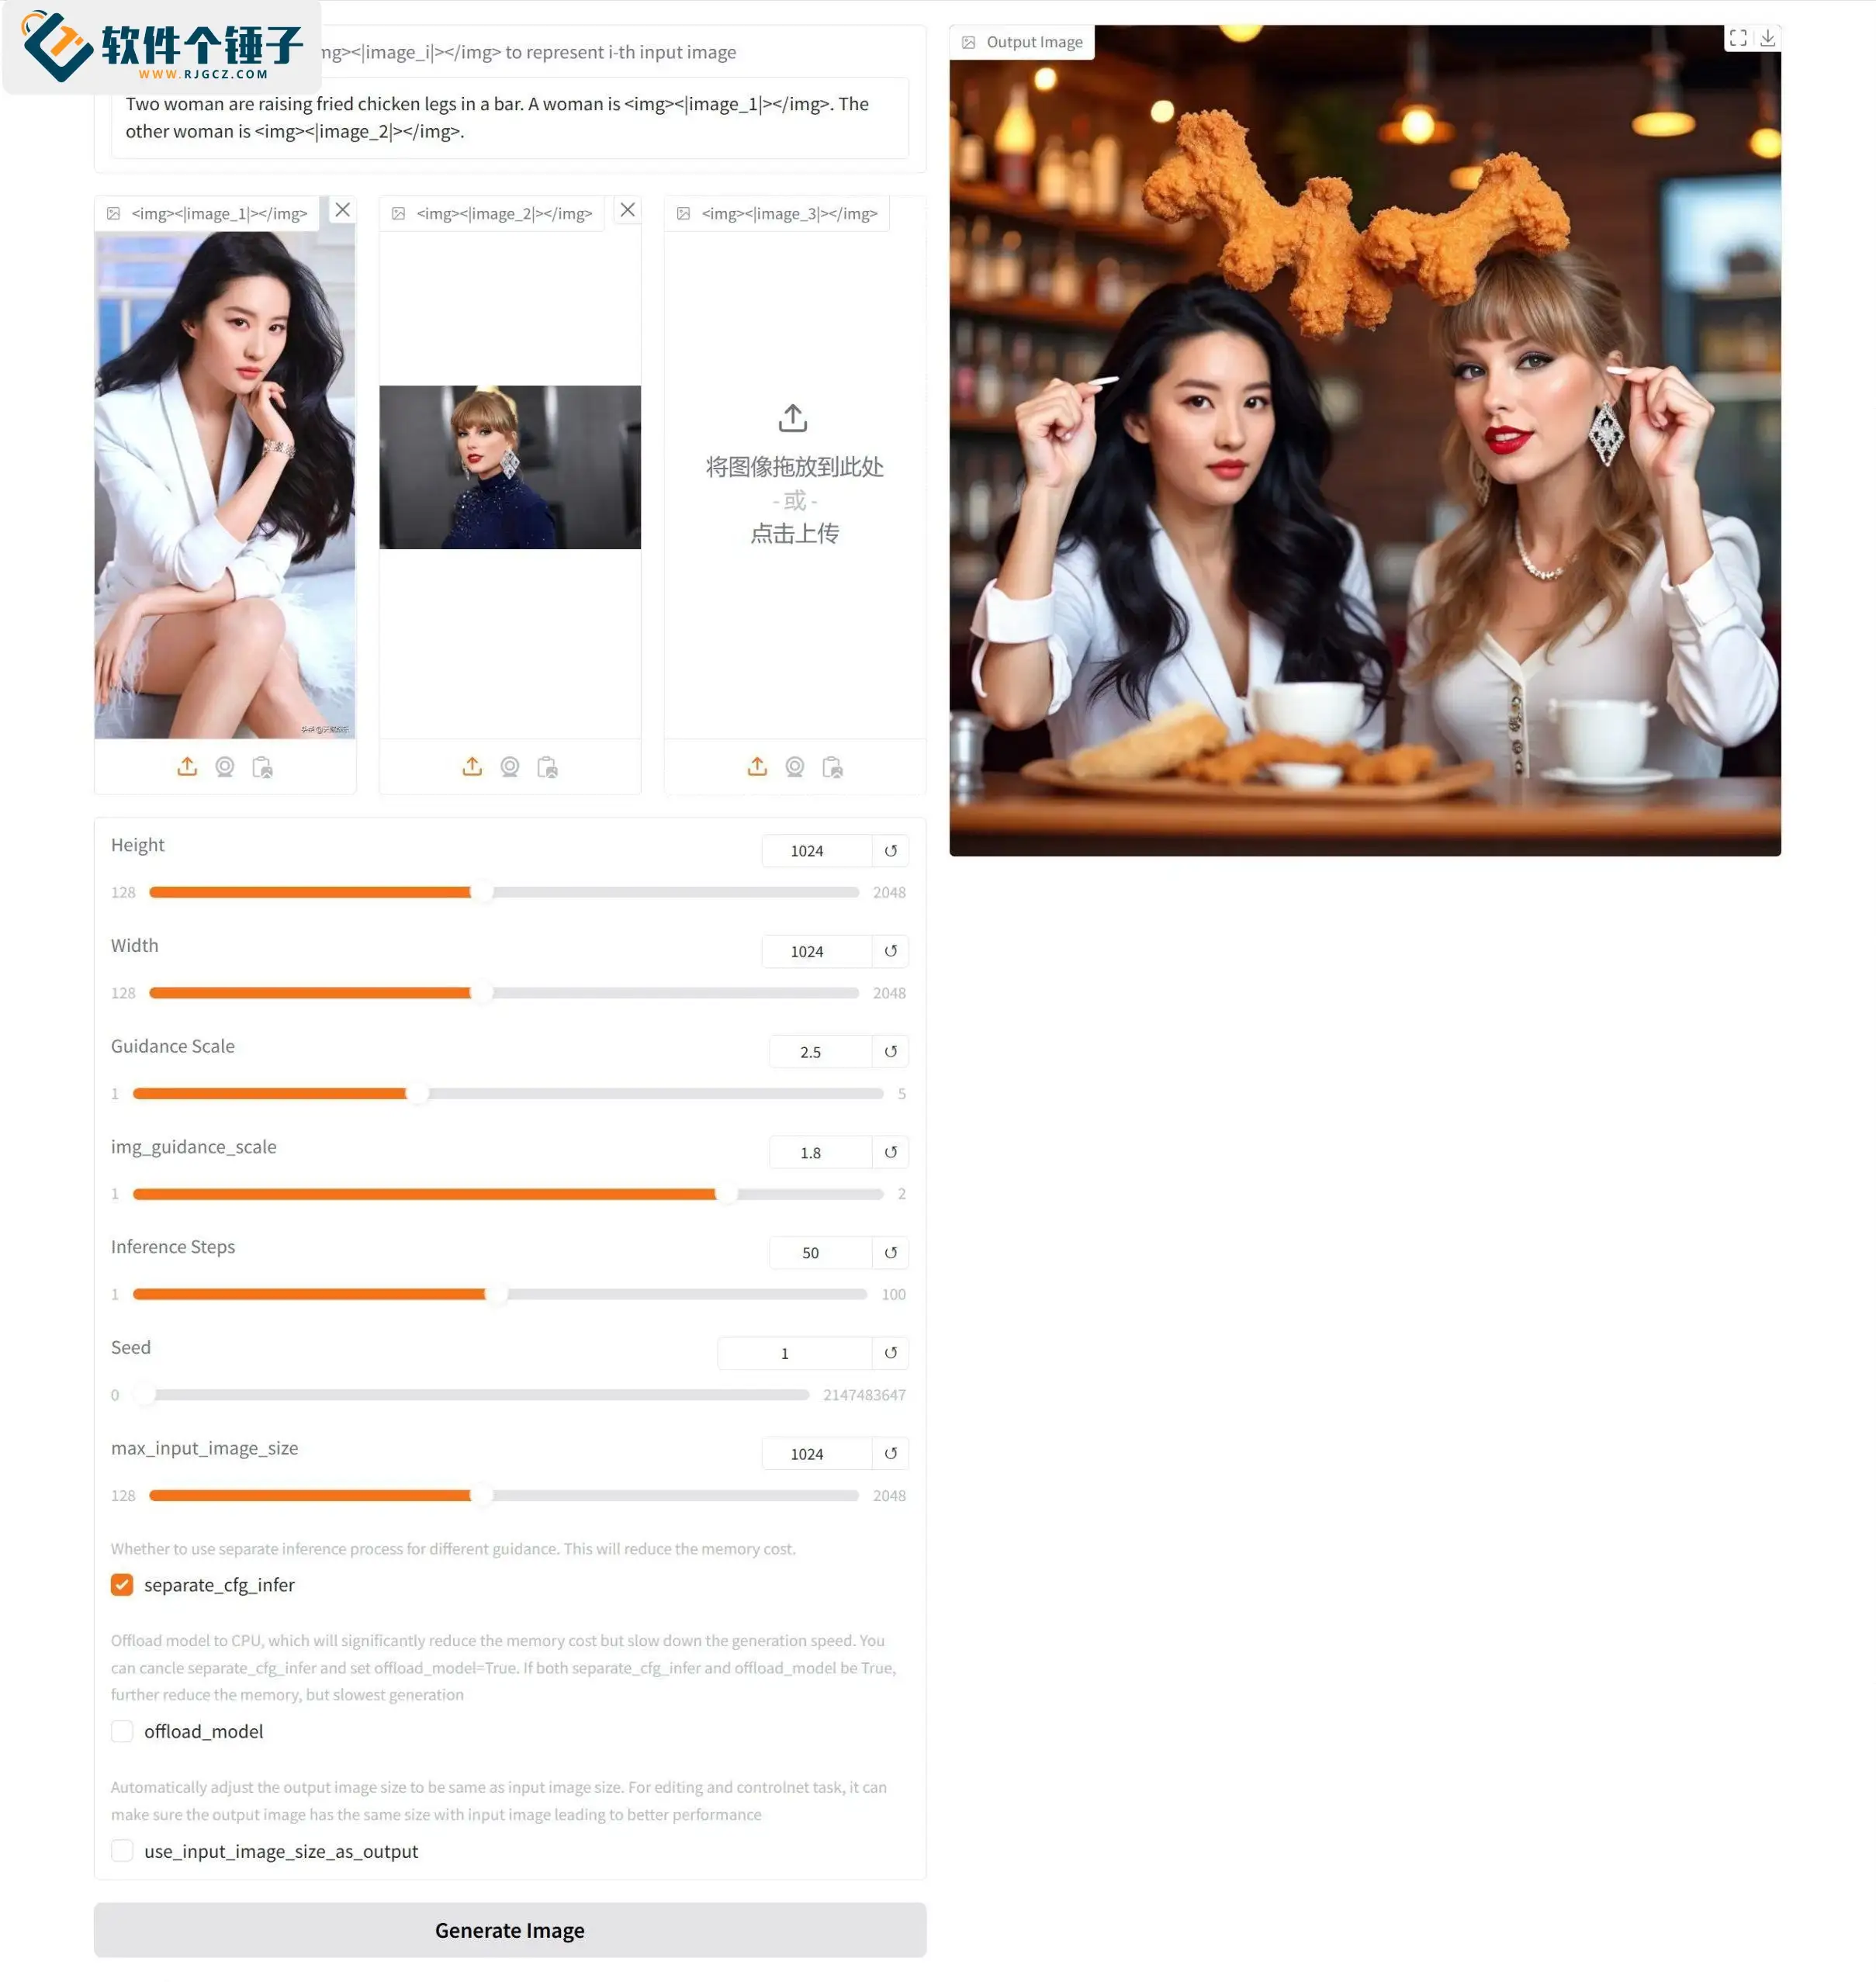
4. Colocar as pessoas de duas imagens em uma única imagem
Prompt: Two woman are raising fried chicken legs in a bar. A woman is <img><|image_1|></img>. The other woman is <img><|image_2|></img>.
Tradução: Duas mulheres estão erguendo coxas de frango frito num bar. Uma mulher é <img><|image_1|></img>. A outra mulher é <img><|image_2|></img>.

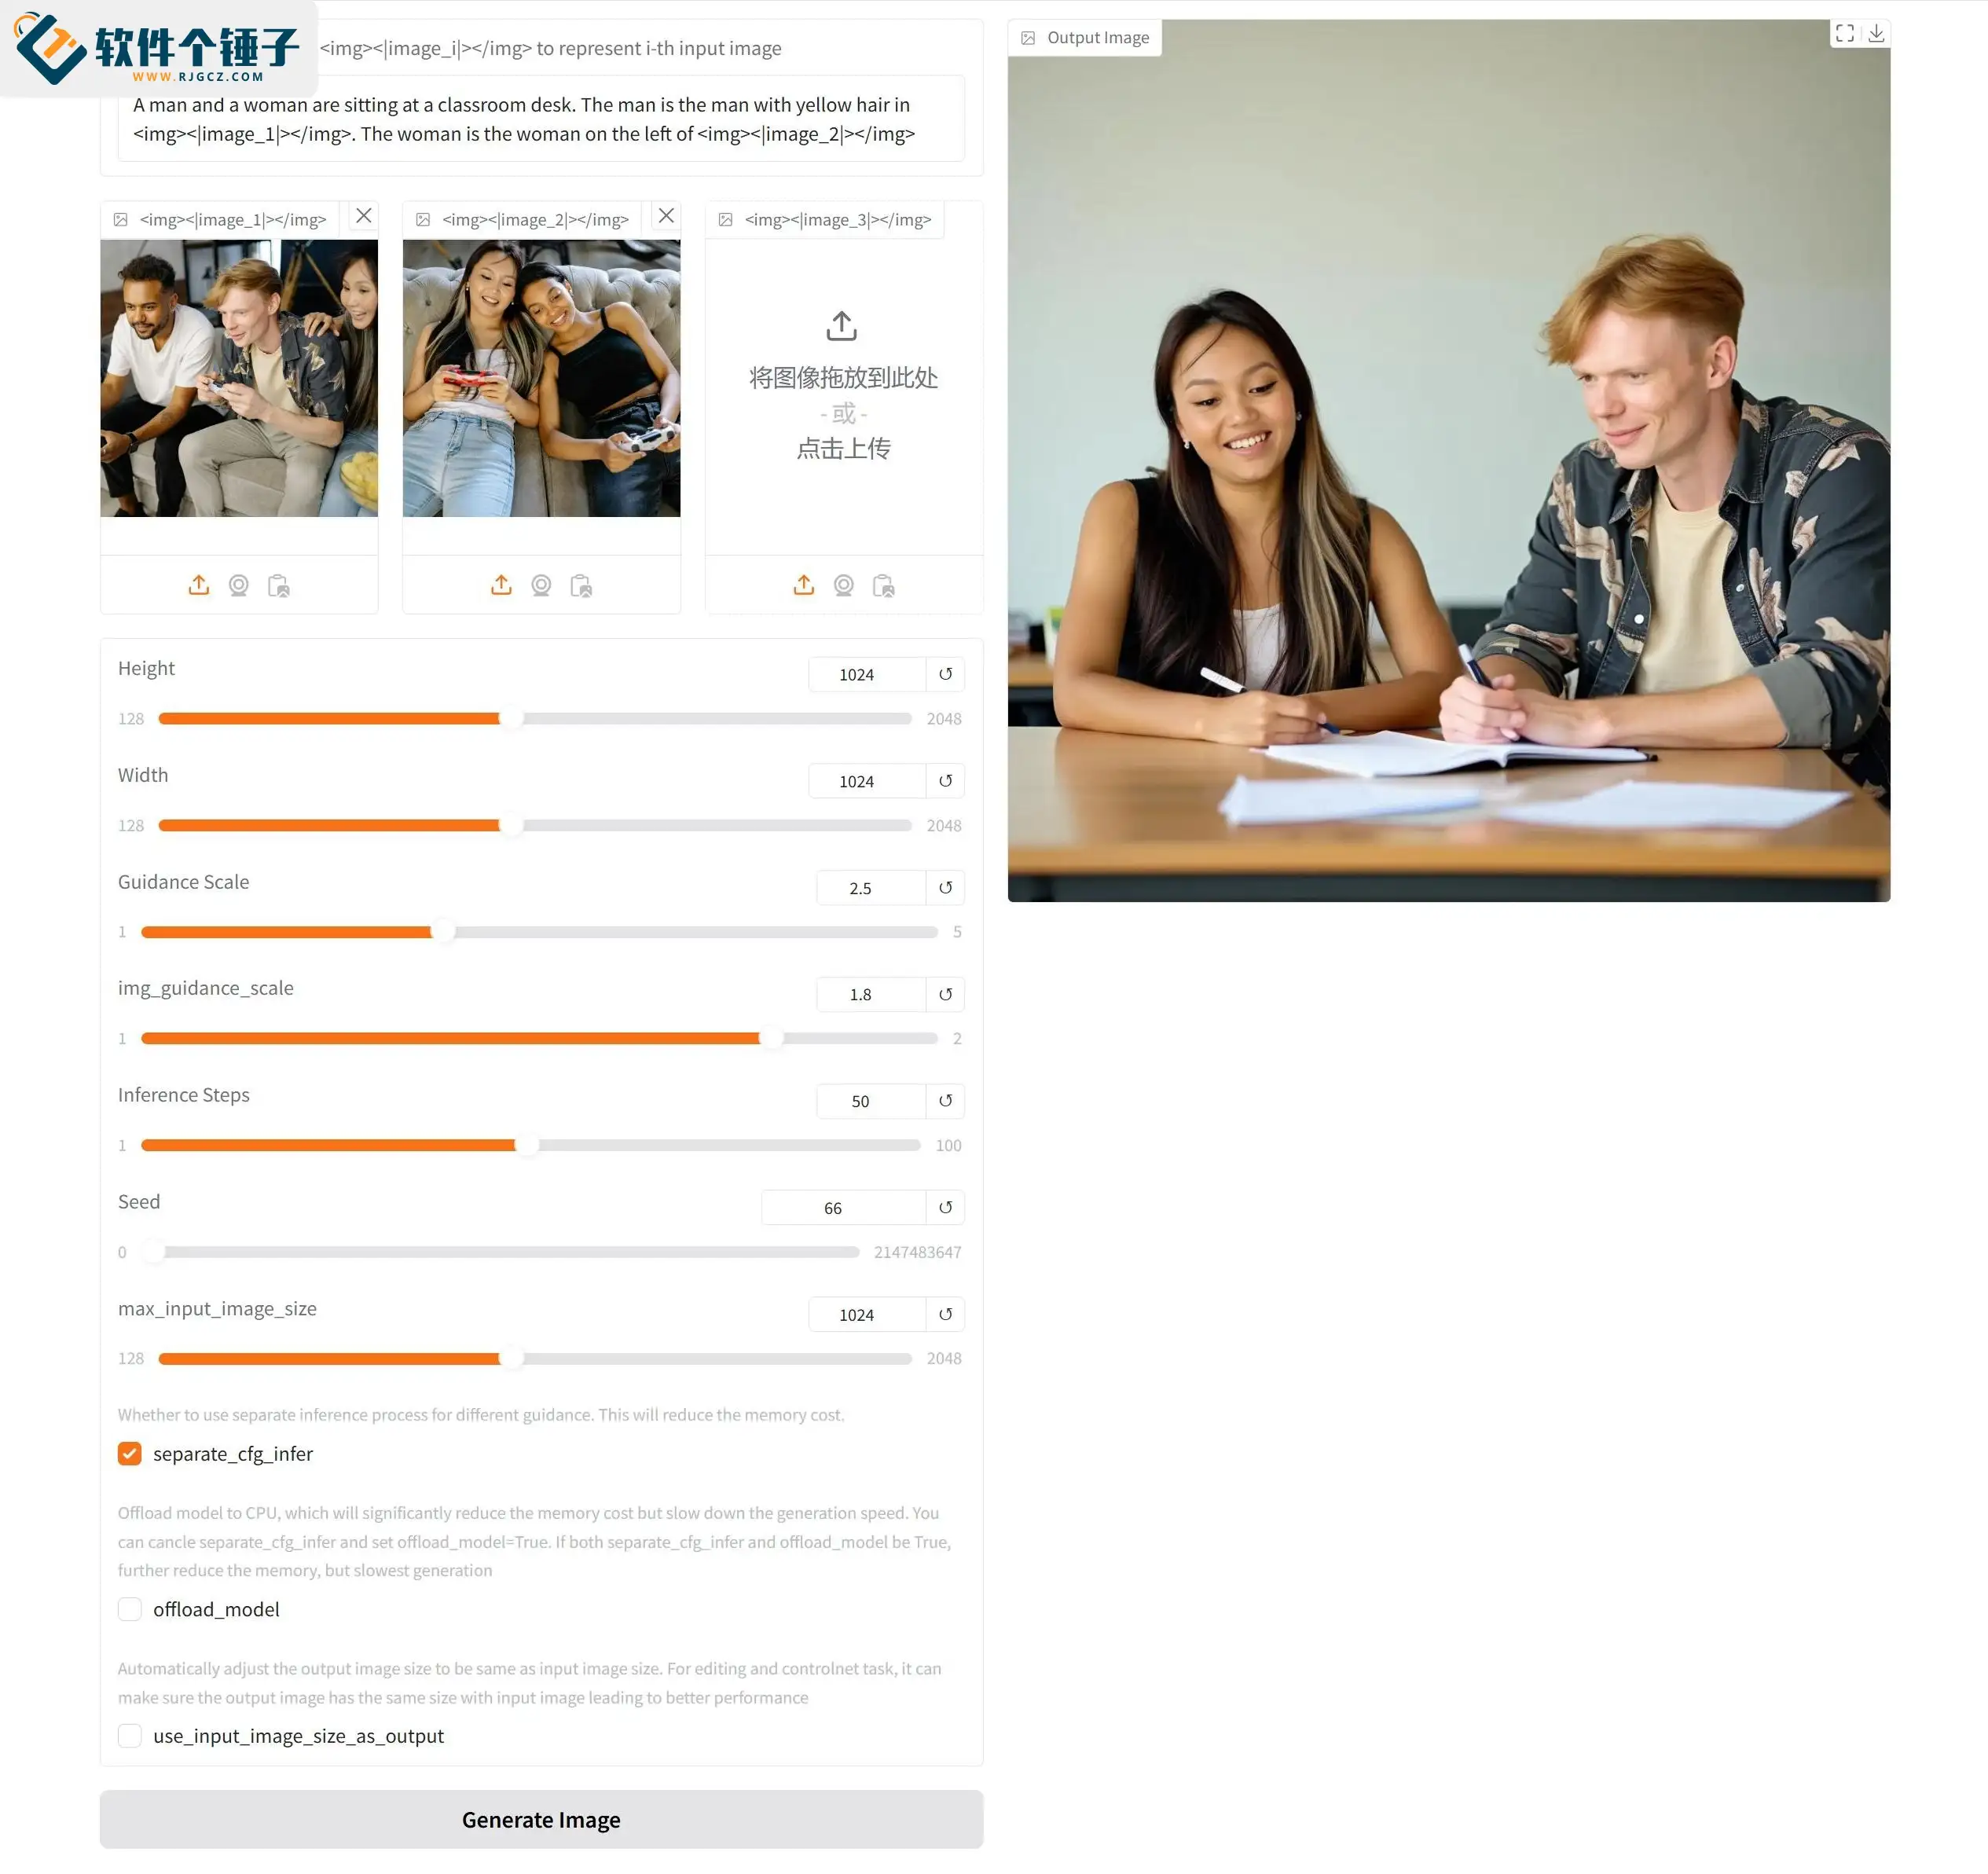
5. Extrair uma pessoa específica de uma multidão e colocá-la em uma imagem
Prompt: A man and a woman are sitting at a classroom desk. The man is the man with yellow hair in <img><|image_1|></img>. The woman is the woman on the left of <img><|image_2|></img>.
Tradução: Um homem e uma mulher estão sentados numa carteira de sala de aula. O homem é o de cabelo amarelo em <img><|image_1|></img>. A mulher é a mulher à esquerda de <img><|image_2|></img>.

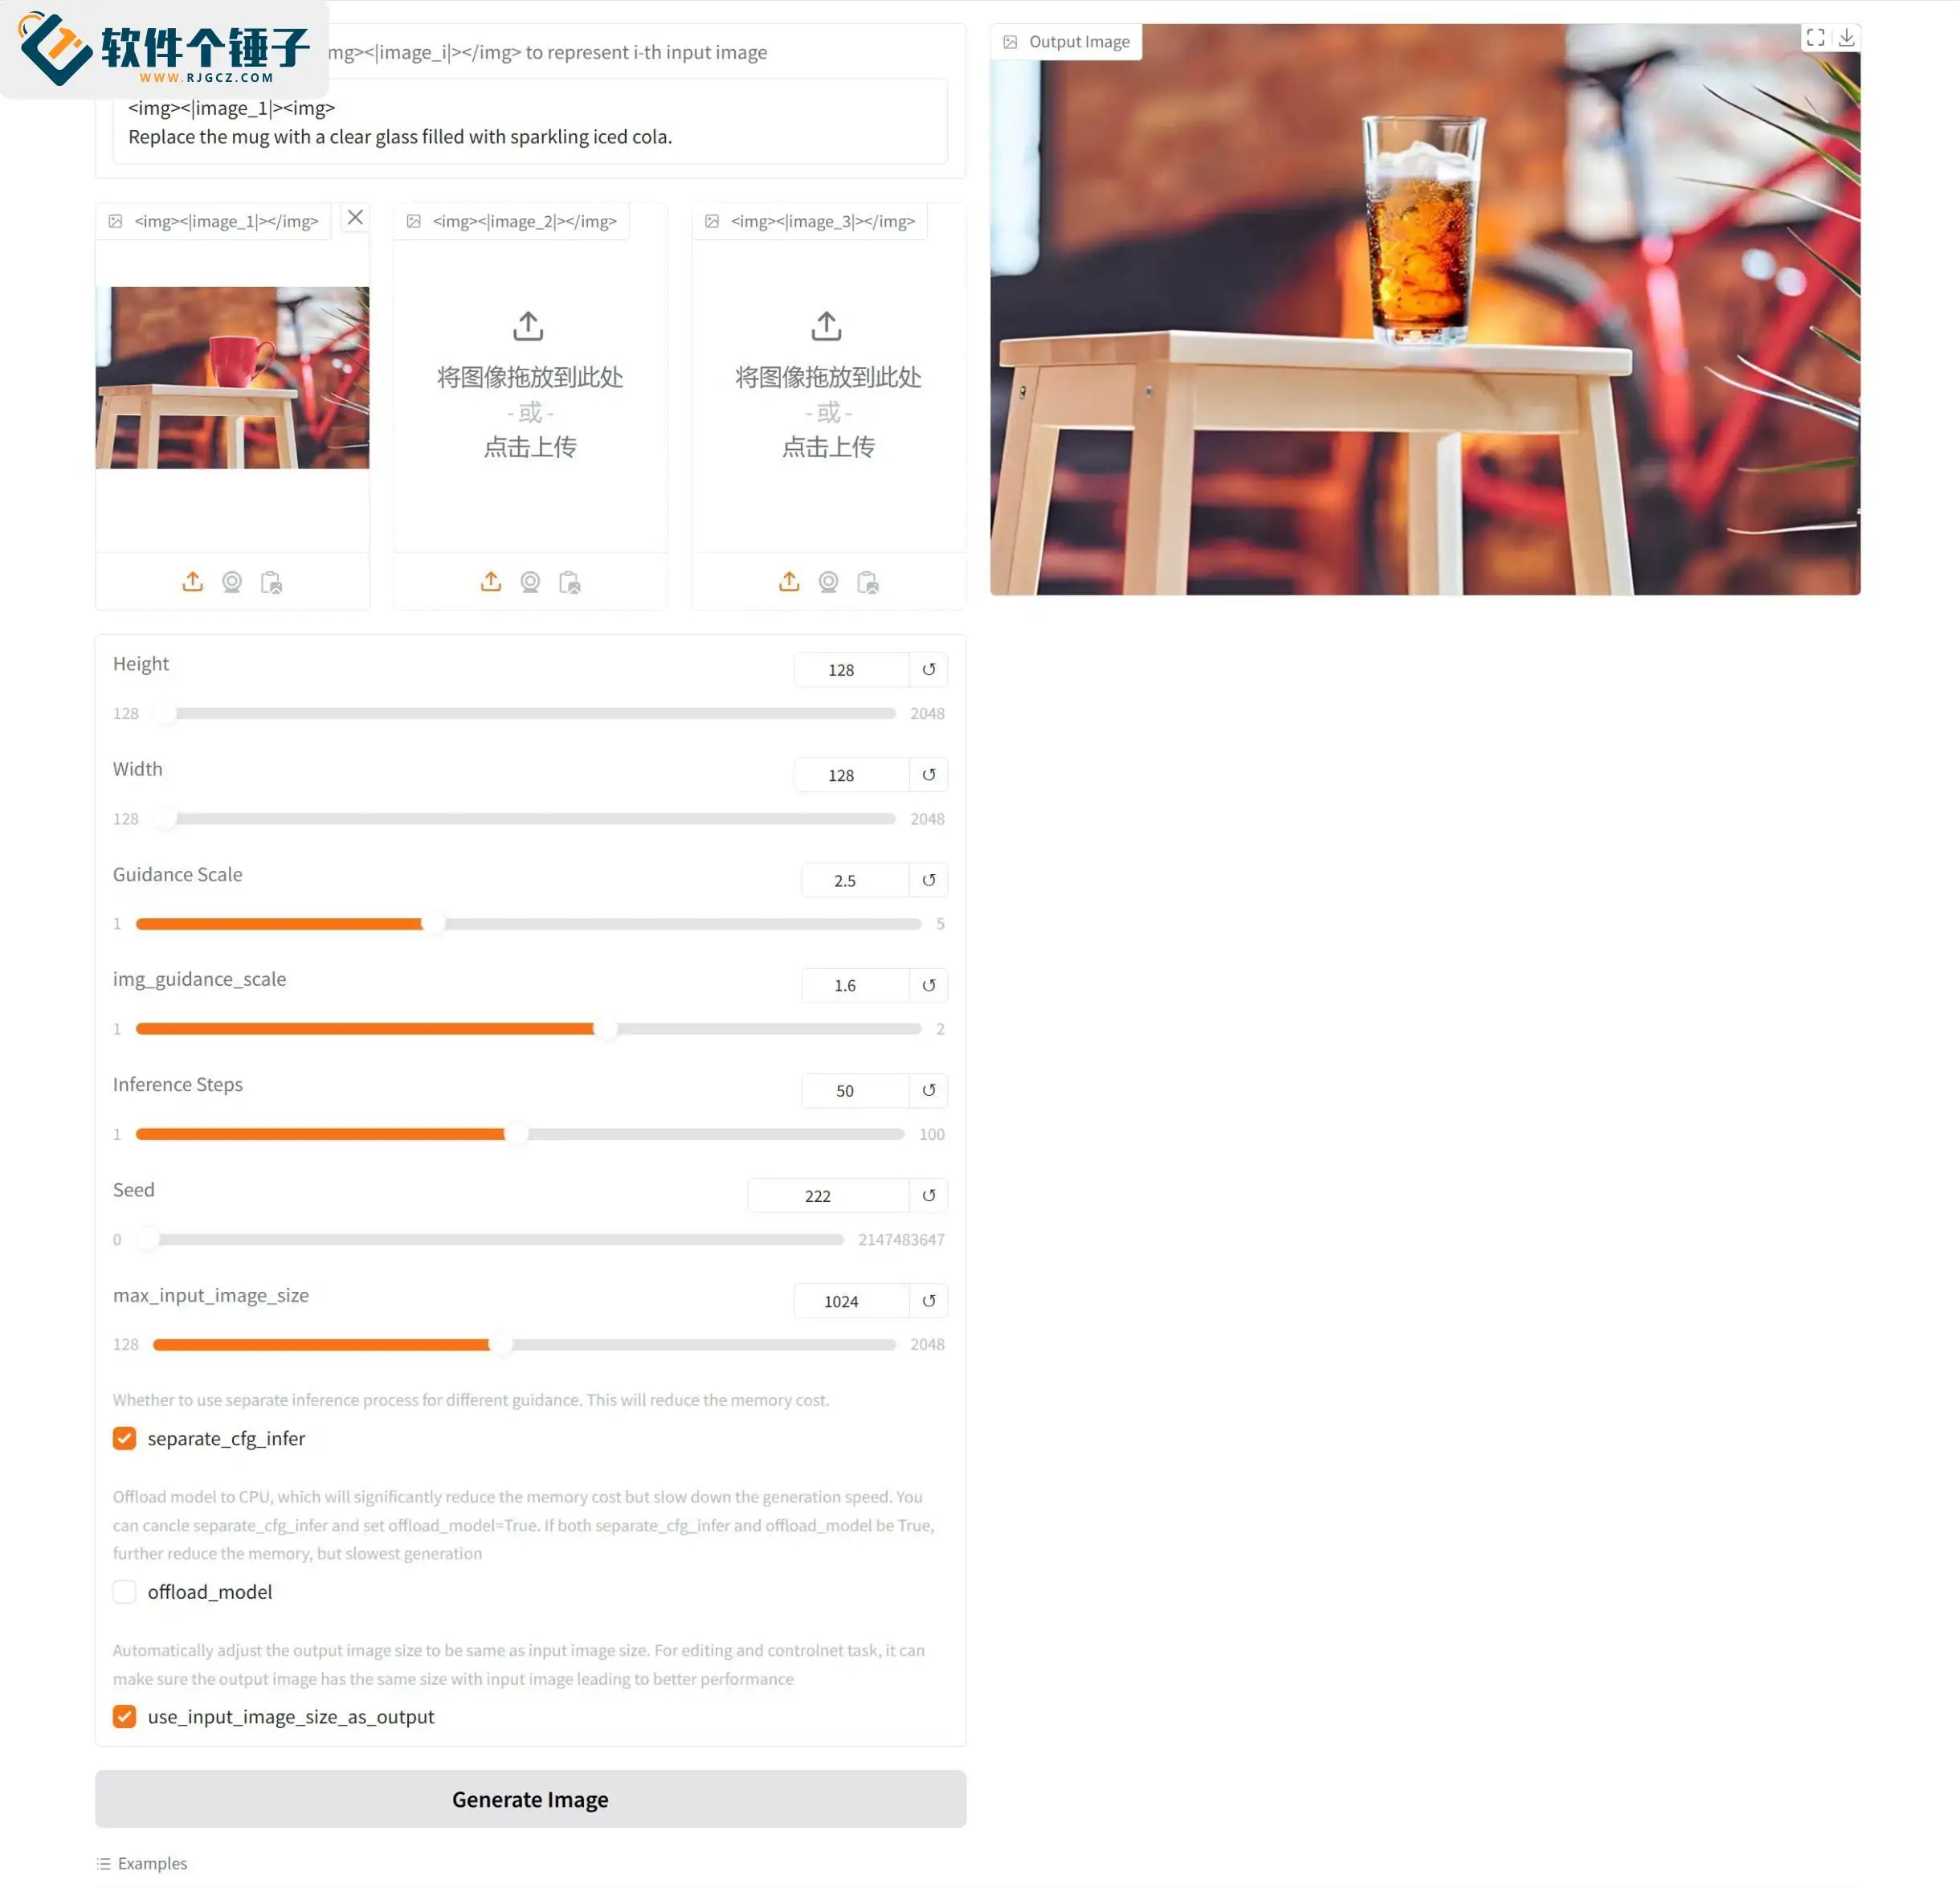
6. Alterar objetos na imagem
Prompt: <img><|image_1|><img>
Replace the mug with a clear glass filled with sparkling iced cola.
Tradução: <img><|image_1|><img>
Substitua a caneca por um copo transparente cheio de cola gelada com gás.

Endereço do projeto de código aberto
[Endereço oficial do OmniGen]
Cursos relacionados

Poderosa caixa de ferramentas local! Gravação de tela, corte/fusão de áudio e vídeo, compressão/extração de vídeo, etc., gratuito permanente – Kedou Video Converter Master

100% perfeito e grátis! Software PDF tudo-em-um: conversão, compressão, edição, etc., limpo sem anúncios – JOPDF

Ferramenta de desktop remoto de código aberto, superior às versões pagas! Gratuita e ilimitada para uso pessoal e comercial, multiplataforma – HopToDesk

Ferramenta mais recente para baixar livros didáticos do ensino fundamental e médio: recursos de um ano inteiro, slides, vídeos e áudios com um clique

O dia todo olhando para a tela, como ficar sem uma ferramenta de proteção ocular? Aplicativo gratuito de proteção contra luz azul para PC, com um pet que te lembra de descansar na hora certa, Huyanbao

PyIsland: centro de controle do sistema moderno com Dynamic Island na área de trabalho do Windows

Produção de manhuá 3D simulado: prática completa do Seedance 2.0, do zero à criação de manhuá de alta qualidade

Compatível com Win/Mac! Última versão vitalícia: restaure fotos antigas, melhore a nitidez e amplie sem perda - Aiarty Image Enhancer

Ferramenta de download de Bilibili de código aberto no Github: download em lote de vídeos de Bilibili com suporte a 8K e Dolby Vision, fácil de usar, Bilidown

Coleção de ferramentas de desktop Windows! 50+ widgets de desktop práticos e minimalistas, com captura de tela, gravação de tela, tradução, previsão do tempo etc., caixa de ferramentas Duomi

Contact Info
- E-mail: massivesidehustles@outlook.com
