


-
Solounternehmens-Kurse
-
 Sonstiges
-
Auslandskurse
-
Fotografie & Schnitt
-
Community & Private Domain
-
Schreiben & Texten für Medien
-
Nebenverdienst-Projekte
-
E-Commerce
-
Kurzvideos & Live-Streaming
-
Künstliche Intelligenz (KI)
-
Software & Tools
-
Betriebssysteme
-
Plugins & Skripte
-
MacOS-Software
-
Android-Software
-
Windows-Software


KI-Stimmklon mit Unterstützung für Dialoge mehrerer Figuren F5 TTS-V3 kostenlos und Open Source, Start mit einem Klick, keine Bereitstellungslizenz nötig (Software-Hammer · R2264)
-
Goldfarming-Geldverdienplan für Spiele: täglich über 1.000 verdienen – ein stabiles 3-Jahres-Projekt, das jeder in der Freizeit umsetzen kann
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
AI-Comic-Drama-SOP-Systemkurs: Web-Novel-Auswahl und -Adaption, Drehbuchnormen, Text-zu-Bild/Bild-zu-Video-Fertigfilm, Voice-over und Schnitt – standardisiertes Full-Flow-Umsetzungs-Tutorial (Update 0826)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Hot-Game-vollautomatisiertes Verdienen: 500+ pro Tag, keine Erfahrung, einfache Bedienung – das stetigste langfristige Game-Verdienst-Nebenprojekt (enthüllt)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Douyin-Verkaufs-Begleitcamp: kein echtes Auftreten nötig, Anfänger kopieren Vorlagen und produzieren Verkaufsvideos
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Premier-Game-Farming-Geldplan: 1.000+ täglich, für Normalverdiener in der Freizeit machbar! [Enthüllung]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten






-
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Lu Master v6.1024.4105.1121 schlanke Single-File-Version [Software Ge Chuzi · R1880]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Software zur Erstellung zweidimensionaler Cartoon-Animationen Moho Pro v14.3 [Software Gezhi Chuzi · R2355]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PC-Videobearbeitungssoftware Aiseesoft Filmai v1.0.18 【Software Gezhi·R2470】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Microsoft To Do v2.147 Offizielle kostenlose Version [Software Gechui·R2618]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PR/AE/DaVinci/FCPX Video-Farbkorrektur-Oszilloskop-Plugin Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Gechui·R2748】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten





F5-TTS ist ein leistungsstarkes Text-zu-Sprache-System (TTS), das eine natürliche und flüssige Sprachgenerierung bietet. Es unterstützt den Sprachwechsel, die Anpassung der Sprechgeschwindigkeit und den Ausdruck von Emotionen und zeichnet sich durch eine besondere Zero-Shot-Generierung sowie die Vorteile groß angelegten Sprachtrainings aus. Die neue Zwei-Personen-Dialogfunktion erweitert die Einsatzmöglichkeiten zusätzlich und macht es zum idealen Werkzeug für globale Kommunikation und Kreation.

Funktionsmerkmale der Software
1. Sprachwechsel
Unterstützt den nahtlosen Wechsel zwischen mehreren Sprachen und deckt mühelos komplexe Spracheingaben ab.
2. Zero-Shot-Generierung
Erzeugt hochwertige Sprache ohne spezifische Trainingsbeispiele und passt sich neuen Sprachen oder unbekannten Sprechstilen an.
3. Anpassung der Sprechgeschwindigkeit
Bietet eine Geschwindigkeitssteuerung, mit der Nutzer das Sprechtempo nach Bedarf anpassen und vielfältige Szenarien bedienen können.
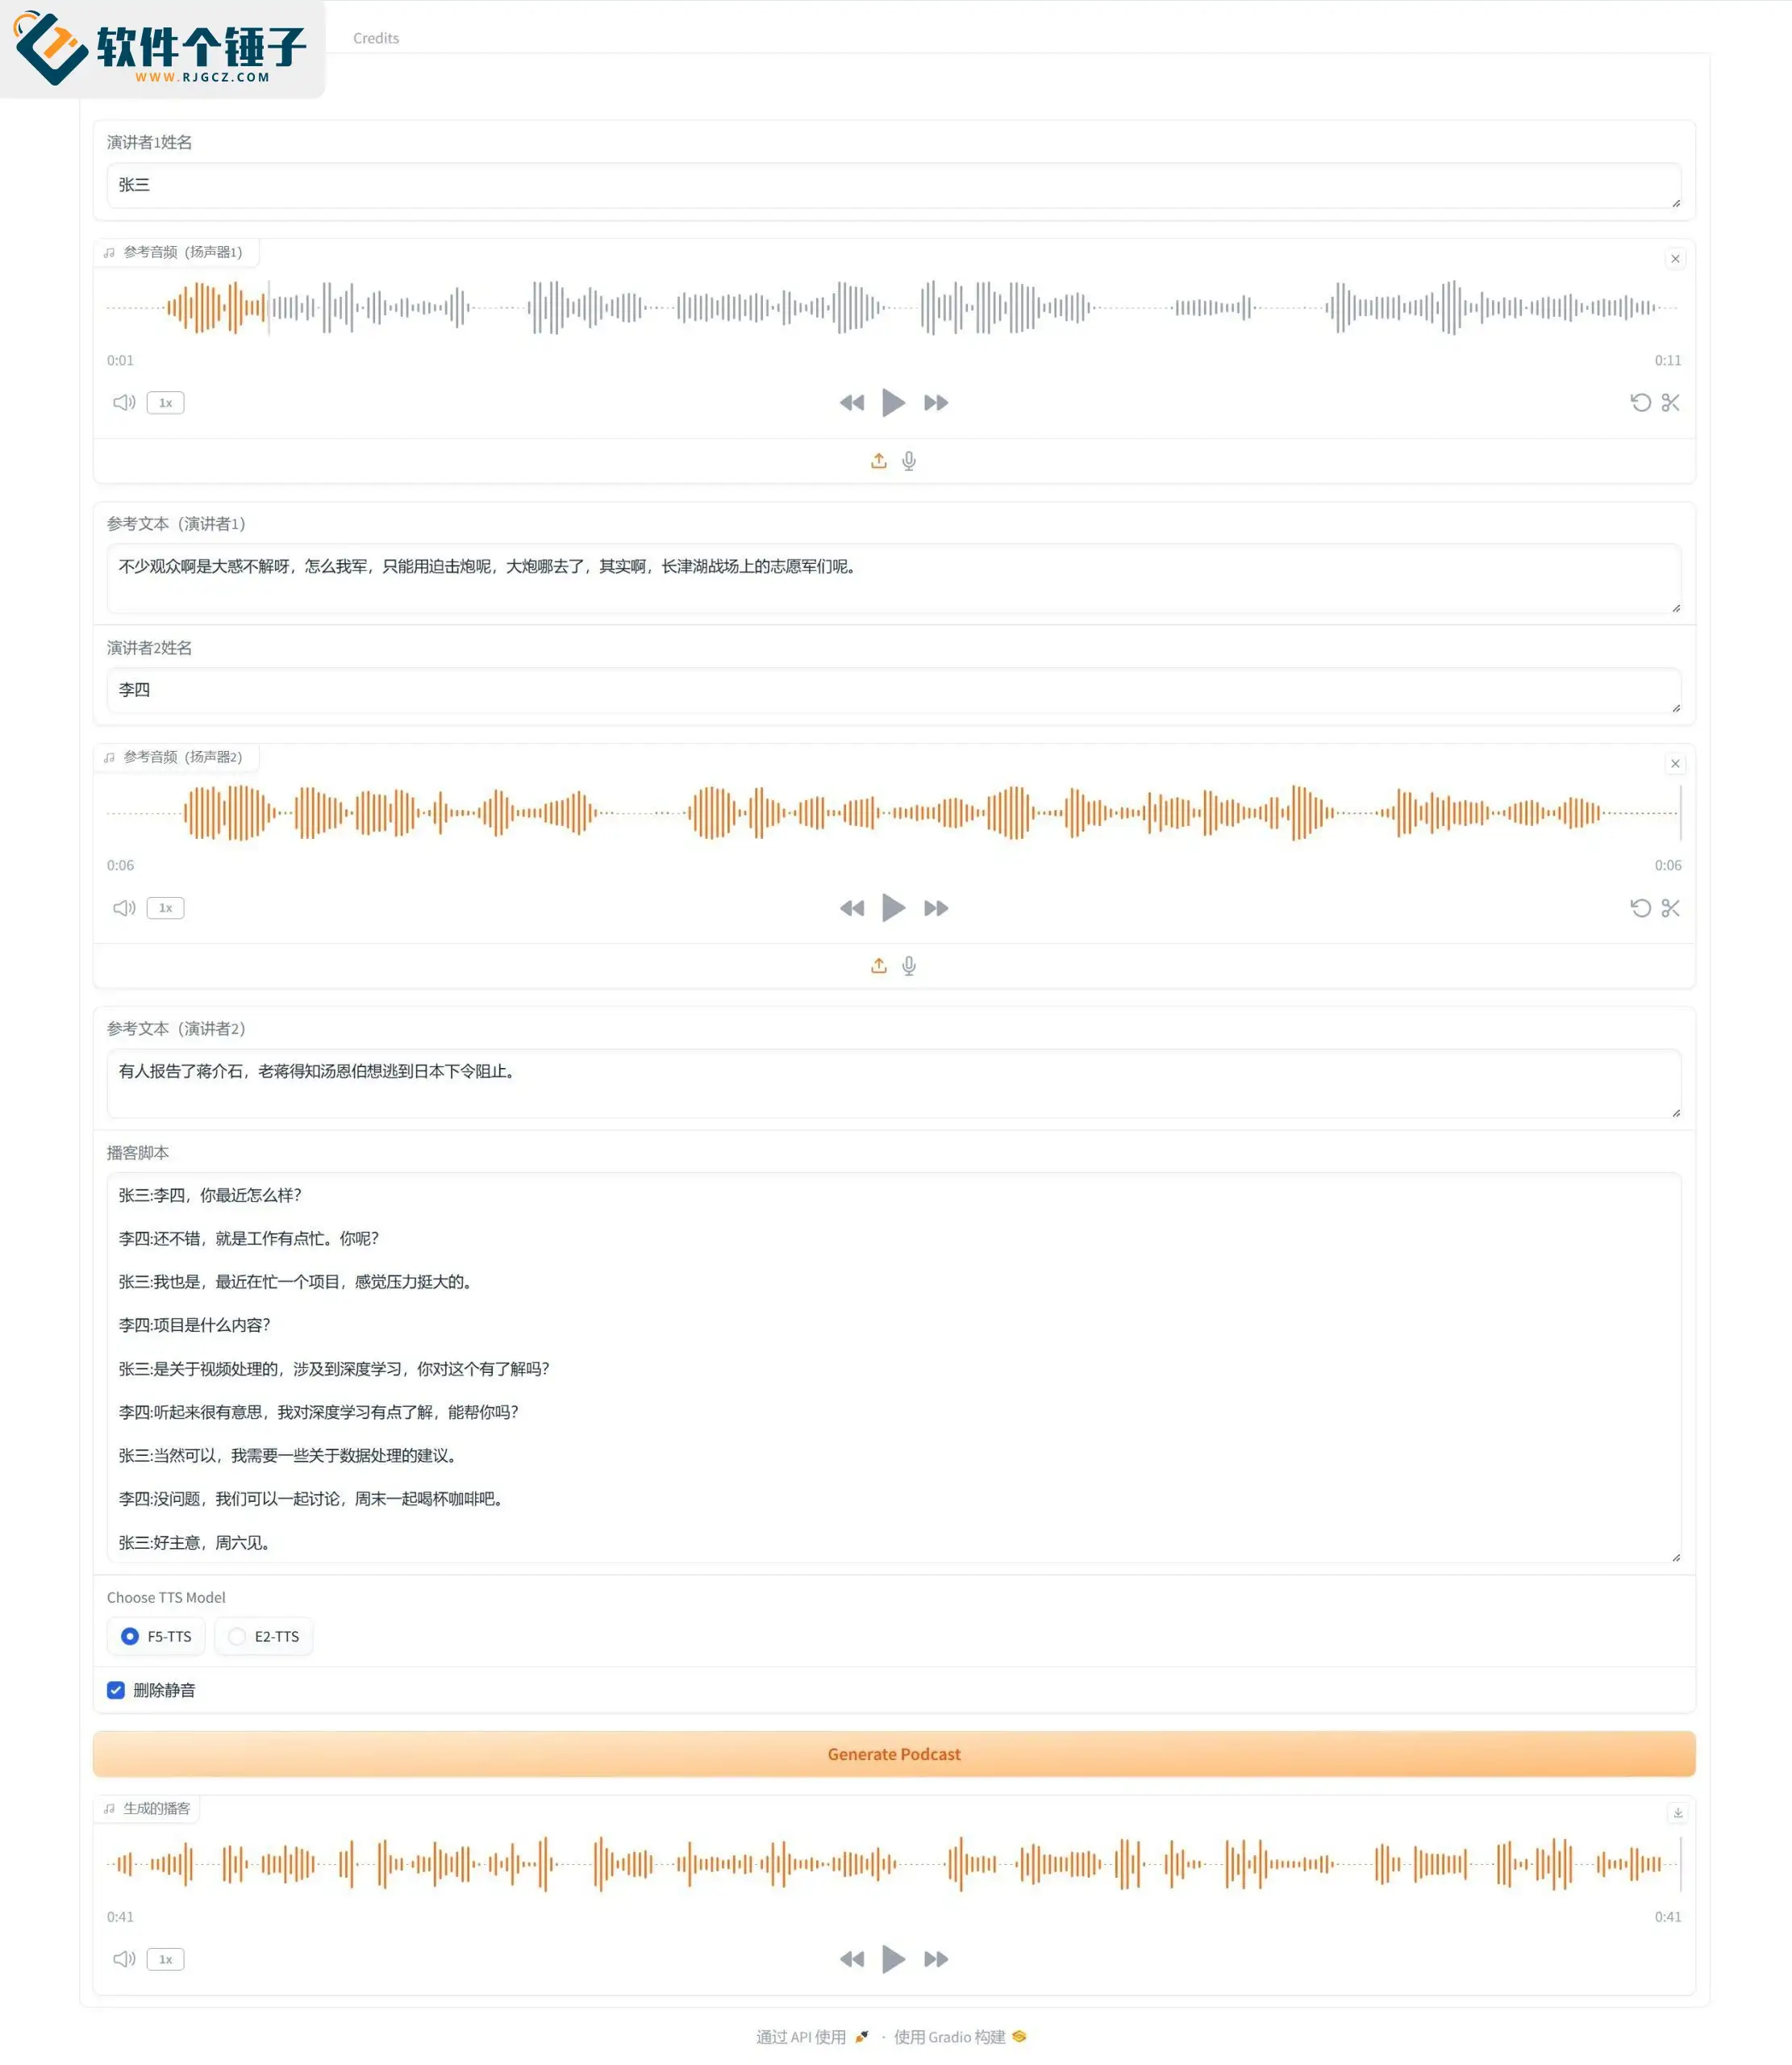
4. Zwei-Personen-Dialogfunktion
Ermöglicht die Einstellung zweier Figuren für einen Dialog, was die Erstellung dialogbasierter Inhalte erleichtert.
Anwendungsfälle
F5-TTS lässt sich breit einsetzen, etwa in intelligenten Assistenten, der Online-Bildung und der Content-Erstellung. Ob natürliche Sprachausgabe oder ausdrucksstarke Emotionen – dieses Werkzeug erfüllt die Anforderungen und eignet sich für Nutzer, die hochwertige Sprachgenerierung und Sprachunterstützung benötigen.
Systemanforderungen
– Betriebssystem: Windows 10/11 64 Bit
– Grafikkarte: empfohlen wird eine NVIDIA-Grafikkarte mit 8 GB VRAM oder mehr, Unterstützung für CUDA >= 11.8
– Festplattenplatz: nach dem Entpacken etwa 10,1 GB; ausreichend Speicherplatz sicherstellen
– So prüfst du Grafikkartenmarke und VRAM:
1. Task-Manager öffnen
2. Auf die Registerkarte "Leistung" klicken
3. "GPU" auswählen; oben rechts ist das Grafikkartenmodell zu sehen, unten wird die Größe des Grafikspeichers angezeigt

CUDA-Installationsanleitung:Klicken, um die Anleitung anzuzeigen
Anleitung
1. Komplettpaket entpacken
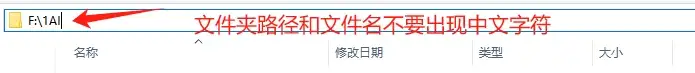
Stellen Sie sicher, dass der Entpackpfad und die Dateinamen keine chinesischen Zeichen enthalten, damit bei der Ausführung der Software keine Fehler auftreten.

2. Vorbereitung des Audiomaterials
Es wird empfohlen, die Länge des Materials auf 15 Sekunden zu begrenzen und trockenes Audiomaterial zu verwenden (ohne Hintergrundgeräusche, ohne Störgeräusche). Bei Hintergrundgeräuschen kann [UVR]verwendet werden.
3. Bedienoberfläche starten
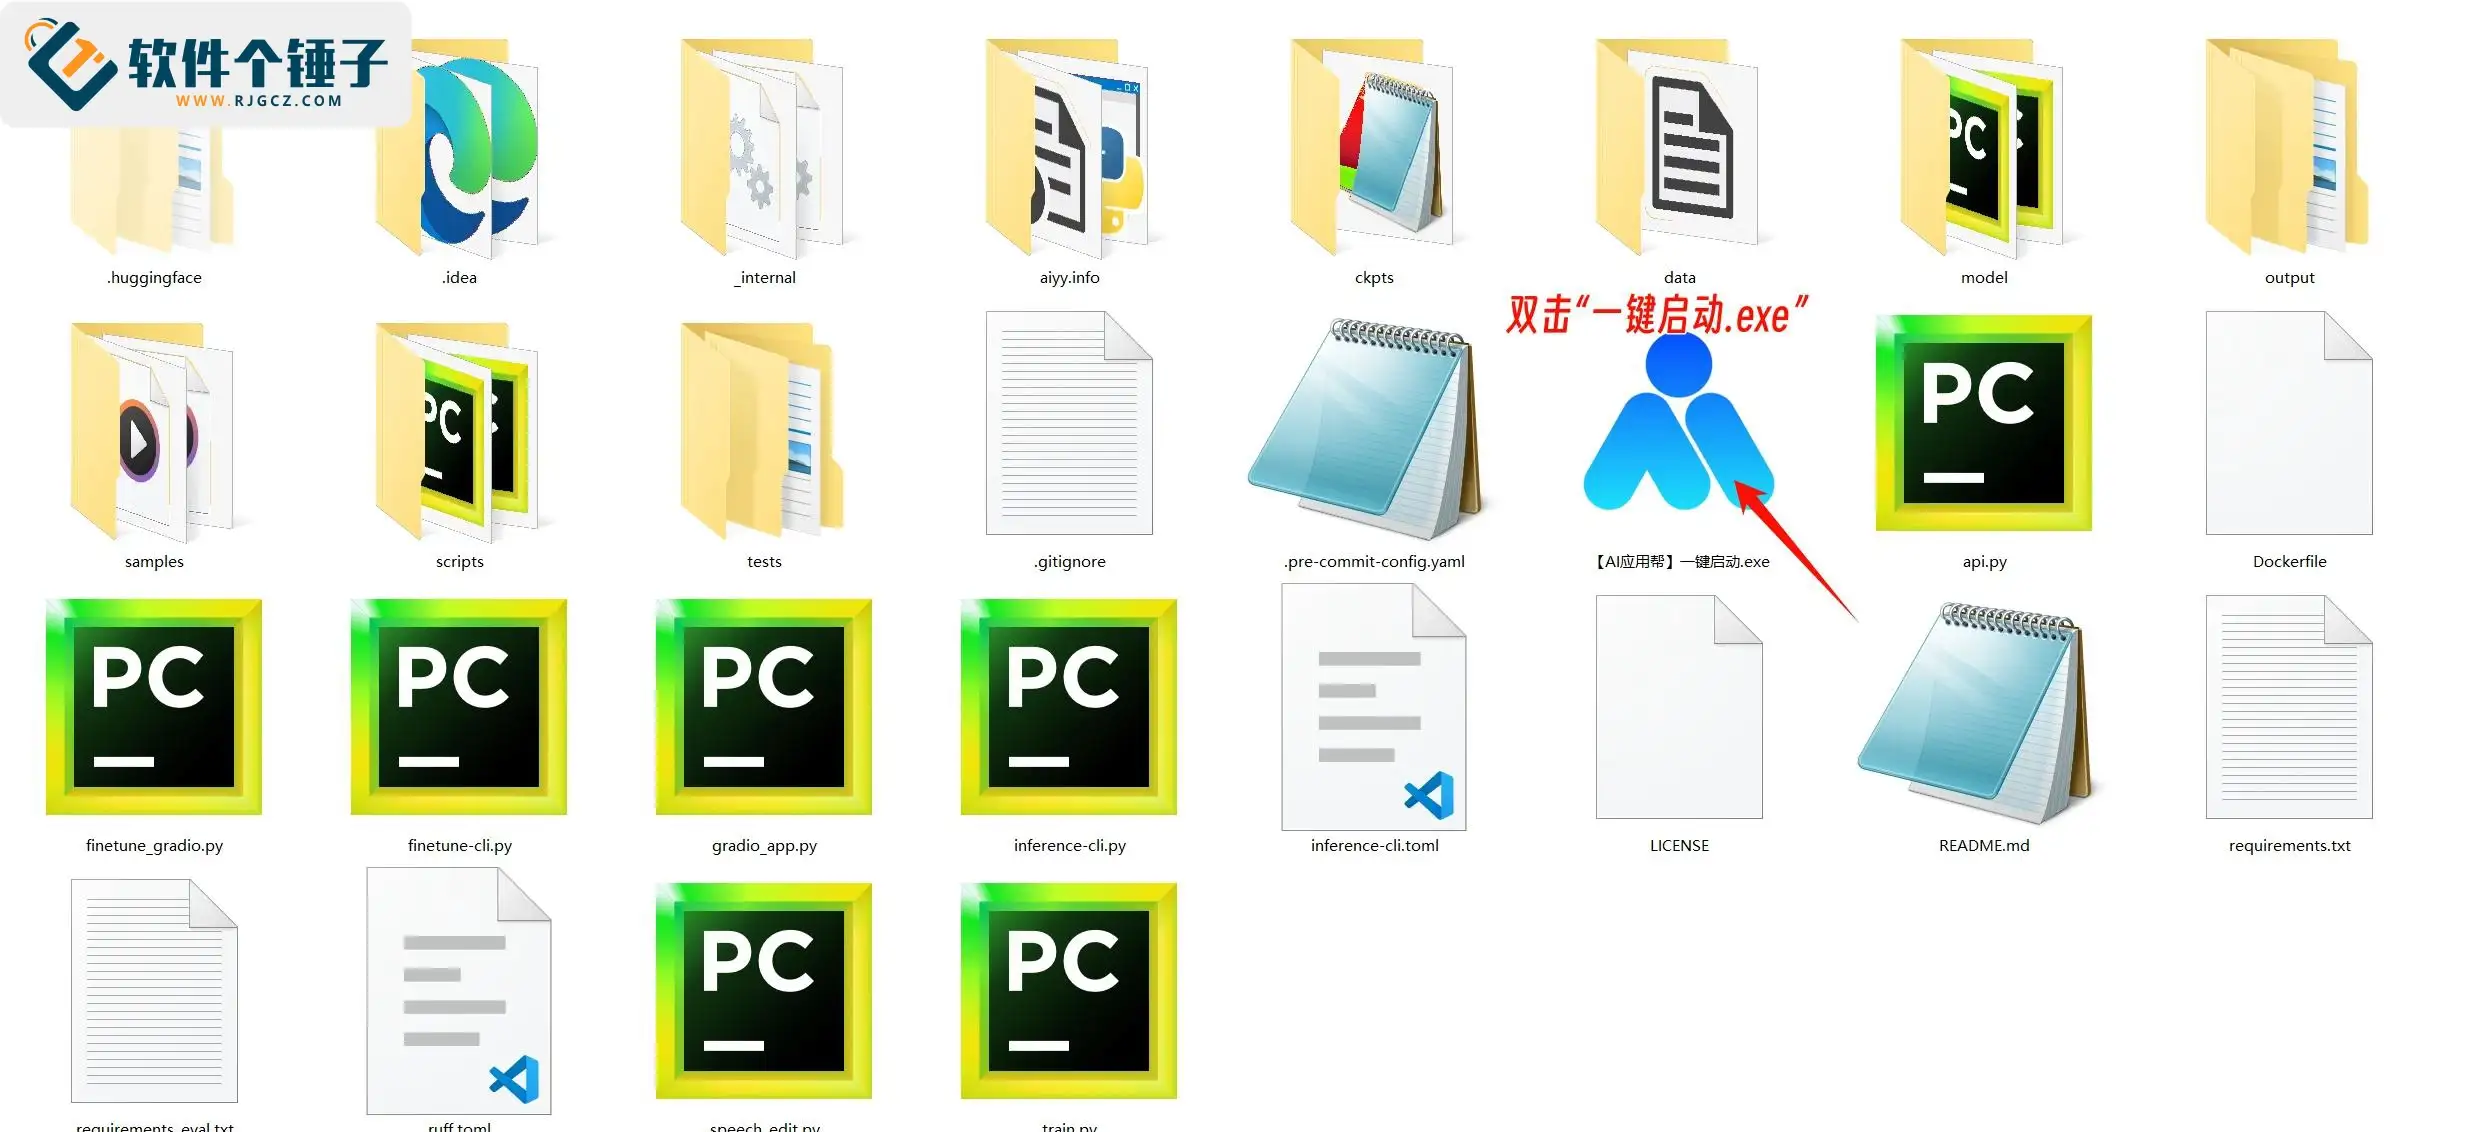
Doppelklicken Sie auf "Ein-Klick-Start.exe"; nach kurzer Wartezeit öffnet sich die Bedienoberfläche im Browser.

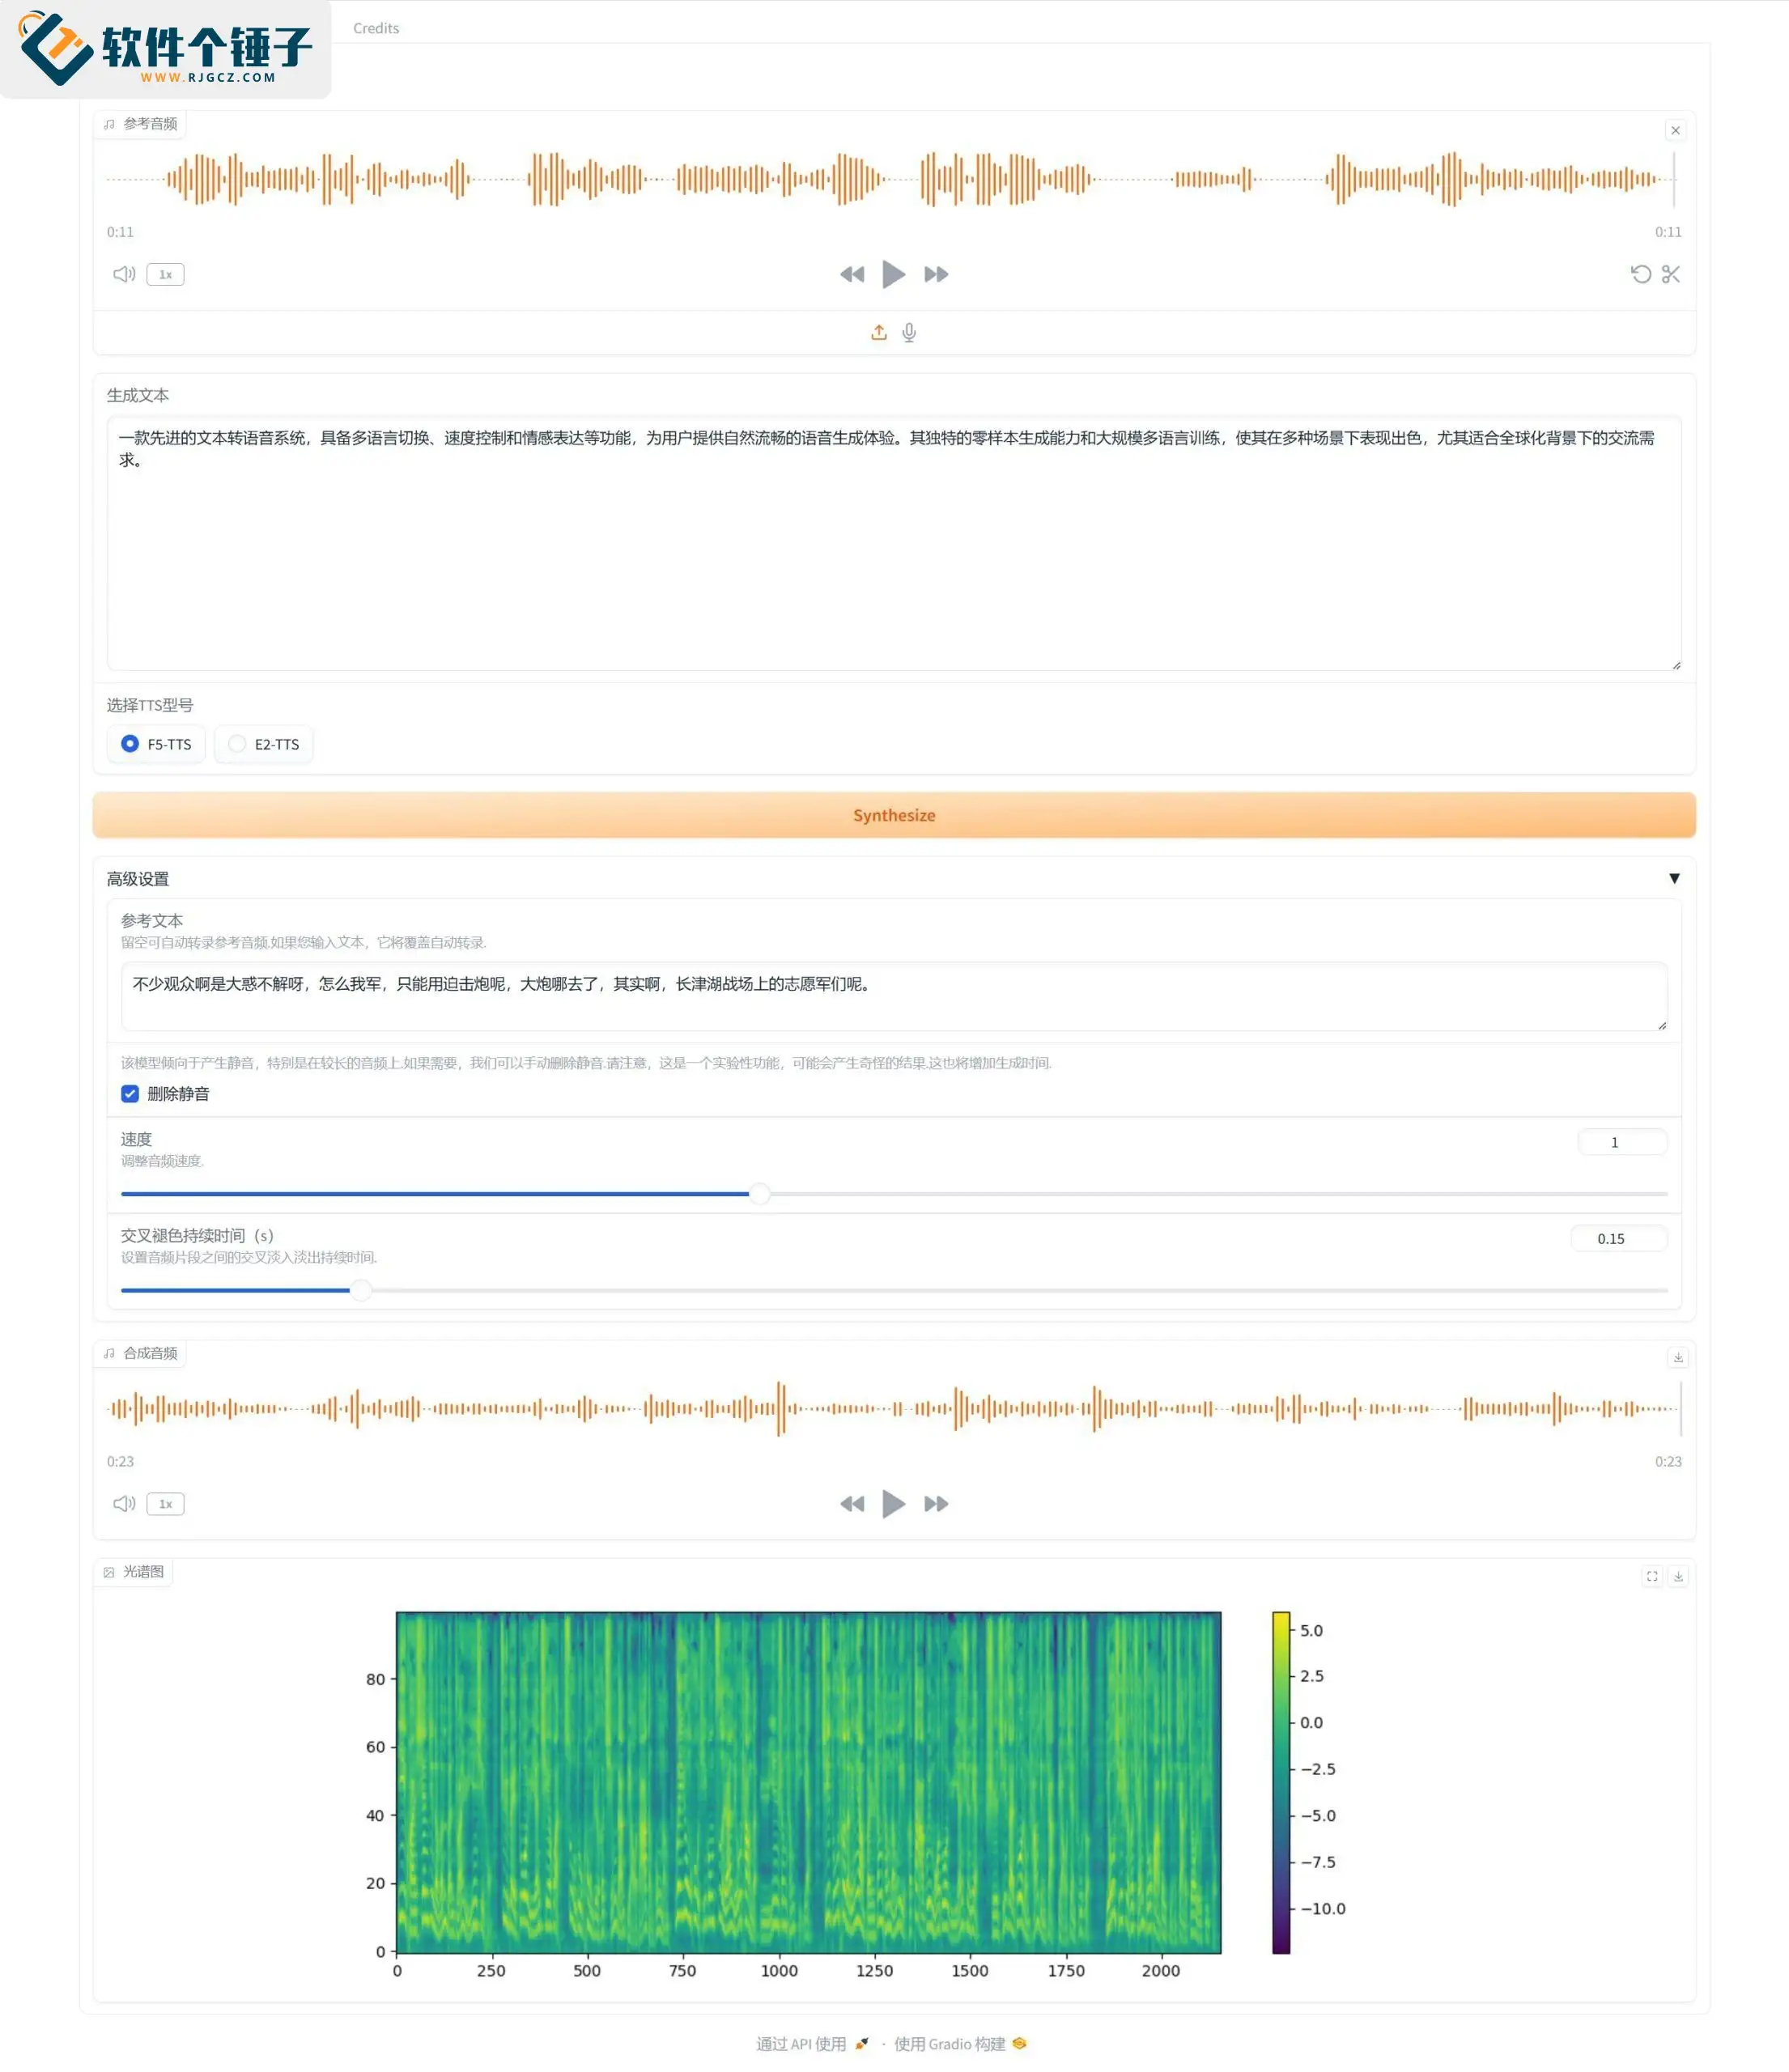
4. Sprachgenerierung für eine einzelne Rolle
– Audio hochladen
– Referenzaudiotext eingeben (d. h. den Dialoginhalt im Audio)
– "Stille entfernen" aktivieren
– Den zu erzeugenden Text eingeben, am Satzende einen Punkt setzen und auf Erzeugen klicken

Das erzeugte Ergebnis wird unten auf der Seite angezeigt und kann angehört und heruntergeladen werden.

[Originalaudio]
[Erzeugtes Ergebnis]
5. Dialogerzeugung für zwei Rollen
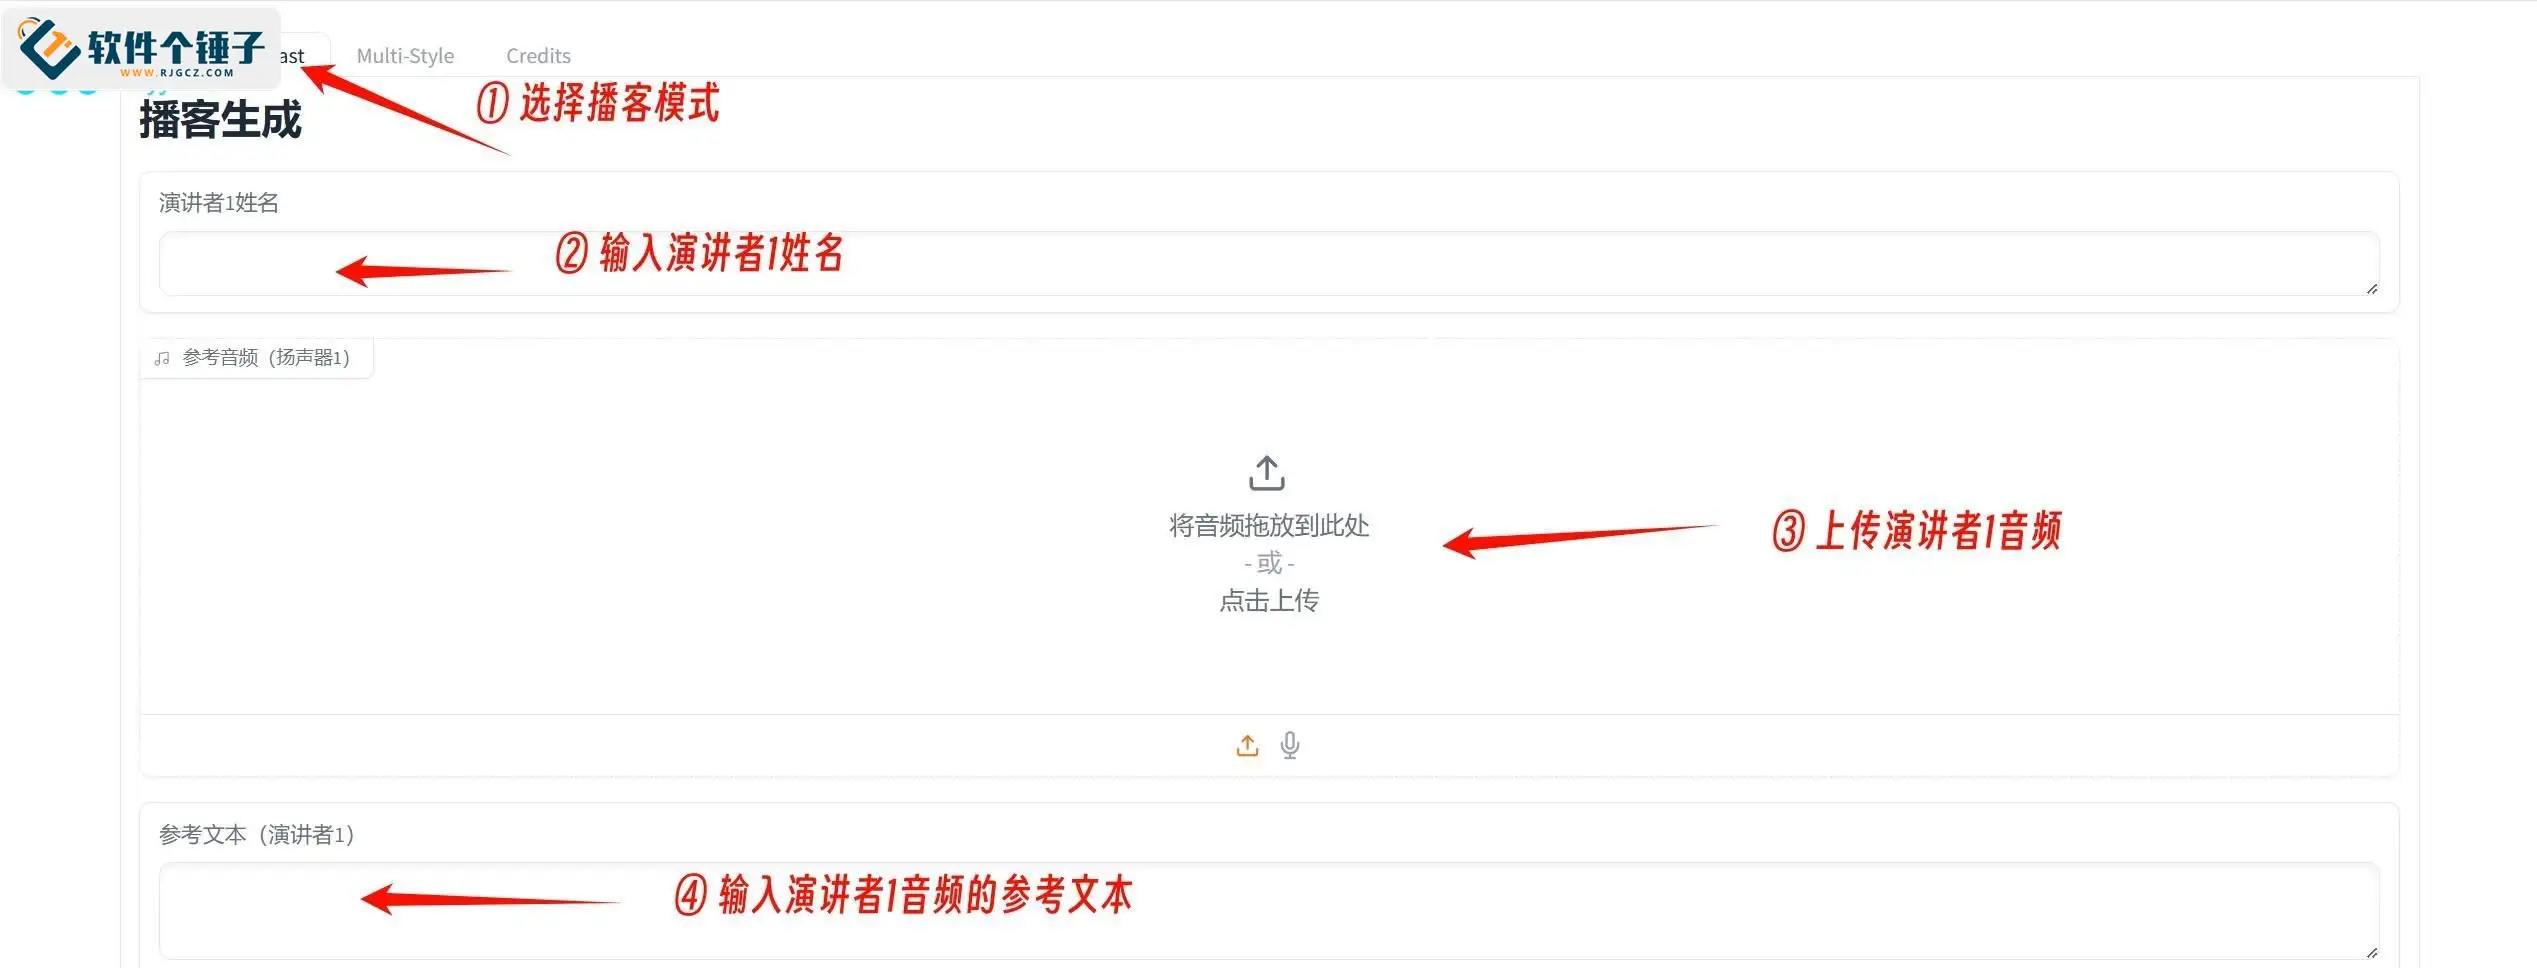
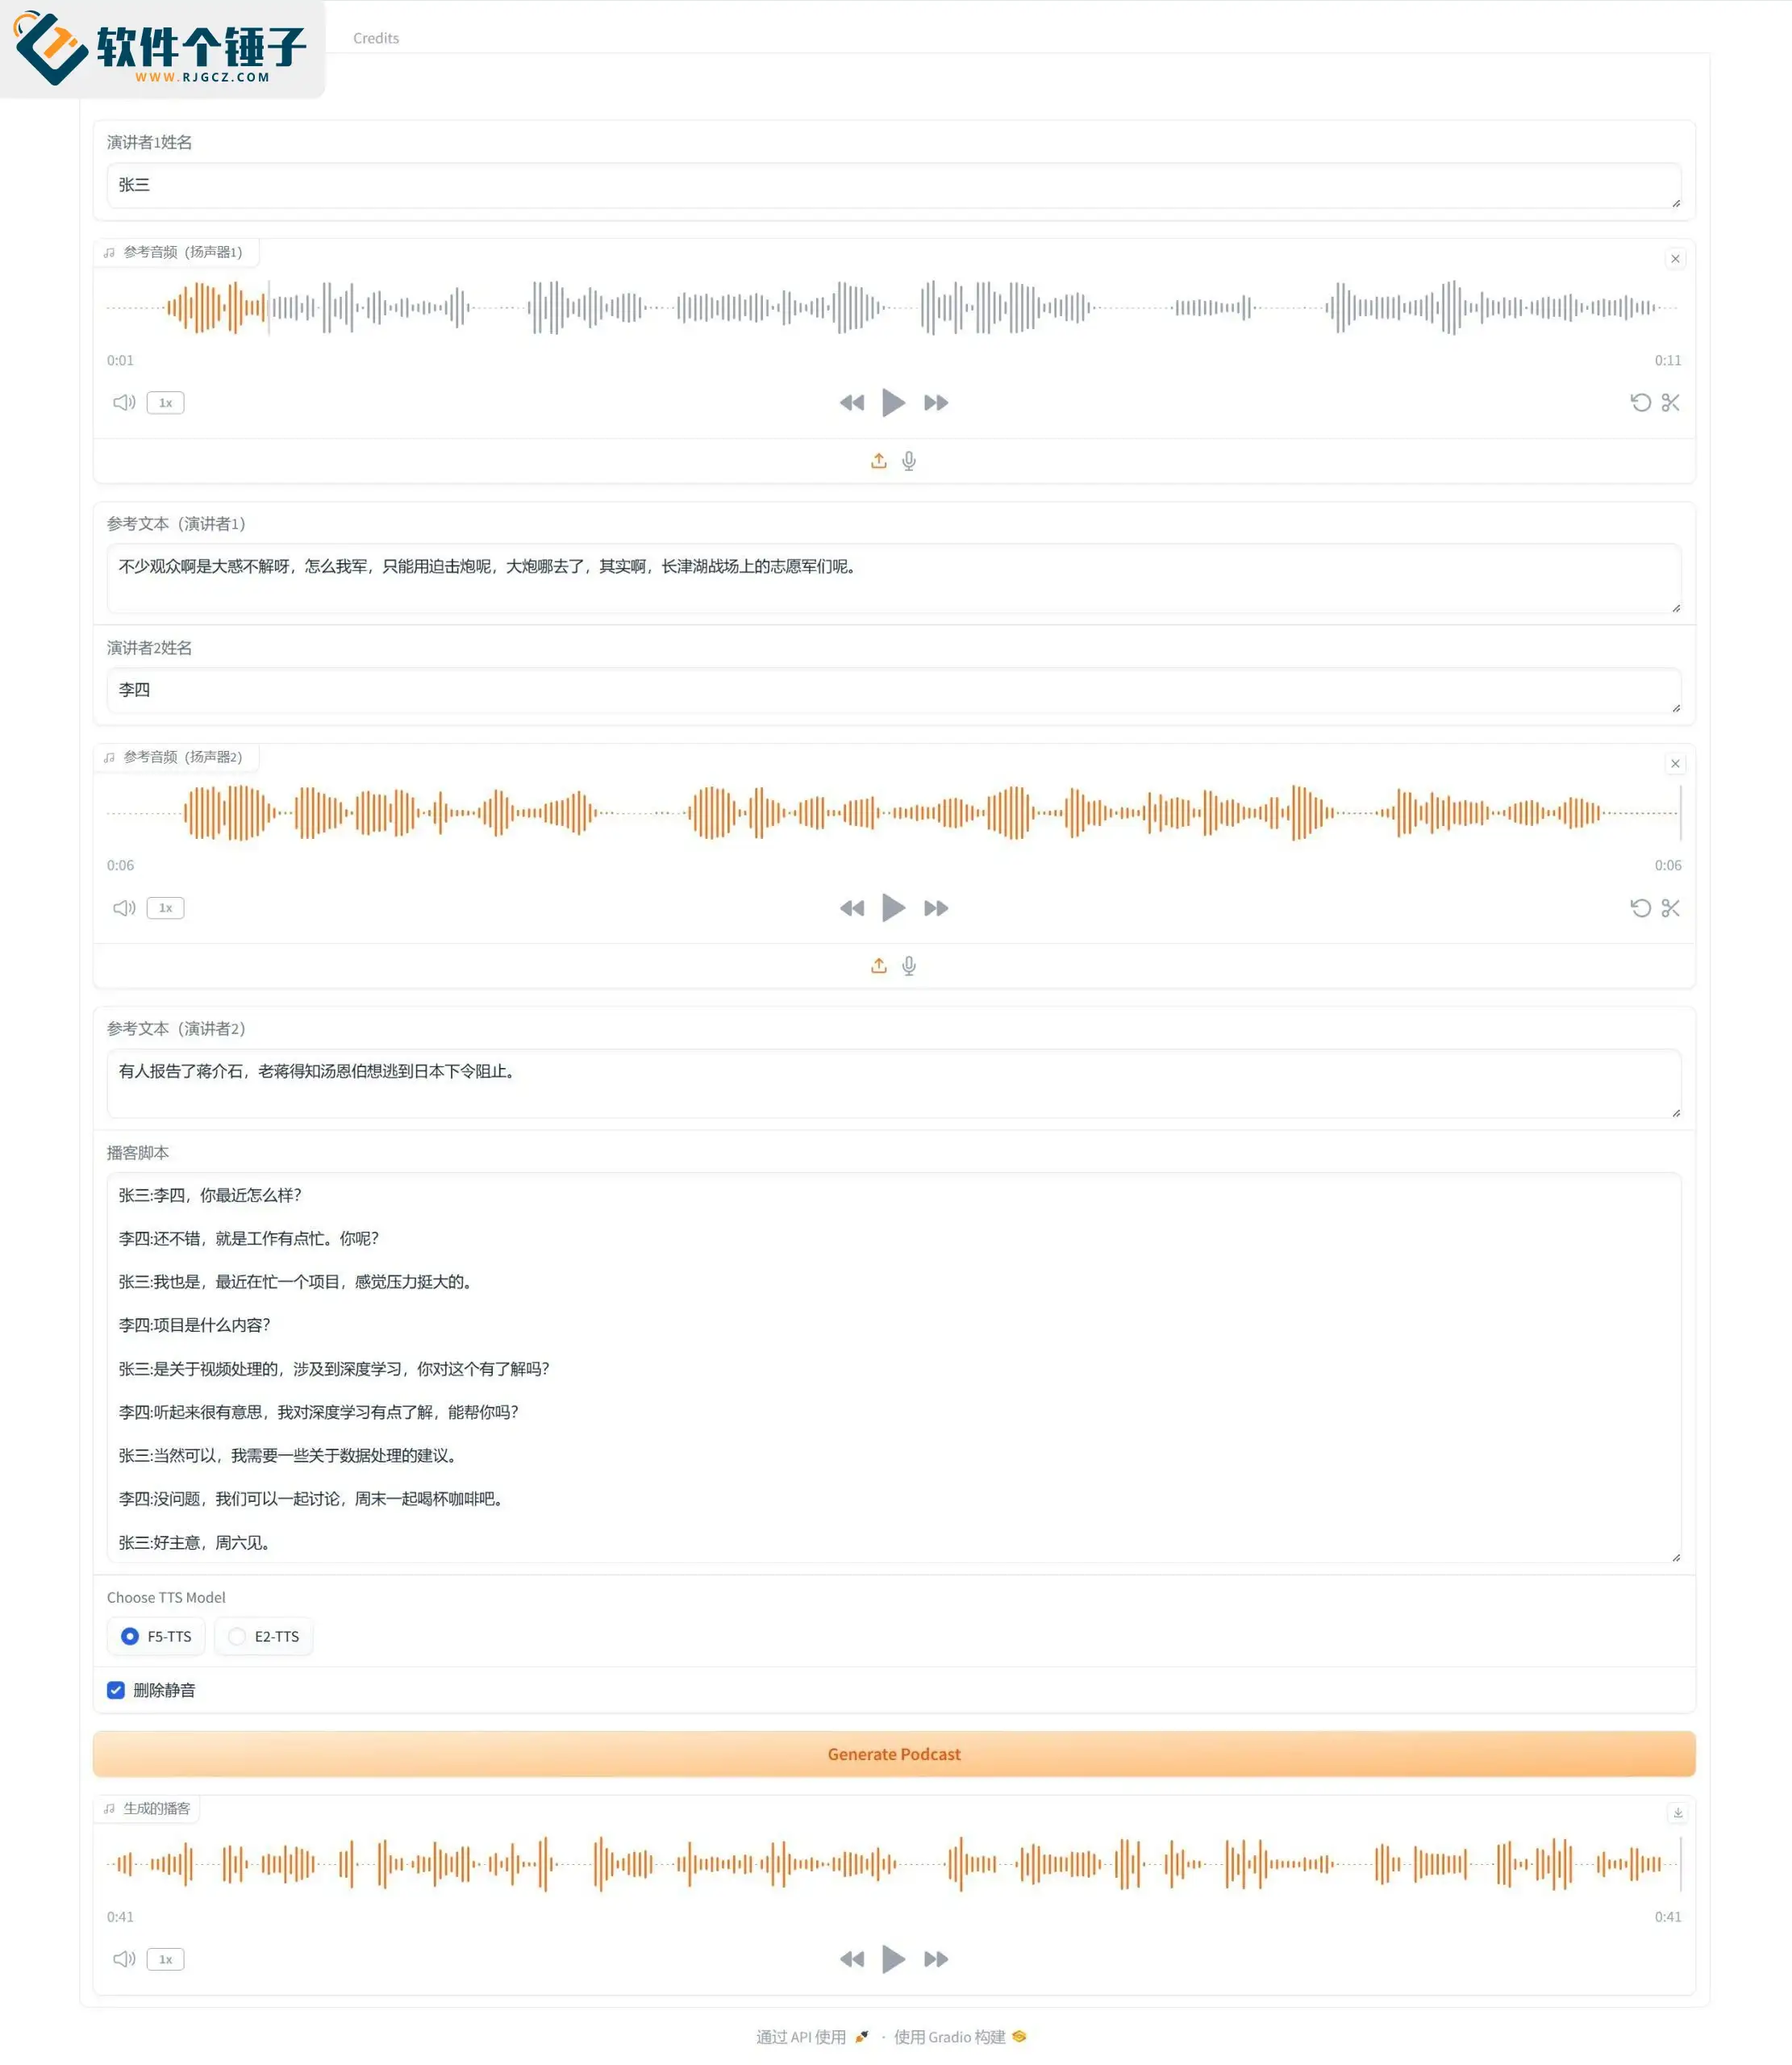
– Den Modus "Podcast" wählen, beide Rollen benennen, ihre jeweiligen Audios hochladen und den entsprechenden Referenztext eingeben
– Ein Dialogskript schreiben; auf das Format achten: Nach dem Rollennamen einen Doppelpunkt setzen und den Dialoginhalt schreiben, am Satzende ist ein Punkt erforderlich
– "Stille entfernen" aktivieren und auf Erzeugen klicken

Das erzeugte Ergebnis wird unten angezeigt und kann angehört oder heruntergeladen werden.

[Originalaudio-A]
[Originalaudio-B]
[Erzeugtes Ergebnis]
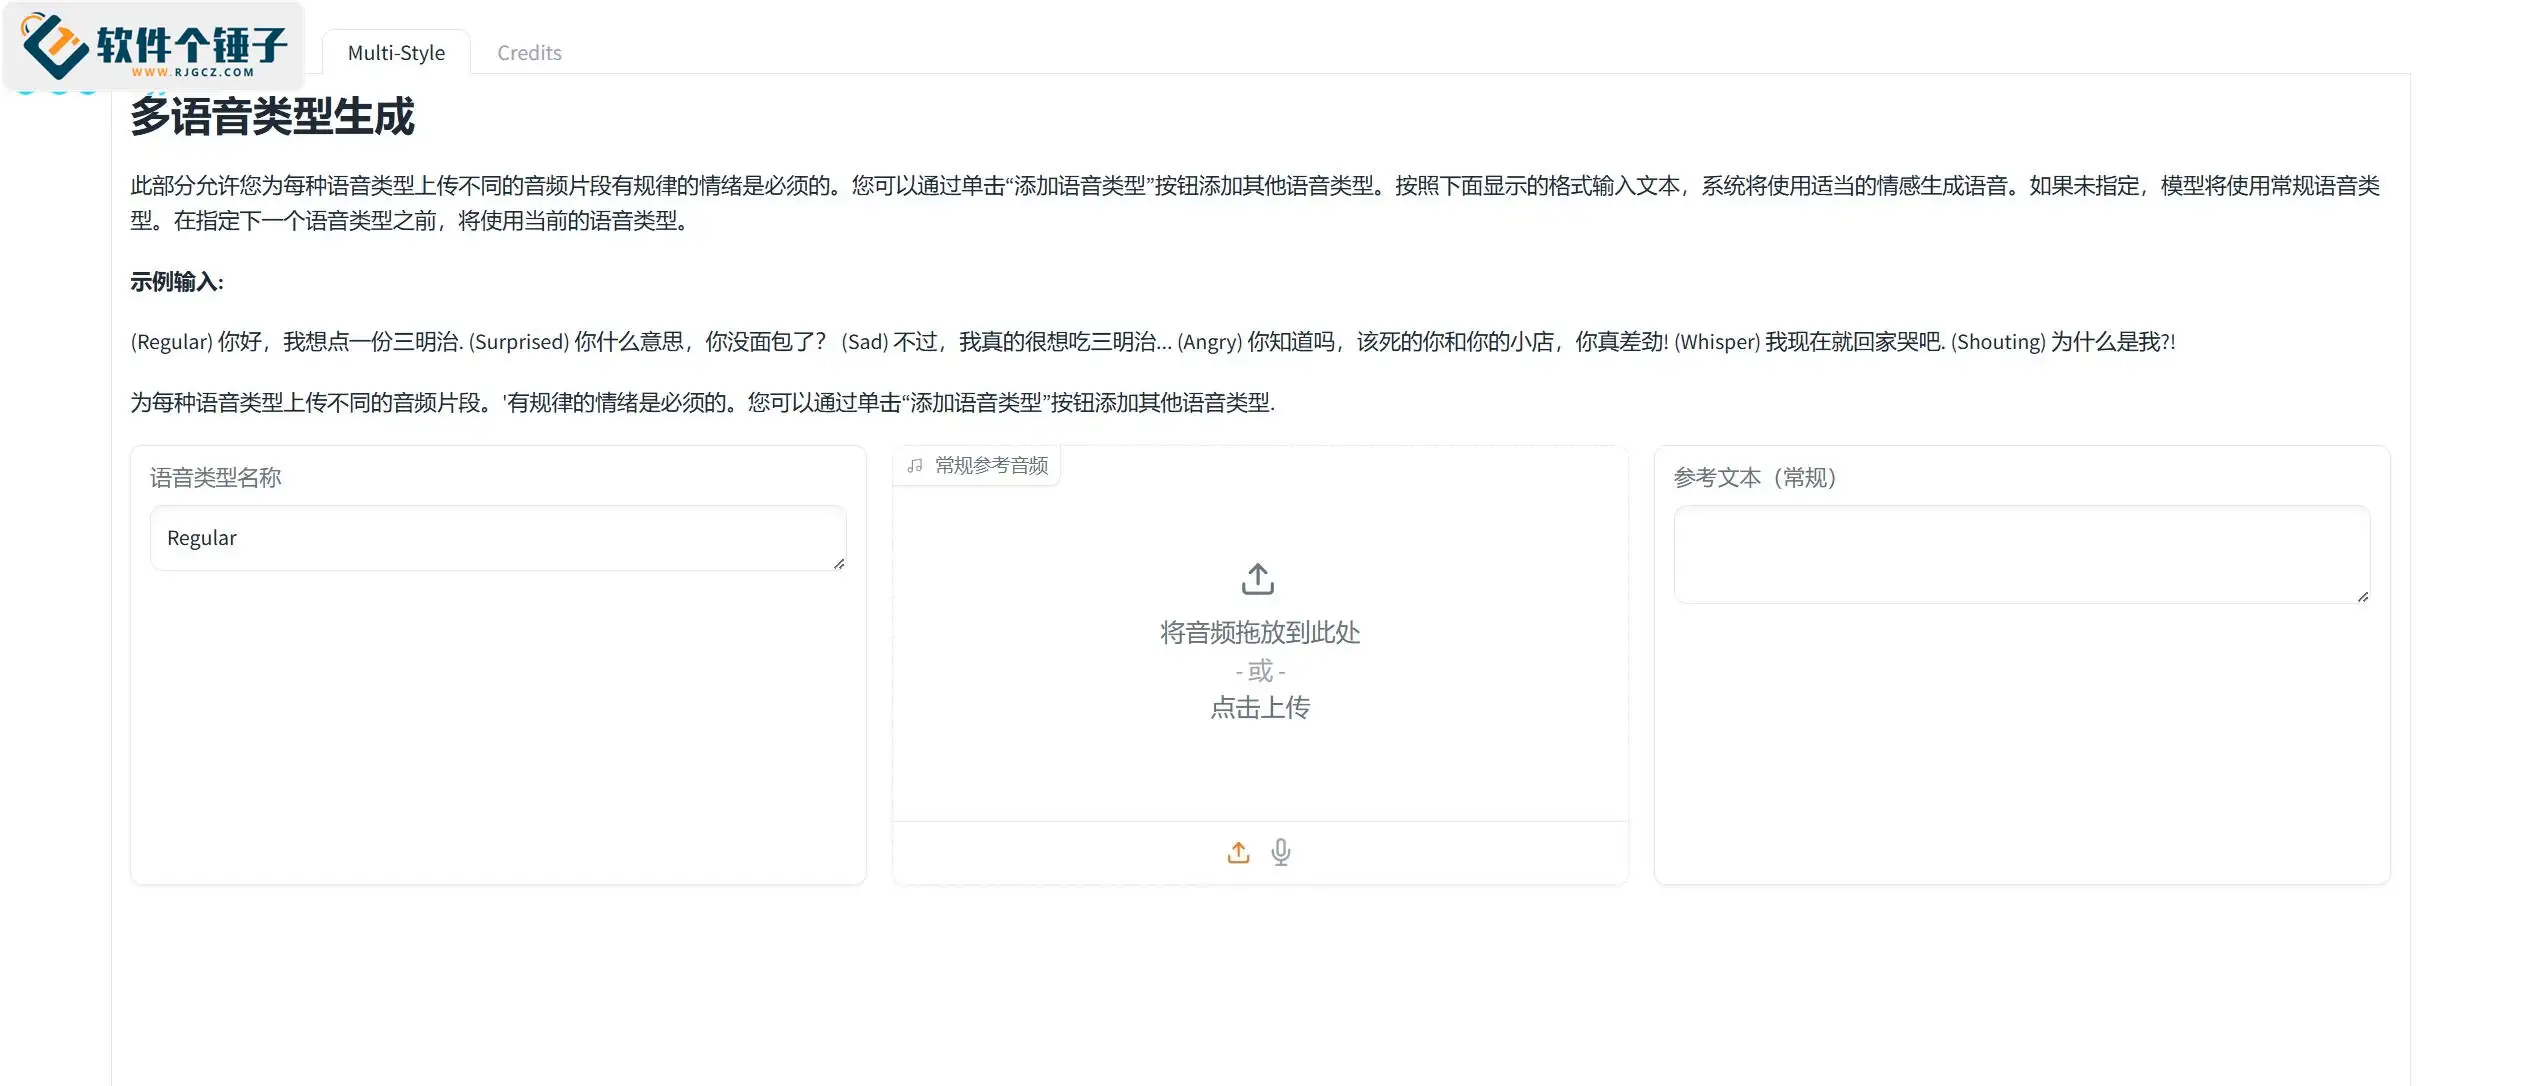
PS: Das Tool unterstützt auch die Emotionsgenerierung, doch in Tests war das Ergebnis eher durchschnittlich - bei Interesse können Sie es selbst ausprobieren!

Open-Source-Adresse:https://github.com/SWivid/F5-TTS
Ähnliche Kurse

Super lokale Toolbox! Integrierte Bildschirmaufnahme, Audio-/Video-Schnitt & -Zusammenführung, Video-Komprimierung & -Extraktion, für immer gratis – Kedou Video Converter

100%% perfektes Gratis-Tool! Alles-in-einem-Multifunktions-PDF-Software: PDF konvertieren, komprimieren, bearbeiten etc., minimalistisch, keine Werbung, so schön – JOPDF

Open-Source-Desktop-Fernzugriffstool, weit besser als kostenpflichtige Versionen! Kostenlos und unbegrenzt für Privat und Gewerbe nutzbar, plattformübergreifend, Desktop-Fernsteuerung – HopToDesk

Neuestes Tool zum Herunterladen von Lehrmaterialien für Grund- und Mittelschule: komplette Jahrgangsstufen, mit begleitenden Folien, Videos und Audios auf einen Klick

Den ganzen Tag auf den Bildschirm, ohne Augenschutz-Tool? Kostenlose Blaulicht-Schutz-App für PC, mit Haustier, das dich an Pausen erinnert, Huyanbao

PyIsland: Modernes System-Control-Center mit Desktop-Dynamic-Island für Windows

3D-Simulation-Manju-Produktion: Seedance 2.0 Komplettprozess-Praxis, von 0 bis zur hochwertigen Manju-Kreation

Für Win und Mac! Neueste lebenslange Version: Restaurierung alter Fotos, Bildklarheit und verlustfreie Vergrößerung - Aiarty Image Enhancer

Github Open-Source-Bilibili-Downloader: Stapel-Download von Bilibili-Videos mit 8K und Dolby Vision-Unterstützung – einfach zu bedienen, Bilidown

Windows-Desktop-Werkzeugsammlung: 50+ praktische, schlichte Desktop-Widgets, mit Screenshot, Screenrecording, Übersetzung, Wetter u.v.m. – Duomi-Toolbox

Contact Info
- E-Mail: massivesidehustles@outlook.com
