


-
คอร์สธุรกิจ
-
 อื่น ๆ
-
บทเรียนจากต่างประเทศ
-
การถ่ายภาพ & ตัดต่อ
-
การดูแลชุมชน & โดเมนส่วนตัว
-
การเขียนสื่อส่วนตัว & การเขียนโฆษณา
-
โปรเจกต์รายได้เสริม
-
อีคอมเมิร์ซ
-
วิดีโอสั้น & สตรีมสด
-
ปัญญาประดิษฐ์ (AI)
-
ซอฟต์แวร์และเครื่องมือ
-
ระบบปฏิบัติการ
-
ปลั๊กอินและสคริปต์
-
ซอฟต์แวร์ MacOS
-
ซอฟต์แวร์ Android
-
ซอฟต์แวร์ Windows


โคลนเสียง AI รองรับบทสนทนาหลายตัวละคร F5 TTS-V3 ฟรีโอเพนซอร์ส เปิดใช้งานคลิกเดียว ไม่ต้องติดตั้งหรือขออนุญาต [ซอฟต์แวร์ค้อน·R2264]
-
แผนหาเงินจากการฟาร์มเกม: รายได้ 1k+ ต่อวัน โปรเจกต์เก่าที่มั่นคงมา 3 ปี คนทั่วไปใช้เวลาว่างก็ทำได้!【เปิดเผย】
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
คอร์สระบบ SOP คอมิกดราม่า AI: การกรองและดัดแปลงนิยายเว็บ กฎบทละคร ข้อความต่อภาพ/ภาพต่อวิดีโองานจบ พากย์และตัดต่อ - สอนลงมือระบบครบวงจร (อัปเดต 0826)
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
การหารายได้เกมฮอตแบบอัตโนมัติเต็มรูปแบบ: 500+ ต่อวัน ไม่ต้องมีประสบการณ์ ดำเนินงานง่าย - อาชีพเสริมหารายได้จากเกมระยะยาวที่มั่นคงที่สุด (เปิดเผย)
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
คราวนี้หนูทำได้ดี! อย่าตื่นกลัวกับปัญหาฟอร์แมต Windows เครื่องมือแปลงฟอร์แมตโอเพนซอร์ส FlyingMouse มาช่วย เครื่องมือขุมทรัพย์ยอดนิยมบน GitHub
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
ค่ายฝึกขายของ Douyin พร้อมโค้ช: ไม่ต้องหน้ากล้อง มือใหม่ทำตามขั้นตอนก็ได้วิดีโอขายของ
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
แผนหาเงินเกมวางแรก: วันละ 1000+ คนทั่วไปใช้เวลาว่างทำได้! [เผย]
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก






-
คราวนี้หนูทำได้ดี! อย่าตื่นกลัวกับปัญหาฟอร์แมต Windows เครื่องมือแปลงฟอร์แมตโอเพนซอร์ส FlyingMouse มาช่วย เครื่องมือขุมทรัพย์ยอดนิยมบน GitHub
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
LuMaster v6.1024.4105.1121 เวอร์ชันย่อไฟล์เดียว[ซอฟต์แวร์ค้อน·R1880]
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
ซอฟต์แวร์สร้างแอนิเมชันการ์ตูน 2D Moho Pro v14.3
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
ซอฟต์แวร์ตัดต่อวิดีโอสำหรับคอมพิวเตอร์ Aiseesoft Filmai v1.0.18
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
Microsoft To Do v2.147 เวอร์ชันฟรีอย่างเป็นทางการ
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
PR/AE/DaVinci/FCPX ปลั๊กอินออสซิลโลสโคปปรับสีวิดีโอ Nobe OmniScope Win1.11.15 / Mac1.10.138【ซอฟต์แวร์ก้อกุยจื่อ·R2748】
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก





F5-TTS เป็นระบบแปลงข้อความเป็นเสียง (TTS) ที่ทรงพลัง ให้ประสบการณ์สร้างเสียงที่ราบรื่นเป็นธรรมชาติ รองรับการสลับภาษา การปรับความเร็วเสียง และการแสดงอารมณ์ พร้อมความสามารถพิเศษในการสร้างแบบ zero-shot และข้อได้เปรียบจากการฝึกด้วยข้อมูลเสียงขนาดใหญ่ ฟีเจอร์บทสนทนาสองคนที่เพิ่มเข้ามาใหม่ช่วยขยายขอบเขตการใช้งานให้กว้างขึ้น เหมาะเป็นเครื่องมือในอุดมคติสำหรับการสื่อสารและงานสร้างสรรค์ในระดับโลก

คุณสมบัติของซอฟต์แวร์
1. การสลับภาษา
รองรับการสลับระหว่างหลายภาษาอย่างไร้รอยต่อ รับมือความต้องการป้อนข้อมูลภาษาที่ซับซ้อนได้อย่างง่ายดาย
2. ความสามารถสร้างแบบ zero-shot
สร้างเสียงคุณภาพสูงได้โดยไม่ต้องมีตัวอย่างฝึกเฉพาะ ปรับตัวเข้ากับภาษาใหม่หรือสไตล์เสียงที่ไม่เคยเห็นได้
3. การปรับความเร็วเสียง
มีฟีเจอร์ควบคุมความเร็วเสียง ผู้ใช้ปรับจังหวะเสียงได้ตามต้องการ ให้เหมาะกับหลากหลายสถานการณ์
4. ฟีเจอร์บทสนทนาสองคน
อนุญาตให้ตั้งค่าสองตัวละครเพื่อสนทนากัน สะดวกต่อการสร้างเนื้อหาประเภทบทสนทนา
สถานการณ์ที่เหมาะสม
F5-TTS ใช้ได้อย่างกว้างขวางในด้านผู้ช่วยอัจฉริยะ การเรียนออนไลน์ และการสร้างเนื้อหา ฯลฯ ไม่ว่าจะเป็นเสียงที่ราบรื่นเป็นธรรมชาติหรือการแสดงอารมณ์ที่หลากหลาย เครื่องมือนี้ตอบโจทย์ได้ทั้งหมด เหมาะสำหรับผู้ใช้ที่ต้องการสร้างเสียงคุณภาพสูงพร้อมการรองรับหลายภาษา
ข้อกำหนดของระบบ
– ระบบปฏิบัติการ: Windows 10/11 64 บิต
– การ์ดจอ: แนะนำให้ใช้การ์ดจอ NVIDIA ที่มีหน่วยความจำ 8GB ขึ้นไป รองรับ CUDA >= 11.8
– พื้นที่ฮาร์ดดิสก์: หลังแตกไฟล์ต้องใช้พื้นที่ประมาณ 10.1GB โปรดตรวจสอบว่าฮาร์ดดิสก์มีพื้นที่เพียงพอ
– วิธีดูยี่ห้อการ์ดจอและขนาดหน่วยความจำ:
1. เปิด Task Manager
2. คลิกแท็บ "ประสิทธิภาพ" (Performance)
3. เลือก "GPU" มุมขวาบนสามารถดูรุ่นการ์ดจอ ด้านล่างแสดงขนาดหน่วยความจำ

คู่มือติดตั้ง CUDA:คลิกเพื่อดูคู่มือ
บทเรียนการใช้งาน
1. แตกไฟล์แพ็กเกจรวม
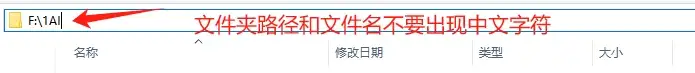
ตรวจสอบให้แน่ใจว่าพาธแตกไฟล์และชื่อไฟล์ไม่มีอักขระภาษาจีน เพื่อหลีกเลี่ยงข้อผิดพลาดในการทำงานของซอฟต์แวร์

2. การเตรียมไฟล์เสียง
แนะนำให้ควบคุมความยาวไฟล์ไว้ภายใน 15 วินาที เสียงเป็นเสียงดิบ (ไม่มีเสียงพื้นหลัง ไม่มีเสียงรบกวน) หากมีเสียงพื้นหลังสามารถใช้ [UVR]จัดการได้
3. เปิดหน้าจอการใช้งาน
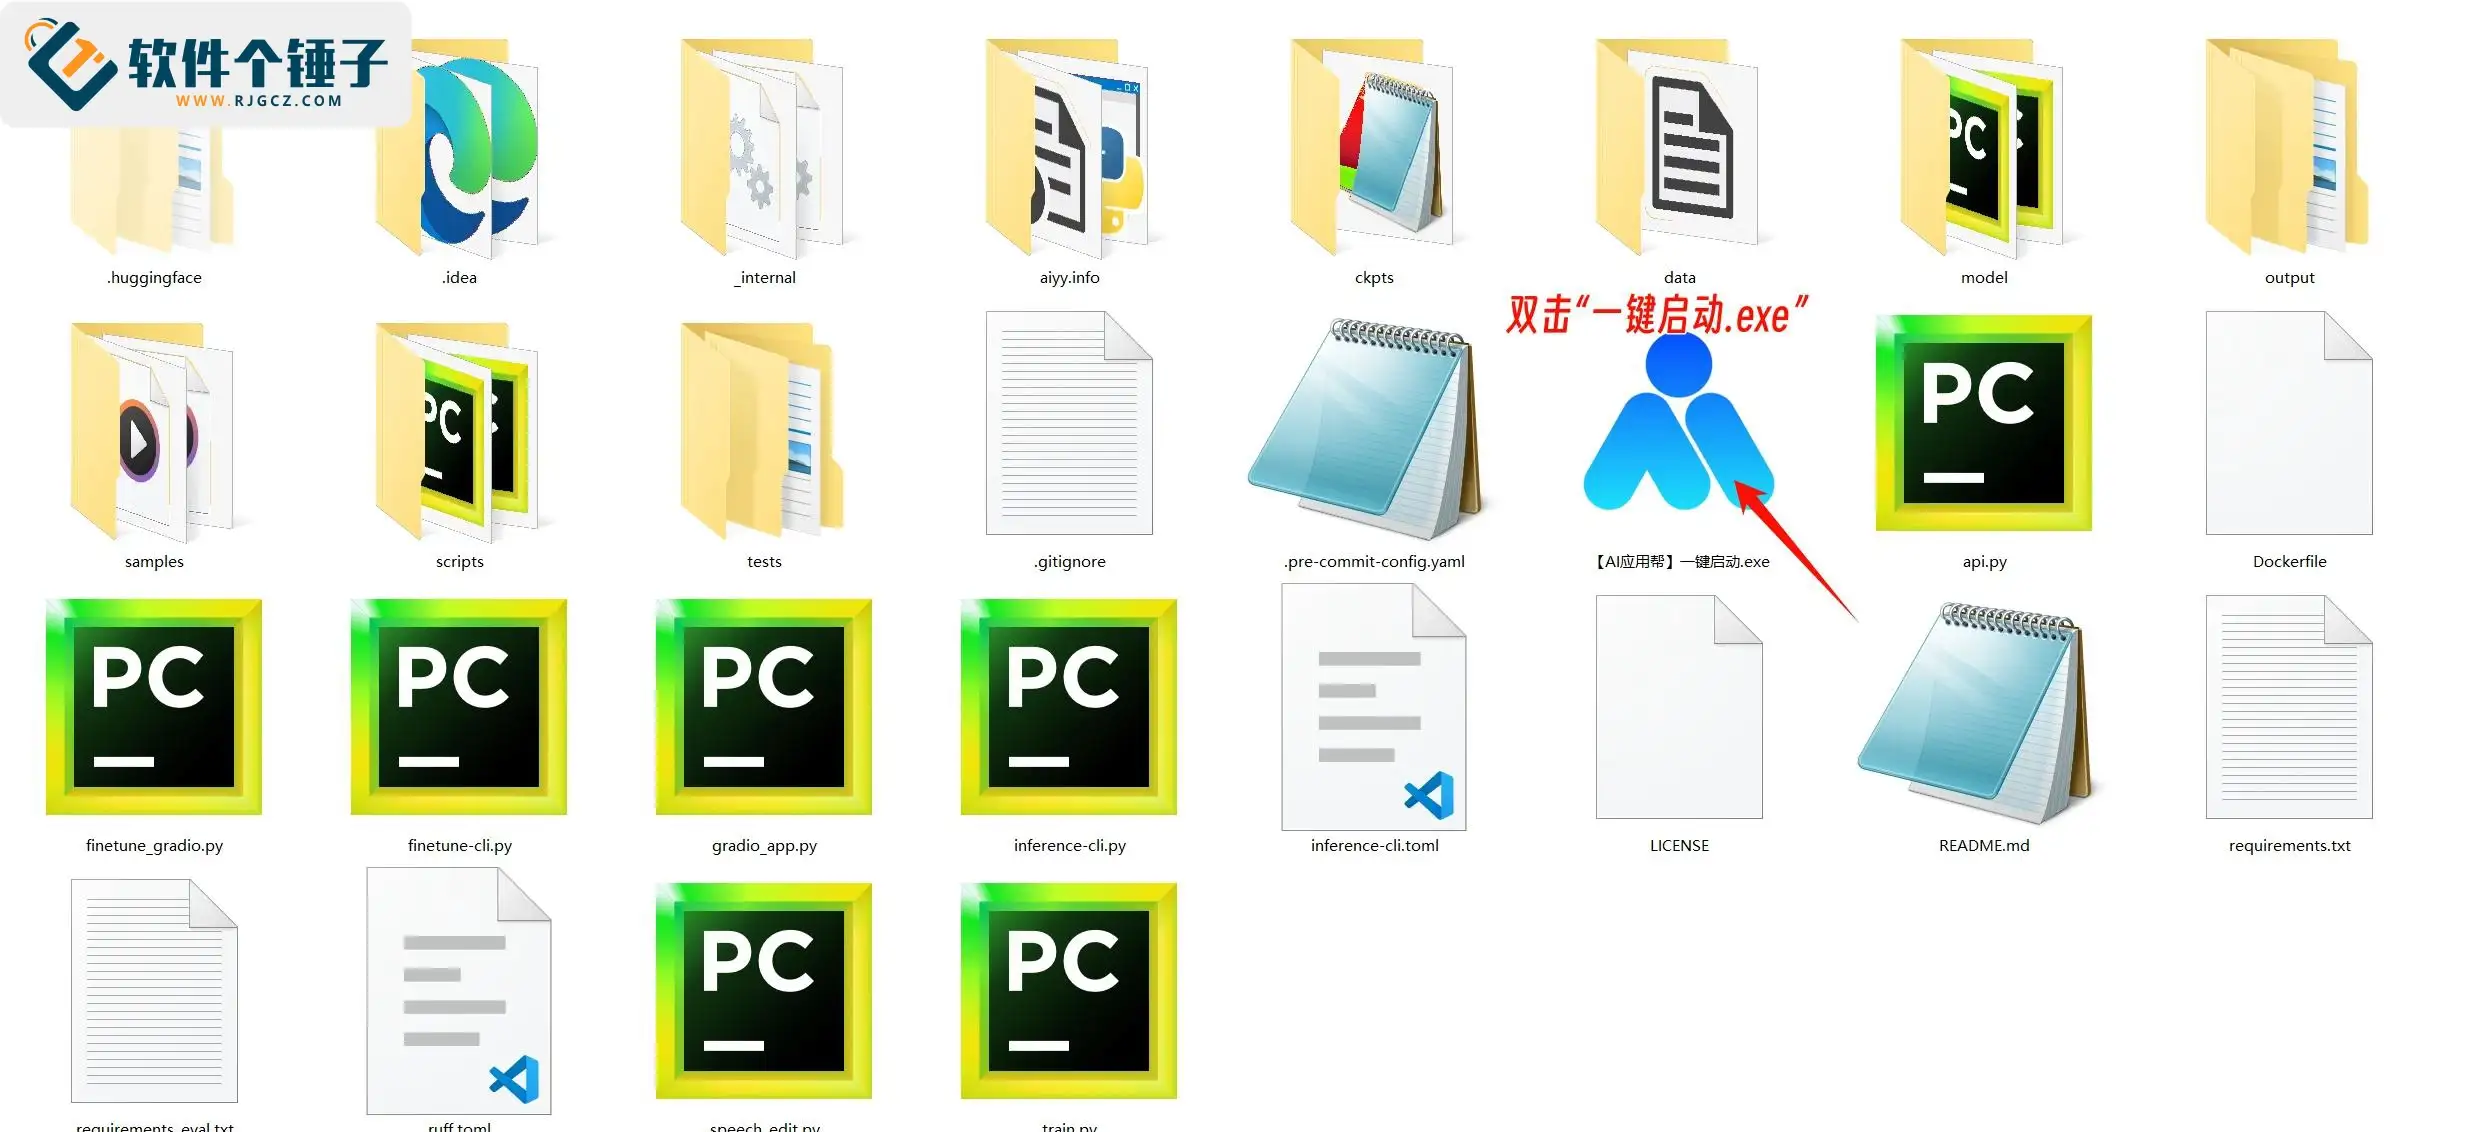
ดับเบิลคลิกไฟล์เปิดใช้งานแบบคลิกเดียว (.exe) รอสักครู่ก็จะเปิดหน้าจอการใช้งานในเบราว์เซอร์

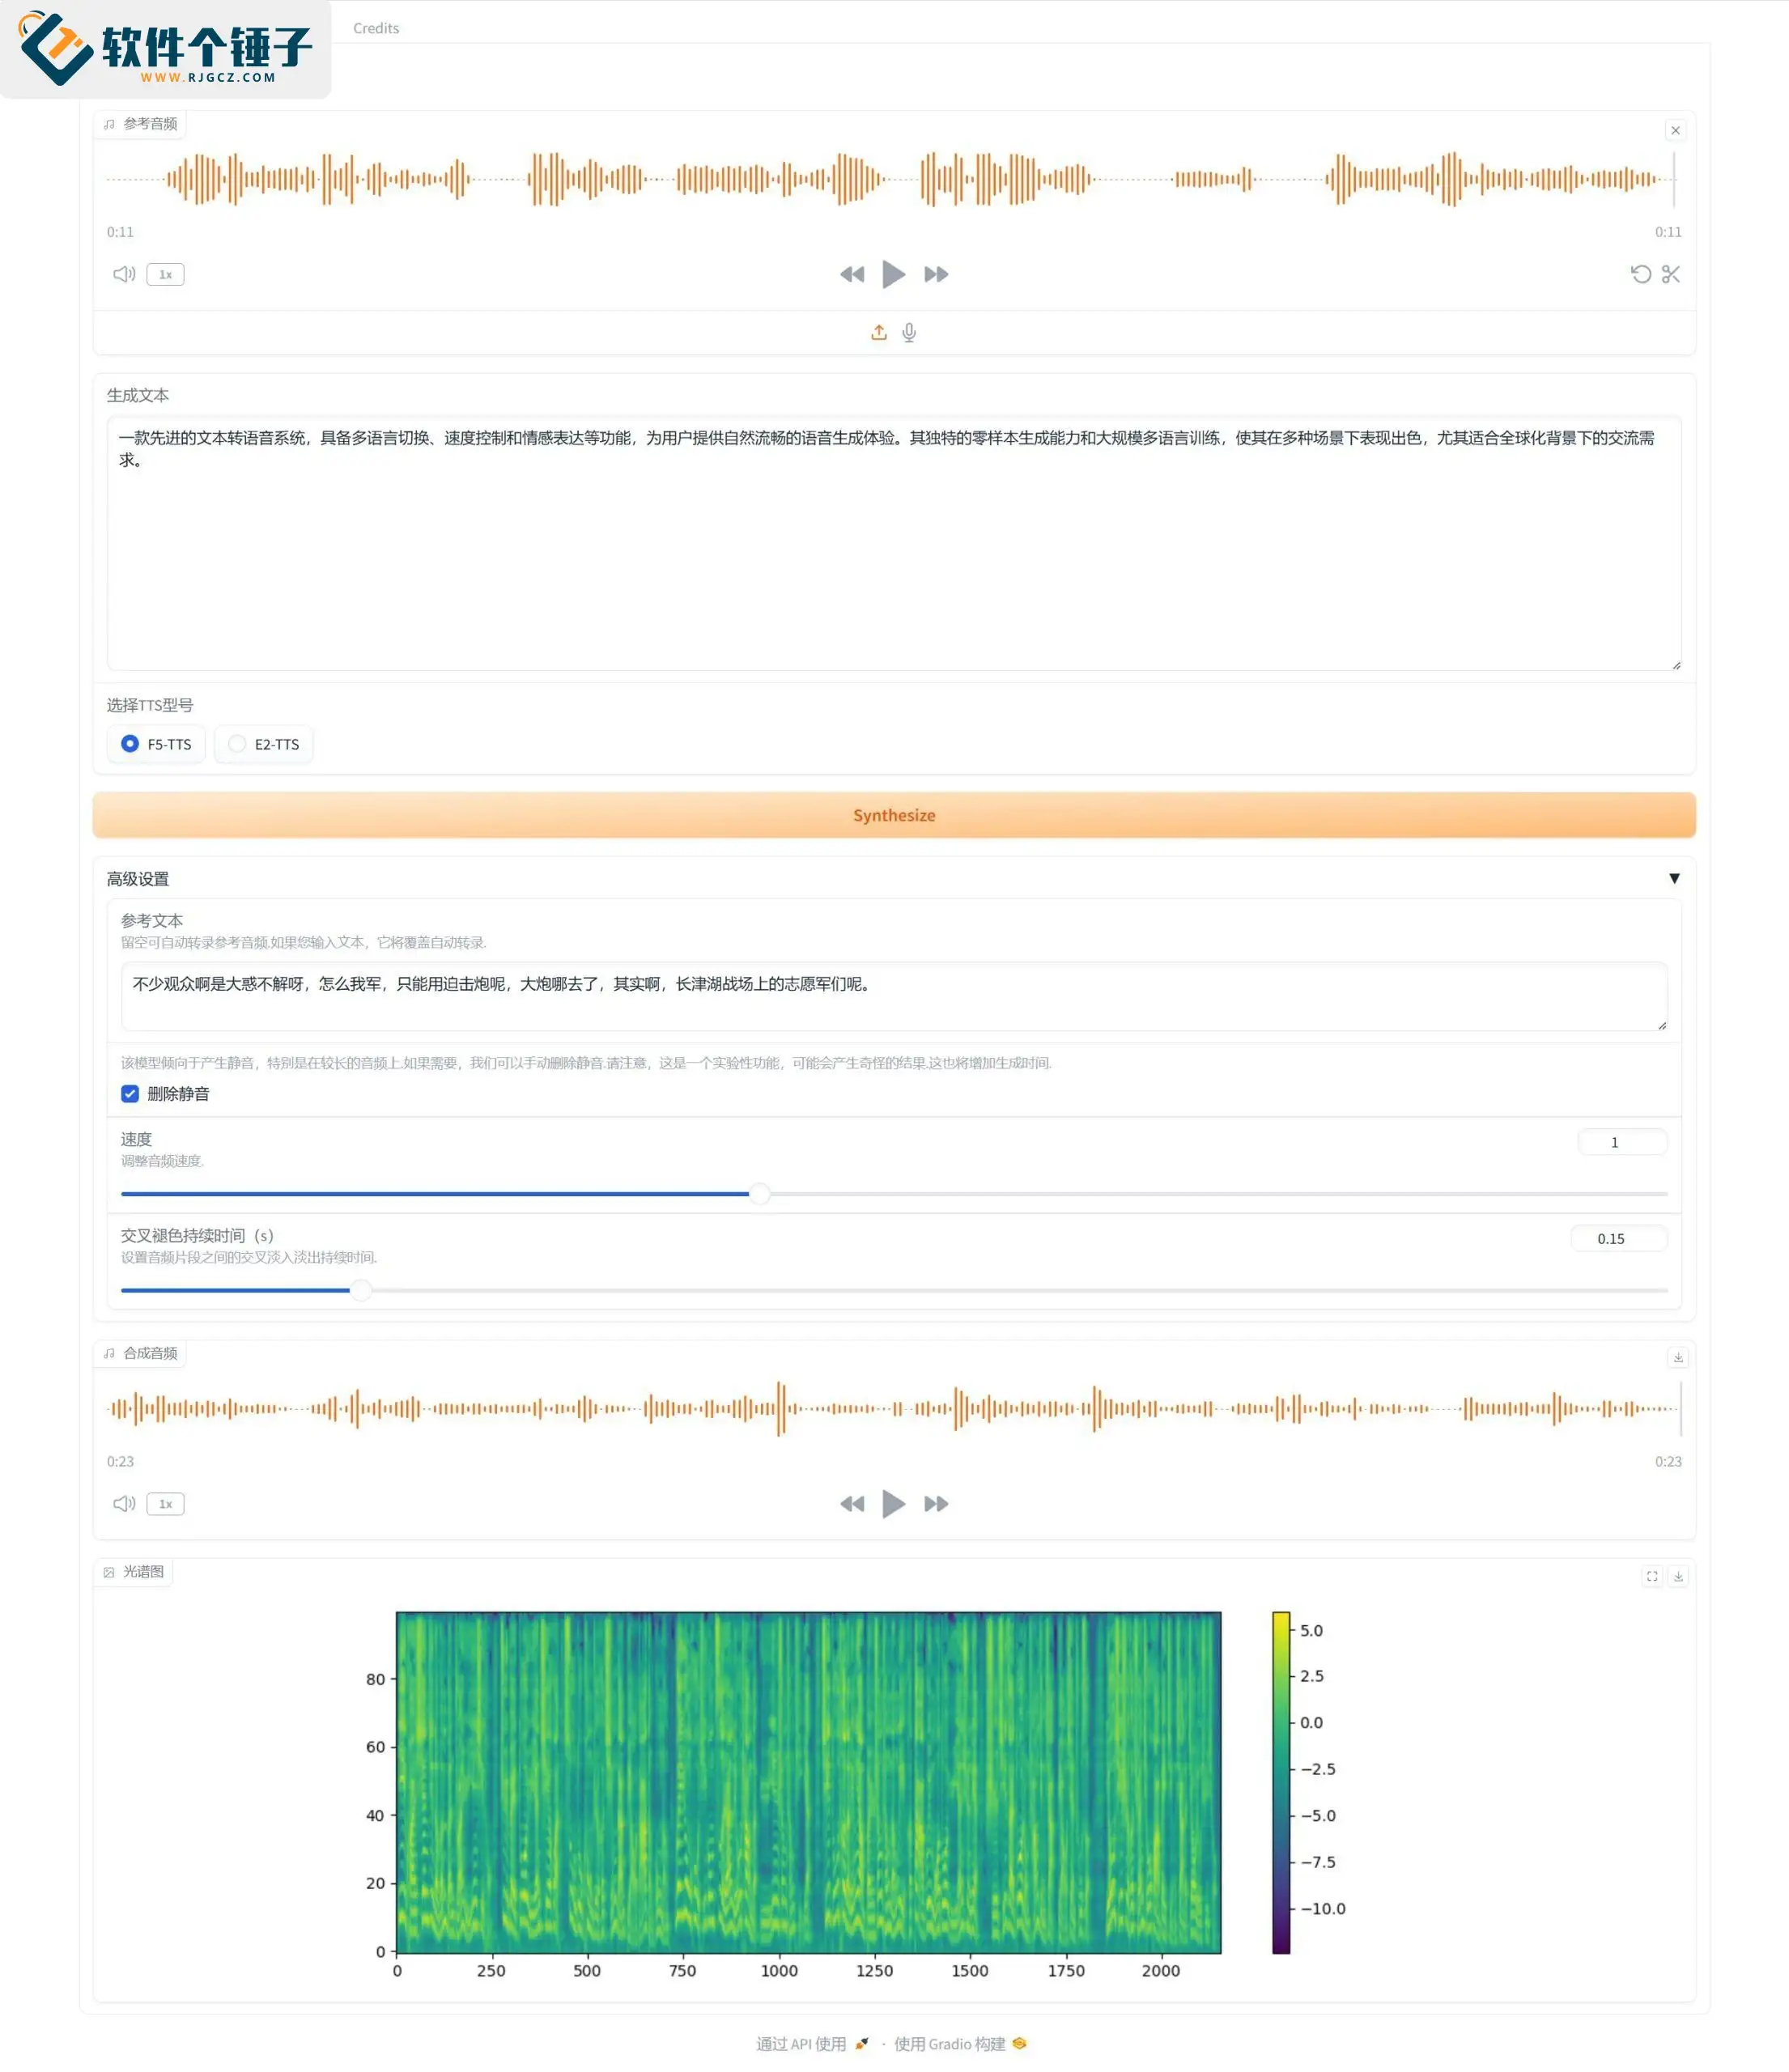
4. การสร้างเสียงแบบตัวละครเดียว
– อัปโหลดไฟล์เสียง
– ป้อนข้อความเสียงอ้างอิง (คือเนื้อหาบทสนทนาในไฟล์เสียง)
– ติ๊กเลือก "ลบความเงียบ"
– ป้อนข้อความที่ต้องการสร้าง ใส่จุดที่ท้ายประโยค แล้วคลิกสร้าง

ผลลัพธ์ที่สร้างจะแสดงด้านล่างของหน้า รองรับการฟังตัวอย่างและดาวน์โหลด

[เสียงต้นฉบับ]
[ผลลัพธ์ที่สร้าง]
5. การสร้างบทสนทนาสองตัวละคร
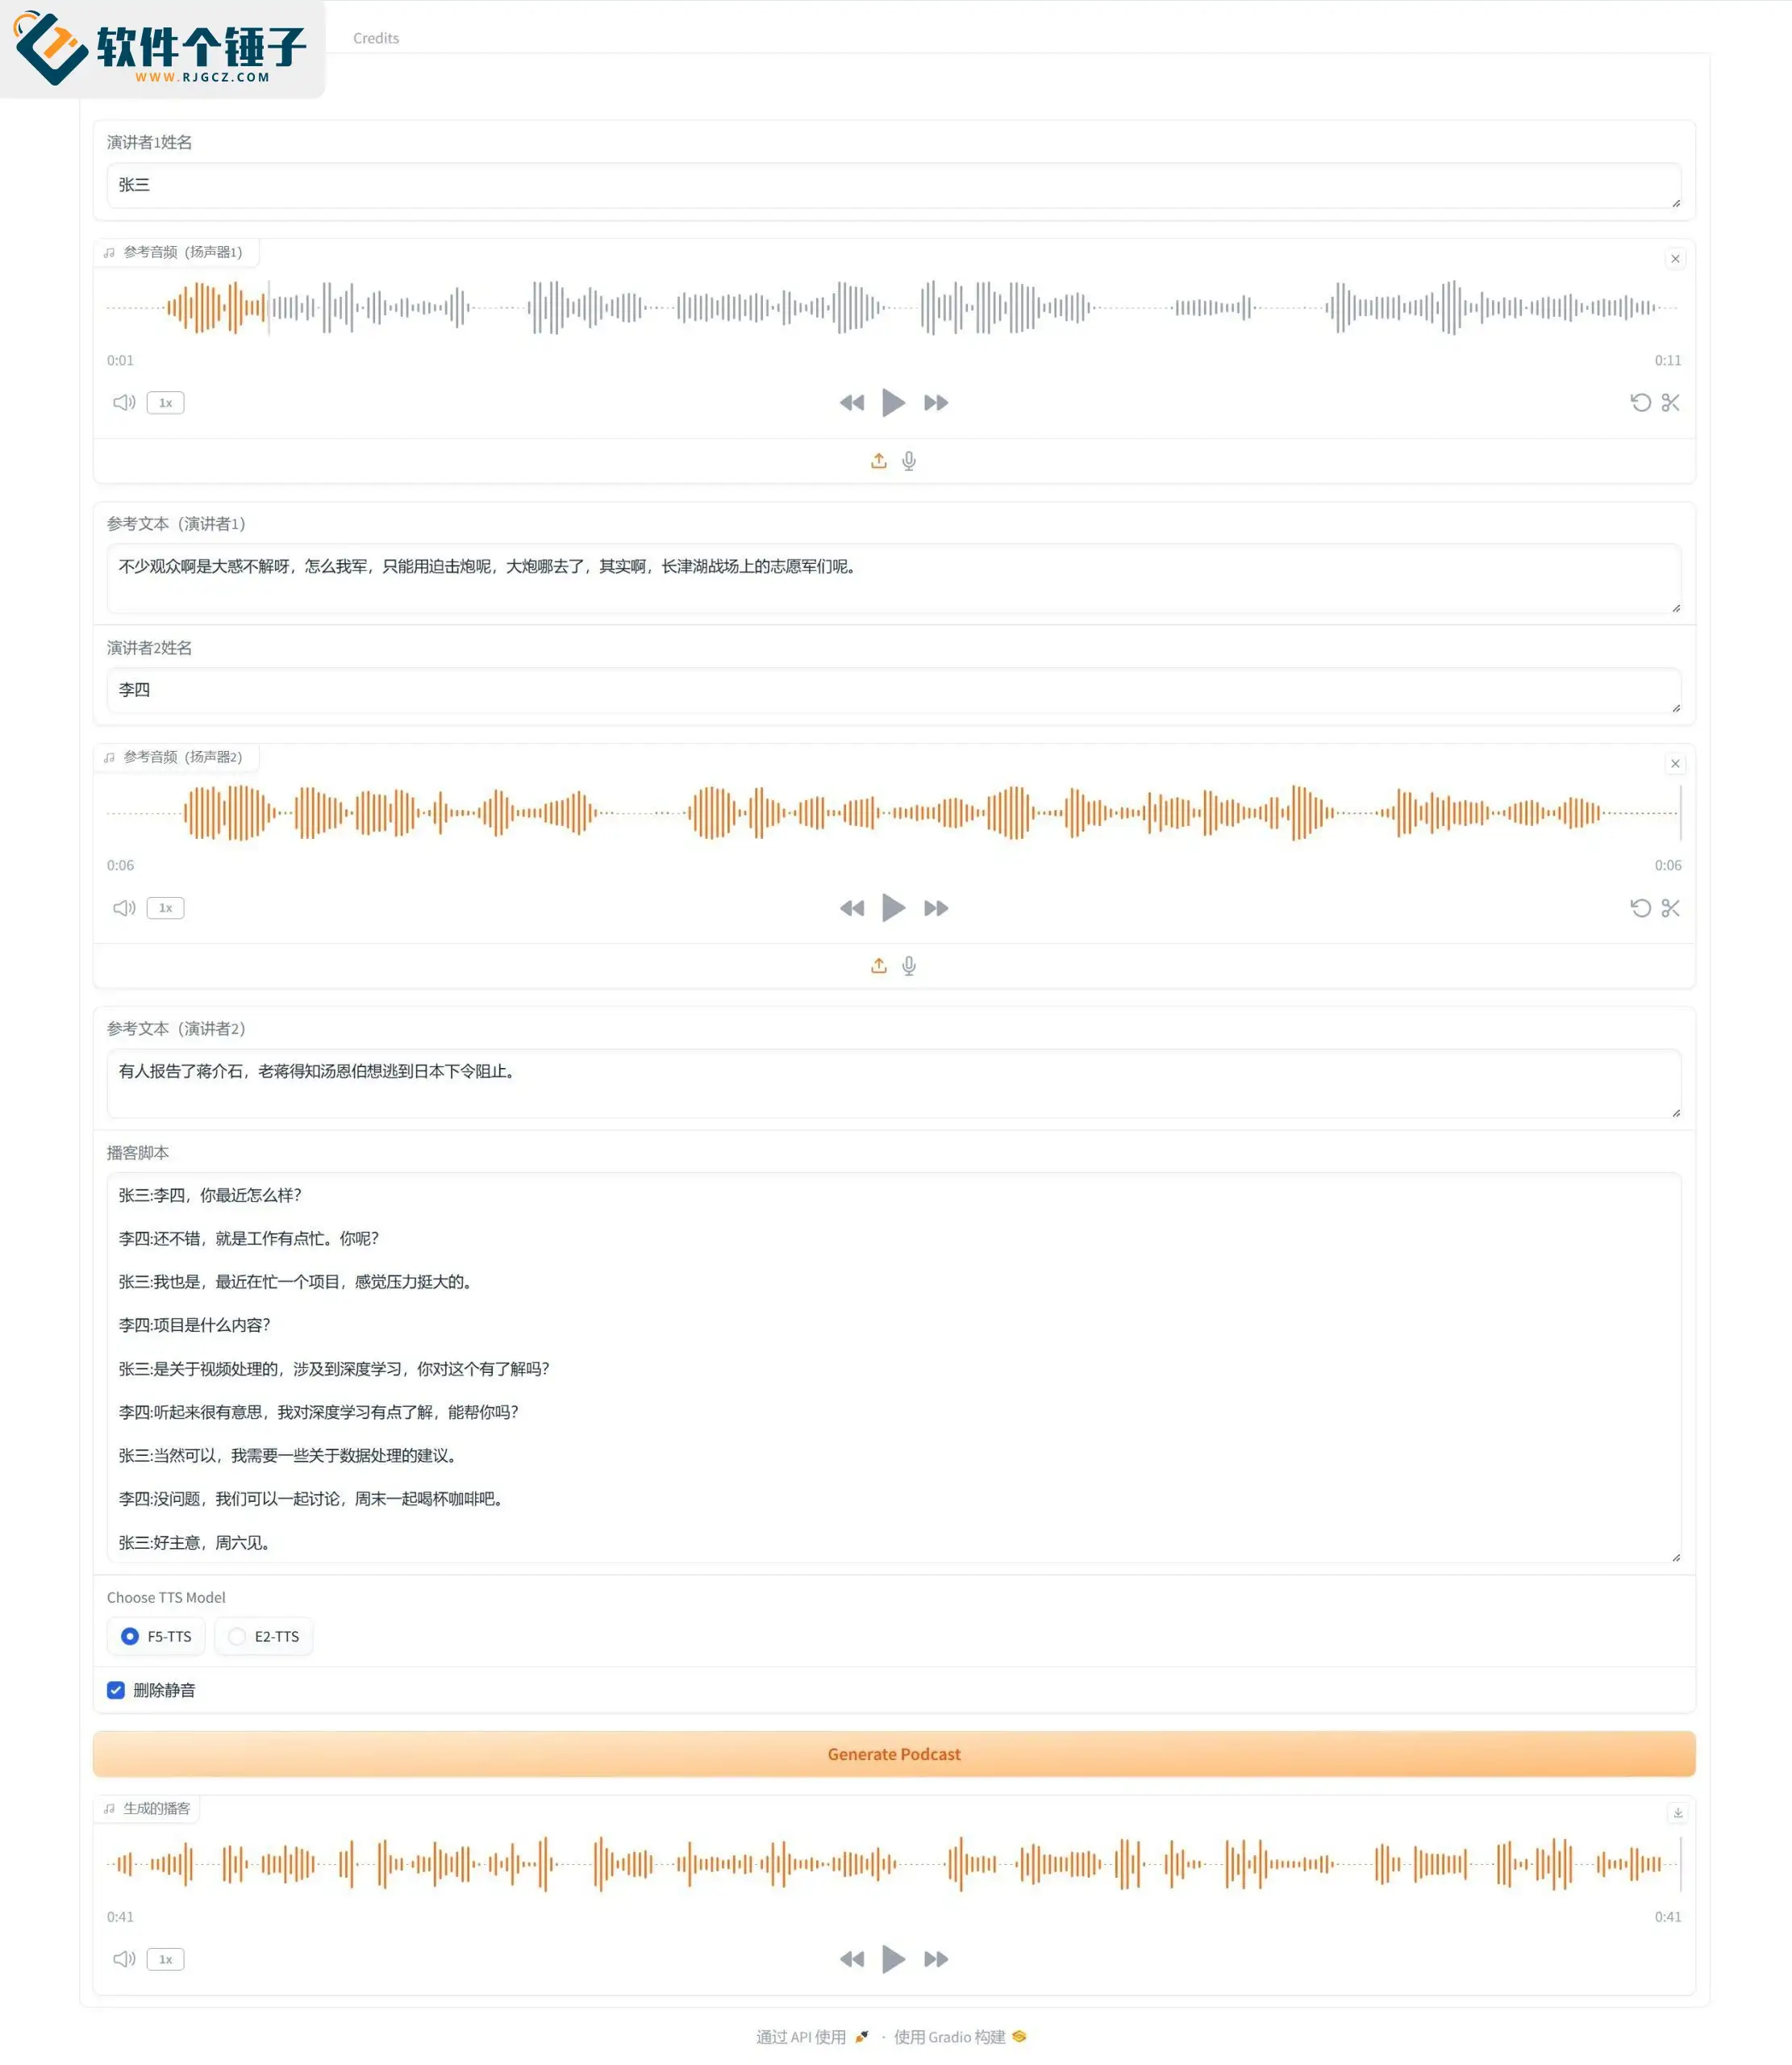
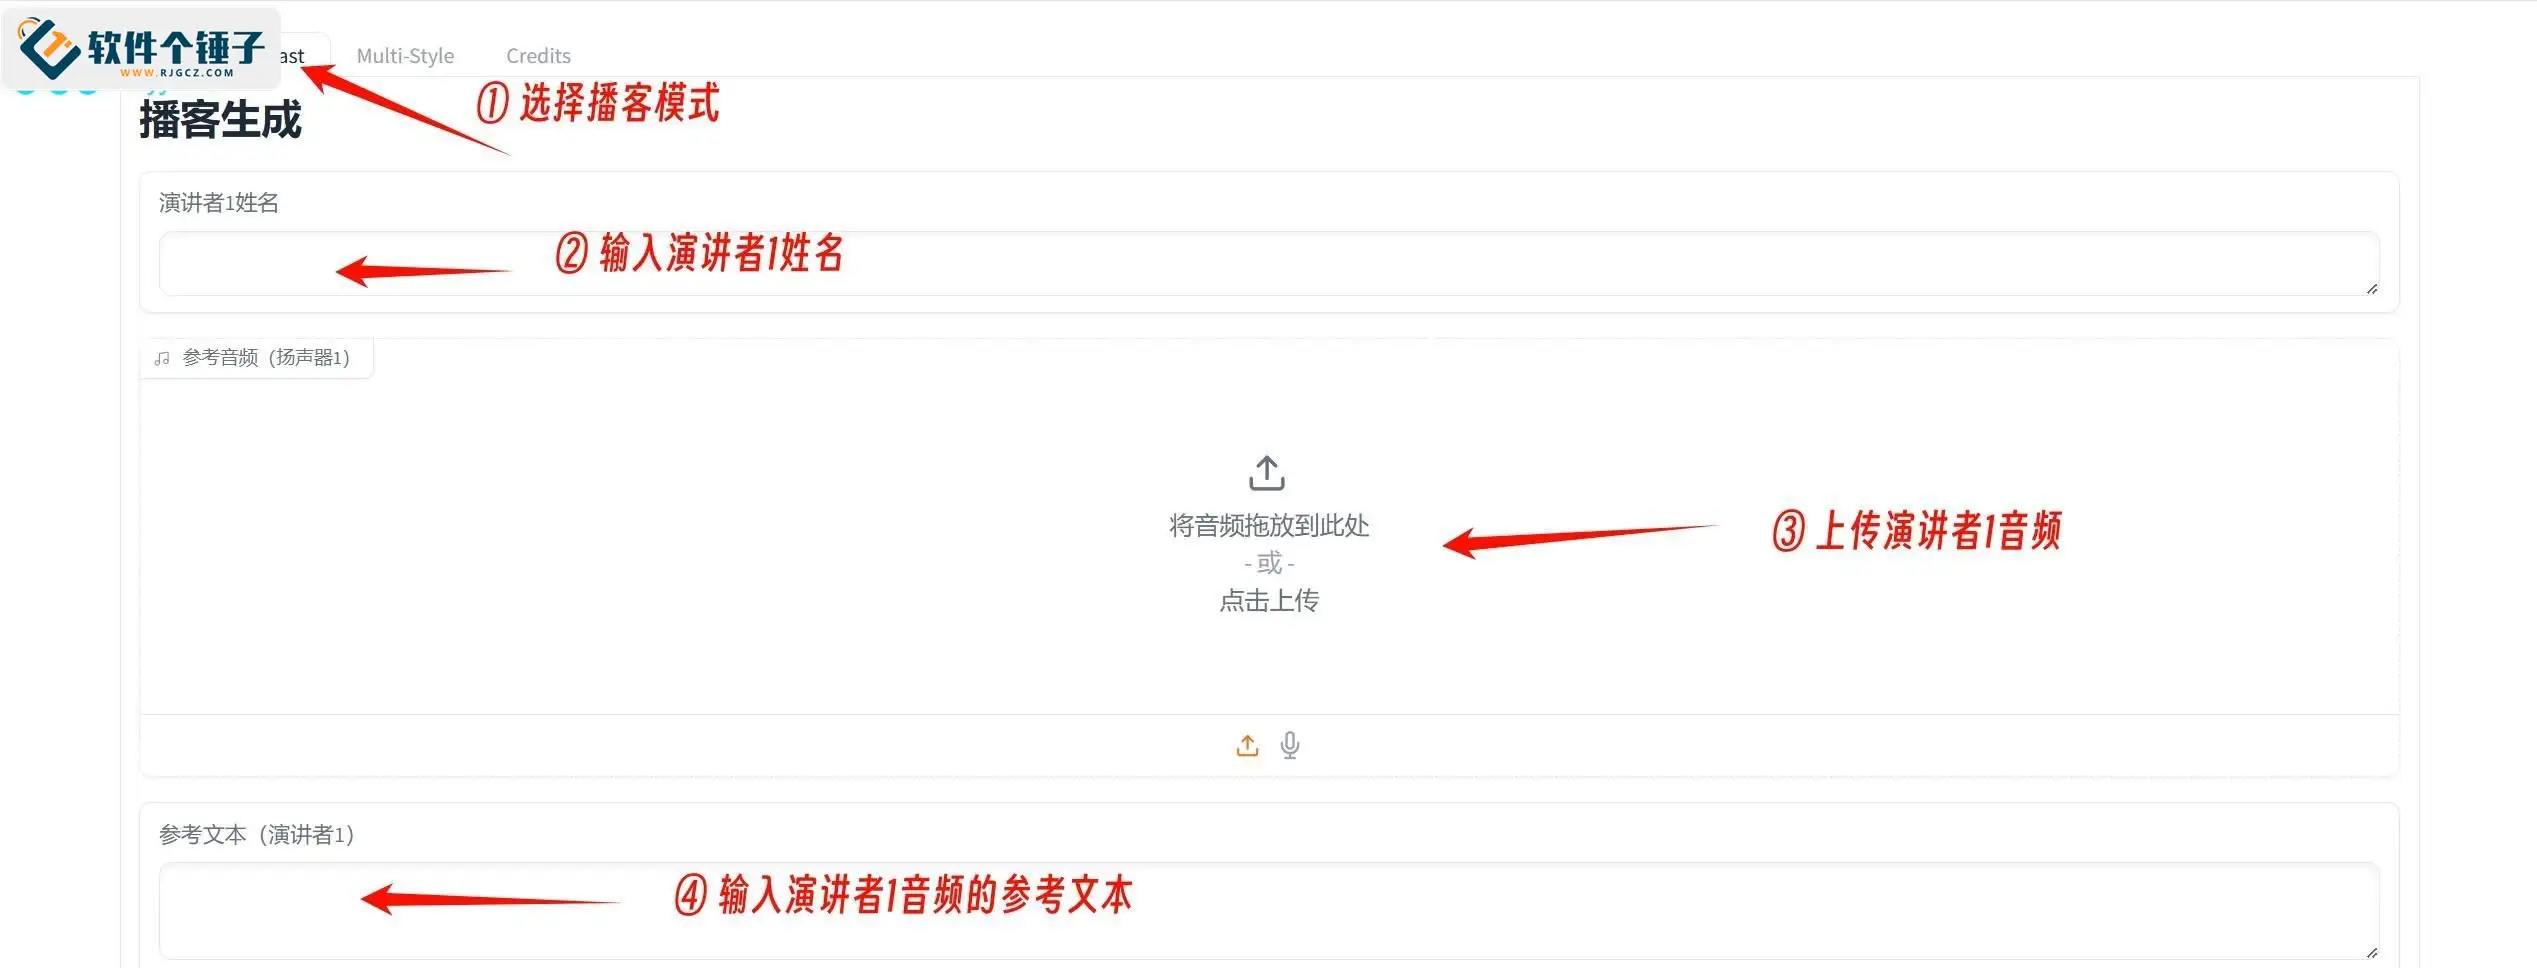
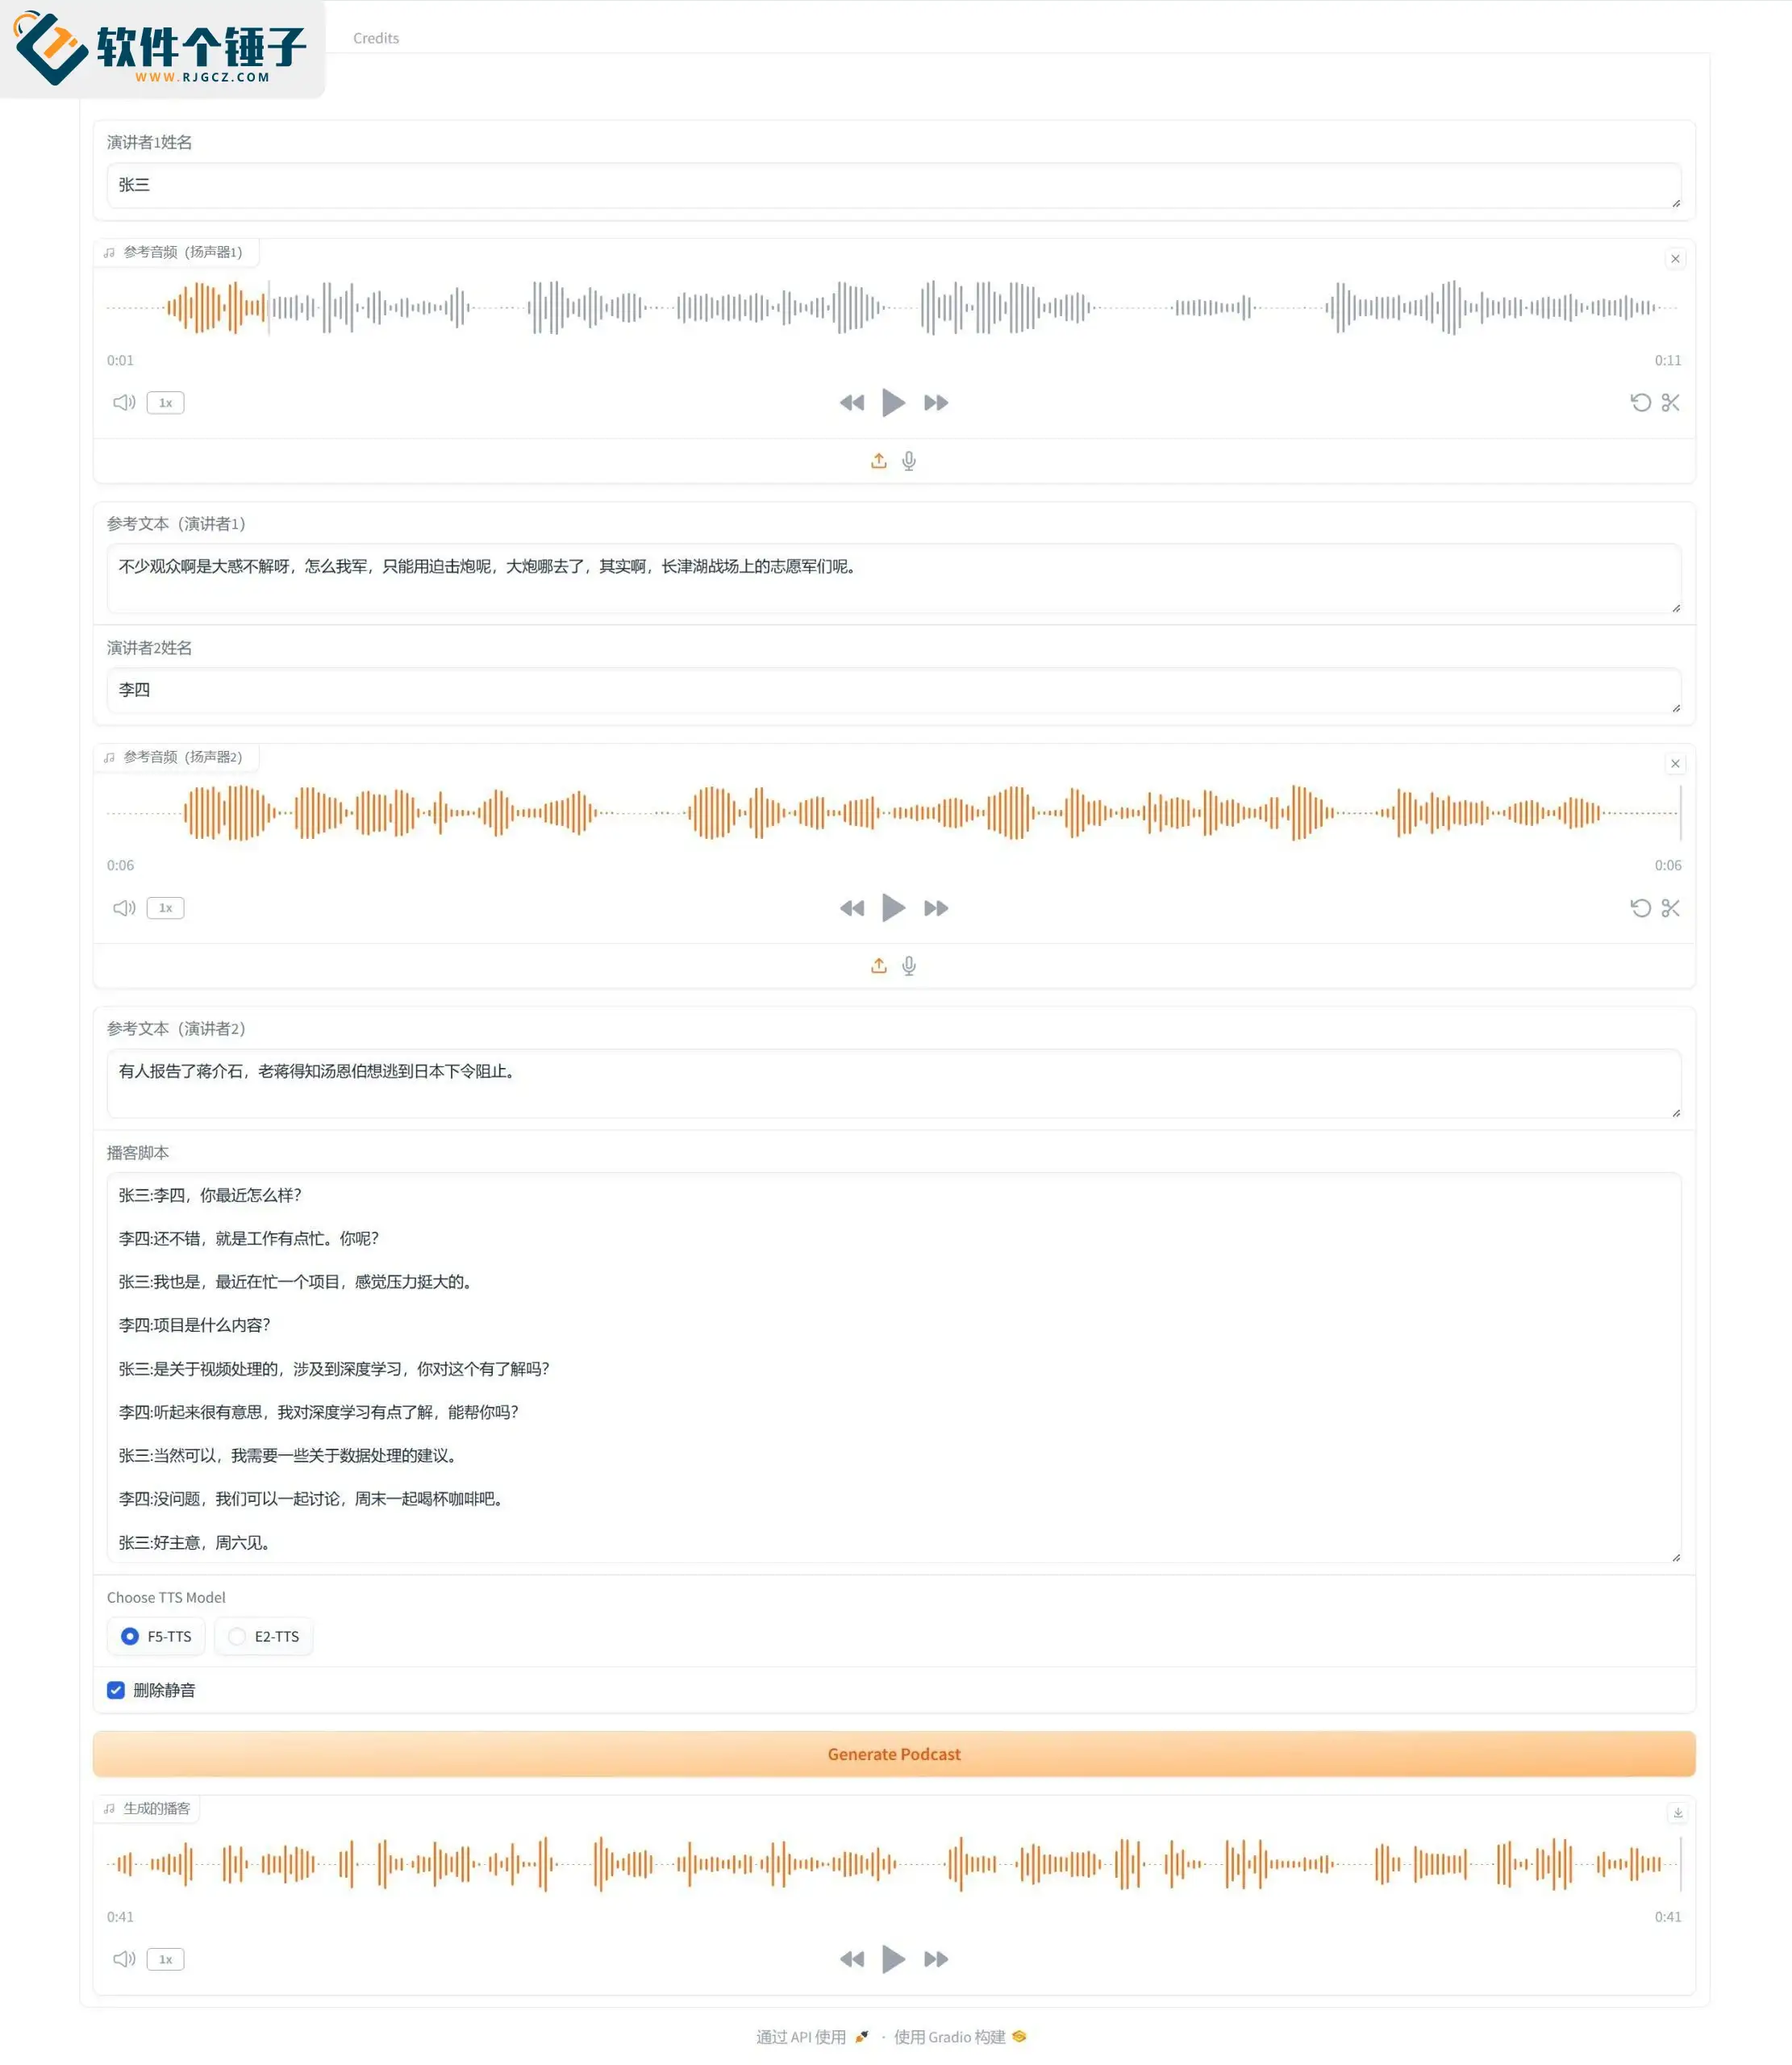
– เลือกโหมด "Podcast" ตั้งชื่อให้สองตัวละครและอัปโหลดไฟล์เสียงของแต่ละตัว ป้อนข้อความอ้างอิงที่สอดคล้องกัน
– เขียนสคริปต์บทสนทนา ระวังรูปแบบ: ใส่ชื่อตัวละครตามด้วยเครื่องหมายโคลอนแล้วเขียนเนื้อหาบทสนทนา ท้ายประโยคต้องใส่จุด
– ติ๊กเลือก "ลบความเงียบ" แล้วคลิกสร้าง

ผลลัพธ์ที่สร้างจะแสดงด้านล่าง สามารถฟังตัวอย่างหรือดาวน์โหลดได้

[เสียงต้นฉบับ-A]
[เสียงต้นฉบับ-B]
[ผลลัพธ์ที่สร้าง]
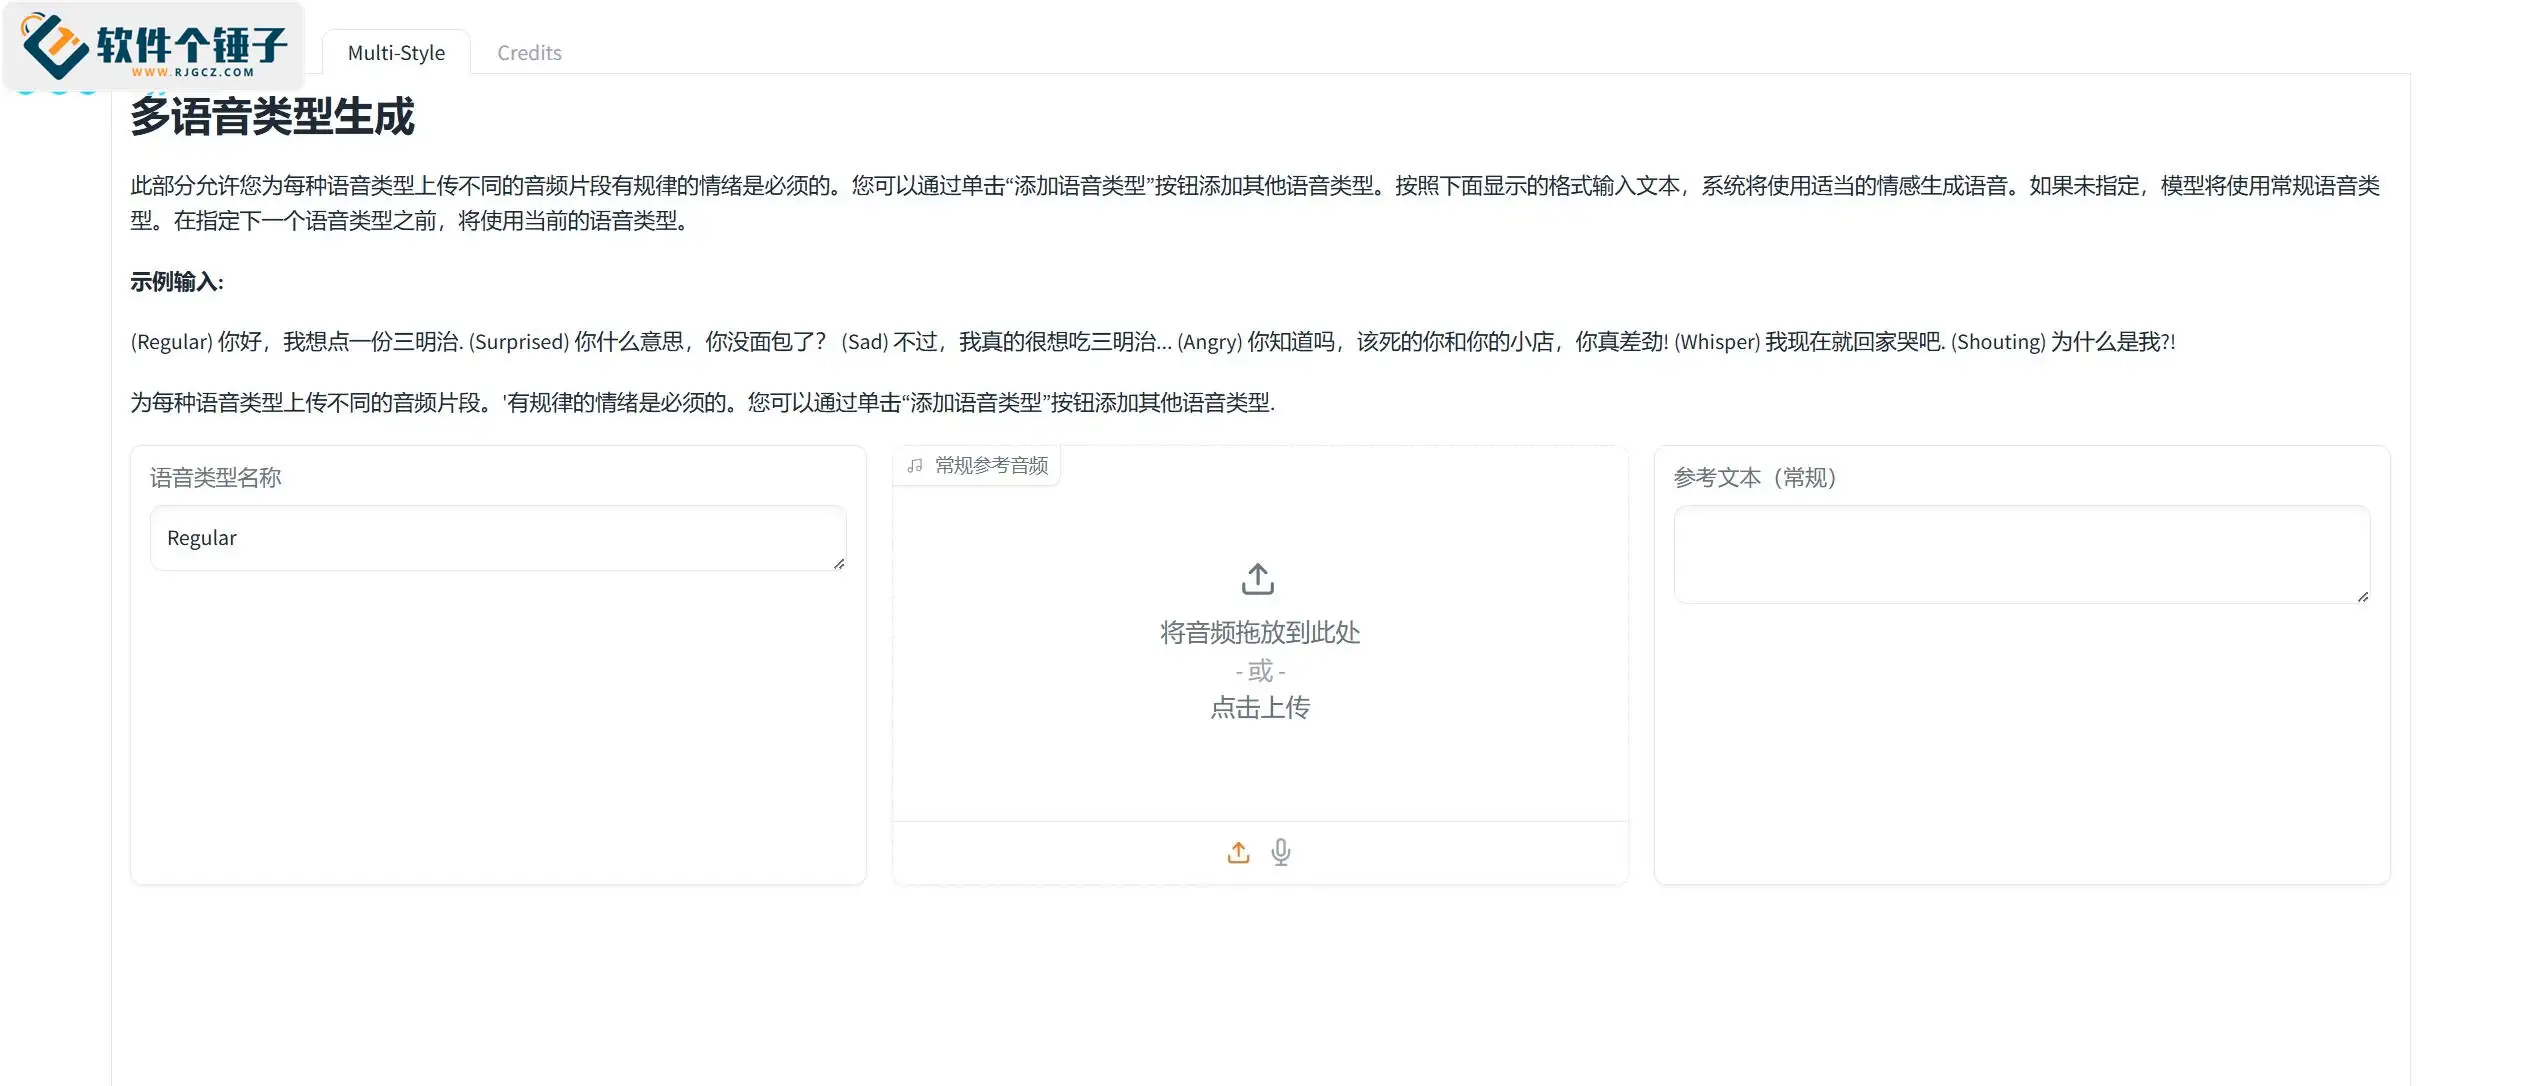
PS: เครื่องมือนี้ยังรองรับการสร้างอารมณ์ด้วย แต่ทดสอบแล้วได้ผลปานกลาง หากสนใจสามารถทดสอบเองได้!

ที่อยู่โอเพนซอร์ส:https://github.com/SWivid/F5-TTS
คอร์สที่เกี่ยวข้อง

กล่องเครื่องมือบนเครื่องสุดยอดมาแล้ว! ในตัวมีอัดหน้าจอ ตัด-รวมเสียงและวิดีโอ บีบอัด-แยกวิดีโอ ฟรีตลอดชีพ - Kedou Video Converter

เครื่องมือฟรี 100% สุดยอด! ซอฟต์แวร์ PDF มัลติฟังก์ชันแบบครบวงจร แปลง บีบอัด แก้ไข PDF ฯลฯ เรียบง่ายไม่มีโฆษณา - JOPDF

เครื่องมือรีโมทเดสก์ท็อปโอเพ่นซอร์ส เหนือกว่าเวอร์ชันเสียเงิน! ใช้ฟรีไม่จำกัดทั้งส่วนตัวและเชิงพาณิชย์ รองรับทุกแพลตฟอร์ม HopToDesk

ตัวดาวน์โหลดสื่อเรียน K-12 ล่าสุด: โหลดทั้งชั้นเป็นชุด, สไลด์·วิดีโอ·เสียงคลิกเดียว

HuYanBao: แอปถนอมตาและกรองแสงสีฟ้าฟรีสำหรับคอมพิวเตอร์ พร้อมสัตว์เลี้ยงเตือนให้พักเป็นระยะ

วินโดวส์ก็มี Dynamic Island บนเดสก์ท็อปได้! ศูนย์ควบคุมระบบสุดโมเดิร์น ให้คอมพิวเตอร์มีรอยบากดำเพิ่ม PyIsland

การผลิตคอมิกดราม่า 3D สมจริง: คอร์สปฏิบัติ Seedance2.0 ครบกระบวนการ

รองรับทั้ง Win/Mac! เวอร์ชันถาวรตลอดชีพล่าสุด รองรับการซ่อมภาพเก่า เครื่องมือทำภาพให้คมชัดและขยายแบบไม่สูญเสียคุณภาพ Aiarty Image Enhancer

คอร์สเรียนออนไลน์: Github เครื่องมือดาวน์โหลดวิดีโอ Bilibili โอเพนซอร์ส รองรับ 8K และ Dolby Vision ดาวน์โหลดวิดีโอ Bilibili แบบกลุ่ม ใช้งานง่าย Bilidown

ชุดเครื่องมือเดสก์ท็อป Windows! มีวิดเจ็ตเดสก์ท็อปมินิมัลประยุกต์ในตัวกว่า 50 ตัว ครอบคลุมแคปหน้าจอ บันทึกหน้าจอ แปลภาษา พยากรณ์อากาศ ฯลฯ — กล่องเครื่องมือ DuoMi

ข้อมูลติดต่อ
- อีเมล์: massivesidehustles@outlook.com
