


-
Kursus Perniagaan
-
 Lain-lain
-
Tutorial Luar Negara
-
Fotografi & Penyuntingan
-
Komuniti & Domain Persendirian
-
Penulisan Media Sendiri & Penulisan Iklan
-
Projek Pendapatan Sampingan
-
E-dagang
-
Video Pendek & Penstriman Langsung
-
Kecerdasan Buatan (AI)
-
Perisian & Alatan
-
Sistem Pengendalian
-
Pemalam & Skrip
-
Perisian MacOS
-
Perisian Android
-
Perisian Windows

Alat pengklonan suara AI yang pakar meniru nada dan emosi FireRedTTS, percuma dan sumber terbuka, mula dengan satu klik, tanpa penyebaran atau kebenaran, keluaran Xiaohongshu [Perisian Ge Chuizi-R2265]
-
Pelan Buat Duit Farming Emas Permainan: Jana 1k+ Sehari, Projek Stabil 3 Tahun, Orang Biasa Boleh Buat Pada Masa Lapang
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pendapatan automatik sepenuhnya permainan popular: 500+ sehari, tiada pengalaman, operasi mudah - kerja sampingan pendapatan permainan jangka panjang paling stabil (didedahkan)
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Tikus berjasa kali ini! Jangan panik dengan masalah format Windows - alat penukaran format FlyingMouse sumber terbuka membantu, permata GitHub popular
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Bootcamp Jualan Produk Douyin Dengan Bimbingan: Tak Perlu Muncul Di Kamera, Pendatang Baharu Ikut Langkah Hasilkan Video Pendek Jualan
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pelan jana wang game terbitan pertama: 1K+ sehari, orang biasa boleh lakukan pada masa lapang
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli






-
Tikus berjasa kali ini! Jangan panik dengan masalah format Windows - alat penukaran format FlyingMouse sumber terbuka membantu, permata GitHub popular
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Master Lu v6.1024.4105.1121 versi fail tunggal yang diringkaskan [Perisian Ge Chuizi·R1880]
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Perisian Animasi Kartun 2D Moho Pro v14.3 [Perisian Ge Chuzi · R2355]
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Perisian penyuntingan dan pemprosesan video untuk komputer Aiseesoft Filmai v1.0.18 【Software Ge Chuizi·R2470】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Microsoft To Do v2.147 versi rasmi percuma【Software Ge Chuizi·R2618】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pemalam osiloskop pembetulan warna video PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Perisian Ge Chui Zi·R2748】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli





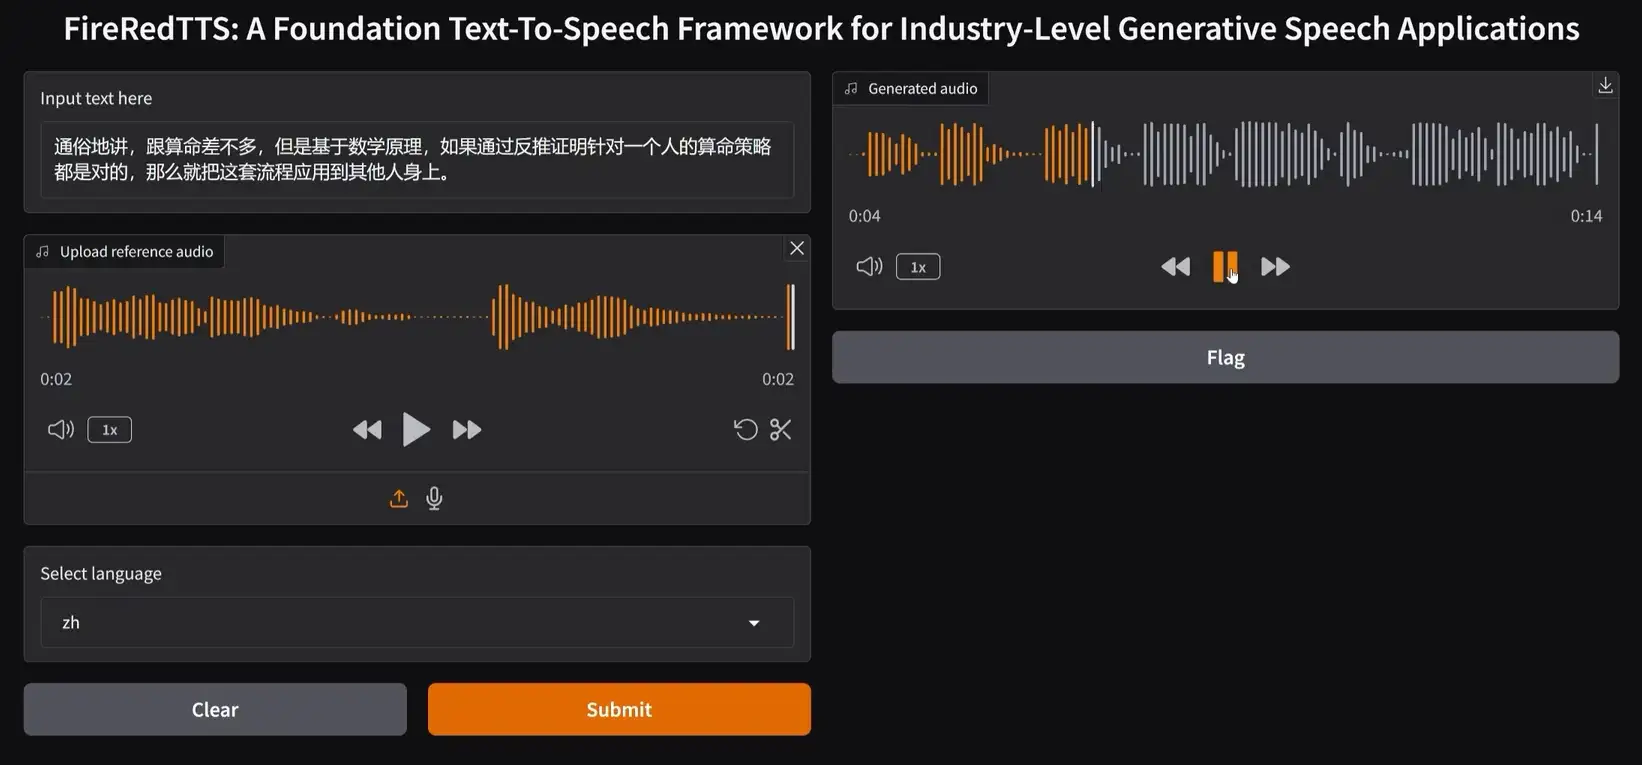
FireRedTTS yang dikeluarkan oleh Xiaohongshu ialah alat sintesis suara AI termaju; hanya dengan beberapa saat audio rujukan, ia dapat mengklon suara dengan tepat dan menghasilkan suara peribadi dengan gaya yang pelbagai. Tanpa proses latihan yang rumit, alat ini mampu meniru pelbagai warna suara, sangat sesuai untuk senario seperti alih suara video pendek dan interaksi sembang, membolehkan pengguna menyesuaikan kesan suara eksklusif dengan mudah.

Kesan satu:
Audio asal
Kesan dijana
Kesan dua:
Audio asal
Kesan dijana
Kesan tiga:
Audio asal
Kesan dijana
Kesan empat:
Audio asal
Kesan dijana - Bahasa Cina
Kesan dijana - Bahasa Inggeris
Sorotan perisian
1. Peniruan warna suara yang pelbagai
Sama ada suara gadis manis, suara wanita matang yang anggun, mahupun suara lelaki dewasa yang tenang, FireRedTTS boleh menirunya dengan sempurna bagi memenuhi keperluan pengguna yang pelbagai.
2. Tanpa kos pembelajaran
Pengguna hanya perlu menyediakan beberapa saat audio rujukan untuk menghasilkan suara eksklusif, sama sekali tidak memerlukan langkah latihan yang rumit.
3. Gaya suara yang kaya
Daripada lucu kepada lembut, daripada tegas bergaya kepada comel, FireRedTTS menyokong pelbagai ekspresi emosi dan sesuai untuk pelbagai senario penggunaan.
4. Penjanaan pantas
Hanya dalam sekelip mata, suara lengkap dapat dijana, meningkatkan kecekapan penghasilan video pendek dan kandungan kreatif dengan ketara.
Senario penggunaan
1. Alih suara video pendek
Pencipta kandungan boleh menyuntik lebih banyak keseronokan ke dalam video pendek; sama ada gaya suara lucu atau mesra, semuanya dapat menjadikan kandungan lebih menarik.
2. Interaksi sembang
Gunakan warna suara selebriti atau suara peribadi dalam aplikasi sembang untuk menambah keseronokan perbualan dan menjadikan komunikasi lebih berpersonaliti.
3. Alih suara iklan dan filem
Dengan pelbagai gaya suara yang ditawarkan oleh FireRedTTS, tambahkan kesan suara yang unik pada iklan atau karya filem untuk meningkatkan kualiti karya.
4. Penciptaan audio
Pemuzik atau pencipta podcast boleh menggunakan FireRedTTS untuk menyuntik lebih banyak elemen suara ke dalam karya mereka dan mencipta kandungan audio yang penuh kesegaran.
Keperluan konfigurasi
Untuk memastikan perisian berjalan lancar, disyorkan komputer anda memenuhi konfigurasi berikut:
– Sistem pengendalian: Windows 10/11 (64-bit)
– Kad grafik: Disyorkan kad grafik NVIDIA dengan memori video 8GB ke atas, menyokong CUDA >= 11.8
– Ruang storan: Fail selepas nyahmampat berukuran kira-kira 12.6GB, sila pastikan ruang cakera keras mencukupi
– Pemasangan CUDA: Jika CUDA belum dipasang, sila rujuk tutorial pemasangan:Tutorial pemasangan CUDA
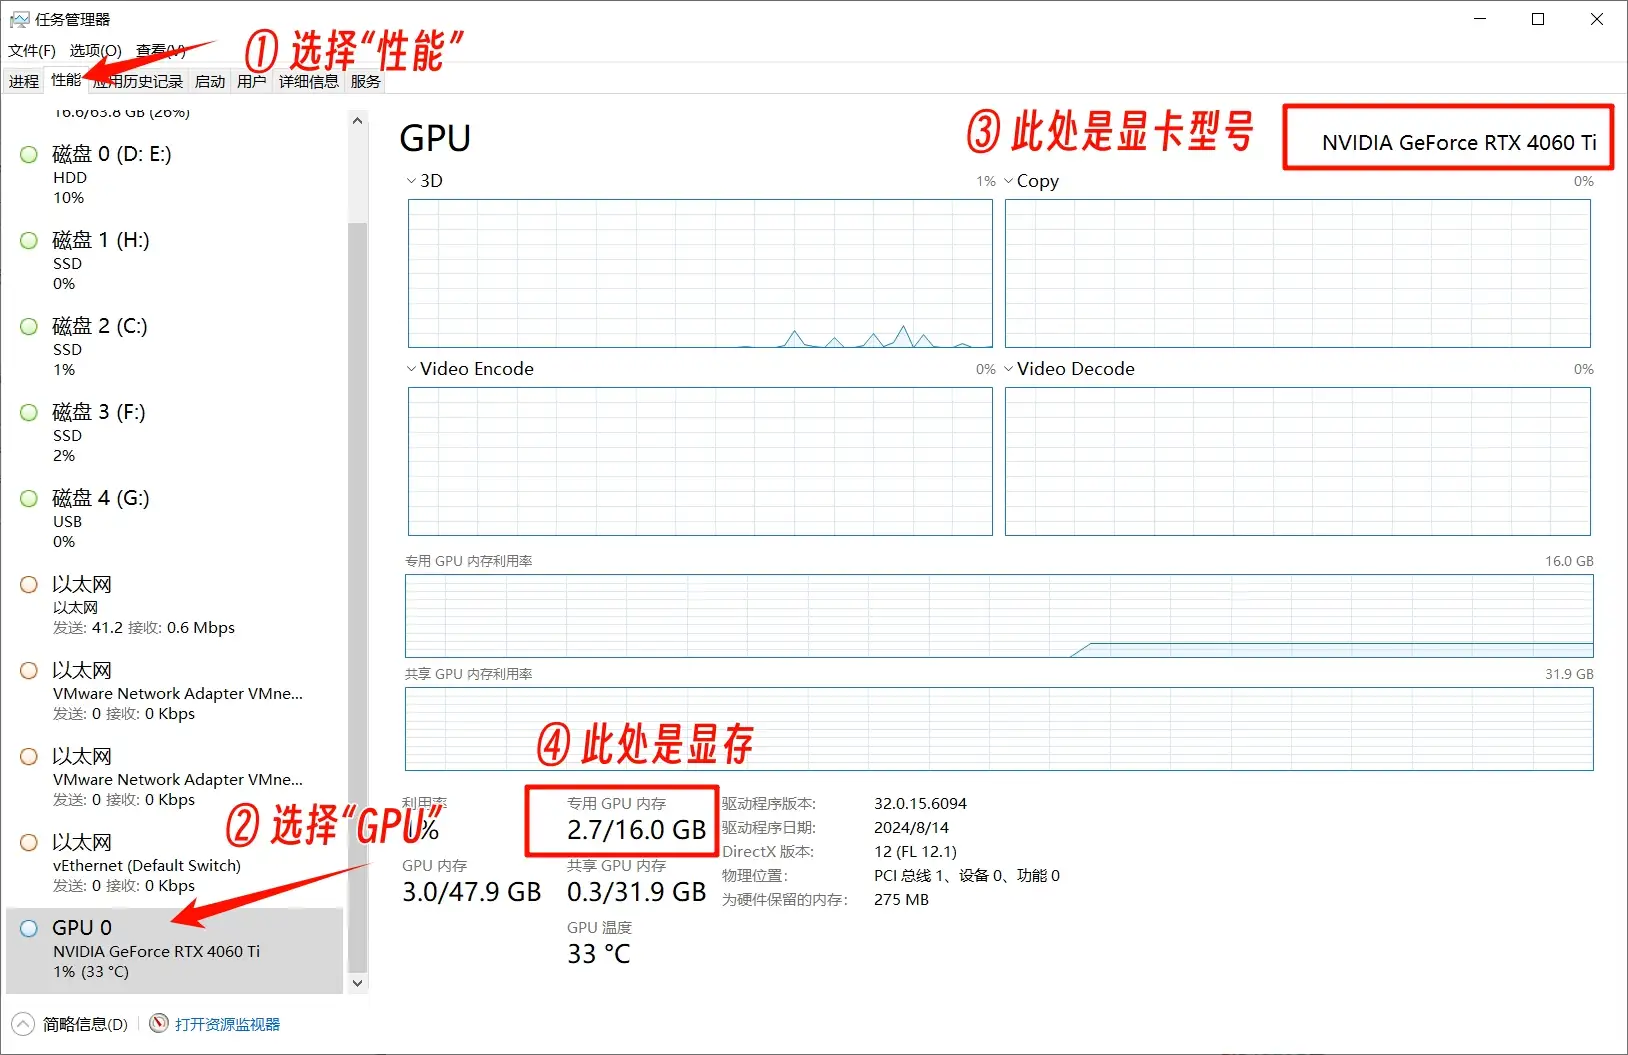
Cara menyemak model kad grafik dan saiz memori video
1. Buka Pengurus Tugas
2. Klik tab "Prestasi"
3. Pilih "GPU"
4. Di penjuru kanan atas anda boleh melihat model kad grafik, dan saiz memori video dipaparkan di bawah

Melalui FireRedTTS, sama ada video pendek kreatif, interaksi sembang, mahupun alih suara iklan, semuanya dapat memberikan lebih banyak kemungkinan kepada suara dan membantu anda menguasai pelbagai senario dengan mudah!
Tutorial penggunaan:
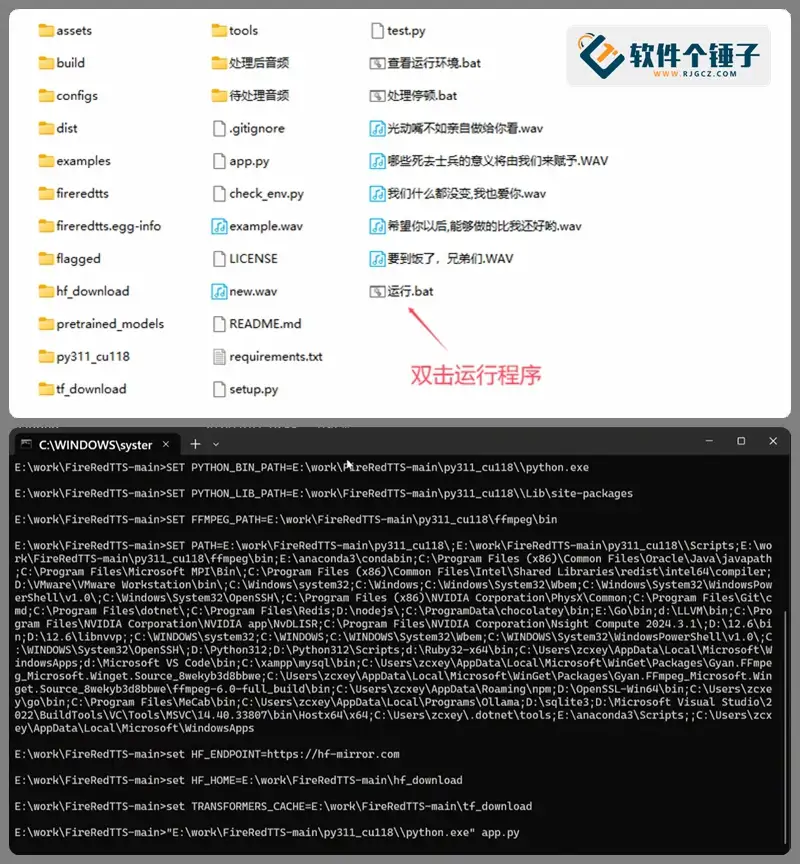
01. Selepas memuat turun pakej bersepadu, nyahmampatkannya;
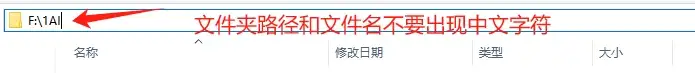
Perhatian: laluan folder dan nama fail (termasuk nama fail audio, imej, video dan lain-lain) tidak boleh mengandungi aksara Cina, jika tidak sebahagian perisian akan melaporkan ralat kerana tidak dapat mengenalinya

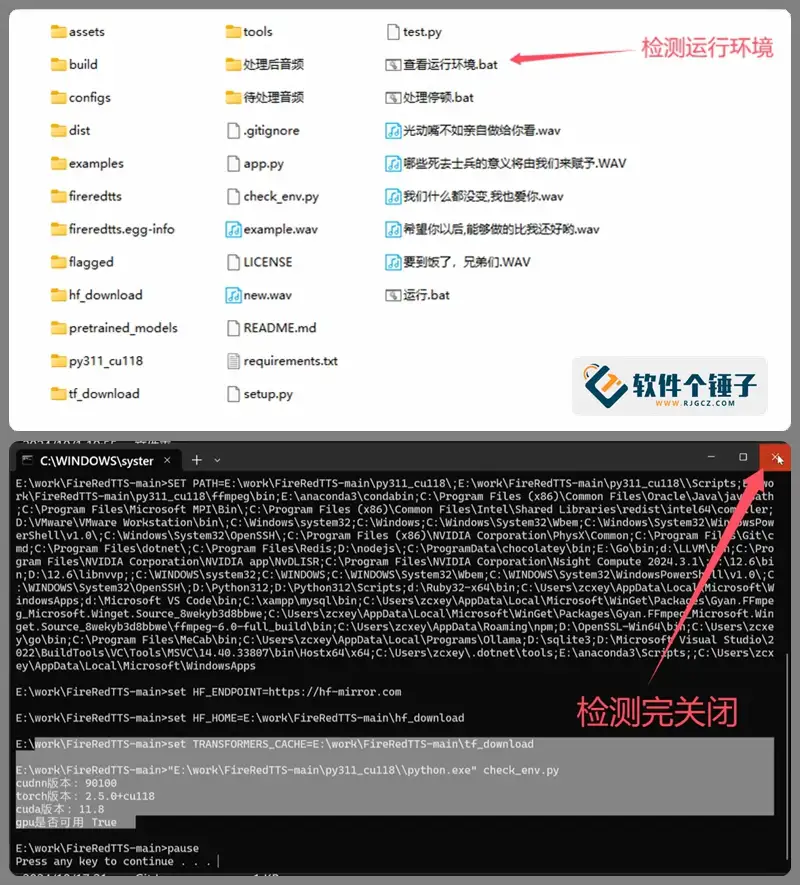
02. Selepas nyahmampat, klik dua kali untuk menjalankan 查看运行环境.bat, dan tutup selepas selesai;

03. Klik dua kali 运行.bat untuk menjalankan program, minimumkan tetingkap pelaksanaan dan jangan tutupnya;

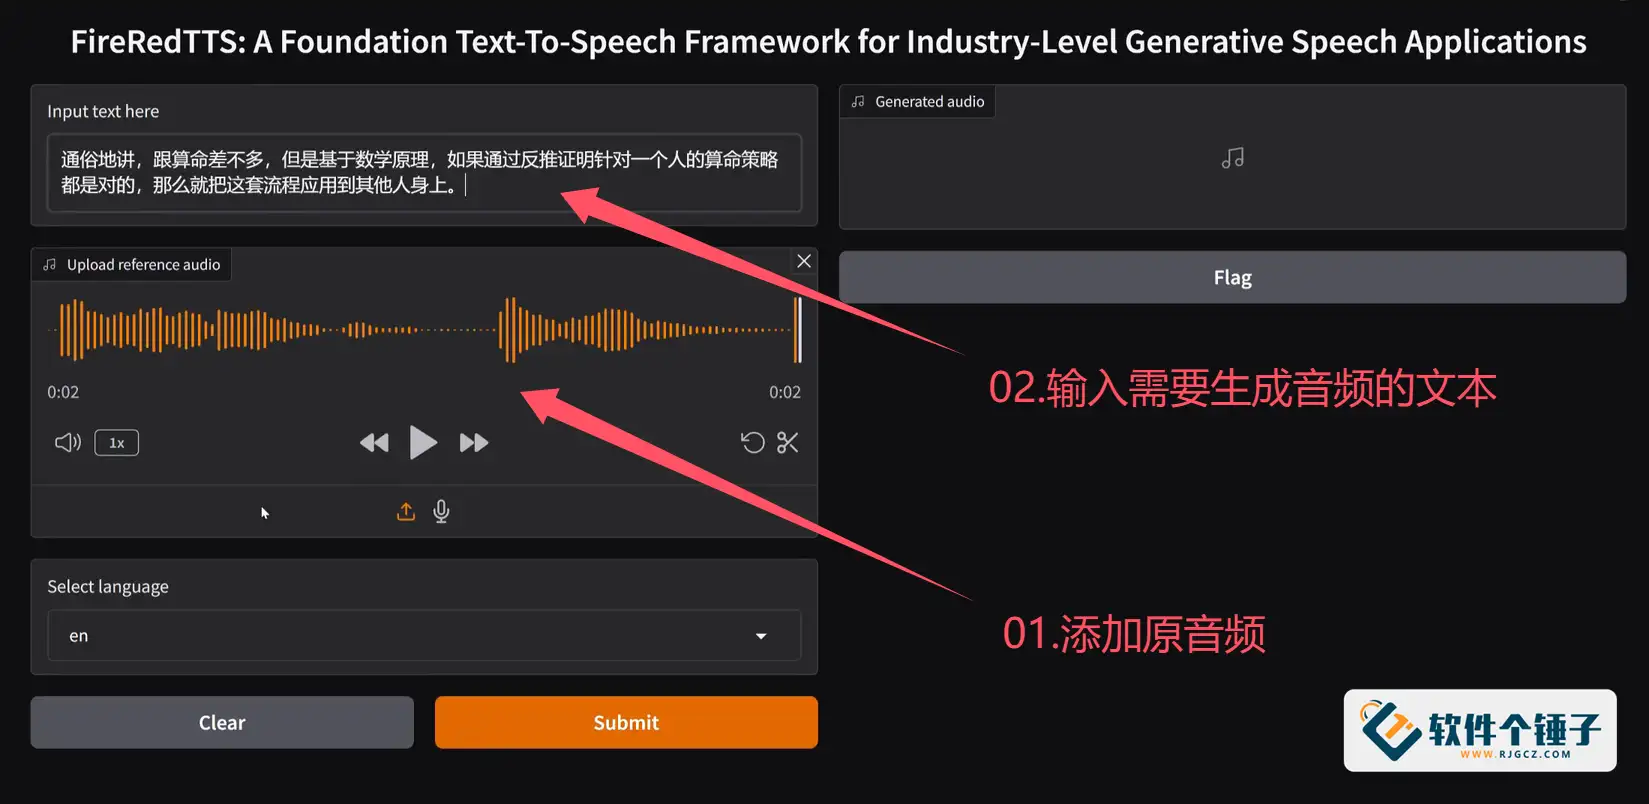
04. Tambah audio asal, kemudian masukkan teks yang perlu ditukar kepada suara;

05. Pilih bahasa ("zh" untuk Bahasa Cina, "en" untuk Bahasa Inggeris; ambil perhatian bahawa di sini anda mesti memilih, walaupun pilihan yang dikehendaki sudah dipaparkan, buka dan pilih sekali, jika tidak akan berlaku ralat), akhir sekali klik "Submit" untuk menghantar, tunggu sebentar dan hasil akan dijana; hasil penjanaan berada di sebelah kanan dan boleh dipratonton;

Alamat sumber terbuka:https://github.com/FireRedTeam/FireRedTTS
Kurs Berkaitan

Kotak alat tempatan super! Rakaman skrin, potong & gabung audio/video, mampat & ekstrak video terbina dalam, percuma selamanya - Kedou Video Converter

Alat percuma sempurna 100%%! Perisian PDF serba boleh sehenti: penukaran, pemampatan, penyuntingan PDF dll., minimalis, tiada iklan, sangat bagus - JOPDF

Alat Desktop Jauh Sumber Terbuka, Mengatasi Versi Berbayar! Percuma untuk Kegunaan Peribadi dan Komersial Tanpa Had, Merentas Platform, HopToDesk

Alat Muat Turun Buku Teks Sekolah Terkini: Sokong Muat Turun Seluruh Tingkatan, Bahan Kursus·Video·Audio Satu Klik

HuyanBao: aplikasi penjaga mata cahaya biru percuma untuk komputer, dengan peringatan rehat haiwan peliharaan

Windows juga boleh ada Pulau Dinamik desktop! Pusat kawalan sistem moden, beri komputer anda takuk hitam tambahan, PyIsland

Penghasilan Drama Komik Realistik 3D: Kursus Amali Penuh Seedance2.0

Sokongan Win/Mac! Versi seumur hidup terkini, pemulihan foto lama, peningkatan imej tanpa kehilangan kualiti Aiarty Image Enhancer

Kursus video dalam talian: Github / B / 8K / Bilidown

Koleksi Alat Desktop Windows! 50+ Widget Desktop Minimalis Praktis Terbina, Termasuk Tangkapan Skrin, Rakaman Skrin, Terjemahan, Cuaca dsb. — DuoMi Toolbox

