


-
Corsi per imprenditori solisti
-
 Altri
-
Tutorial esteri
-
Fotografia & Montaggio
-
Community & Dominio privato
-
Scrittura & Copywriting per media
-
Progetti di reddito extra
-
E-commerce
-
Video brevi & Live streaming
-
Intelligenza Artificiale (IA)
-
Software & Strumenti
-
Sistemi operativi
-
Plugin & Script
-
Software MacOS
-
Software Android
-
Software Windows

Generazione AI di digital human parlanti da foto - supporta mezzi busti EchoMimic V2, gratuito e open source di Alibaba DAMO Academy, avvio con un clic, nessuna distribuzione o autorizzazione necessaria [Software Gechuizi · R2279]
-
Piano di guadagno con il farming di oro nei videogiochi: guadagna oltre 1k al giorno, un progetto stabile da 3 anni che chiunque può fare nel tempo libero
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Corso sistematico SOP per AI comic drama: selezione e adattamento di web novel, norme per le sceneggiature, da testo a immagine e da immagine a video fino al film finito, doppiaggio e montaggio - tutorial completo e standardizzato (aggiornamento 0826)
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Farming automatizzato di giochi popolari: 500+/giorno, senza esperienza, semplice – l'extra stabile a lungo termine più affidabile [Rivelato]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
ShuShu questa volta si è fatto onore! Niente panico con i problemi di formato di Windows: lo strumento open source ShuShu Format Converter, un gioiello popolare su GitHub
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Camp di accompagnamento vendite Douyin: senza apparizione reale, principianti copiano template e producono video
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Piano di guadagno con il farming nei giochi in anteprima: 1.000+ al giorno, fattibile dalle persone comuni nel tempo libero
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati






-
ShuShu questa volta si è fatto onore! Niente panico con i problemi di formato di Windows: lo strumento open source ShuShu Format Converter, un gioiello popolare su GitHub
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Lu Master v6.1024.4105.1121 versione alleggerita in file singolo [Software Ge Chuizi - R1880]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Software per la creazione di animazioni cartonate bidimensionali Moho Pro v14.3 [Software Ge Chuzi · R2355]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Software di editing e elaborazione video per PC Aiseesoft Filmai v1.0.18 【Software Ge Chuzi·R2470】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Microsoft To Do v2.147 versione ufficiale gratuita【Software Gechuzi·R2618】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Plugin oscilloscopio per color grading video PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Ge Chuizi·R2748】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati





EchoMimic è una tecnologia AI avanzata sviluppata da Alibaba DAMO Academy, in grado di generare automaticamente, da un file audio e una foto del volto, un video con animazione labiale perfettamente sincronizzata al contenuto audio. Questa tecnologia è ampiamente utilizzata in ambiti come intrattenimento, istruzione, realtà virtuale e videoconferenze, offrendo agli utenti esperienze innovative.
Attualmente è disponibile la versione EchoMimic V2, che supporta il caricamento di foto a mezzo busto e può generare digital human a mezzo busto più vivaci, rendendo gli scenari d'uso ancora più vari.
Funzioni principali
– Sincronizzazione labiale precisa
Analizzando il contenuto audio e i punti caratteristici del volto, genera un effetto video perfettamente corrispondente al ritmo e al contenuto della voce.
– Animazione naturale e realistica
La tecnologia supporta movimenti facciali ed espressioni naturali; le animazioni generate hanno un forte senso di realismo, vicine alla resa di una persona reale.
– Supporto linguistico e multi-stile
Che si tratti di mandarino, inglese o stile cantato, EchoMimic riesce a ottenere una sincronizzazione di alta qualità, soddisfacendo esigenze diversificate.
Scenari d'uso
– Ambito dell'intrattenimento
Genera animazioni di dialogo sincronizzate per personaggi di film, TV e videogiochi, aumentando il coinvolgimento del pubblico.
– Settore dell'istruzione
Crea video didattici interattivi, rendendo l'apprendimento vivo e interessante e migliorando la qualità dell'insegnamento.
– Realtà virtuale (VR)
Genera animazioni realistiche di personaggi virtuali, rafforzando l'esperienza immersiva dell'utente in ambienti VR.
– Riunioni online
Genera animazioni labiali sincronizzate per riunioni a distanza, aumentando il realismo della comunicazione.
– Realtà aumentata (AR)
Crea personaggi virtuali realistici nelle applicazioni AR, arricchendo l'esperienza interattiva.
Requisiti di configurazione del sistema
- Sistema operativo: Windows 10/11 64 bit
– Requisiti della scheda grafica:
– Versione V1: scheda grafica NVIDIA con almeno 8 GB di VRAM
– Versione V2: almeno 12 GB di VRAM, consigliati 16 GB o più per garantire un funzionamento stabile (più potente è la scheda grafica, più veloce è la generazione)
– Dipendenze software: CUDA ≥ 12.4
– Spazio di archiviazione: circa 19,8 GB dopo l'estrazione
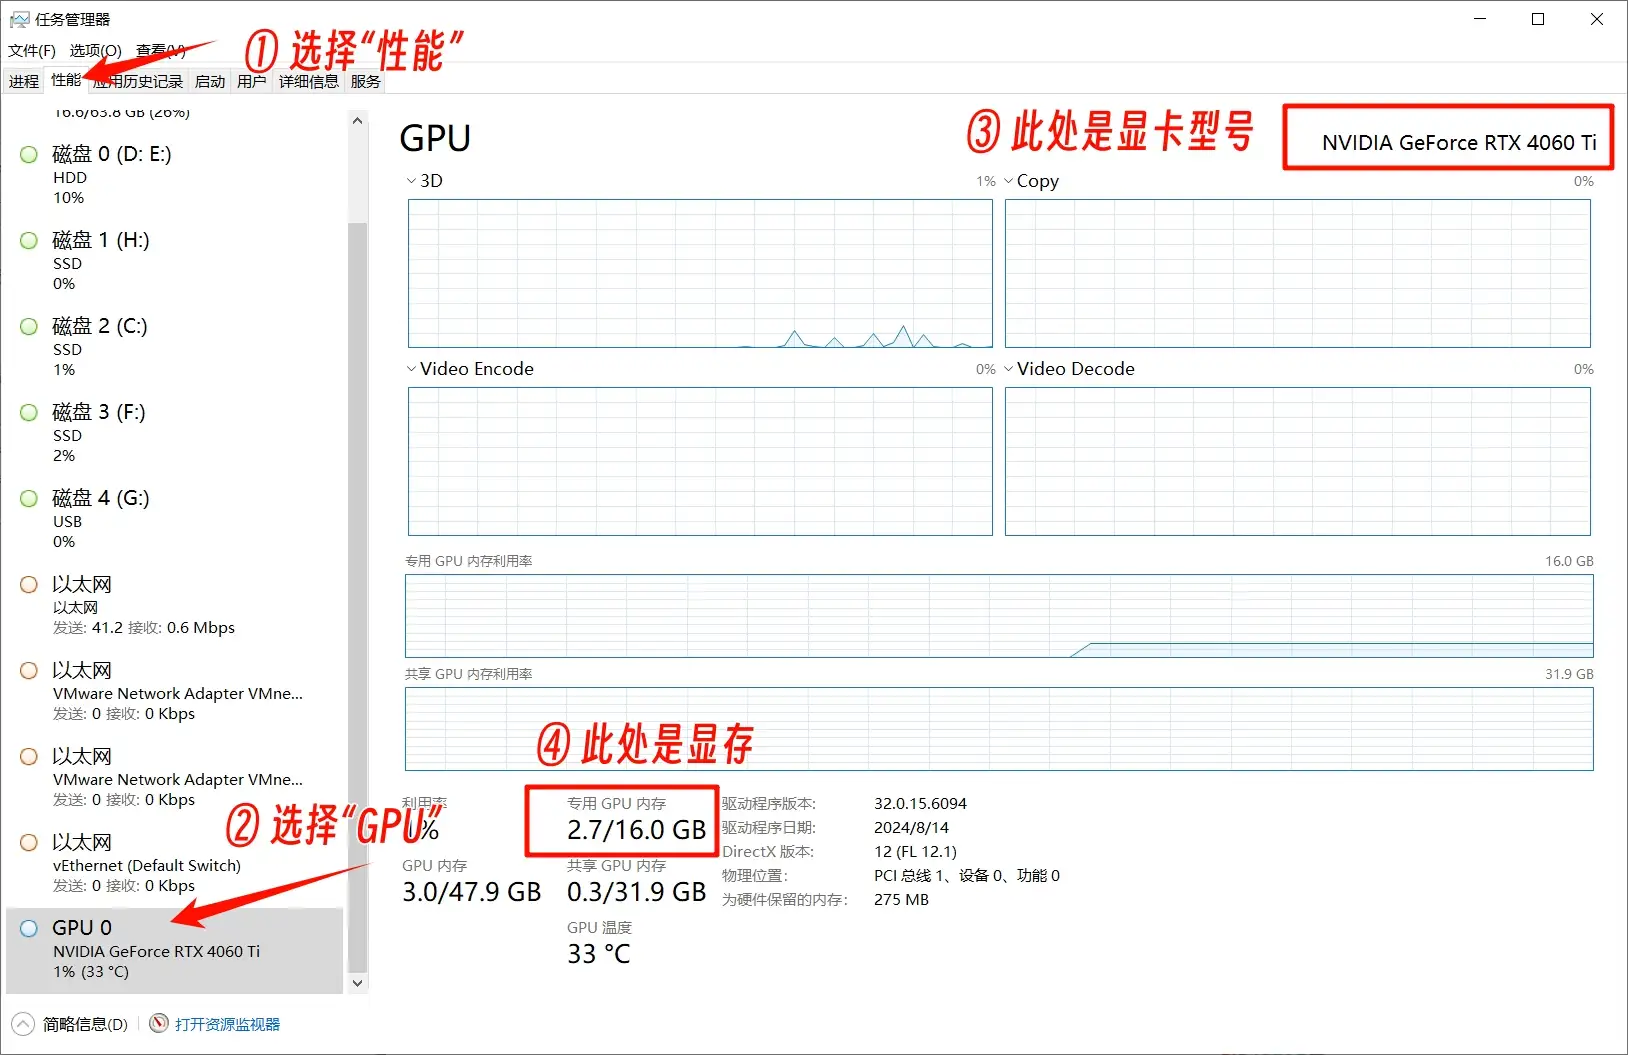
– Come visualizzare le informazioni della scheda grafica:
1. Apri il Task Manager
2. Fai clic sulla scheda "Prestazioni"
3. Nell'area "GPU" controlla il modello della scheda grafica e la dimensione della VRAM

Per il tutorial dettagliato sull'installazione di CUDA visita: [
Guida all'uso
Guida operativa alla versione V2
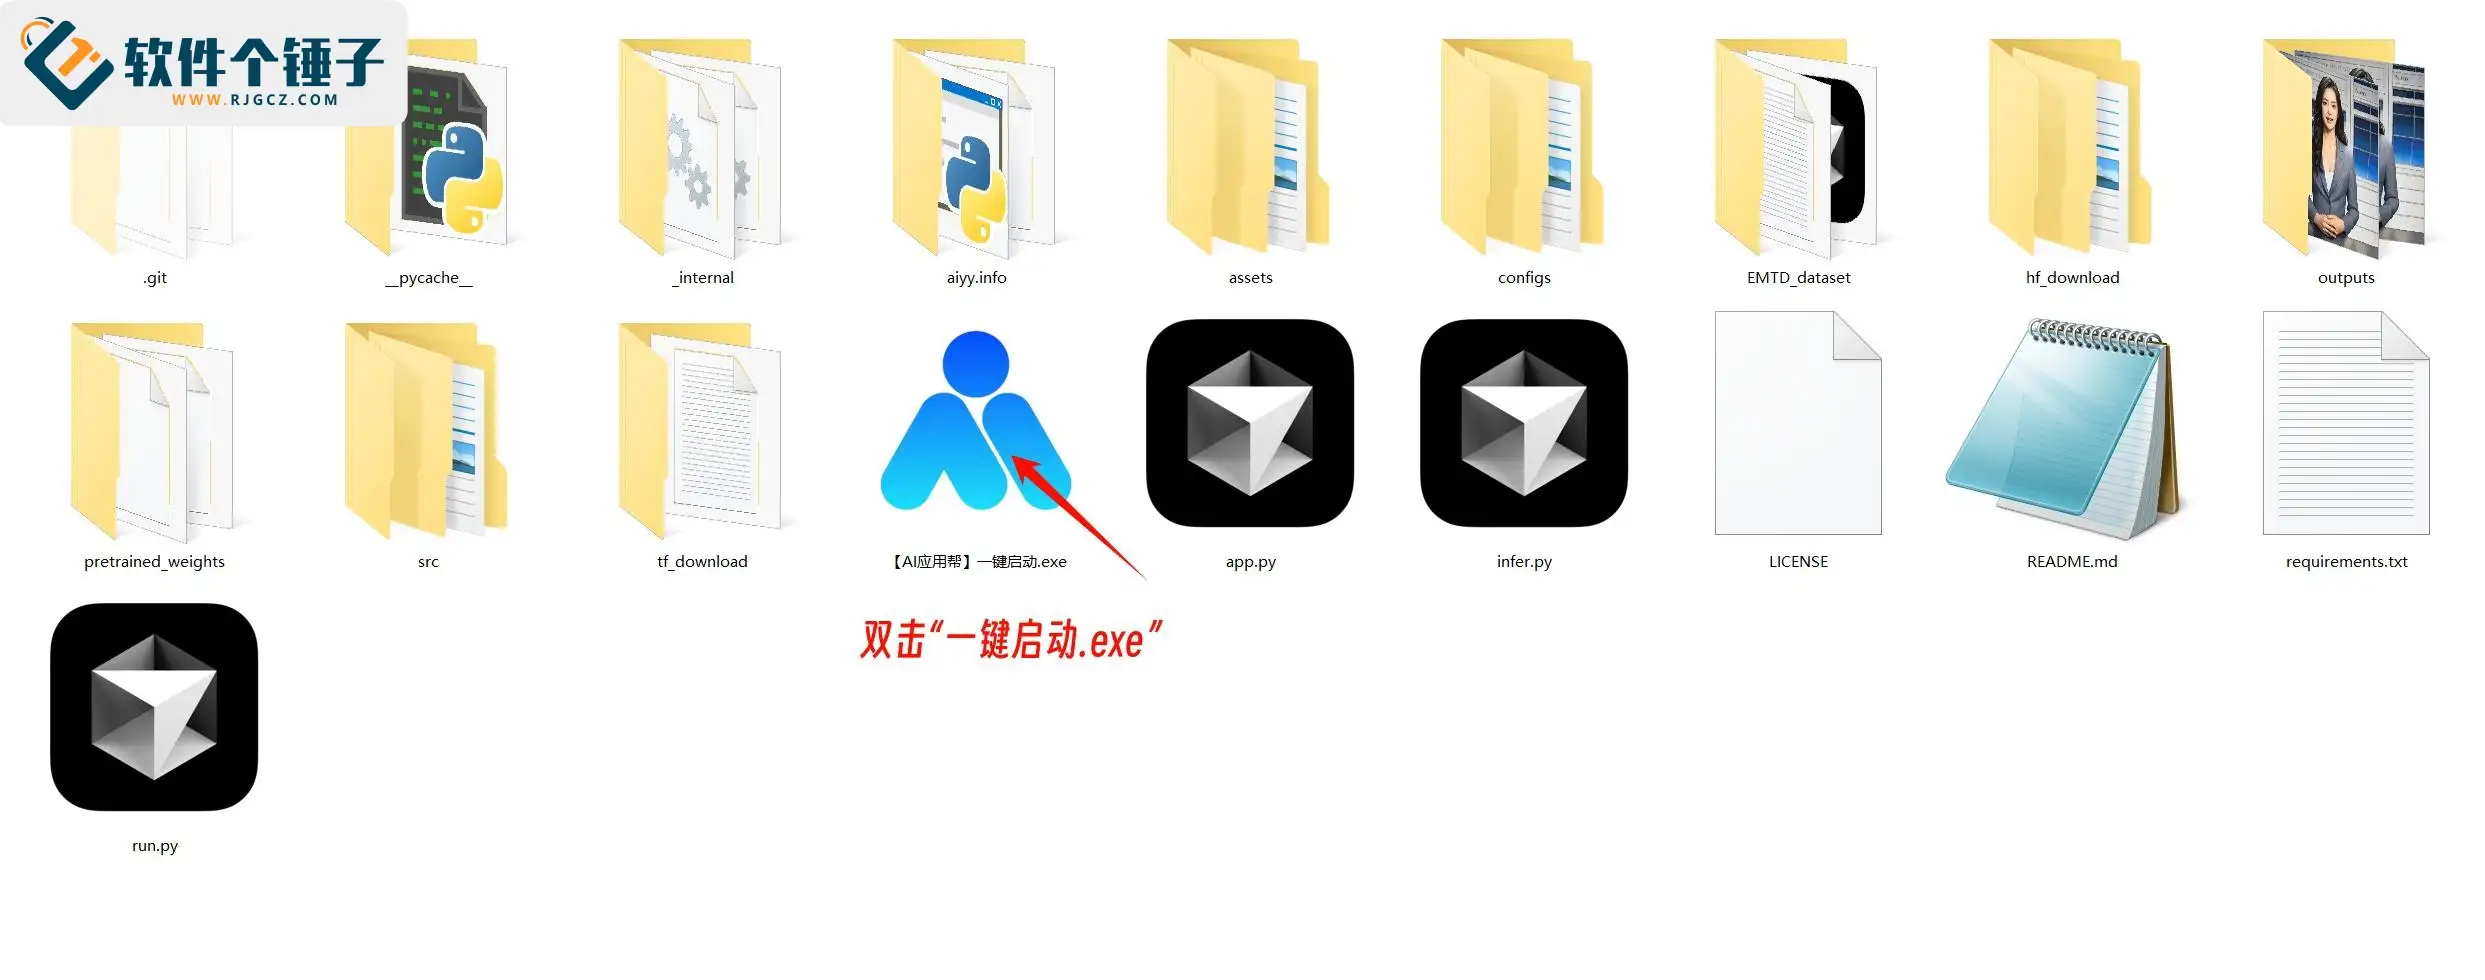
1. Estrai il pacchetto integrato scaricato e assicurati che cartelle e nomi dei file non contengano caratteri cinesi (inclusi immagini, audio e altri file).

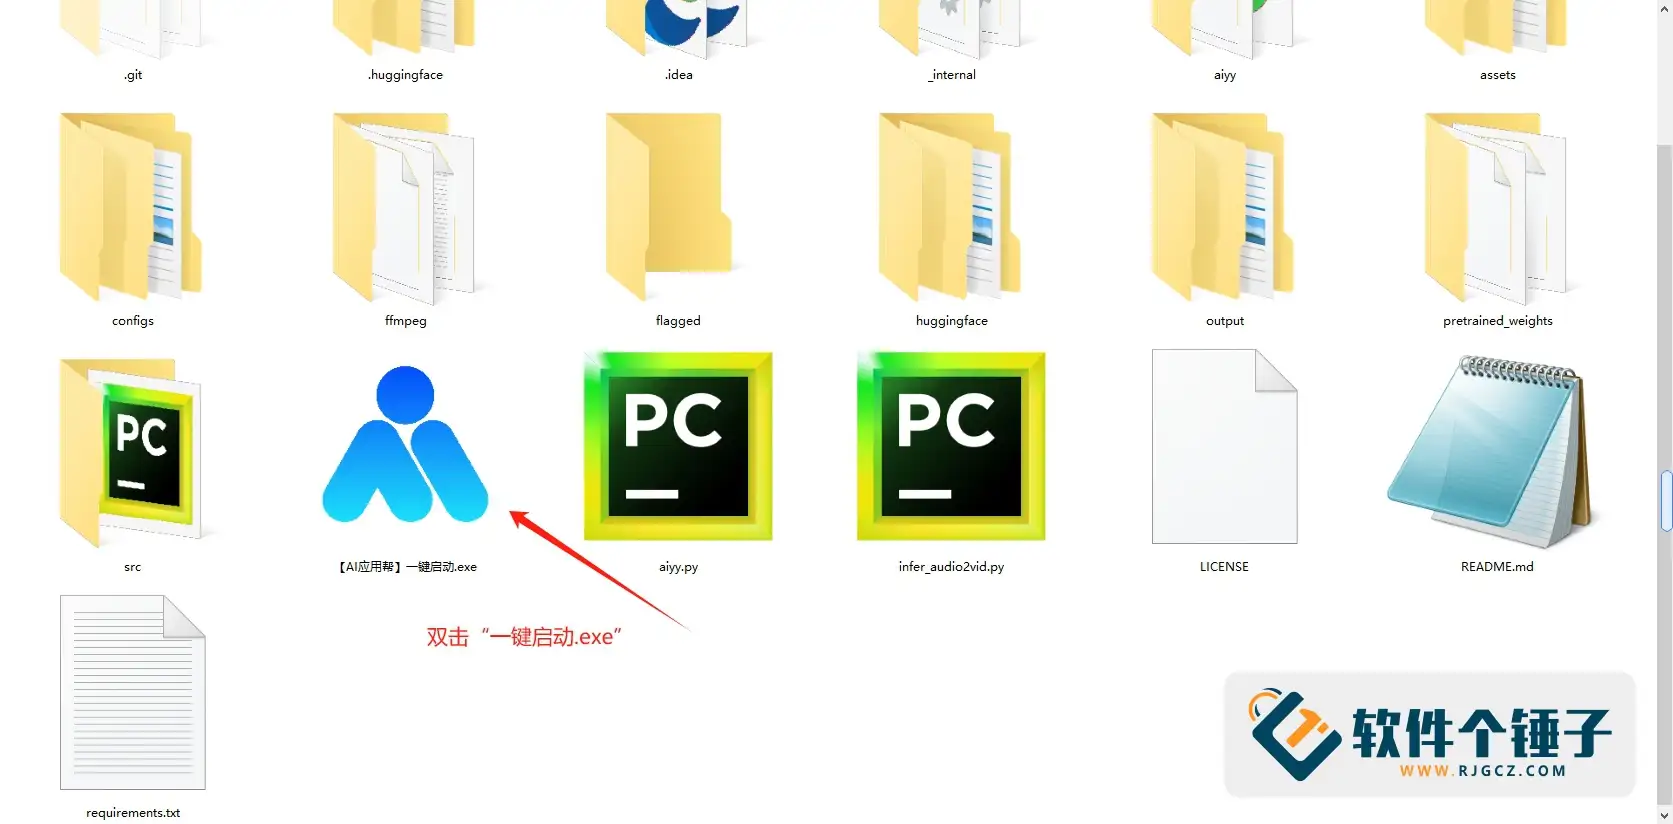
2. Fai doppio clic su "Avvio con un clic.exe", attendi qualche istante e il browser aprirà automaticamente l'interfaccia operativa.

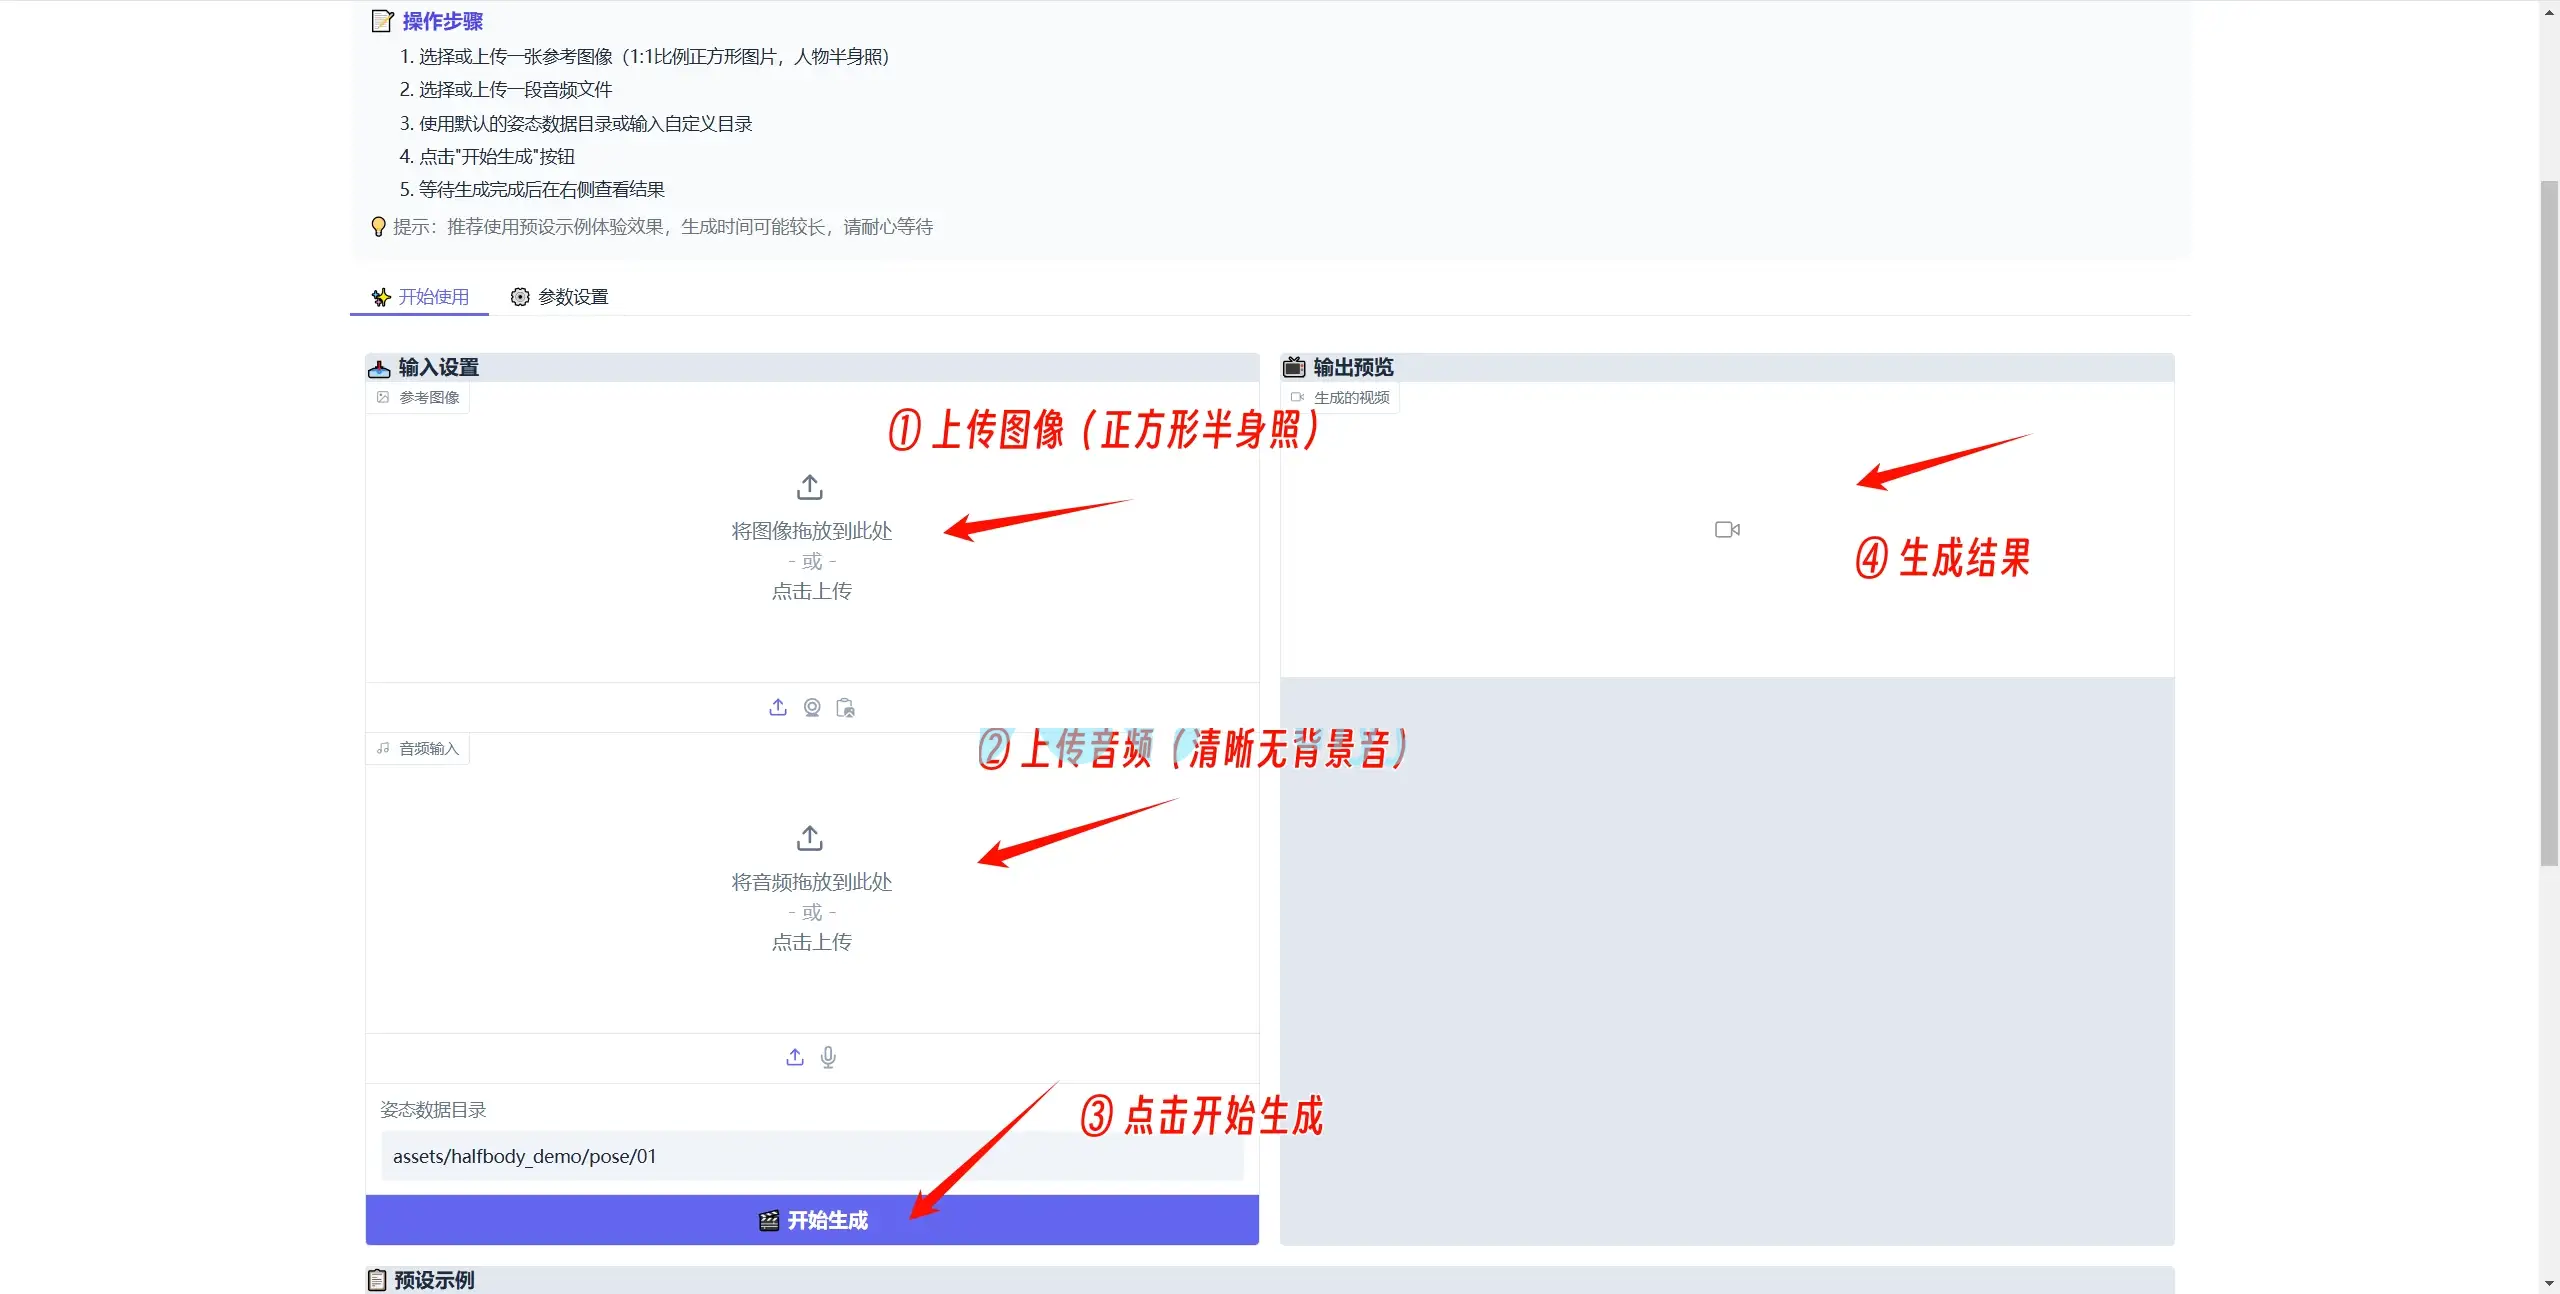
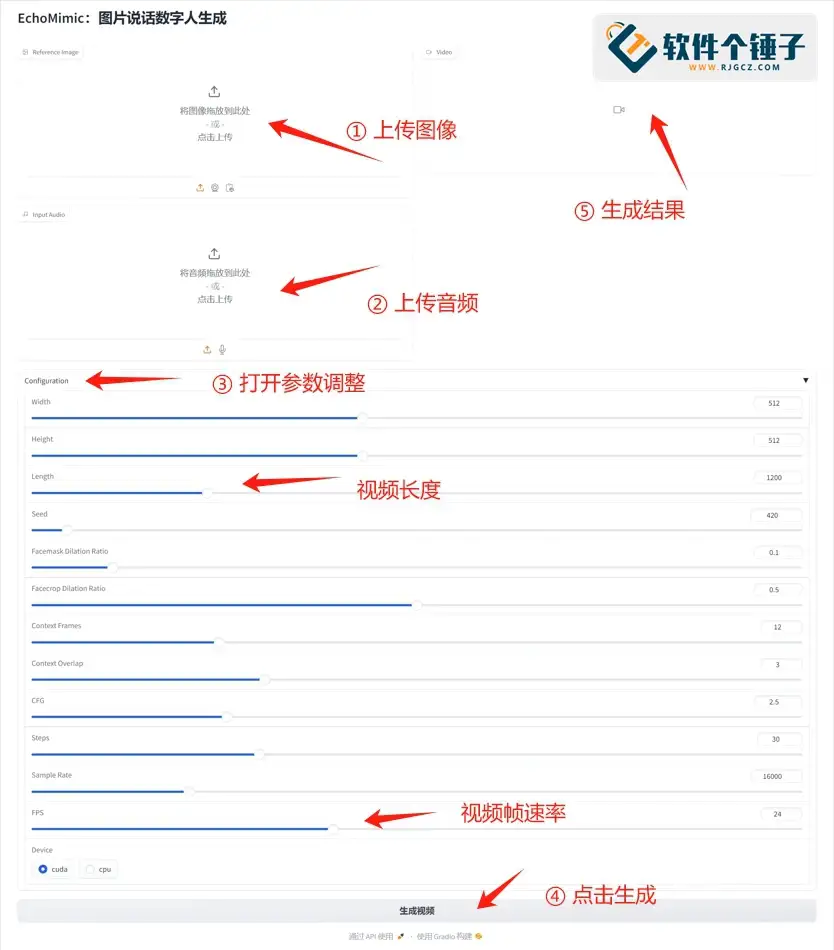
3. Carica una foto frontale del viso in formato quadrato 1:1, assicurandoti che i lineamenti siano nitidi e il materiale conforme ai requisiti (fai riferimento all'esempio in fondo alla pagina).
4. Carica il file audio; si consiglia un audio di sola voce, senza musica di sottofondo.

5. Fai clic su "Inizia generazione" e attendi pazientemente il completamento (ad esempio: con una scheda grafica 4060Ti 16G, generare 1 secondo di video richiede circa 5 minuti).

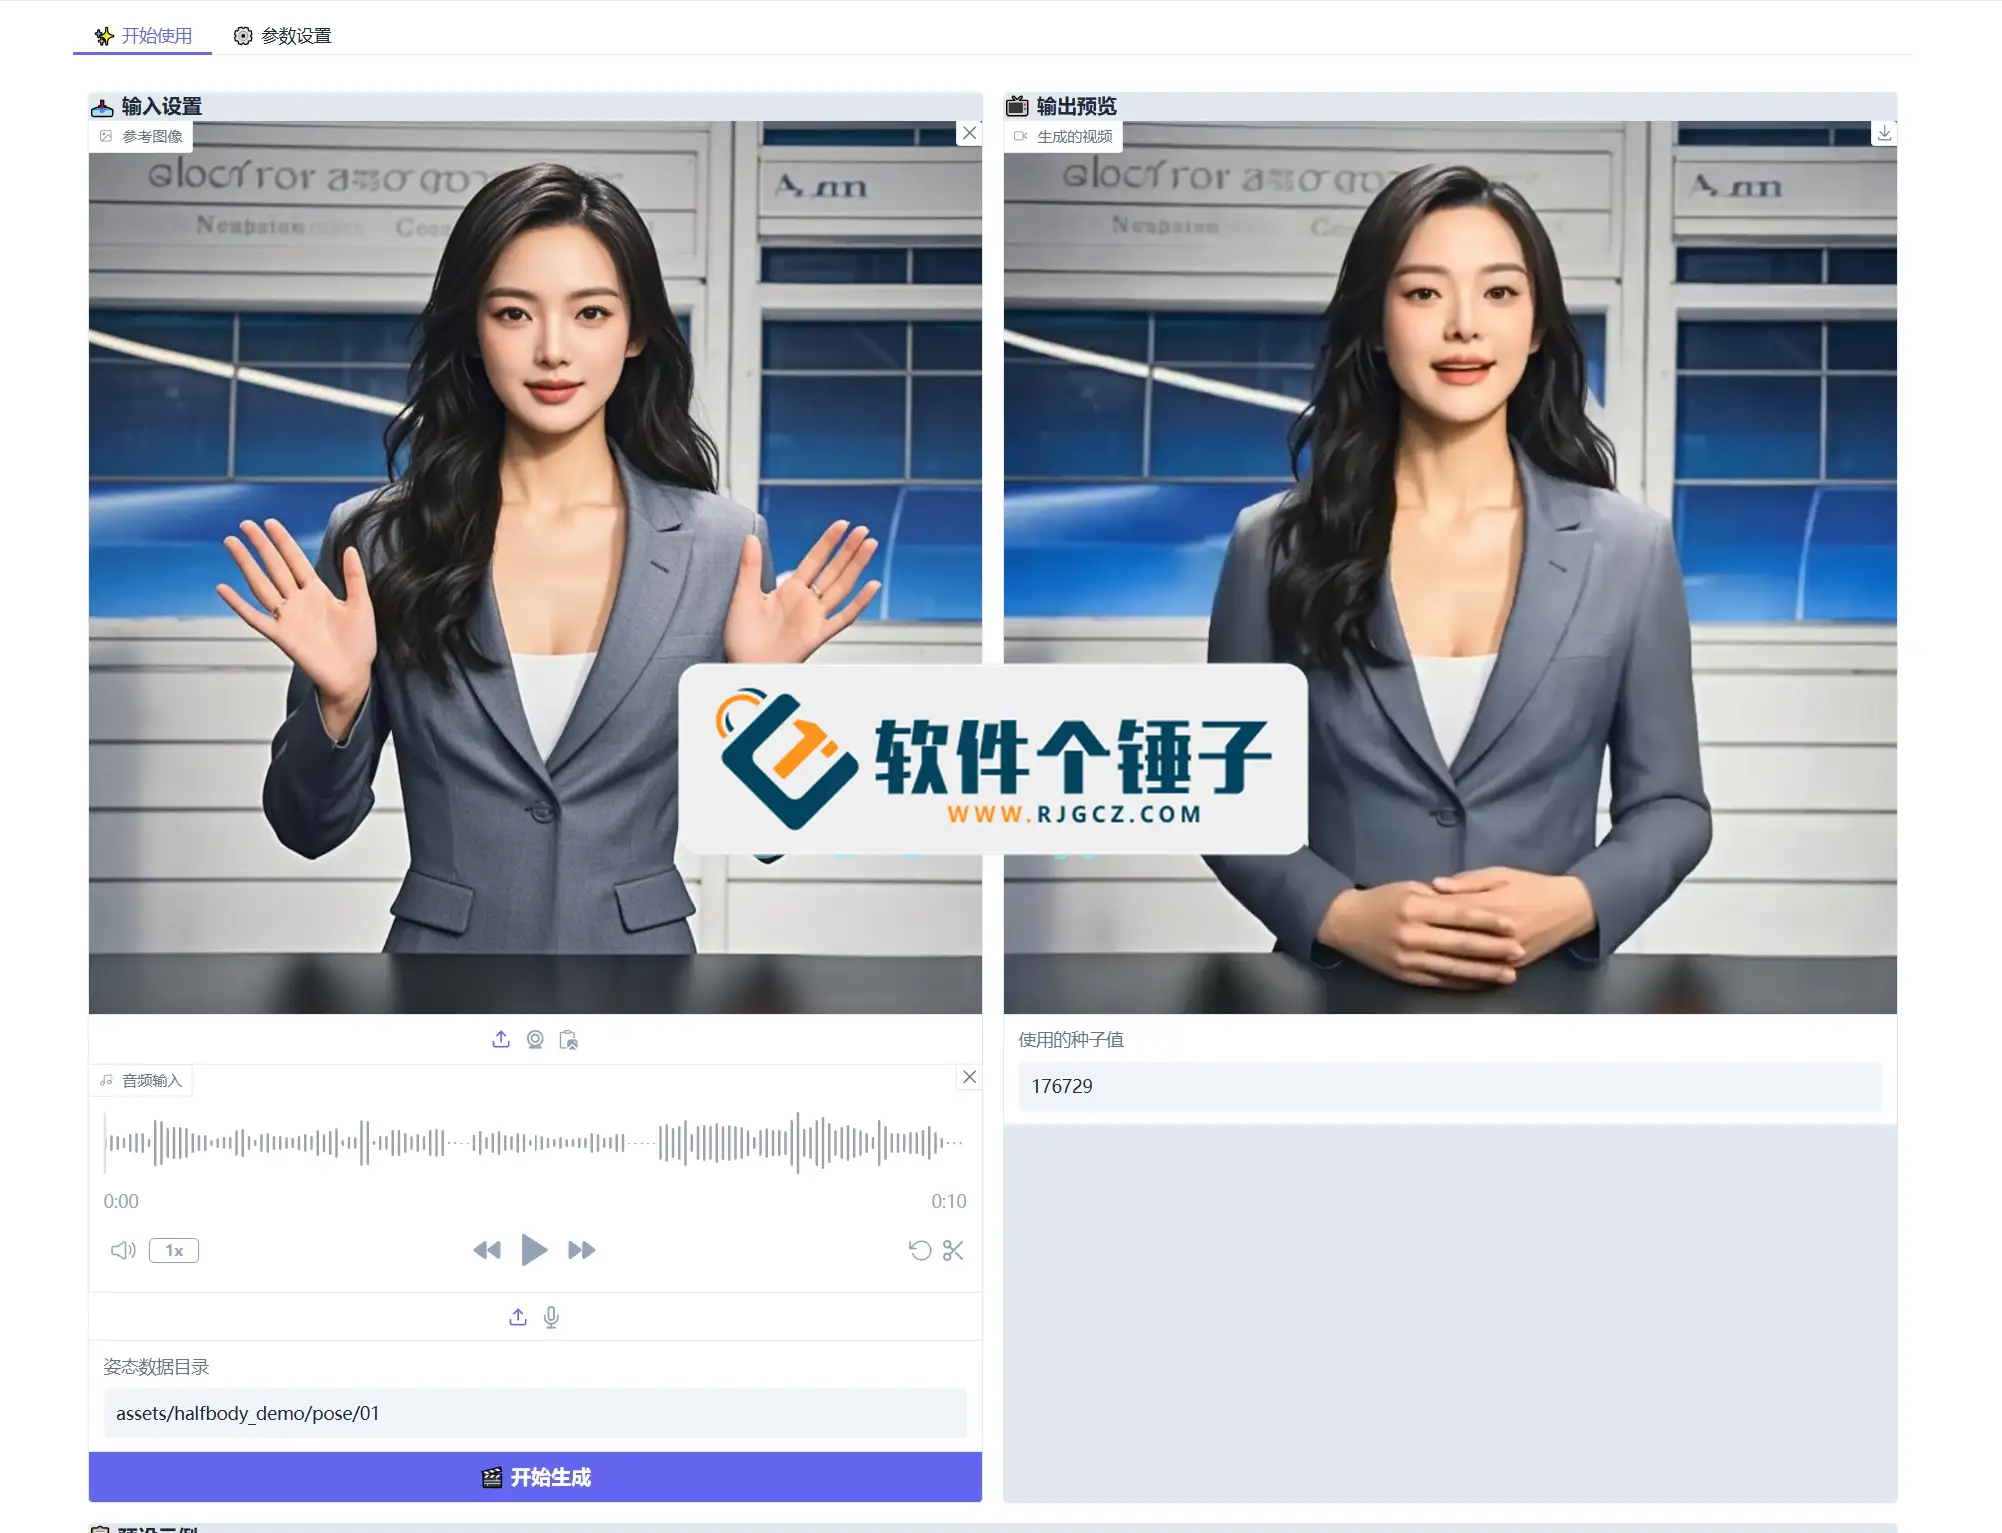
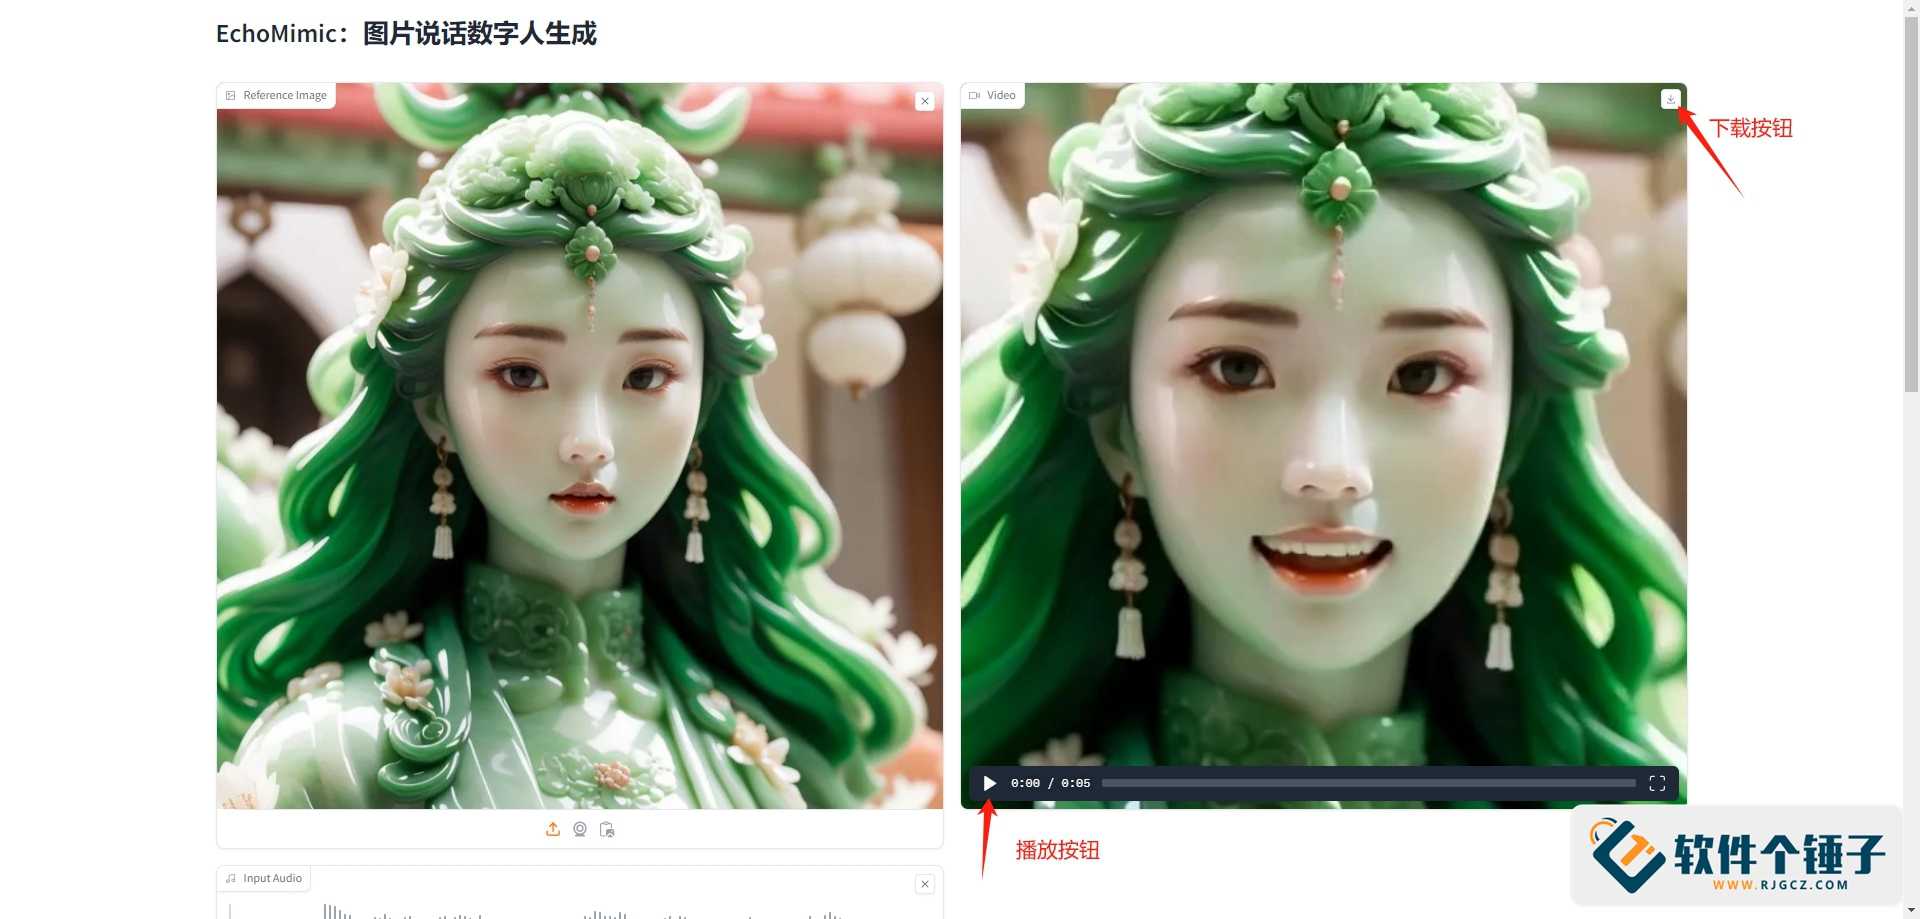
6. Al termine della generazione puoi visualizzare in anteprima e salvare il video.
Guida operativa alla versione V1
1. Dopo l'estrazione fai doppio clic su "Avvio con un clic.exe" per aprire l'interfaccia operativa nel browser.

2. Carica la foto del volto e il file audio, regola i parametri (come la durata del video, predefinita entro 50 secondi) oppure usa le impostazioni predefinite.

3. Fai clic su "Invia"; il risultato della generazione appare a destra, dove puoi visualizzarlo in anteprima e scaricarlo.

Nota: qualunque versione tu usi, assicurati che i percorsi e i nomi dei file non contengano caratteri cinesi per evitare errori di riconoscimento da parte del software.
Esempi ufficiali:
Indirizzo open source
– Versione V1: [https://github.com/BadToBest/EchoMimic](https://github.com/BadToBest/EchoMimic)
– Versione V2: [https://github.com/antgroup/echomimic_v2](https://github.com/antgroup/echomimic_v2)
Corsi correlati

Toolbox super locale! Con registrazione dello schermo integrata, taglio e unione di audio/video, compressione ed estrazione video, gratis per sempre - Kedou Video Converter

Strumento gratis perfetto al 100%%! Software PDF multifunzione tutto in uno: converti, comprimi, modifica PDF ecc., minimal, senza pubblicità, fantastico - JOPDF

Strumento di desktop remoto open source, superiore alle versioni a pagamento! Gratuito e illimitato per uso personale e commerciale, multipiattaforma – HopToDesk

Ultimo strumento di download di libri di testo per scuola elementare e media: download delle risorse di un intero anno, slide, video e audio con un clic

Tutto il giorno davanti allo schermo, senza uno strumento di protezione per gli occhi? Ecco l'app gratuita anti-luce blu per PC, con un animale che ti ricorda di riposare. Huyanbao

PyIsland: centro di controllo di sistema moderno con Dynamic Island sul desktop Windows

Produzione di drammi anime 3D simulati: pratica completa con Seedance 2.0, ti guida da 0 a 1 nella creazione di drammi anime di alta qualità

Compatibile Win/Mac! Ultima versione a vita: ripristina vecchie foto, migliora la nitidezza e ingrandisci senza perdita - Aiarty Image Enhancer

Tool di download Bilibili open source su Github: download in batch di video Bilibili con supporto 8K e Dolby Vision, semplice, Bilidown

Collezione di strumenti desktop Windows: 50+ widget pratici ed essenziali, con screenshot, registrazione, traduzione, meteo ecc. – toolbox Duomi

