


-
Cursos de negócio solo
-
 Outros
-
Tutoriais no exterior
-
Fotografia & Edição
-
Comunidade & Domínio privado
-
Escrita & Copywriting para mídias
-
Projetos de renda extra
-
Comércio eletrônico
-
Vídeo curto & Transmissão ao vivo
-
Inteligência Artificial (IA)
-
Software & Ferramentas
-
Sistemas operacionais
-
Plugins & Scripts
-
Software MacOS
-
Software Android
-
Software Windows

IA que gera um humano digital falante a partir de uma imagem, com suporte a foto de meio corpo EchoMimic V2, gratuito e de código aberto do Alibaba DAMO Academy, inicialização com um clique, sem necessidade de implantação ou licença [Software Ge Chui Z...
-
Plano de Renda com Farm de Ouro em Jogos: ganhe mais de mil por dia, um projeto estável de 3 anos que qualquer pessoa faz no tempo livre
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Curso SOP sistemático de mangá-drama de IA: seleção de webnovels, roteiro, texto para imagem, imagem para vídeo, dublagem e edição – tutorial padronizado de ponta a ponta (atual. 26/08)
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Farming automatizado de jogos populares: 500+/dia, sem experiência, simples – o extra estável a longo prazo mais fiável [Revelado]
Material de estudo de referência — incluído com a assinatura Obter assinatura -
ShuShu desta vez se safou! Não entre em pânico com problemas de formato do Windows: a ferramenta de código aberto ShuShu Format Converter, uma joia popular no GitHub
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Campo de acompanhamento de vendas no Douyin: sem aparecer, iniciantes copiam modelos e produzem vídeos
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Plano de renda com farming de jogos no lançamento: mais de 1.000 por dia, viável para pessoas comuns no tempo livre! [Revelado]
Material de estudo de referência — incluído com a assinatura Obter assinatura






-
ShuShu desta vez se safou! Não entre em pânico com problemas de formato do Windows: a ferramenta de código aberto ShuShu Format Converter, uma joia popular no GitHub
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Lu Master v6.1024.4105.1121, versão enxuta em arquivo único【Software Ge Chui Zi·R1880】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Software de criação de animação de cartoon 2D Moho Pro v14.3 [Software Ge Chuzi · R2355]
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Software de edição e processamento de vídeo para computador Aiseesoft Filmai v1.0.18 【Software Ge Chuzi·R2470】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Microsoft To Do v2.147 Versão oficial gratuita【Software Ge Chuizi·R2618】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Plugin de osciloscópio de correção de cor de vídeo para PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Ge Chui Zi·R2748】
Material de estudo de referência — incluído com a assinatura Obter assinatura





EchoMimic é uma tecnologia avançada de IA desenvolvida pelo Alibaba DAMO Academy, capaz de gerar automaticamente, a partir de um arquivo de áudio e de uma foto de rosto, um vídeo com animação labial perfeitamente sincronizada com o conteúdo do áudio. Essa tecnologia é amplamente utilizada em entretenimento, educação, realidade virtual e reuniões online, entre outras áreas, proporcionando ao usuário uma experiência inovadora.
Atualmente, a versão EchoMimic V2 já foi lançada; a nova versão suporta o envio de fotos de meio corpo e gera humanos digitais de meio corpo mais vivos, tornando os cenários de aplicação mais diversificados.
Principais funções
– Sincronização labial precisa
Por meio da análise do conteúdo do áudio e dos pontos faciais, gera um efeito de vídeo totalmente compatível com o ritmo e o conteúdo da fala.
– Animação natural e realista
A tecnologia suporta movimentos faciais e mudanças de expressão naturais; a animação gerada tem forte realismo, próxima à atuação de uma pessoa real.
– Suporte a idiomas e múltiplos estilos
Seja mandarim, inglês ou estilo de canto, o EchoMimic alcança efeitos de sincronização de alta qualidade, atendendo a necessidades diversificadas.
Cenários de uso
– Área de entretenimento
Gera animações de diálogo sincronizadas para personagens de filmes, TV e jogos, aumentando a imersão do espectador.
– Setor educacional
Produz vídeos de ensino interativos, tornando o aprendizado mais vivo e interessante e melhorando a qualidade da educação.
– Realidade virtual (VR)
Gera animações realistas de personagens virtuais, aumentando a imersão do usuário em ambientes de VR.
– Reuniões online
Gera animações de lábios sincronizadas para reuniões remotas, aumentando o realismo da comunicação.
– Realidade aumentada (AR)
Cria personagens virtuais extremamente realistas em aplicações de AR, enriquecendo a experiência interativa.
Requisitos de configuração do sistema
– Sistema operacional: Windows 10/11 64 bits
– Requisitos de placa de vídeo:
– Versão V1: placa NVIDIA com pelo menos 8 GB de memória de vídeo
– Versão V2: pelo menos 12 GB de memória de vídeo, recomendando-se 16 GB ou mais para garantir a operação estável (quanto mais forte a placa, mais rápida a geração)
– Dependência de software: CUDA ≥ 12.4
– Espaço de armazenamento: cerca de 19,8 GB após a descompactação
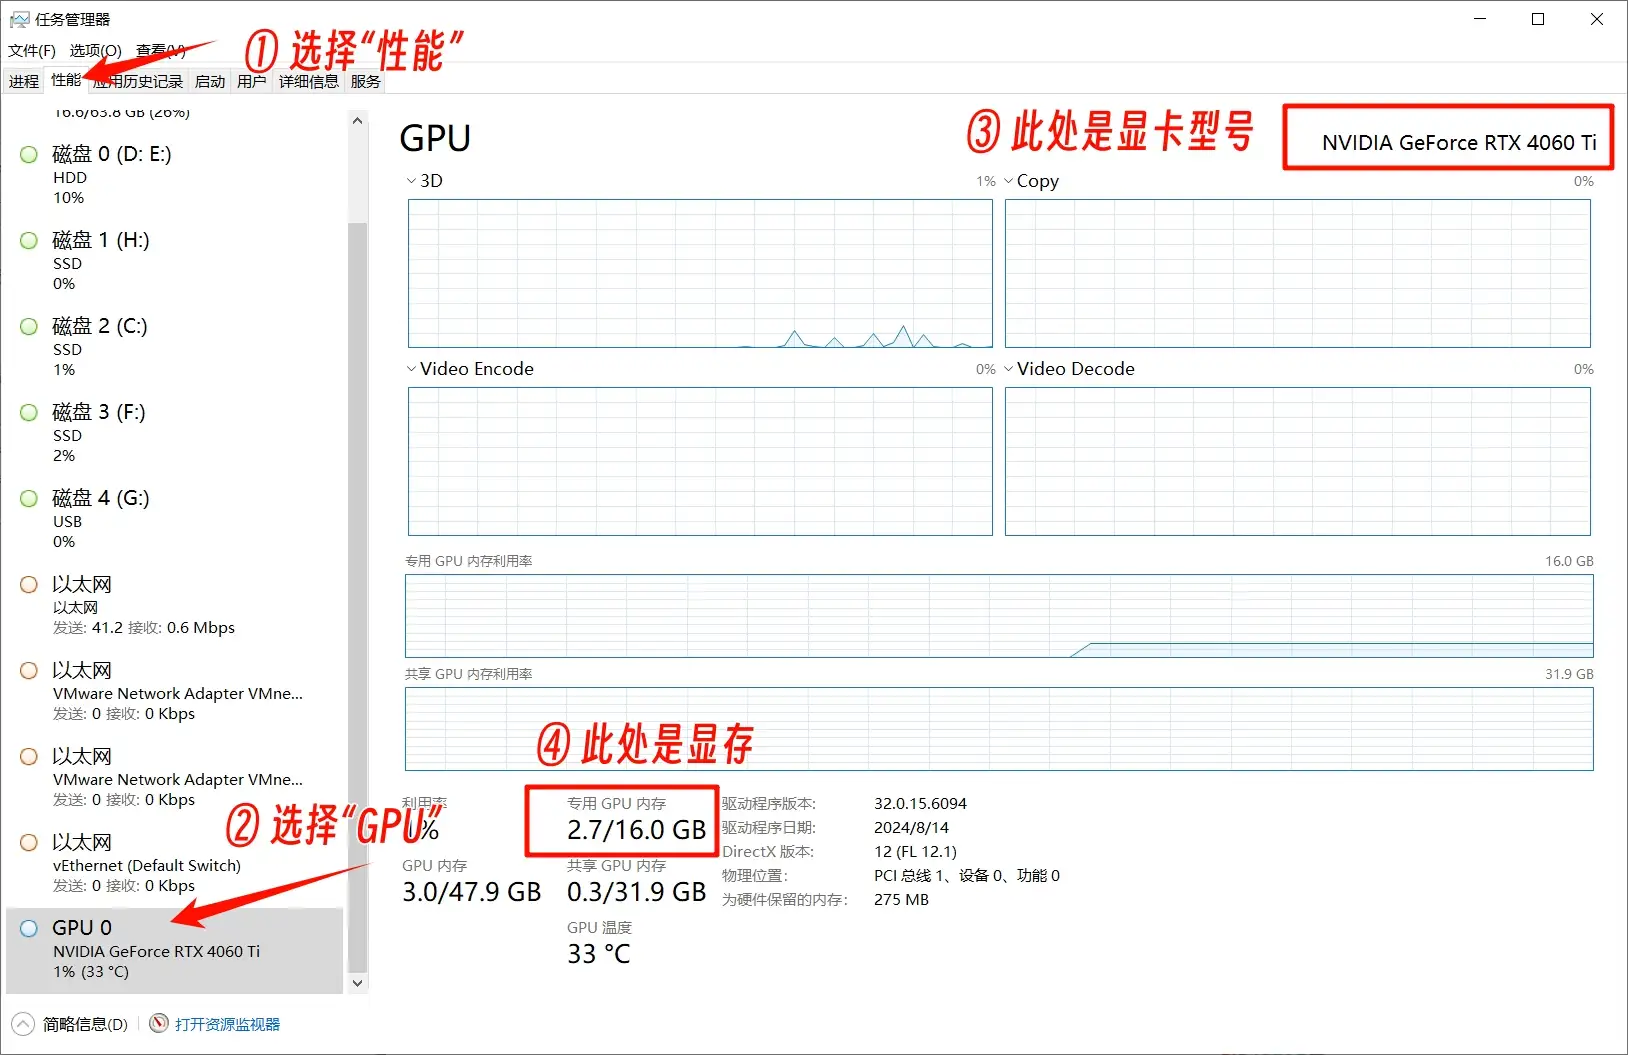
– Como ver as informações da placa de vídeo:
1. Abra o Gerenciador de Tarefas
2. Clique na guia "Desempenho"
3. Na área "GPU", veja o modelo da placa de vídeo e o tamanho da memória de vídeo

Para o tutorial detalhado de instalação do CUDA, acesse: [
Tutorial de uso
Guia de operação da versão V2
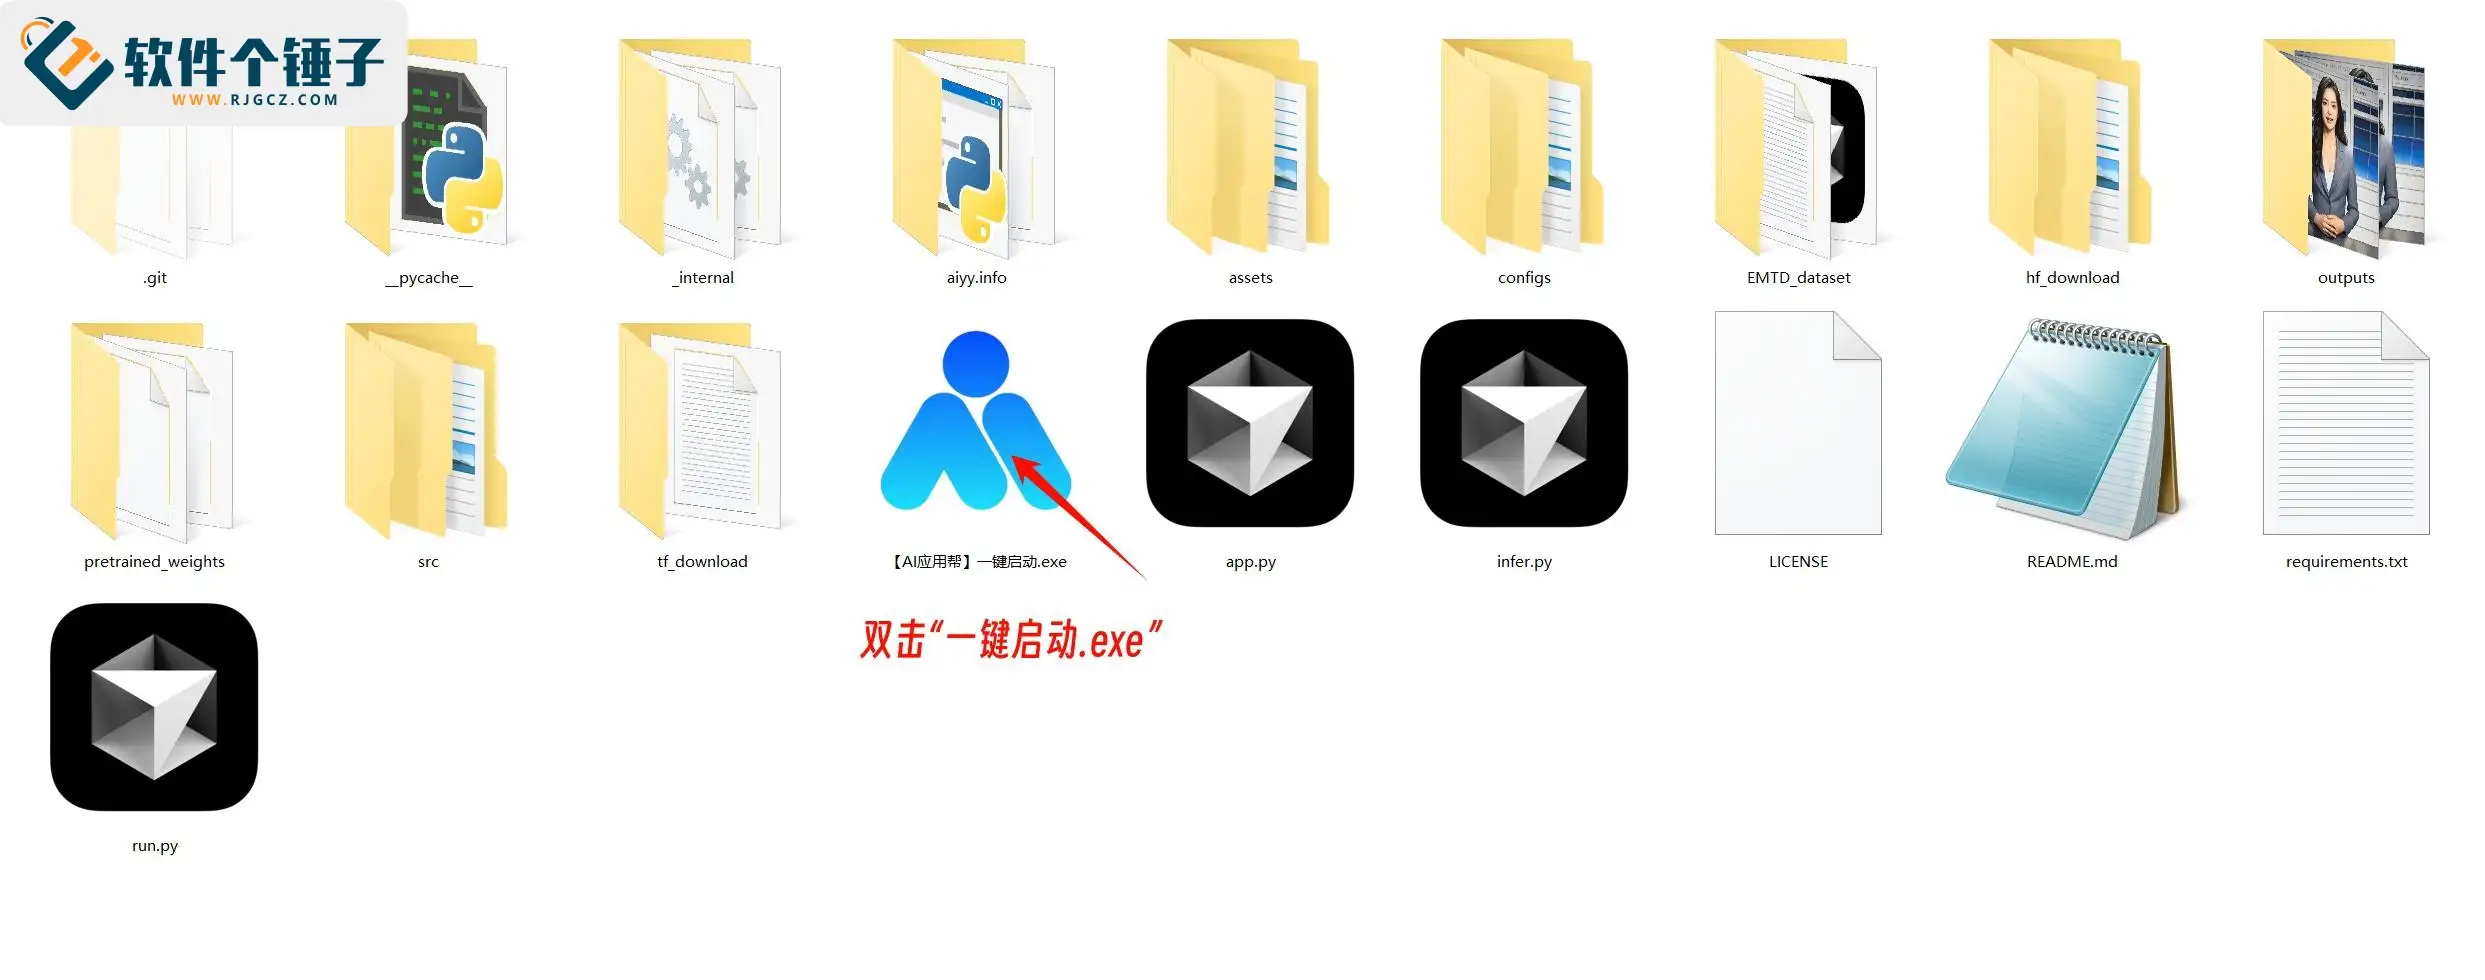
1. Descompacte o pacote integrado baixado e certifique-se de que as pastas e os nomes dos arquivos não contenham caracteres chineses (incluindo arquivos de imagem e áudio).

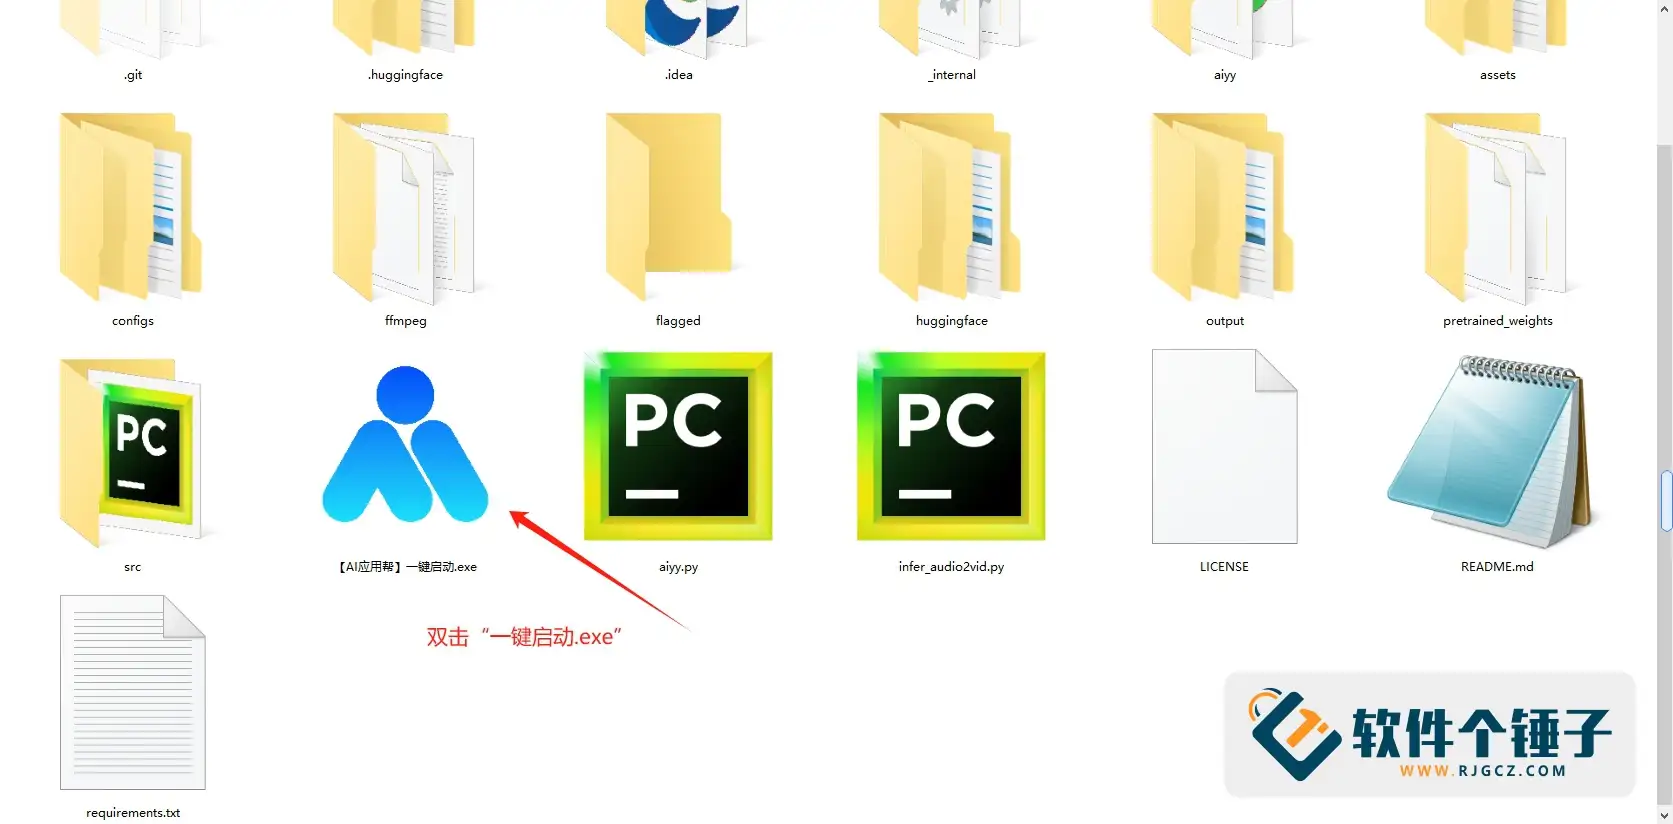
2. Dê um duplo clique em "inicialização com um clique.exe" e aguarde um momento; o navegador abrirá automaticamente a interface de operação.

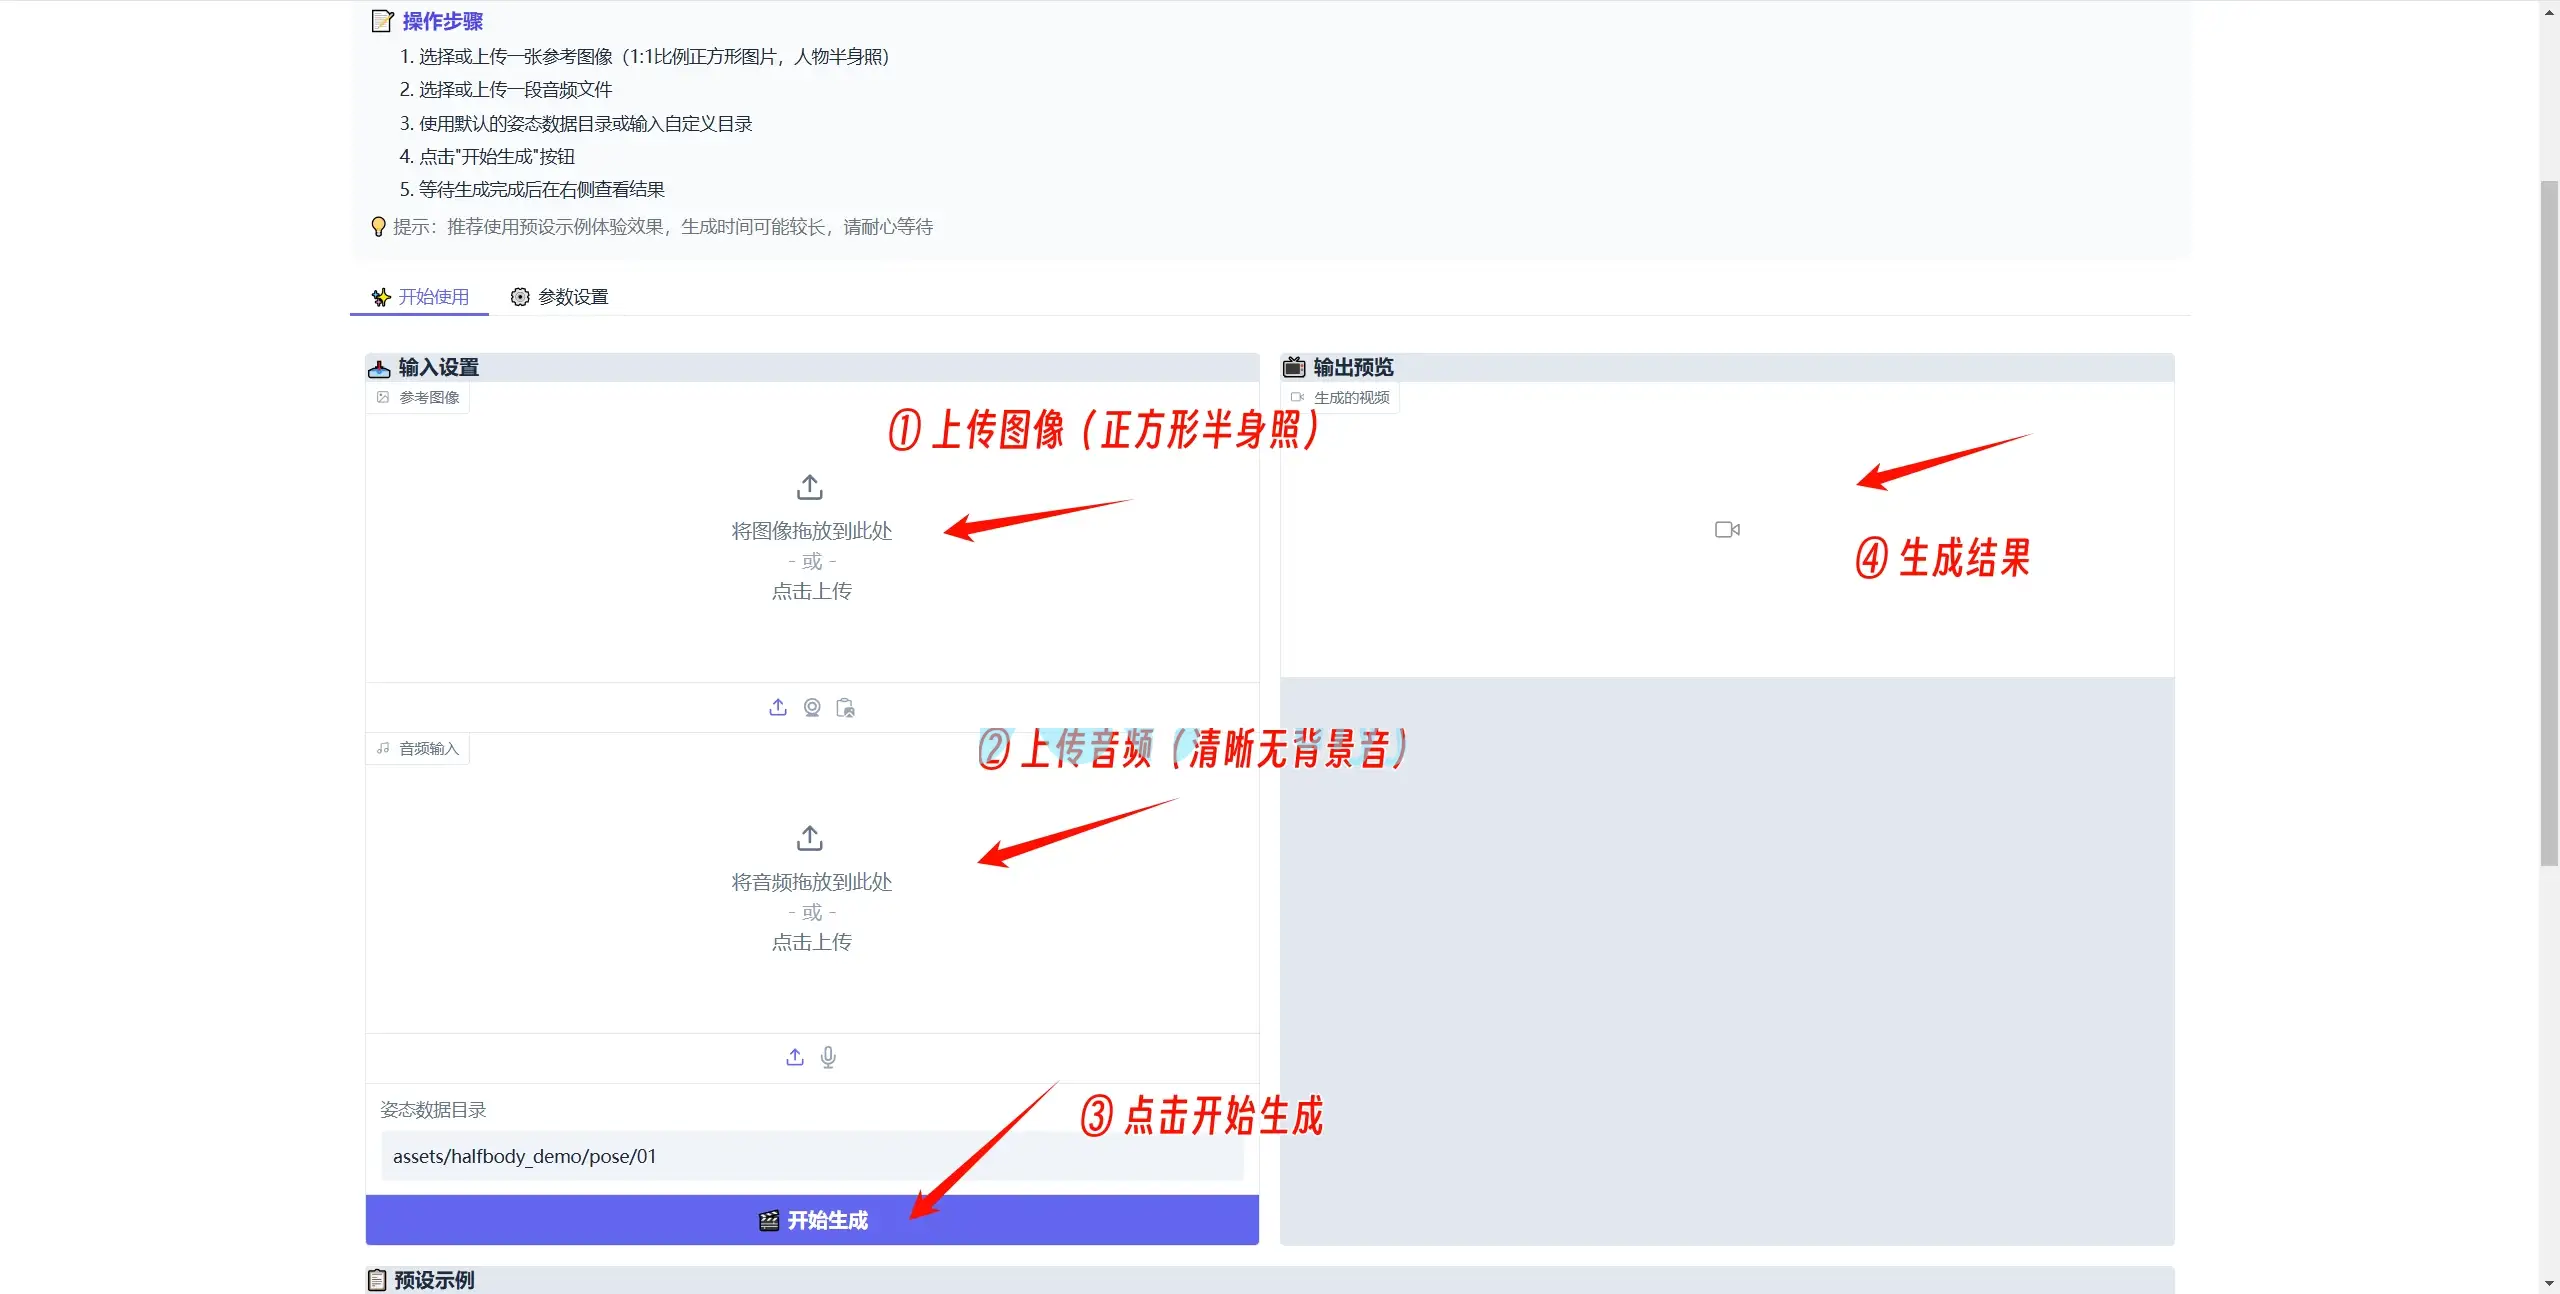
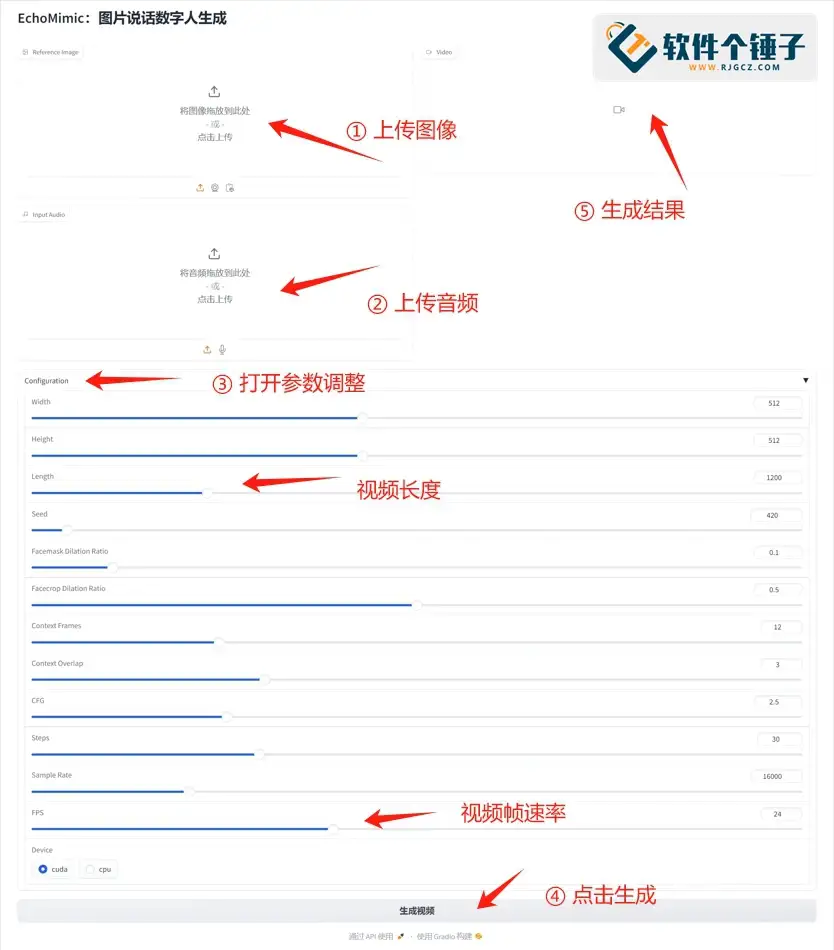
3. Envie uma foto frontal do rosto da pessoa na proporção quadrada 1:1, garantindo que os traços faciais estejam nítidos e que o material atenda aos requisitos (veja os exemplos no final da página).
4. Envie o arquivo de áudio; recomenda-se usar áudio apenas com voz humana, removendo a música de fundo.

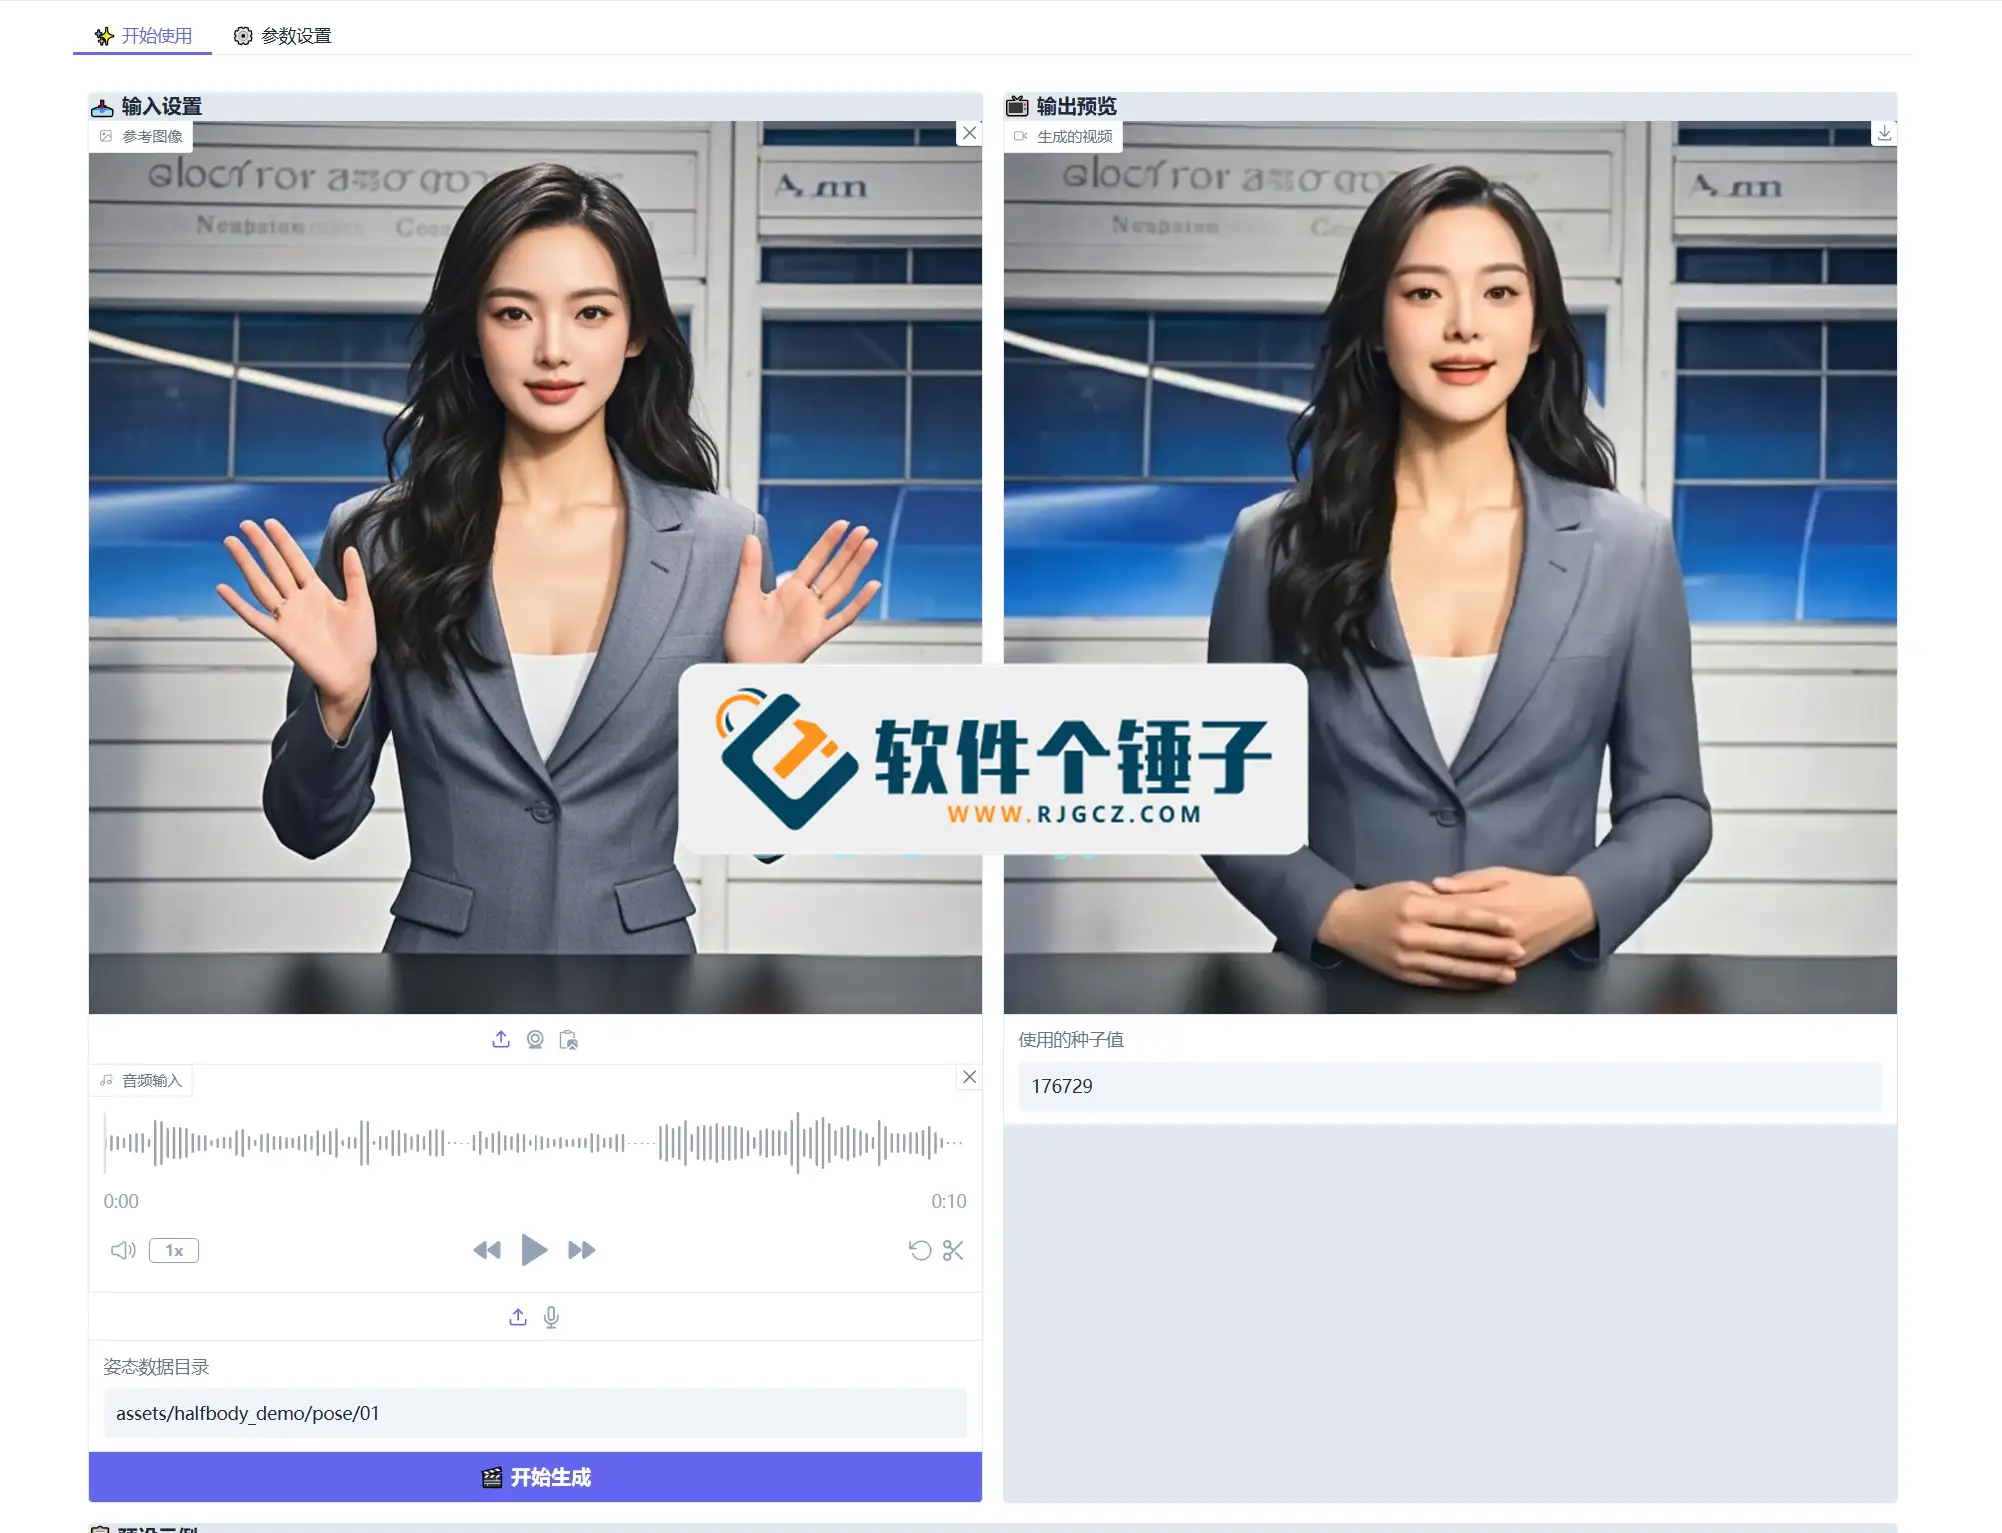
5. Clique em "Iniciar geração" e aguarde com paciência a conclusão (por exemplo: com uma placa 4060Ti 16G, gerar 1 segundo de vídeo leva cerca de 5 minutos).

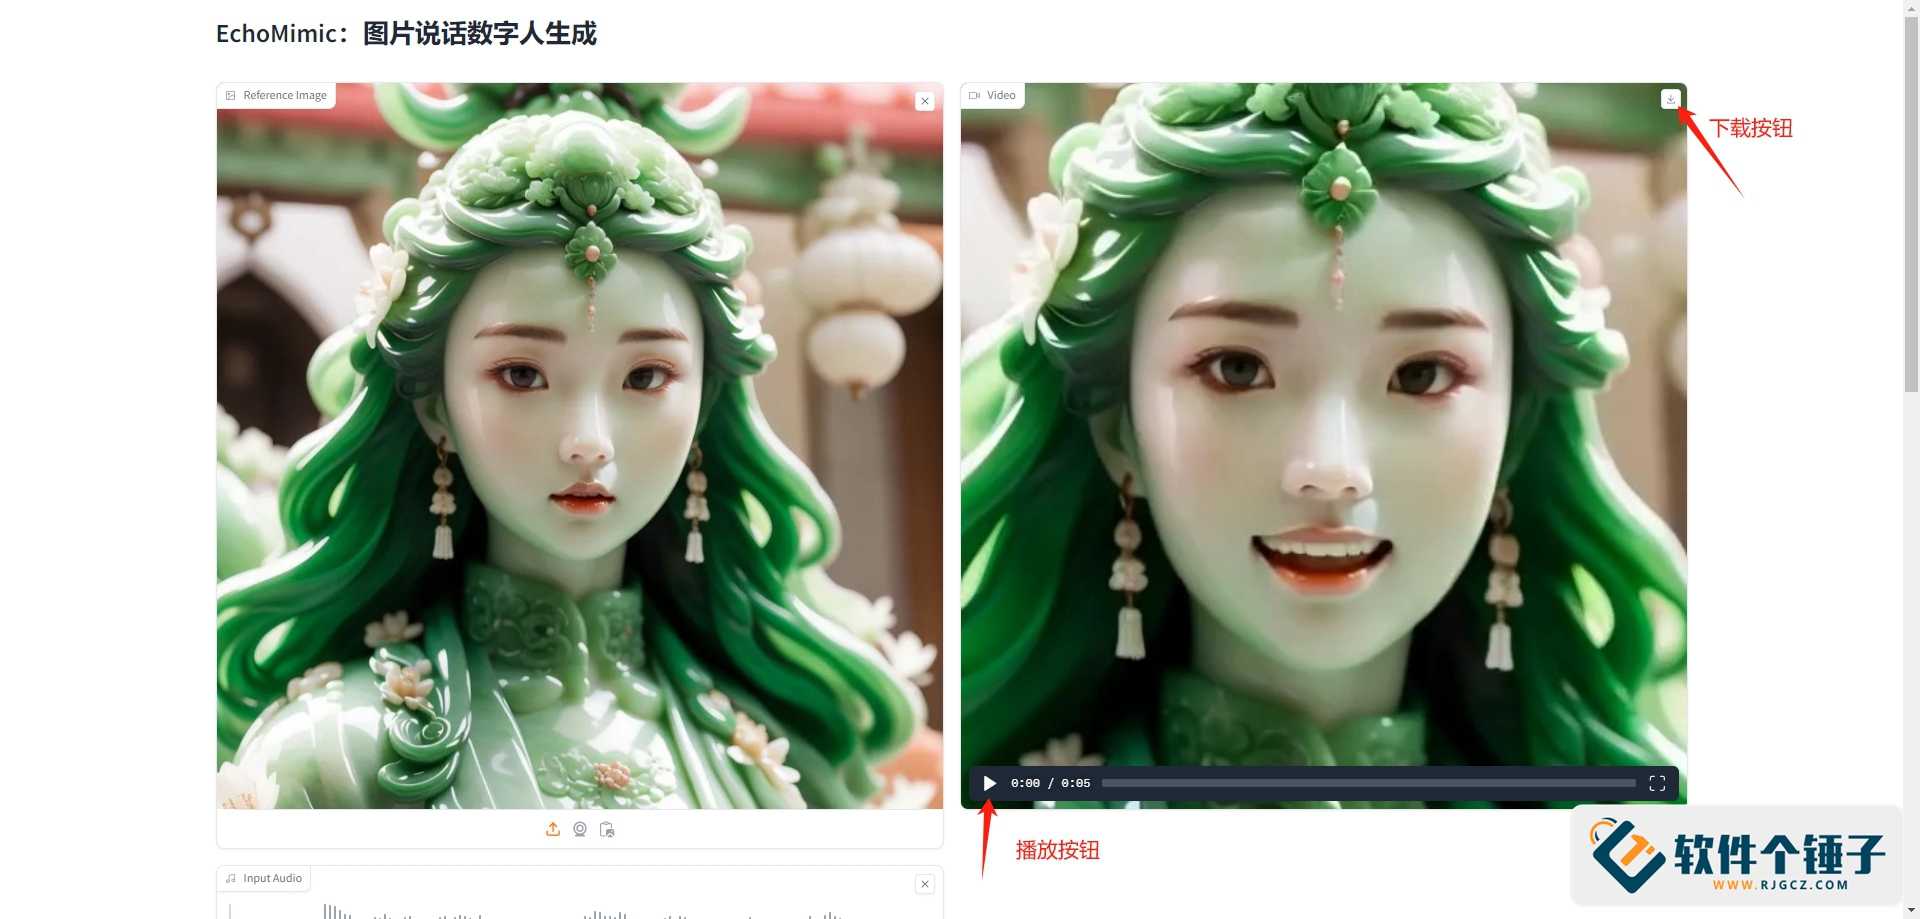
6. Após a geração, é possível pré-visualizar e salvar o vídeo.
Guia de operação da versão V1
1. Após descompactar, dê um duplo clique em "inicialização com um clique.exe" para abrir a interface de operação no navegador.

2. Envie a foto do rosto e o arquivo de áudio, ajuste os parâmetros (como a duração do vídeo, padrão de até 50 segundos) ou use as configurações padrão.

3. Clique em "Enviar"; o resultado da geração aparece à direita, com opção de pré-visualização e download.

Atenção: independentemente da versão usada, certifique-se de que o caminho e o nome dos arquivos não contenham caracteres chineses, para evitar erros de reconhecimento do software.
Exemplos oficiais:
Endereço do projeto de código aberto
– Versão V1: [https://github.com/BadToBest/EchoMimic](https://github.com/BadToBest/EchoMimic)
– Versão V2: [https://github.com/antgroup/echomimic_v2](https://github.com/antgroup/echomimic_v2)
Cursos relacionados

Poderosa caixa de ferramentas local! Gravação de tela, corte/fusão de áudio e vídeo, compressão/extração de vídeo, etc., gratuito permanente – Kedou Video Converter Master

100% perfeito e grátis! Software PDF tudo-em-um: conversão, compressão, edição, etc., limpo sem anúncios – JOPDF

Ferramenta de desktop remoto de código aberto, superior às versões pagas! Gratuita e ilimitada para uso pessoal e comercial, multiplataforma – HopToDesk

Ferramenta mais recente para baixar livros didáticos do ensino fundamental e médio: recursos de um ano inteiro, slides, vídeos e áudios com um clique

O dia todo olhando para a tela, como ficar sem uma ferramenta de proteção ocular? Aplicativo gratuito de proteção contra luz azul para PC, com um pet que te lembra de descansar na hora certa, Huyanbao

PyIsland: centro de controle do sistema moderno com Dynamic Island na área de trabalho do Windows

Produção de manhuá 3D simulado: prática completa do Seedance 2.0, do zero à criação de manhuá de alta qualidade

Compatível com Win/Mac! Última versão vitalícia: restaure fotos antigas, melhore a nitidez e amplie sem perda - Aiarty Image Enhancer

Ferramenta de download de Bilibili de código aberto no Github: download em lote de vídeos de Bilibili com suporte a 8K e Dolby Vision, fácil de usar, Bilidown

Coleção de ferramentas de desktop Windows! 50+ widgets de desktop práticos e minimalistas, com captura de tela, gravação de tela, tradução, previsão do tempo etc., caixa de ferramentas Duomi

Contact Info
- E-mail: massivesidehustles@outlook.com
