-
उद्यमी कोर्स
-
 अन्य
-
विदेशी ट्यूटोरियल
-
फ़ोटोग्राफ़ी और एडिटिंग
-
कम्युनिटी और प्राइवेट डोमेन
-
सेल्फ-मीडिया लेखन और कॉपीराइटिंग
-
साइड इनकम प्रोजेक्ट्स
-
ई-कॉमर्स
-
शॉर्ट वीडियो और लाइव स्ट्रीमिंग
-
आर्टिफिशियल इंटेलिजेंस (AI)
-
सॉफ्टवेयर और टूल्स
-
ऑपरेटिंग सिस्टम
-
प्लगइन और स्क्रिप्ट
-
MacOS सॉफ्टवेयर
-
Android सॉफ्टवेयर
-
Windows सॉफ्टवेयर
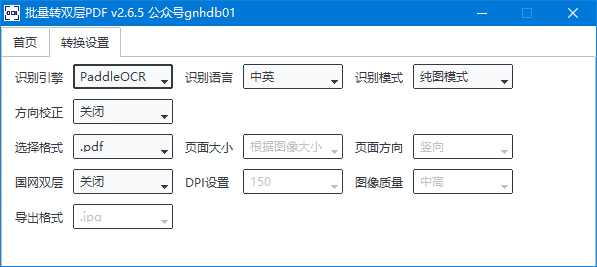
बैच टू डबल-लेयर PDF सॉफ़्टवेयर v3.0.8 विभिन्न भाषाओं की पहचान का समर्थन करता है [सॉफ़्टवेयर गे हथौड़ा·R4747]
-
गेम गोल्ड-फ़ार्मिंग कमाई योजना: रोज़ाना 1k+ कमाएँ, तीन साल से स्थिर प्रोजेक्ट, ख़ाली समय में कोई भी कर सकता है
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
हॉट-गेम पूर्ण-स्वचालित कमाई: प्रतिदिन 500+, कोई अनुभव नहीं, सरल संचालन - सबसे स्थिर दीर्घकालिक गेम-कमाई साइड हैंसल (खुलासा)
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
चूहा इस बार योग्यता कमाता है! Windows फ़ॉर्मैट समस्याओं पर घबराएं नहीं - ओपन-सोर्स FlyingMouse फ़ॉर्मैट-कन्वर्ज़न टूल मदद करता है, एक लोकप्रिय GitHub रत्न
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
Douyin प्रोडक्ट-सेलिंग बूटकैंप विद कोचिंग: कैमरे पर न हों ज़रूरी, नए लोग स्टेप्स फॉलो कर सेलिंग शॉर्ट वीडियो बनाएँ
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
फ़र्स्ट-रिलीज़ गेम गोल्ड-फ़ार्मिंग मनी प्लान: दिन में 1K+, फ़ुरसत में आम लोग
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें






-
चूहा इस बार योग्यता कमाता है! Windows फ़ॉर्मैट समस्याओं पर घबराएं नहीं - ओपन-सोर्स FlyingMouse फ़ॉर्मैट-कन्वर्ज़न टूल मदद करता है, एक लोकप्रिय GitHub रत्न
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
लू दाशी v6.1024.4105.1121 स्लिम सिंगल-फ़ाइल संस्करण [सॉफ़्टवेयर एक हथौड़ा - R1880]
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
2D कार्टून एनिमेशन निर्माण सॉफ़्टवेयर Moho Pro v14.3 [सॉफ़्टवेयर गे हथौड़ा·R2355]
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
कंप्यूटर संस्करण वीडियो संपादन प्रसंस्करण सॉफ़्टवेयर Aiseesoft Filmai v1.0.18 【सॉफ़्टवेयर गेज़ हथौड़ा·R2470】
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
Microsoft To Do v2.147 आधिकारिक मुफ़्त संस्करण【सॉफ़्टवेयर गे चुइज़ी·R2618】
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें -
PR/AE/दा विंची/FCPX वीडियो कलर ग्रेडिंग ऑसिलोस्कोप प्लगइन Nobe OmniScope Win1.11.15 / Mac1.10.138【सॉफ़्टवेयर गे हमर·R2748】
संदर्भ अध्ययन सामग्री — सदस्यता में शामिल सदस्य बनें





बैच टू डबल-लेयर PDF सॉफ़्टवेयर एक ऐसा उपकरण है जो विशेष रूप से उस तरह की "छवि-आधारित" सिंगल-लेयर PDF फ़ाइलों को डबल-लेयर PDF फ़ाइलों में बदलने के लिए उपयोग किया जाता है, जिनमें आप मूल रूप देख सकते हैं और साथ ही टेक्स्ट खोज और कॉपी भी कर सकते हैं। इस तरह से परिवर्तित PDF न केवल मूल स्कैन की तरह दिखती है, बल्कि इसमें एक छिपी हुई टेक्स्ट परत भी जुड़ जाती है जिससे आप खोज, चयन और कॉपी कर सकते हैं। यह सुविधा बहुत ही उपयोगी है, यह आपके दस्तावेज़ प्रबंधन और जानकारी खोजने की दक्षता को बहुत बढ़ा सकती है।

यह विशेष रूप से क्या-क्या कर सकता है? मुख्य सुविधाओं का अवलोकन
इस सॉफ़्टवेयर की कार्यक्षमता "रूपांतरण" और "पहचान" के इर्द-गिर्द घूमती है, और यह बहुत शक्तिशाली है:
- बैच प्रोसेसिंग से समय की बचत: यह एक साथ दर्जनों या सैकड़ों PDF फ़ाइलों को रूपांतरण के लिए आयात करने का समर्थन करता है, एक-एक करके मैन्युअल रूप से काम करने की ज़रूरत नहीं, कार्य कुशलता सीधे अधिकतम हो जाती है।
- स्मार्ट OCR टेक्स्ट पहचान: उन्नत ऑप्टिकल कैरेक्टर रिकग्निशन तकनीक का उपयोग करके, यह छवियों में टेक्स्ट का स्वचालित रूप से विश्लेषण करता है, फिर एक पारदर्शी टेक्स्ट लेयर बनाता है जिसे आप चुन और खोज सकते हैं, और छवि के ऊपर रख देता है।
- बहुत सारे फ़ॉर्मेट का समर्थन: यह न केवल PDF फ़ाइलों को संभाल सकता है, बल्कि JPEG, PNG जैसे सामान्य छवि फ़ॉर्मेट भी सीधे आयात और रूपांतरित किए जा सकते हैं, जो बहुत सुविधाजनक है।
- पैरामीटर स्वयं समायोजित कर सकते हैं: उपयोगकर्ता अपनी आवश्यकताओं के अनुसार आउटपुट PDF की गुणवत्ता, पृष्ठ आकार, फ़ॉन्ट एम्बेड करना है या नहीं, आदि विभिन्न पैरामीटर समायोजित कर सकते हैं, जो बहुत लचीला है।
- कई भाषाओं को पहचान सकता है: यह कई भाषाओं के दस्तावेज़ों को पहचान और रूपांतरित कर सकता है, जैसे चीनी, अंग्रेज़ी, जापानी आदि, जिससे विभिन्न उपयोगकर्ताओं की आवश्यकताएं पूरी होती हैं।
उपयोग करने में कैसा लगता है? ये विशेषताएं बहुत फ़ायदेमंद हैं
कठिन कार्यक्षमताओं के अलावा, इसका उपयोग अनुभव भी अच्छा है:
- पहचान की सटीकता बहुत उच्च: उन्नत OCR तकनीक का उपयोग किया गया है, जो रूपांतरण के बाद टेक्स्ट लेयर की उच्च सटीकता सुनिश्चित करता है, जिससे आपको मैन्युअल रूप से प्रूफ़रीडिंग और संशोधन करने का काम बहुत कम हो जाता है।
- प्रोसेसिंग की गति तेज़: एल्गोरिदम को अनुकूलित किया गया है, रूपांतरण की गति बहुत तेज़ है, भले ही आप एक बार में बहुत सारी फ़ाइलें इसे दे दें, यह तेज़ी से आपका काम पूरा कर देगा।
- इंटरफ़ेस मित्रवत और उपयोग में आसान: ऑपरेशन इंटरफ़ेस सरल और सहज डिज़ाइन किया गया है, इस प्रकार के सॉफ़्टवेयर का पहली बार उपयोग करने वाला नौसिखिया उपयोगकर्ता भी आसानी से इसे संभाल सकता है।
- गोपनीयता और सुरक्षा पर ध्यान: रूपांतरण प्रक्रिया के दौरान आपके दस्तावेज़ों की गोपनीयता की रक्षा करता है, सभी प्रोसेसिंग स्थानीय रूप से होती है, जिससे आपकी फ़ाइल डेटा सुरक्षा सुनिश्चित होती है।
- आउटपुट विकल्प बहुत लचीले: यह समृद्ध आउटपुट सेटिंग विकल्प प्रदान करता है, आप विभिन्न उपयोग परिदृश्यों (जैसे ई-बुक बनाना, या महत्वपूर्ण अभिलेखों को संग्रहित करना) के अनुसार समायोजित कर सकते हैं, जो बहुत विचारशील है।
किन परिदृश्यों में इसकी आवश्यकता होती है?
यदि आपने नीचे दी गई इन स्थितियों का सामना किया है, तो यह सॉफ़्टवेयर शायद आपकी अनिवार्य आवश्यकता है:
- बहुत सारे स्कैन किए गए PDF दस्तावेज़ हैं: जैसे अभिलेखागार से स्कैन की गई किताबें, अनुबंध, चालान आदि, जिनमें से जल्दी से कीवर्ड खोजना चाहते हैं।
- शैक्षणिक शोध या कानूनी पेशेवर: जिन्हें अक्सर बड़ी मात्रा में साहित्य और मुकदमे की फाइलों में विशिष्ट सामग्री खोजनी पड़ती है।
- कार्यालय कर्मचारी या दस्तावेज़ प्रबंधक: जिन्हें पहाड़ जैसे कागज़ी दस्तावेज़ों को डिजिटल बनाना और उन्हें प्रबंधनीय व खोजने योग्य बनाना है।
- ई-बुक निर्माण के शौकीन: जो स्कैन की गई किताबों को सुंदर और पूर्ण-पाठ खोजने योग्य इलेक्ट्रॉनिक संस्करण में बनाना चाहते हैं।
- कोई भी व्यक्ति जो छवि PDF में "आँखें फाड़कर अक्षर ढूँढने" से थक चुका है।
सरल शब्दों में, यह किस समस्या का समाधान करता है?
सीधे शब्दों में कहें, यह सॉफ़्टवेयर आपकी उन "मृत" छवि PDF (जिन्हें केवल देखा जा सकता है, खोजा नहीं जा सकता) को "जीवित" खोजने योग्य PDF (जिन्हें देखा भी जा सकता है, खोजा और कॉपी भी किया जा सकता है) में बदलने में मदद करता है। यह शक्तिशाली बैच प्रोसेसिंग और OCR तकनीक के माध्यम से आपको अकुशल मैन्युअल सूचना पुनर्प्राप्ति कार्य से मुक्त करता है, चाहे व्यक्तिगत अध्ययन हो या टीम कार्यालय कार्य, दोनों में दक्षता में उल्लेखनीय वृद्धि करता है।
संबंधित कोर्स

Windows के लिए सुपर-हल्का C-ड्राइव मैनेजर! बेहद ख़ास: डिस्क विश्लेषण और सफ़ाई रिमाइंडर, 2MB का आकार, पूरी तरह मुफ़्त

बिना USB ड्राइव के रीइंस्टॉल! यह टूल नए लोगों को भी जल्दी Windows रीइंस्टॉल करने देता है, अनअटेंडेड सेटअप सपोर्ट, डेटा सुरक्षित—CmzPrep_Rev2

एक GitHub स्पीड-अप टूल! GitHub को तेज़ी से खोलें, सबसे तेज़ नोड का ऑटो-रिस्पॉन्स - एक हल्का ओपन-सोर्स टूल: Ghips

ईज़ीआरसी: बिना USB वन-क्लिक विंडोज़ रीइंस्टॉल, बैकअप-रिस्टोर सहित

Windows 10/11 अपडेट स्थायी रूप से ब्लॉक करें

Windows 7/10/11 सिस्टम अपडेट बंद करने का टूल आ गया! केवल 400KB, एक क्लिक में सिस्टम अपडेट बंद करें और अपडेट बहाल करें, छोटा और उपयोगी

फ़ाइलें बेतरतीब ढंग से मत हटाएं! C ड्राइव लाल होने का उपाय, गहन सफ़ाई + सिस्टम ऑप्टिमाइज़ेशन, Windows/macOS दोनों के लिए!

Office पूर्ण-स्वचालित वन-क्लिक डिप्लॉयमेंट इंस्टॉलर, 2024 तक, अनुकूलन योग्य घटक, अंतर्निहित सक्रियण, पूर्णतः मुफ़्त - Mocreak

विंडोज़ सिस्टम रीइंस्टॉल टूल, लोकल इमेज फ़ाइल इंस्टॉल और बैकअप सपोर्ट करता है, आसान, सुरक्षित और स्थिर, सभी परिदृश्यों में सपोर्ट

पीसी में छोटी-छोटी समस्याएं? नए लोगों के लिए ज़रूरी ड्राइवर मरम्मत टूल, एक क्लिक में ड्राइवर अपडेट और मरम्मत, बस इतना ही आसान!