-
Corsi per imprenditori solisti
-
 Altri
-
Tutorial esteri
-
Fotografia & Montaggio
-
Community & Dominio privato
-
Scrittura & Copywriting per media
-
Progetti di reddito extra
-
E-commerce
-
Video brevi & Live streaming
-
Intelligenza Artificiale (IA)
-
Software & Strumenti
-
Sistemi operativi
-
Plugin & Script
-
Software MacOS
-
Software Android
-
Software Windows
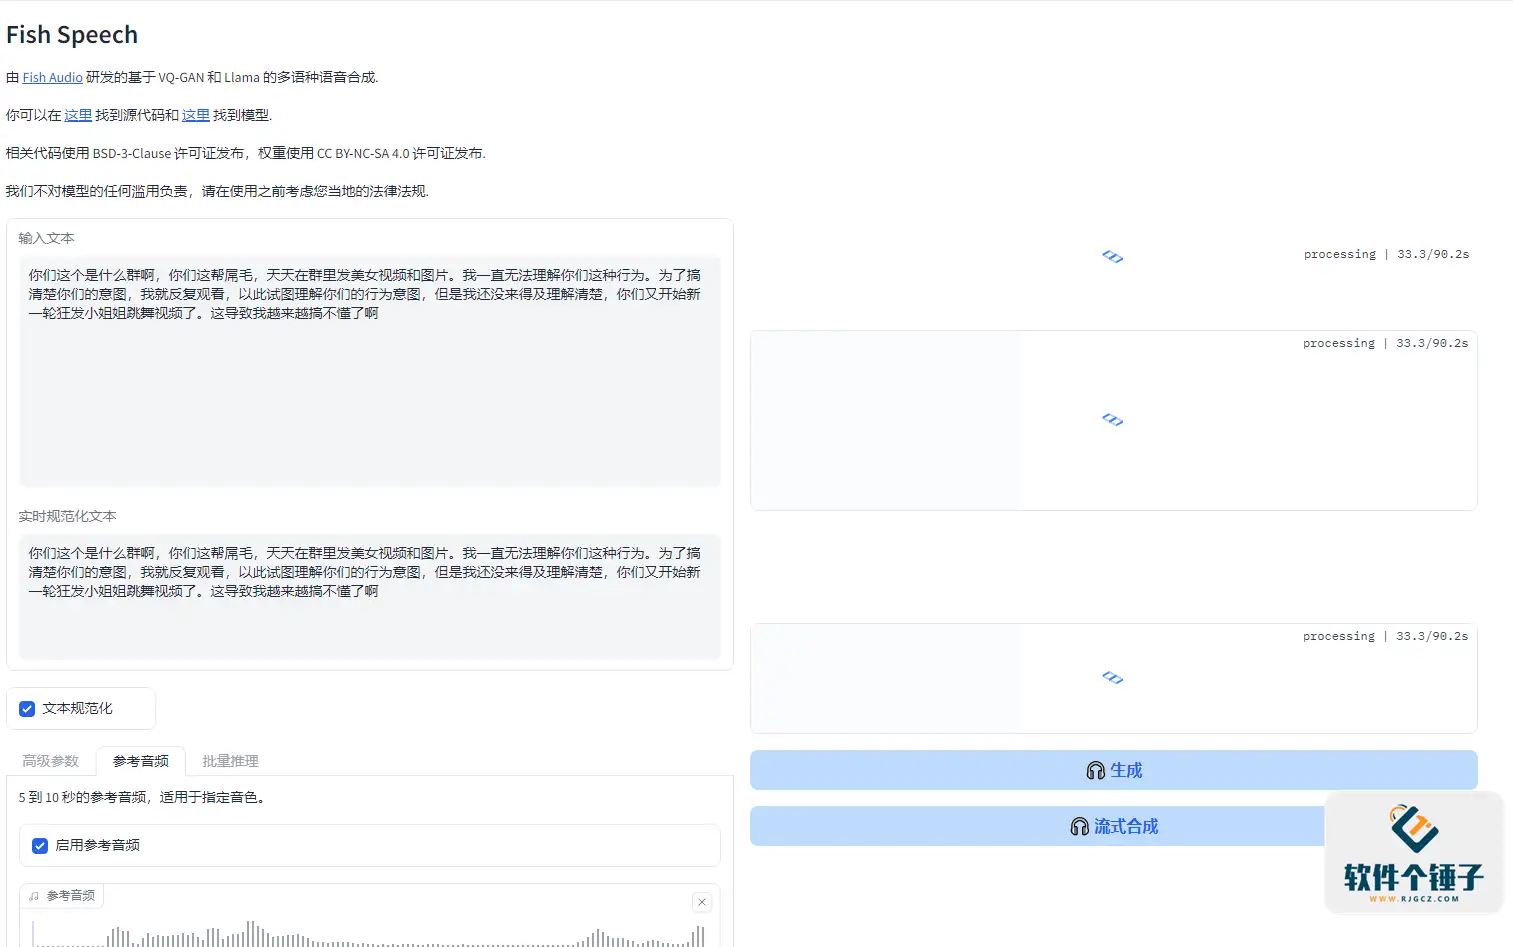

[R2341] Pacchetto tutto-in-uno per la sintesi vocale con supporto alla clonazione vocale Fish Speech v1.5.0 gratuito e open source
-
Piano di guadagno con il farming di oro nei videogiochi: guadagna oltre 1k al giorno, un progetto stabile da 3 anni che chiunque può fare nel tempo libero
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Corso sistematico SOP per AI comic drama: selezione e adattamento di web novel, norme per le sceneggiature, da testo a immagine e da immagine a video fino al film finito, doppiaggio e montaggio - tutorial completo e standardizzato (aggiornamento 0826)
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Farming automatizzato di giochi popolari: 500+/giorno, senza esperienza, semplice – l'extra stabile a lungo termine più affidabile [Rivelato]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
ShuShu questa volta si è fatto onore! Niente panico con i problemi di formato di Windows: lo strumento open source ShuShu Format Converter, un gioiello popolare su GitHub
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Camp di accompagnamento vendite Douyin: senza apparizione reale, principianti copiano template e producono video
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Piano di guadagno con il farming nei giochi in anteprima: 1.000+ al giorno, fattibile dalle persone comuni nel tempo libero
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati






-
ShuShu questa volta si è fatto onore! Niente panico con i problemi di formato di Windows: lo strumento open source ShuShu Format Converter, un gioiello popolare su GitHub
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Lu Master v6.1024.4105.1121 versione alleggerita in file singolo [Software Ge Chuizi - R1880]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Software per la creazione di animazioni cartonate bidimensionali Moho Pro v14.3 [Software Ge Chuzi · R2355]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Software di editing e elaborazione video per PC Aiseesoft Filmai v1.0.18 【Software Ge Chuzi·R2470】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Microsoft To Do v2.147 versione ufficiale gratuita【Software Gechuzi·R2618】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Plugin oscilloscopio per color grading video PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Ge Chuizi·R2748】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati





Fish Speech è una nuova tecnologia di sintesi vocale (TTS) sviluppata dal team di Fish Audio, progettata per convertire il testo in un output vocale naturale e fluido utilizzando le più avanzate tecniche di machine learning e deep learning. Questo progetto è rilasciato con licenza CC-BY-NC-SA-4.0, il che significa che gli utenti possono utilizzare, modificare e condividere gratuitamente il suo codice e i suoi modelli nel rispetto dei termini pertinenti.
Punti di forza tecnici
Il progetto Fish Speech utilizza numerose tecnologie AI all'avanguardia, tra cui l'architettura Transformer, VQ-GAN, Llama e VITS. La combinazione di queste tecnologie consente al modello di comprendere e generare meglio il parlato di sequenze di testo lunghe, migliorando la precisione e l'efficienza della generazione vocale. È il meccanismo di auto-attenzione dell'architettura Transformer a rendere la sintesi vocale più raffinata e ad aumentare notevolmente la velocità di generazione. Inoltre, Fish Speech combina l'apprendimento multi-task con un'efficiente tecnologia di vocoder a rete neurale, permettendogli di gestire facilmente compiti complessi di sintesi vocale e di offrire effetti vocali fluidi e naturali.

Funzioni principali
- Supporto linguistico
Fish Speech supporta il cinese, il giapponese, l'inglese e molte altre lingue, con una potente funzione di sintesi vocale cross-linguistica che soddisfa le esigenze degli utenti di tutto il mondo. - Espressione emotiva
Questa tecnologia non solo è in grado di sintetizzare il parlato in mandarino, ma può anche generare un parlato ricco di emozioni, come: felicità, tristezza, rabbia, ecc., rendendo la voce più vivida e migliorandone l'espressività. - Clonazione vocale
Fish Speech dispone di una funzione di clonazione vocale, in grado di imitare con precisione le caratteristiche vocali di uno specifico parlante attraverso l'addestramento con un piccolo numero di campioni vocali, realizzando una sintesi vocale personalizzata. - Sintesi vocale in tempo reale
Supporta la generazione vocale in tempo reale a bassa latenza, ideale per scenari applicativi che richiedono un feedback immediato, come il servizio clienti online, i chatbot, ecc. - Efficienza e leggerezza
Nonostante le potenti funzionalità, i requisiti di esecuzione di Fish Speech non sono elevati. È sufficiente una GPU con soli 4 GB di VRAM per funzionare fluidamente, riducendo notevolmente la soglia di utilizzo hardware.
Scenari d'uso
Le potenti funzionalità e la flessibilità di Fish Speech lo rendono adatto a molteplici ambiti, tra cui assistenti intelligenti, chatbot, tecnologie per l'accessibilità, istruzione, creazione di contenuti, sviluppo di giochi e servizio clienti. Che si tratti di conversazioni quotidiane o di applicazioni professionali, è in grado di offrire un'esperienza vocale precisa e naturale.

Open source e comunità
Fish Speech è completamente open source: gli utenti non solo possono utilizzare e modificare liberamente il codice del progetto, ma possono anche svilupparlo ulteriormente in base alle proprie esigenze. Il team di Fish Audio e la comunità open source si impegnano costantemente per ottimizzare il progetto e offrire agli utenti di tutto il mondo un'esperienza migliore.
In sintesi
In sintesi, Fish Speech è uno strumento di sintesi vocale open source efficiente, potente e facile da usare, con ampie prospettive di applicazione. Se sei interessato alla tecnologia di sintesi vocale, non esitare a visitare GitHub per seguire e provare il progetto Fish Speech!
Sulle prestazioni
Ho testato con la mia scheda grafica 4070ti Super per un intero pomeriggio: generare un file audio di 29 secondi richiede circa 130 secondi, con un consumo di VRAM molto basso; si stima che una scheda grafica con 6 GB di VRAM possa funzionare senza problemi. Durante il test, la ventola della scheda grafica non ha quasi mai reagito, e il funzionamento è stato molto stabile.
Demo audio allegata
Di seguito è allegata una demo audio; chissà se riuscite a indovinare quale modello vocale è stato usato come riferimento.
Corsi correlati

Toolbox super locale! Con registrazione dello schermo integrata, taglio e unione di audio/video, compressione ed estrazione video, gratis per sempre - Kedou Video Converter

Strumento gratis perfetto al 100%%! Software PDF multifunzione tutto in uno: converti, comprimi, modifica PDF ecc., minimal, senza pubblicità, fantastico - JOPDF

Strumento di desktop remoto open source, superiore alle versioni a pagamento! Gratuito e illimitato per uso personale e commerciale, multipiattaforma – HopToDesk

Ultimo strumento di download di libri di testo per scuola elementare e media: download delle risorse di un intero anno, slide, video e audio con un clic

Tutto il giorno davanti allo schermo, senza uno strumento di protezione per gli occhi? Ecco l'app gratuita anti-luce blu per PC, con un animale che ti ricorda di riposare. Huyanbao

PyIsland: centro di controllo di sistema moderno con Dynamic Island sul desktop Windows

Produzione di drammi anime 3D simulati: pratica completa con Seedance 2.0, ti guida da 0 a 1 nella creazione di drammi anime di alta qualità

Compatibile Win/Mac! Ultima versione a vita: ripristina vecchie foto, migliora la nitidezza e ingrandisci senza perdita - Aiarty Image Enhancer

Tool di download Bilibili open source su Github: download in batch di video Bilibili con supporto 8K e Dolby Vision, semplice, Bilidown

Collezione di strumenti desktop Windows: 50+ widget pratici ed essenziali, con screenshot, registrazione, traduzione, meteo ecc. – toolbox Duomi