


-
Solounternehmens-Kurse
-
 Sonstiges
-
Auslandskurse
-
Fotografie & Schnitt
-
Community & Private Domain
-
Schreiben & Texten für Medien
-
Nebenverdienst-Projekte
-
E-Commerce
-
Kurzvideos & Live-Streaming
-
Künstliche Intelligenz (KI)
-
Software & Tools
-
Betriebssysteme
-
Plugins & Skripte
-
MacOS-Software
-
Android-Software
-
Windows-Software
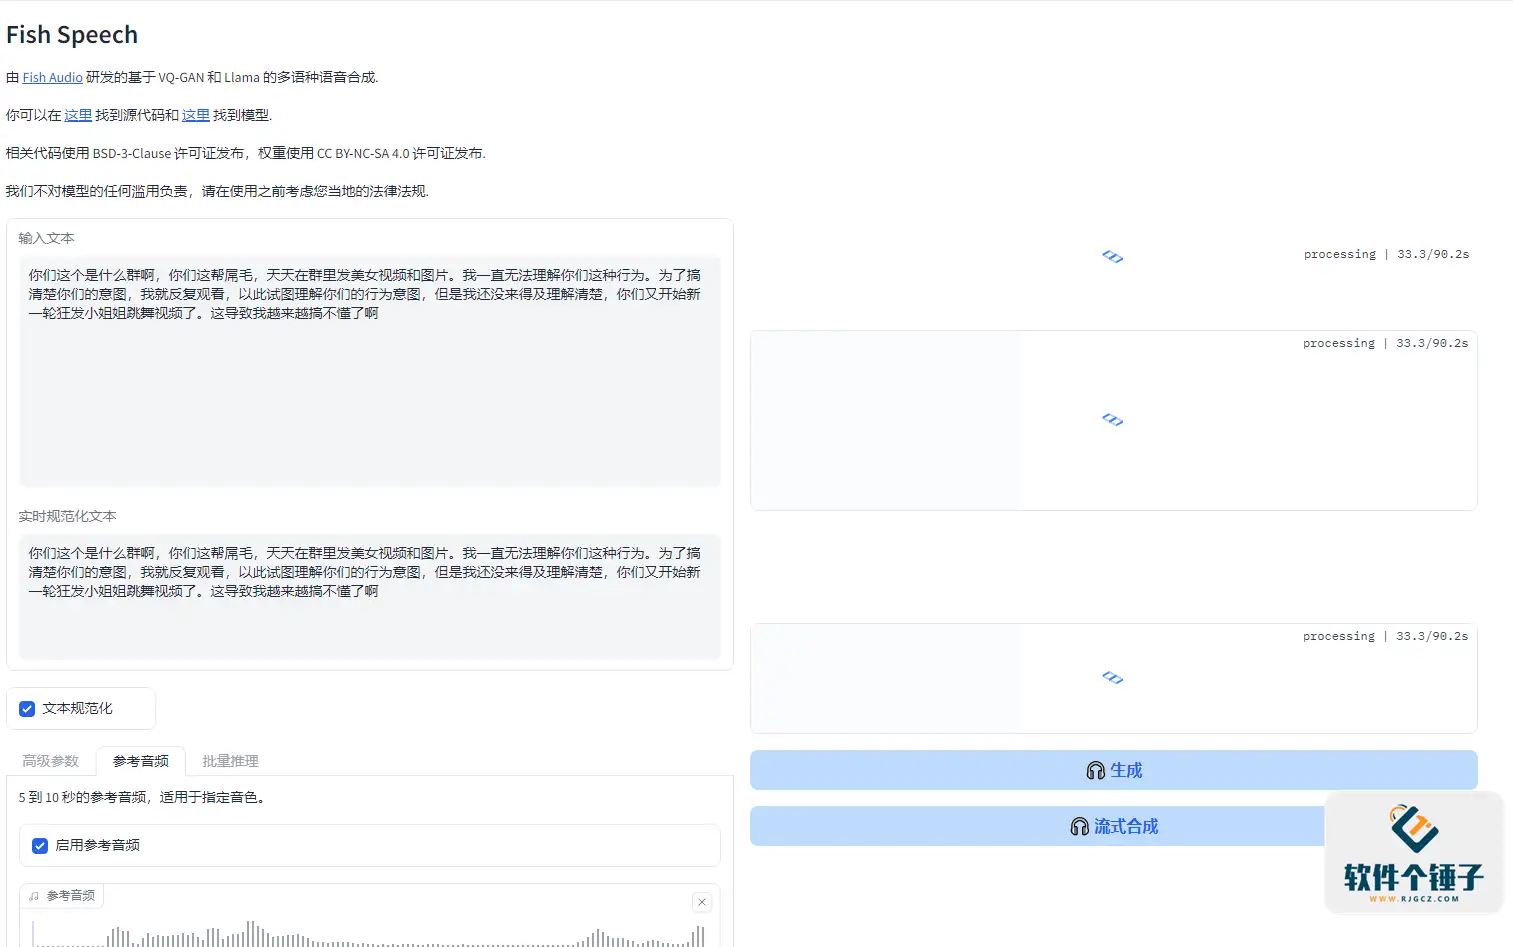

【R2341】Text-zu-Sprache-Ein-Klick-Integrationspaket, unterstützt Stimmklonierung, Fish Speech v1.5.0, kostenlos und Open Source
-
Goldfarming-Geldverdienplan für Spiele: täglich über 1.000 verdienen – ein stabiles 3-Jahres-Projekt, das jeder in der Freizeit umsetzen kann
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
AI-Comic-Drama-SOP-Systemkurs: Web-Novel-Auswahl und -Adaption, Drehbuchnormen, Text-zu-Bild/Bild-zu-Video-Fertigfilm, Voice-over und Schnitt – standardisiertes Full-Flow-Umsetzungs-Tutorial (Update 0826)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Hot-Game-vollautomatisiertes Verdienen: 500+ pro Tag, keine Erfahrung, einfache Bedienung – das stetigste langfristige Game-Verdienst-Nebenprojekt (enthüllt)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Douyin-Verkaufs-Begleitcamp: kein echtes Auftreten nötig, Anfänger kopieren Vorlagen und produzieren Verkaufsvideos
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Premier-Game-Farming-Geldplan: 1.000+ täglich, für Normalverdiener in der Freizeit machbar! [Enthüllung]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten






-
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Lu Master v6.1024.4105.1121 schlanke Single-File-Version [Software Ge Chuzi · R1880]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Software zur Erstellung zweidimensionaler Cartoon-Animationen Moho Pro v14.3 [Software Gezhi Chuzi · R2355]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PC-Videobearbeitungssoftware Aiseesoft Filmai v1.0.18 【Software Gezhi·R2470】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Microsoft To Do v2.147 Offizielle kostenlose Version [Software Gechui·R2618]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PR/AE/DaVinci/FCPX Video-Farbkorrektur-Oszilloskop-Plugin Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Gechui·R2748】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten





Fish Speech ist eine neue Text-zu-Sprache-Technologie (TTS), die vom Fish Audio Team entwickelt wurde und darauf abzielt, modernste maschinelle Lern- und Deep-Learning-Technologien zu nutzen, um Text in natürliche und flüssige Sprachausgabe umzuwandeln. Dieses Projekt wird unter der CC-BY-NC-SA-4.0-Lizenz veröffentlicht, was bedeutet, dass Nutzer den Code und die Modelle unter Einhaltung der entsprechenden Bedingungen kostenlos verwenden, ändern und teilen dürfen.
Technische Highlights
Das Fish Speech Projekt verwendet zahlreiche führende KI-Technologien, darunter die Transformer-Architektur, VQ-GAN, Llama und VITS. Diese Technologien ermöglichen es dem Modell, lange Textsequenzen besser zu verstehen und Sprache daraus zu generieren, was die Genauigkeit und Effizienz der Sprachgenerierung verbessert. Es ist der Self-Attention-Mechanismus der Transformer-Architektur, der die Sprachsynthese feiner macht und die Generierungsgeschwindigkeit erheblich steigert. Darüber hinaus kombiniert Fish Speech Multi-Task-Learning mit effizienter neuronaler Vocoder-Technologie, sodass komplexe Sprachsynthese-Aufgaben mühelos bewältigt und flüssige sowie natürliche Sprachresultate erzielt werden können.

Kernfunktionen
- Sprachunterstützung
Fish Speech unterstützt Chinesisch, Japanisch, Englisch und viele weitere Sprachen und verfügt über eine leistungsstarke sprachübergreifende Sprachsynthese-Funktion, die die Bedürfnisse globaler Nutzer erfüllt. - Emotionale Ausdrucksweise
Diese Technologie kann nicht nur Mandarin-Sprache synthetisieren, sondern auch emotionale Sprache erzeugen, zum Beispiel: Freude, Trauer, Wut usw., wodurch die Sprache lebendiger wird und die Ausdruckskraft erhöht wird. - Stimmklonierung
Fish Speech verfügt über eine Stimmklonierungsfunktion, die durch Training mit wenigen Sprachproben die Stimmmerkmale eines bestimmten Sprechers präzise nachahmen und eine personalisierte Sprachsynthese ermöglichen kann. - Echtzeit-Sprachsynthese
Unterstützt Echtzeit-Sprachgenerierung mit niedriger Latenz, ideal für Anwendungsszenarien, die sofortiges Feedback erfordern, wie Online-Kundenservice, Chatbots usw. - Effizient und leichtgewichtig
Trotz der leistungsstarken Funktionen sind die Anforderungen für den Betrieb von Fish Speech nicht hoch. Eine GPU mit nur 4 GB VRAM reicht für einen flüssigen Betrieb aus, was die Hardware-Hürde erheblich senkt.
Anwendungsszenarien
Die leistungsstarken Funktionen und die Flexibilität von Fish Speech machen es für viele Bereiche geeignet, darunter intelligente Assistenten, Chatbots, Barrierefreiheitstechnologie, Bildung, Content-Erstellung, Spieleentwicklung sowie Kundenservice. Ob im Alltagsgespräch oder in professionellen Anwendungen, es bietet ein präzises und natürliches Spracherlebnis.

Open Source und Community
Fish Speech ist vollständig Open Source. Nutzer können den Projektcode nicht nur frei verwenden und ändern, sondern auch je nach individuellem Bedarf weiterentwickeln. Das Fish Audio Team und die Open-Source-Community arbeiten kontinuierlich daran, das Projekt zu optimieren und globalen Nutzern ein besseres Erlebnis zu bieten.
Zusammenfassung
Zusammenfassend ist Fish Speech ein effizientes, leistungsstarkes und einfach zu bedienendes Open-Source-Text-zu-Sprache-Tool mit breitem Anwendungspotenzial. Wenn Sie sich für Sprachsynthese-Technologie interessieren, besuchen Sie doch GitHub und entdecken Sie das Fish Speech Projekt!
Zur Leistung
Ich habe einen ganzen Nachmittag mit meiner 4070ti Super Grafikkarte getestet. Die Generierung einer 29-sekündigen Audiodatei dauert etwa 130 Sekunden, die VRAM-Auslastung ist sehr gering, schätzungsweise läuft es auch mit einer Grafikkarte mit 6 GB VRAM flüssig. Während des Tests reagierte der Grafikkartenlüfter kaum, der Betrieb war sehr stabil.
Beigefügte Audio-Demo
Unten ist eine Audio-Demo beigefügt. Ich frage mich, ob jemand erraten kann, welches Stimmmodell als Referenz diente.
Ähnliche Kurse

Super lokale Toolbox! Integrierte Bildschirmaufnahme, Audio-/Video-Schnitt & -Zusammenführung, Video-Komprimierung & -Extraktion, für immer gratis – Kedou Video Converter

100%% perfektes Gratis-Tool! Alles-in-einem-Multifunktions-PDF-Software: PDF konvertieren, komprimieren, bearbeiten etc., minimalistisch, keine Werbung, so schön – JOPDF

Open-Source-Desktop-Fernzugriffstool, weit besser als kostenpflichtige Versionen! Kostenlos und unbegrenzt für Privat und Gewerbe nutzbar, plattformübergreifend, Desktop-Fernsteuerung – HopToDesk

Neuestes Tool zum Herunterladen von Lehrmaterialien für Grund- und Mittelschule: komplette Jahrgangsstufen, mit begleitenden Folien, Videos und Audios auf einen Klick

Den ganzen Tag auf den Bildschirm, ohne Augenschutz-Tool? Kostenlose Blaulicht-Schutz-App für PC, mit Haustier, das dich an Pausen erinnert, Huyanbao

PyIsland: Modernes System-Control-Center mit Desktop-Dynamic-Island für Windows

3D-Simulation-Manju-Produktion: Seedance 2.0 Komplettprozess-Praxis, von 0 bis zur hochwertigen Manju-Kreation

Für Win und Mac! Neueste lebenslange Version: Restaurierung alter Fotos, Bildklarheit und verlustfreie Vergrößerung - Aiarty Image Enhancer

Github Open-Source-Bilibili-Downloader: Stapel-Download von Bilibili-Videos mit 8K und Dolby Vision-Unterstützung – einfach zu bedienen, Bilidown

Windows-Desktop-Werkzeugsammlung: 50+ praktische, schlichte Desktop-Widgets, mit Screenshot, Screenrecording, Übersetzung, Wetter u.v.m. – Duomi-Toolbox

Contact Info
- E-Mail: massivesidehustles@outlook.com
