


-
Cursos de negocio en solitario
-
 Otros
-
Tutoriales en el extranjero
-
Fotografía & Edición
-
Comunidad & Dominio privado
-
Escritura & Redacción para medios
-
Proyectos de ingresos extra
-
Comercio electrónico
-
Vídeo corto & Transmisión en vivo
-
Inteligencia Artificial (IA)
-
Software & Herramientas
-
Sistemas operativos
-
Plugins & Scripts
-
Software MacOS
-
Software Android
-
Software Windows
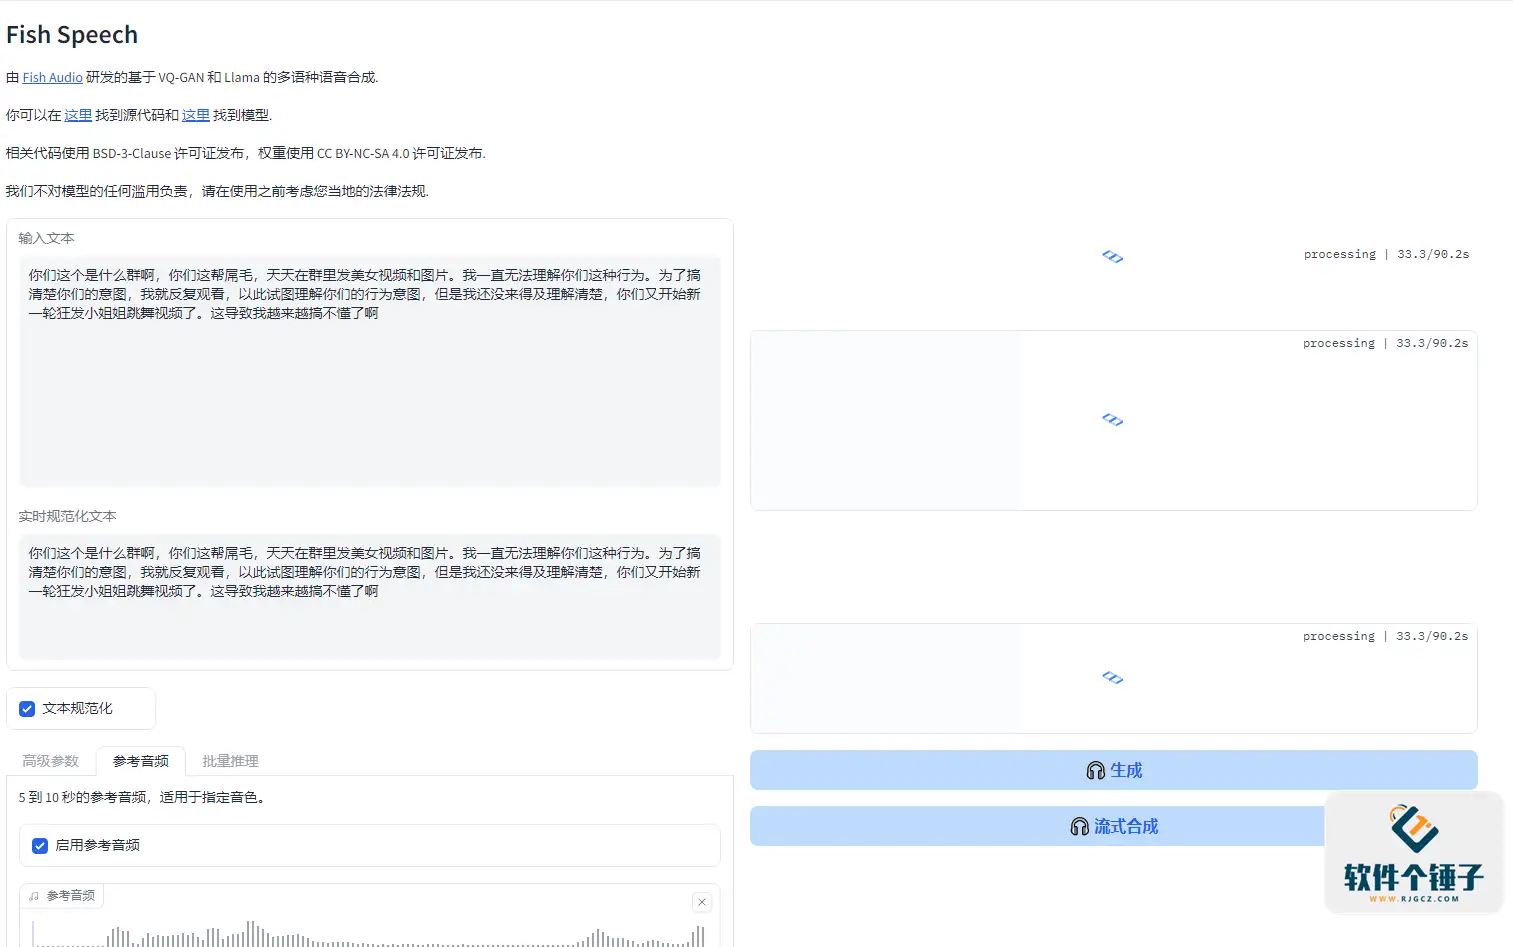

[R2341]Paquete todo en uno de texto a voz Compatible con clonación de voz Fish Speech v1.5.0 Gratuito y de código abierto
-
Plan para ganar dinero con la cría de oro en juegos: gana más de 1000 al día, un proyecto estable de 3 años que cualquiera puede hacer en su tiempo libre
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Curso sistemático con SOP de drama de cómic con IA: selección y adaptación de novelas web, normas de guion, película terminada de texto a imagen e imagen a video, edición de locución: tutorial estanda
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Farming automatizado de juegos populares: 500+/día, sin experiencia, sencillo – el extra estable a largo plazo más fiable [Revelado]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
ShuShu esta vez sí cumplió! No te asustes con los problemas de formato de Windows: la herramienta open source ShuShu Format Converter, una joya popular en GitHub
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Campamento de acompañamiento de ventas en Douyin: sin aparecer en cámara, principiantes copian plantillas y producen videos
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Plan de ingresos por farming de juegos en su estreno: más de 1.000 al día, ¡apto para gente normal en su tiempo libre! [Revelación]
Material de estudio de referencia — incluido con la membresía Obtener membresía






-
ShuShu esta vez sí cumplió! No te asustes con los problemas de formato de Windows: la herramienta open source ShuShu Format Converter, una joya popular en GitHub
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Master Lu v6.1024.4105.1121 versión simplificada de archivo único [Software Ge Chuizi · R1880]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Software de creación de animación de dibujos animados 2D Moho Pro v14.3 [Software Ge Chuzi · R2355]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Software de edición y procesamiento de video para PC Aiseesoft Filmai v1.0.18
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Microsoft To Do v2.147 versión oficial gratuita【Software Ge Chuizi·R2618】
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Plugin de osciloscopio de corrección de color de vídeo para PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138 [Software Gechuzi·R2748]
Material de estudio de referencia — incluido con la membresía Obtener membresía





Fish Speech es una nueva tecnología de texto a voz (TTS) presentada por el equipo de Fish Audio, cuyo objetivo es convertir texto en una salida de voz natural y fluida mediante las técnicas más avanzadas de aprendizaje automático y aprendizaje profundo. Este proyecto se publica bajo la licencia CC-BY-NC-SA-4.0, lo que significa que los usuarios pueden usar, modificar y compartir su código y sus modelos de forma gratuita siempre que cumplan las condiciones correspondientes.
Aspectos técnicos destacados
El proyecto Fish Speech emplea numerosas tecnologías de IA líderes, entre ellas la arquitectura Transformer, VQ-GAN, Llama y VITS. La combinación de estas tecnologías permite al modelo comprender mejor y generar secuencias largas de texto con voz, mejorando la precisión y la eficiencia de la generación de voz. Es el mecanismo de autoatención de la arquitectura Transformer el que hace más refinada la expresión de la síntesis de voz y aumenta en gran medida la velocidad de generación. Además, Fish Speech combina el aprendizaje multitarea con una eficiente tecnología de vocoder de red neuronal, lo que le permite manejar con facilidad tareas complejas de síntesis de voz y ofrecer resultados fluidos y naturales.

Funciones principales
- Soporte de idiomas
Fish Speech admite varios idiomas, como chino, japonés e inglés, y posee una potente función de síntesis de voz multilingüe que satisface las necesidades de usuarios de todo el mundo. - Expresión emocional
Esta tecnología no solo puede sintetizar voz en mandarín, sino también generar voz cargada de emoción, por ejemplo: alegría, tristeza, ira, etc., lo que hace la voz más vívida y refuerza su expresividad. - Clonación de voz
Fish Speech dispone de una función de clonación de voz que, mediante el entrenamiento con unas pocas muestras de audio, imita con precisión las características vocales de un hablante concreto y logra una síntesis de voz personalizada. - Síntesis de voz en tiempo real
Admite la generación de voz en tiempo real con baja latencia, ideal para escenarios que requieren respuesta inmediata, como la atención al cliente en línea o los chatbots. - Eficiencia y ligereza
A pesar de su gran potencia, los requisitos de funcionamiento de Fish Speech no son altos. Solo necesita una GPU con 4 GB de memoria de vídeo para funcionar con fluidez, lo que reduce enormemente el umbral de hardware.
Casos de uso
La potencia y la flexibilidad de Fish Speech lo hacen aplicable a múltiples campos, como asistentes inteligentes, chatbots, tecnologías de accesibilidad, educación, creación de contenido, desarrollo de videojuegos y atención al cliente, entre otros. Ya sea en una conversación cotidiana o en una aplicación profesional, ofrece una experiencia de voz precisa y natural.

Código abierto y comunidad
Fish Speech es totalmente de código abierto; los usuarios no solo pueden usar y modificar libremente el código del proyecto, sino también desarrollar variantes según sus necesidades personales. El equipo de Fish Audio y la comunidad de código abierto también trabajan continuamente para optimizar el proyecto y ofrecer una mejor experiencia a usuarios de todo el mundo.
Resumen
En resumen, Fish Speech es una herramienta de texto a voz de código abierto eficiente, potente y fácil de usar, con amplias perspectivas de aplicación. Si te interesa la tecnología de síntesis de voz, ¡no dudes en visitar GitHub y conocer y probar el proyecto Fish Speech!
Sobre el rendimiento
Estuve probando durante toda una tarde con mi tarjeta gráfica 4070ti Super: generar un archivo de voz de 29 segundos tarda aproximadamente 130 segundos, y el consumo de memoria de vídeo es muy bajo; calculo que una tarjeta con 6 GB de memoria de vídeo puede funcionar sin problemas. Durante las pruebas, el ventilador de la tarjeta gráfica casi no reaccionó y el funcionamiento fue muy estable.
Demostración de audio adjunta
A continuación se adjunta una demostración de audio; no sé si podrán adivinar qué modelo de voz se usó como referencia.
Cursos relacionados

¡Súper caja de herramientas local! Grabación de pantalla integrada, corte y unión de audio y vídeo, compresión y extracción de vídeo, gratis para siempre - Kedou Video Converter

¡Herramienta gratis 100% perfecta! Software PDF multifunción todo en uno: convertir, comprimir y editar PDF, minimalista, sin anuncios, tan bueno - JOPDF

¡Herramienta de escritorio remoto de código abierto, superior a las versiones de pago! Gratis e ilimitada para uso personal y comercial, multiplataforma – HopToDesk

Última herramienta de descarga de libros de primaria y secundaria: recursos de un curso completo, diapositivas, videos y audio con un clic

Todo el día frente a la pantalla, ¿sin una herramienta de protección ocular? Llega una aplicación gratuita de protección contra la luz azul para PC, con una mascota que te recuerda descansar, Huyanbao

PyIsland: centro de control del sistema moderno con Dynamic Island en el escritorio de Windows

Producción de manhua 3D simulada: práctica completa de Seedance 2.0, te lleva de 0 a 1 a crear manhuas de alta calidad

¡Compatible con Win/Mac! Última versión de por vida: restaura fotos antiguas, mejora la nitidez y amplía sin pérdida - Aiarty Image Enhancer

Herramienta de descarga de Bilibili de código abierto en Github: descarga por lotes de vídeos de Bilibili con soporte 8K y Dolby Vision, fácil de usar, Bilidown

Colección de herramientas de escritorio para Windows: más de 50 widgets prácticos y minimalistas, con captura de pantalla, grabación, traducción, clima, etc., caja de herramientas Duomi

Datos de contacto
- Correo electrónico: massivesidehustles@outlook.com
