


-
Cours de business solo
-
 Autres
-
Tutoriels à l'étranger
-
Photographie & Montage
-
Communauté & Domaine privé
-
Écriture & Copywriting pour médias
-
Projets de revenus annexes
-
E-commerce
-
Vidéo courte & Diffusion en direct
-
Intelligence Artificielle (IA)
-
Logiciels & Outils
-
Systèmes d'exploitation
-
Plugins & Scripts
-
Logiciels MacOS
-
Logiciels Android
-
Logiciels Windows
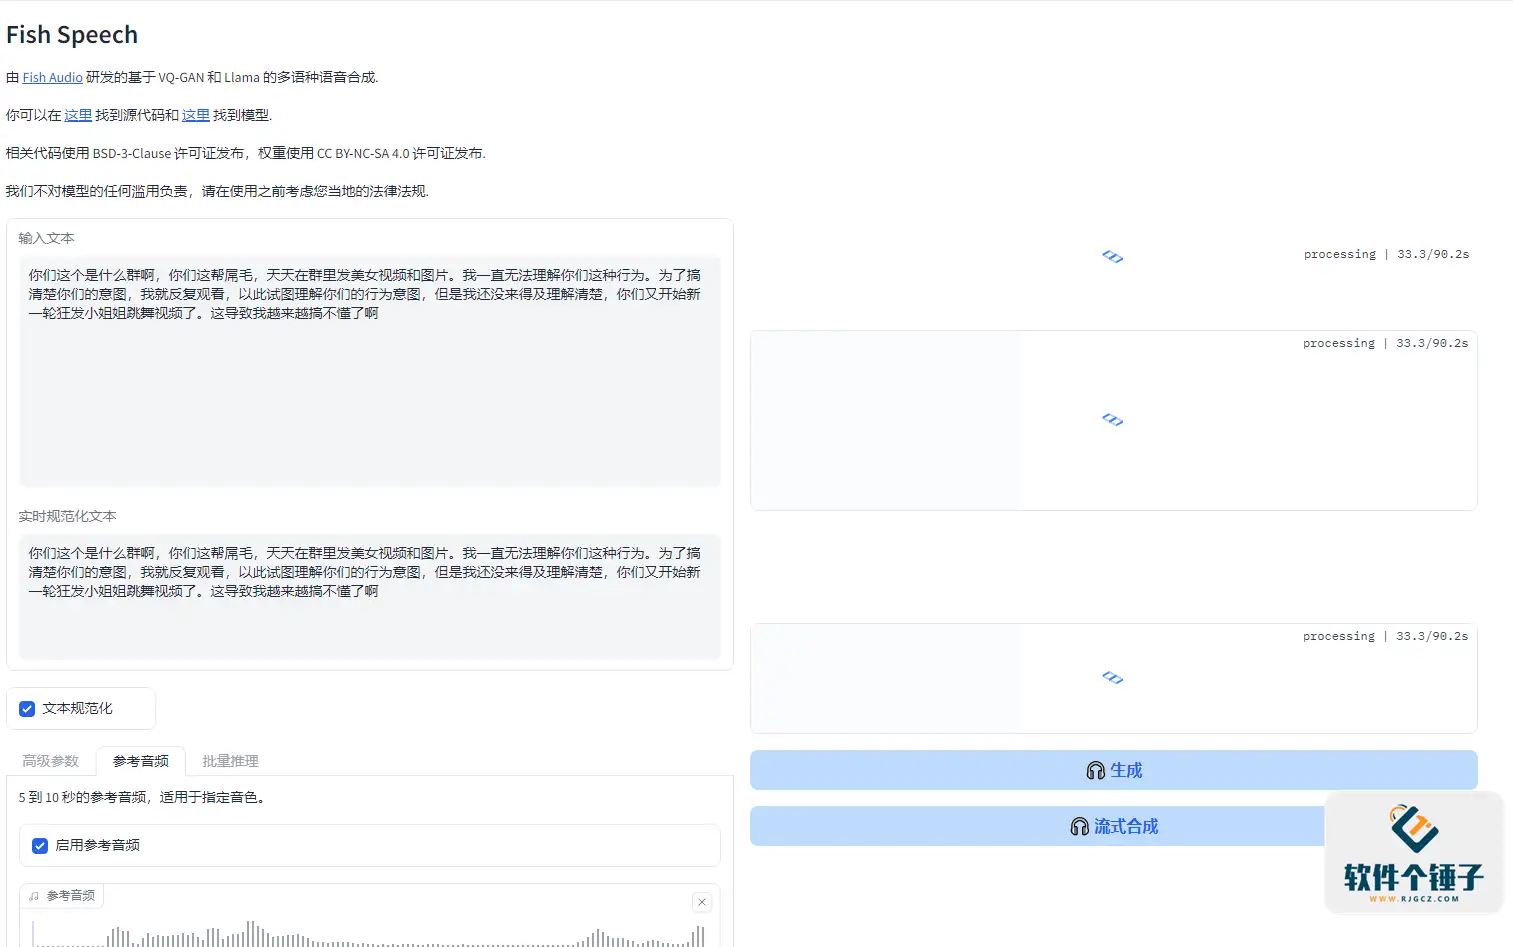

[R2341] Pack tout-en-un de synthèse vocale, prend en charge le clonage vocal, Fish Speech v1.5.0, gratuit et open source
-
Plan lucratif de farming d'or dans les jeux : gagner 1k+ par jour, un projet stable depuis 3 ans que n'importe qui peut faire sur son temps libre
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Cours SOP systématique de dramas en comics IA : sélection/adaptation de web-novels, normes de script, film fini text-to-image/image-to-video, voix off — tutoriel standardisé de tout le flux (MAJ 0826)
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Farming automatisé de jeux populaires : 500+/jour, sans expérience, simple – la complément longue durée la plus stable [Révélé]
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
ShuShu a fait ses preuves ! Pas de panique face aux problèmes de format Windows - l'outil open source ShuShu Format Converter, un bijou GitHub en vogue
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Camp d'accompagnement à la vente Douyin : sans apparaître à l'écran, les débutants copient et produisent des vidéos
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Plan d'argent farming de jeux en avant-première : 1 000+ par jour, accessible aux gens ordinaires pendant leur temps libre !
Matériel d'étude de référence — inclus avec l'abonnement S'abonner






-
ShuShu a fait ses preuves ! Pas de panique face aux problèmes de format Windows - l'outil open source ShuShu Format Converter, un bijou GitHub en vogue
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Lu Master v6.1024.4105.1121 version allégée en fichier unique [Ruanjian Ge Chuzi·R1880]
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Logiciel de création d'animation cartoon 2D Moho Pro v14.3 [Logiciel Ge Chuizi · R2355]
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Logiciel de montage et de traitement vidéo pour PC Aiseesoft Filmai v1.0.18
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Microsoft To Do v2.147 version officielle gratuite
Matériel d'étude de référence — inclus avec l'abonnement S'abonner -
Plugin d'oscilloscope d'étalonnage vidéo pour PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Logiciel Gechui·R2748】
Matériel d'étude de référence — inclus avec l'abonnement S'abonner





Fish Speech est une nouvelle technologie de synthèse vocale (TTS) lancée par l'équipe Fish Audio, visant à convertir du texte en une sortie vocale naturelle et fluide grâce aux technologies les plus avancées d'apprentissage automatique et d'apprentissage profond. Ce projet est publié sous licence CC-BY-NC-SA-4.0, ce qui signifie que les utilisateurs peuvent utiliser, modifier et partager gratuitement son code et ses modèles, à condition de respecter les clauses associées.
Points forts techniques
Le projet Fish Speech adopte de nombreuses technologies d'IA de pointe, notamment l'architecture Transformer, VQ-GAN, Llama et VITS. La combinaison de ces technologies permet au modèle de mieux comprendre et de générer la parole pour de longues séquences de texte, améliorant la précision et l'efficacité de la génération vocale. C'est le mécanisme d'auto-attention de l'architecture Transformer qui rend la synthèse vocale plus fine et augmente considérablement la vitesse de génération. En outre, Fish Speech combine l'apprentissage multitâche et une technologie efficace de vocodeur neuronal, ce qui lui permet de traiter facilement des tâches complexes de synthèse vocale et d'offrir un rendu vocal fluide et naturel.

Fonctions principales
- Prise en charge des langues
Fish Speech prend en charge le chinois, le japonais, l'anglais et d'autres langues, avec une puissante fonction de synthèse vocale multilingue, répondant aux besoins des utilisateurs du monde entier. - Expression des émotions
Cette technologie peut non seulement synthétiser de la parole en mandarin standard, mais aussi générer une parole riche en émotions, telles que : joie, tristesse, colère, etc., rendant la voix plus vivante et renforçant son expressivité. - Clonage vocal
Fish Speech dispose d'une fonction de clonage vocal, capable, grâce à l'entraînement sur un petit nombre d'échantillons audio, d'imiter avec précision les caractéristiques vocales d'un locuteur spécifique et de réaliser une synthèse vocale personnalisée. - Synthèse vocale en temps réel
Prise en charge de la génération vocale en temps réel à faible latence, idéale pour les scénarios nécessitant un retour instantané, comme le service client en ligne, les chatbots, etc. - Efficace et léger
Malgré ses fonctionnalités puissantes, Fish Speech n'a pas d'exigences de fonctionnement élevées. Un GPU avec seulement 4 Go de mémoire vidéo suffit pour fonctionner fluidement, ce qui abaisse considérablement le seuil matériel requis.
Cas d'utilisation
Les fonctionnalités puissantes et la flexibilité de Fish Speech le rendent applicable à de nombreux domaines, notamment les assistants intelligents, les chatbots, les technologies d'accessibilité, l'éducation, la création de contenu, le développement de jeux et le service client, etc. Qu'il s'agisse de conversations quotidiennes ou d'applications professionnelles, il offre une expérience vocale précise et naturelle.

Open source et communauté
Fish Speech est entièrement open source ; les utilisateurs peuvent non seulement utiliser et modifier librement le code du projet, mais aussi le développer davantage selon leurs besoins personnels. L'équipe Fish Audio et la communauté open source travaillent également en continu pour optimiser le projet et offrir une meilleure expérience aux utilisateurs du monde entier.
En résumé
En résumé, Fish Speech est un outil de synthèse vocale open source efficace, puissant et facile à utiliser, avec de larges perspectives d'application. Si la technologie de synthèse vocale vous intéresse, n'hésitez pas à vous rendre sur GitHub pour suivre et découvrir le projet Fish Speech !
À propos des performances
J'ai testé pendant tout un après-midi avec ma carte graphique 4070ti Super : générer un fichier audio de 29 secondes prend environ 130 secondes, et l'occupation de la mémoire vidéo est très faible ; j'estime qu'une carte graphique avec 6 Go de mémoire vidéo peut fonctionner sans problème. Pendant les tests, le ventilateur de la carte graphique n'a pratiquement pas réagi, et le fonctionnement était très stable.
Démonstration audio incluse
Ci-dessous une démonstration audio ; je ne sais pas si vous pourrez deviner quel modèle vocal a servi de référence.
Cours similaires

Boîte à outils locale super pratique ! Enregistrement d’écran intégré, découpe et fusion audio/vidéo, compression et extraction vidéo, gratuit pour toujours - Kedou Video Converter

Outil gratuit 100 % parfait ! Logiciel PDF multifonction tout-en-un : conversion, compression, édition de PDF, etc., épuré, sans publicité, vraiment agréable - JOPDF

Outil de bureau à distance open source, bien meilleur que les versions payantes ! Gratuit et illimité pour un usage personnel et commercial, multiplateforme – HopToDesk

Dernier outil de téléchargement de manuels scolaires primaire et collège : ressources d'une année entière, diaporamas, vidéos et audio en un clic

Toute la journée devant l'écran, sans protection oculaire ? Application gratuite anti-lumière bleue pour PC, avec animal qui vous rappelle de faire une pause, Huyanbao

PyIsland : centre de contrôle système moderne avec Dynamic Island sur le bureau Windows

Production de drames animés 3D réalistes : pratique complète de Seedance 2.0, de 0 à 1 pour créer un drame animé de haute qualité

Compatible Win/Mac ! Dernière version à vie : restaurez de vieilles photos, rendez les images nettes et agrandissez sans perte - Aiarty Image Enhancer

Outil de téléchargement Bilibili open source sur Github : téléchargement par lots de vidéos Bilibili en 8K et Dolby Vision, simple d'utilisation, Bilidown

Collection d'outils de bureau Windows : 50+ widgets pratiques et épurés, capture, enregistrement d'écran, traduction, météo, etc. – boîte à outils Duomi

Informations de contact
- E-mail: massivesidehustles@outlook.com
