


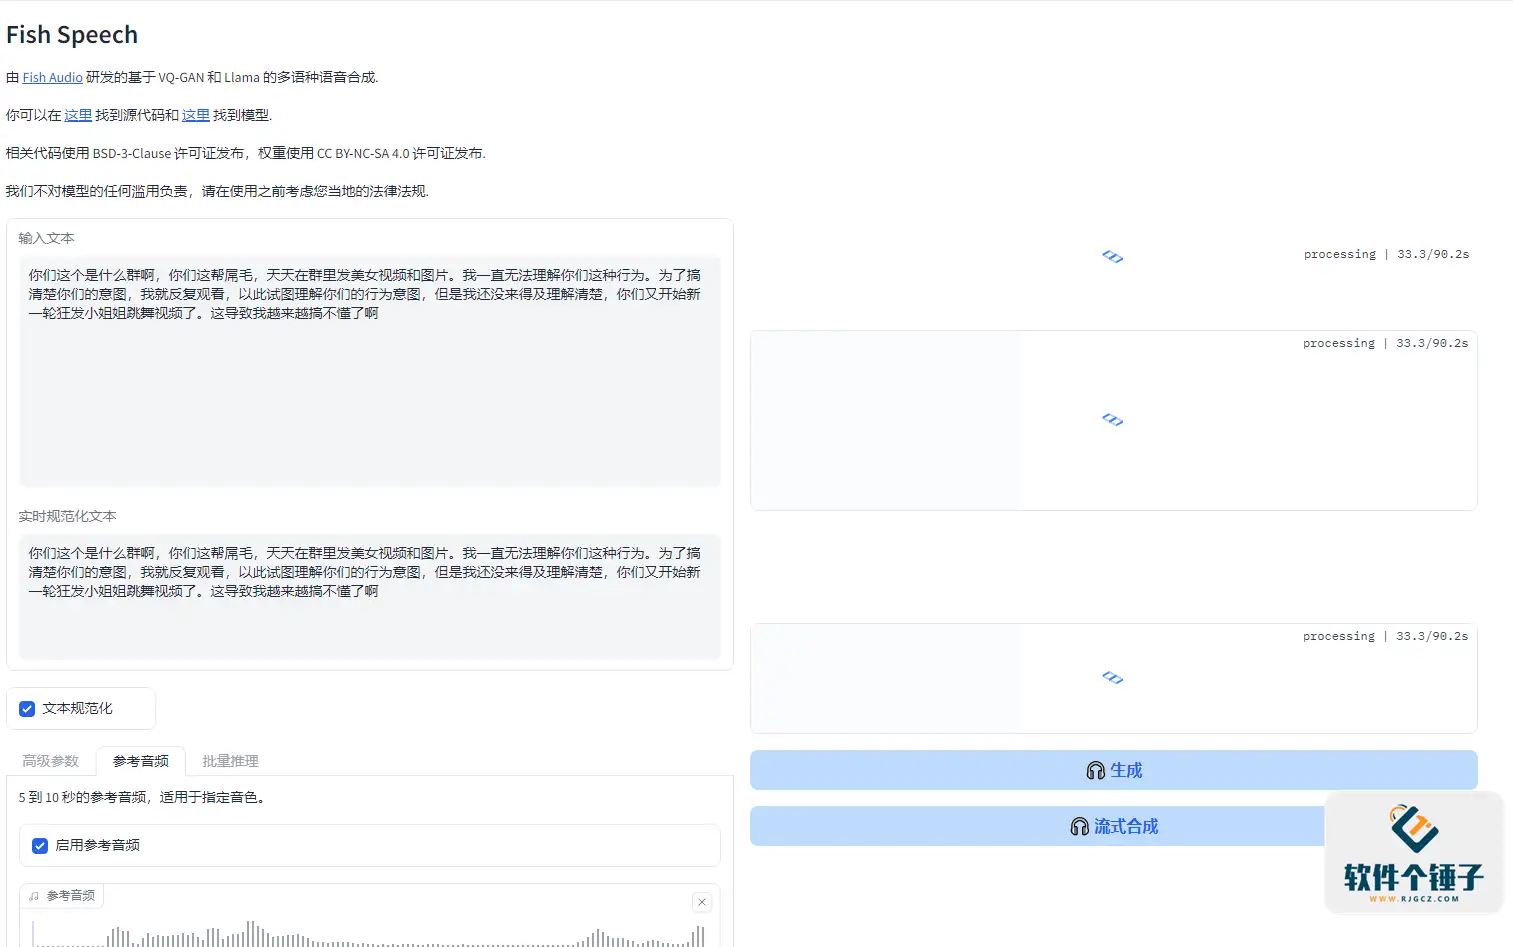

[R2341] 텍스트 음성 변환 원클릭 통합 패키지 음성 복제 지원 Fish Speech v1.5.0 무료 오픈소스
-

선착순 게임 노가다 돈벌기 계획, 일 1k+, 일반인 한가한 시간에 가능! (공개)
회원 참고 학습 자료 멤버십 가입











Fish Speech는 Fish Audio 팀이 선보인 새로운 텍스트 음성 변환(TTS) 기술로, 최첨단 머신러닝과 딥러닝 기술을 활용해 텍스트를 자연스럽고 유창한 음성 출력으로 변환하는 것을 목표로 합니다. 이 프로젝트는 CC-BY-NC-SA-4.0 라이선스로 배포되며, 사용자는 관련 조건을 준수하는 전제 하에 코드와 모델을 무료로 사용, 수정 및 공유할 수 있습니다.
기술적 하이라이트
Fish Speech 프로젝트는 Transformer 아키텍처, VQ-GAN, Llama, VITS 등 다양한 선도적인 AI 기술을 채택했습니다. 이러한 기술의 결합으로 모델은 긴 텍스트 시퀀스의 음성을 더 잘 이해하고 생성할 수 있게 되어 음성 생성의 정밀도와 효율성이 향상되었습니다. 특히 Transformer 아키텍처의 자기 주의 메커니즘은 음성 합성의 표현을 더욱 정교하게 만들고 생성 속도를 크게 향상시킵니다. 또한 Fish Speech는 멀티태스크 학습과 효율적인 신경망 보코더 기술을 결합하여 복잡한 음성 합성 작업을 손쉽게 처리하고 유창하고 자연스러운 음성 효과를 제공합니다.

핵심 기능
- 언어 지원
Fish Speech는 중국어, 일본어, 영어 등 여러 언어를 지원하며 강력한 교차 언어 음성 합성 기능을 갖추어 전 세계 사용자의 요구를 충족합니다. - 감정 표현
이 기술은 표준 중국어 음성을 합성할 수 있을 뿐만 아니라 행복, 슬픔, 분노 등 감정이 풍부한 음성도 생성하여 음성을 더욱 생생하게 만들고 표현력을 강화합니다. - 음성 복제
Fish Speech는 음성 복제 기능을 갖추고 있어 적은 양의 음성 샘플로 훈련하여 특정 화자의 음성 특징을 정확하게 모방하고 개인화된 음성 합성을 구현할 수 있습니다. - 실시간 음성 합성
낮은 지연의 실시간 음성 생성을 지원하여 온라인 고객 서비스, 챗봇 등 즉각적인 피드백이 필요한 응용 시나리오에 매우 적합합니다. - 효율성과 경량성
강력한 기능에도 불구하고 Fish Speech의 실행 요구 사항은 높지 않습니다. 4GB VRAM의 GPU만 있으면 원활하게 실행되어 하드웨어 사용 장벽을 크게 낮춥니다.
활용 환경
Fish Speech의 강력한 기능과 유연성은 지능형 비서, 챗봇, 접근성 기술, 교육, 콘텐츠 제작, 게임 개발 및 고객 서비스 등 여러 분야에 적용할 수 있습니다. 일상 대화든 전문적인 응용이든 정확하고 자연스러운 음성 경험을 제공합니다.

오픈소스와 커뮤니티
Fish Speech는 완전 오픈소스로, 사용자는 프로젝트 코드를 자유롭게 사용하고 수정할 수 있을 뿐만 아니라 개인 요구에 따라 2차 개발도 할 수 있습니다. Fish Audio 팀과 오픈소스 커뮤니티도 지속적으로 노력하며 프로젝트를 끊임없이 최적화하여 전 세계 사용자에게 더 나은 경험을 제공하고 있습니다.
요약
요약하자면, Fish Speech는 효율적이고 강력하며 사용하기 쉬운 오픈소스 텍스트 음성 변환 도구로 폭넓은 응용 전망을 가지고 있습니다. 음성 합성 기술에 관심이 있다면 GitHub에 방문하여 Fish Speech 프로젝트를 팔로우하고 체험해 보세요!
성능에 대하여
제 4070ti Super 그래픽카드로 오후 내내 테스트했는데, 29초짜리 음성 파일을 생성하는 데 약 130초가 걸렸고 VRAM 점유율이 매우 낮아 6GB VRAM의 그래픽카드면 원활하게 실행할 수 있을 것으로 예상됩니다. 테스트 과정에서 그래픽카드 팬이 거의 반응하지 않았고 실행이 매우 안정적이었습니다.
오디오 데모 첨부
아래에 오디오 데모를 첨부합니다. 어떤 음성 모델을 참고했는지 여러분이 맞힐 수 있을지 모르겠네요.
관련 강의





후옌바오: 반려동물 휴식 알림이 있는 무료 블루라이트 눈보호 앱






