


-
Kursus Perniagaan
-
 Lain-lain
-
Tutorial Luar Negara
-
Fotografi & Penyuntingan
-
Komuniti & Domain Persendirian
-
Penulisan Media Sendiri & Penulisan Iklan
-
Projek Pendapatan Sampingan
-
E-dagang
-
Video Pendek & Penstriman Langsung
-
Kecerdasan Buatan (AI)
-
Perisian & Alatan
-
Sistem Pengendalian
-
Pemalam & Skrip
-
Perisian MacOS
-
Perisian Android
-
Perisian Windows
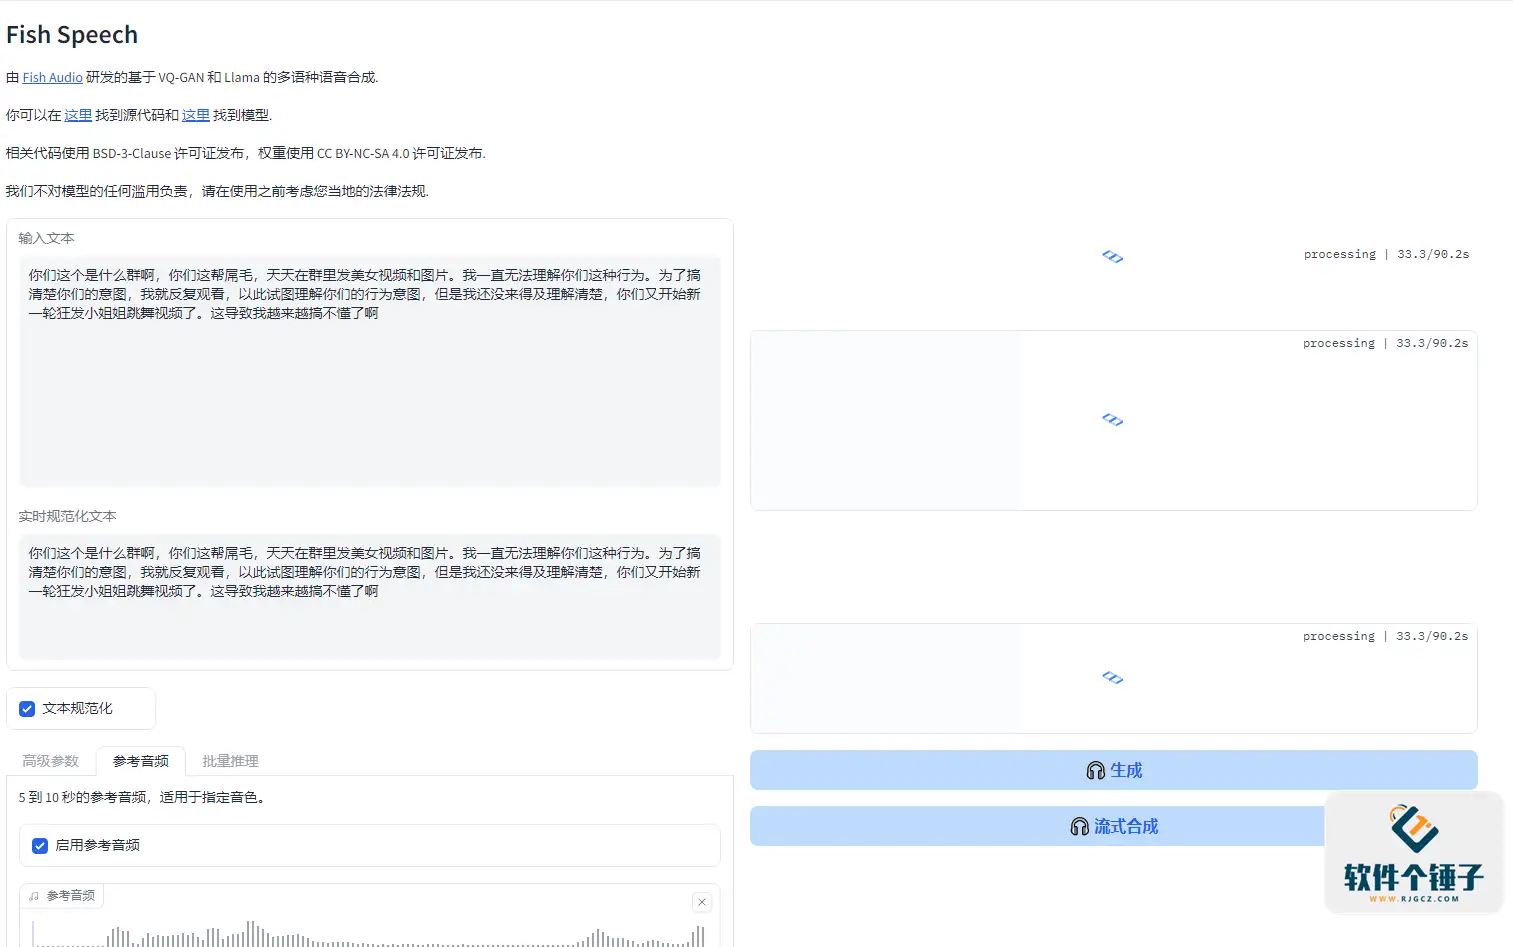

[R2341] Pakej Integrasi Satu Klik Teks ke Ucapan Menyokong Pengklonan Suara Fish Speech v1.5.0 Percuma Sumber Terbuka
-
Pelan Buat Duit Farming Emas Permainan: Jana 1k+ Sehari, Projek Stabil 3 Tahun, Orang Biasa Boleh Buat Pada Masa Lapang
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pendapatan automatik sepenuhnya permainan popular: 500+ sehari, tiada pengalaman, operasi mudah - kerja sampingan pendapatan permainan jangka panjang paling stabil (didedahkan)
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Tikus berjasa kali ini! Jangan panik dengan masalah format Windows - alat penukaran format FlyingMouse sumber terbuka membantu, permata GitHub popular
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Bootcamp Jualan Produk Douyin Dengan Bimbingan: Tak Perlu Muncul Di Kamera, Pendatang Baharu Ikut Langkah Hasilkan Video Pendek Jualan
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pelan jana wang game terbitan pertama: 1K+ sehari, orang biasa boleh lakukan pada masa lapang
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli






-
Tikus berjasa kali ini! Jangan panik dengan masalah format Windows - alat penukaran format FlyingMouse sumber terbuka membantu, permata GitHub popular
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Master Lu v6.1024.4105.1121 versi fail tunggal yang diringkaskan [Perisian Ge Chuizi·R1880]
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Perisian Animasi Kartun 2D Moho Pro v14.3 [Perisian Ge Chuzi · R2355]
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Perisian penyuntingan dan pemprosesan video untuk komputer Aiseesoft Filmai v1.0.18 【Software Ge Chuizi·R2470】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Microsoft To Do v2.147 versi rasmi percuma【Software Ge Chuizi·R2618】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pemalam osiloskop pembetulan warna video PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Perisian Ge Chui Zi·R2748】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli





Fish Speech ialah teknologi teks ke ucapan (TTS) baharu yang diperkenalkan oleh pasukan Fish Audio, bertujuan menggunakan teknologi pembelajaran mesin dan pembelajaran mendalam termaju untuk menukar teks kepada output ucapan yang semula jadi dan lancar. Projek ini diterbitkan di bawah lesen CC-BY-NC-SA-4.0, bermakna pengguna boleh menggunakan, mengubah suai dan berkongsi kod serta modelnya secara percuma dengan syarat mematuhi terma yang berkaitan.
Kelebihan Teknologi
Projek Fish Speech menggunakan banyak teknologi AI terkemuka, termasuk seni bina Transformer, VQ-GAN, Llama dan VITS. Gabungan teknologi ini membolehkan model lebih memahami dan menjana ucapan bagi urutan teks yang panjang, meningkatkan ketepatan dan kecekapan penjanaan ucapan. Mekanisme perhatian kendiri dalam seni bina Transformer menjadikan prestasi sintesis ucapan lebih halus, sekali gus meningkatkan kelajuan penjanaan secara mendadak. Selain itu, Fish Speech juga menggabungkan pembelajaran pelbagai tugas dan teknologi vokoder rangkaian neural yang cekap, membolehkannya mengendalikan tugas sintesis ucapan yang kompleks dengan mudah, memberikan kesan ucapan yang lancar dan semula jadi.

Fungsi utama
- Sokongan bahasa
Fish Speech menyokong pelbagai bahasa seperti Cina, Jepun dan Inggeris, serta mempunyai keupayaan sintesis ucapan merentas bahasa yang kuat untuk memenuhi keperluan pengguna global. - Ekspresi Emosi
Teknologi ini bukan sahaja boleh mensintesis ucapan Mandarin, malah boleh menjana ucapan yang penuh emosi seperti gembira, sedih, marah dan sebagainya, menjadikan ucapan lebih hidup dan meningkatkan daya ekspresi. - Pengklonan Suara
Fish Speech mempunyai fungsi pengklonan suara, yang boleh melalui latihan dengan sampel ucapan yang sedikit, meniru ciri suara penutur tertentu dengan tepat, dan merealisasikan sintesis ucapan yang diperibadikan. - Sintesis Ucapan Masa Nyata
Menyokong penjanaan ucapan masa nyata dengan kependaman rendah, sangat sesuai untuk senario aplikasi yang memerlukan maklum balas segera seperti perkhidmatan pelanggan dalam talian, chatbot dan sebagainya. - Cekap dan Ringan
Walaupun berkuasa, keperluan operasi Fish Speech tidaklah tinggi. Hanya GPU dengan 4GB memori video diperlukan untuk berjalan dengan lancar, sekali gus mengurangkan halangan penggunaan perkakasan dengan ketara.
Senario penggunaan
Fungsi dan fleksibiliti Fish Speech yang berkuasa menjadikannya sesuai untuk pelbagai bidang, termasuk pembantu pintar, chatbot, teknologi kebolehcapaian, pendidikan, penciptaan kandungan, pembangunan permainan dan perkhidmatan pelanggan. Sama ada perbualan harian atau aplikasi profesional, ia boleh memberikan pengalaman ucapan yang tepat dan semula jadi.

Sumber Terbuka dan Komuniti
Fish Speech adalah sumber terbuka sepenuhnya, pengguna bukan sahaja boleh menggunakan dan mengubah suai kod projek dengan bebas, malah boleh melakukan pembangunan sekunder mengikut keperluan peribadi. Pasukan Fish Audio dan komuniti sumber terbuka juga terus berusaha, sentiasa mengoptimumkan projek untuk membawa pengalaman yang lebih baik kepada pengguna global.
Kesimpulan
Ringkasnya, Fish Speech ialah alat teks ke ucapan sumber terbuka yang cekap, berkuasa dan mudah digunakan, dengan prospek aplikasi yang luas. Jika anda berminat dengan teknologi sintesis ucapan, apa kata lawati GitHub, ikuti dan cuba projek Fish Speech!
Tentang Prestasi
Saya menguji dengan kad grafik 4070ti Super saya selama satu petang, menjana fail ucapan 29 saat mengambil masa kira-kira 130 saat, penggunaan memori video sangat rendah, dianggarkan kad grafik dengan 6GB memori video sudah cukup untuk berjalan dengan lancar. Semasa ujian, kipas kad grafik hampir tidak bergerak langsung, operasi sangat stabil.
Disertakan Demo Audio
Di bawah disertakan demo audio, tidak tahu sama ada semua orang boleh meneka model suara rujukan yang mana.
Kurs Berkaitan

Kotak alat tempatan super! Rakaman skrin, potong & gabung audio/video, mampat & ekstrak video terbina dalam, percuma selamanya - Kedou Video Converter

Alat percuma sempurna 100%%! Perisian PDF serba boleh sehenti: penukaran, pemampatan, penyuntingan PDF dll., minimalis, tiada iklan, sangat bagus - JOPDF

Alat Desktop Jauh Sumber Terbuka, Mengatasi Versi Berbayar! Percuma untuk Kegunaan Peribadi dan Komersial Tanpa Had, Merentas Platform, HopToDesk

Alat Muat Turun Buku Teks Sekolah Terkini: Sokong Muat Turun Seluruh Tingkatan, Bahan Kursus·Video·Audio Satu Klik

HuyanBao: aplikasi penjaga mata cahaya biru percuma untuk komputer, dengan peringatan rehat haiwan peliharaan

Windows juga boleh ada Pulau Dinamik desktop! Pusat kawalan sistem moden, beri komputer anda takuk hitam tambahan, PyIsland

Penghasilan Drama Komik Realistik 3D: Kursus Amali Penuh Seedance2.0

Sokongan Win/Mac! Versi seumur hidup terkini, pemulihan foto lama, peningkatan imej tanpa kehilangan kualiti Aiarty Image Enhancer

Kursus video dalam talian: Github / B / 8K / Bilidown

Koleksi Alat Desktop Windows! 50+ Widget Desktop Minimalis Praktis Terbina, Termasuk Tangkapan Skrin, Rakaman Skrin, Terjemahan, Cuaca dsb. — DuoMi Toolbox

