


-
Cursos de negócio solo
-
 Outros
-
Tutoriais no exterior
-
Fotografia & Edição
-
Comunidade & Domínio privado
-
Escrita & Copywriting para mídias
-
Projetos de renda extra
-
Comércio eletrônico
-
Vídeo curto & Transmissão ao vivo
-
Inteligência Artificial (IA)
-
Software & Ferramentas
-
Sistemas operacionais
-
Plugins & Scripts
-
Software MacOS
-
Software Android
-
Software Windows
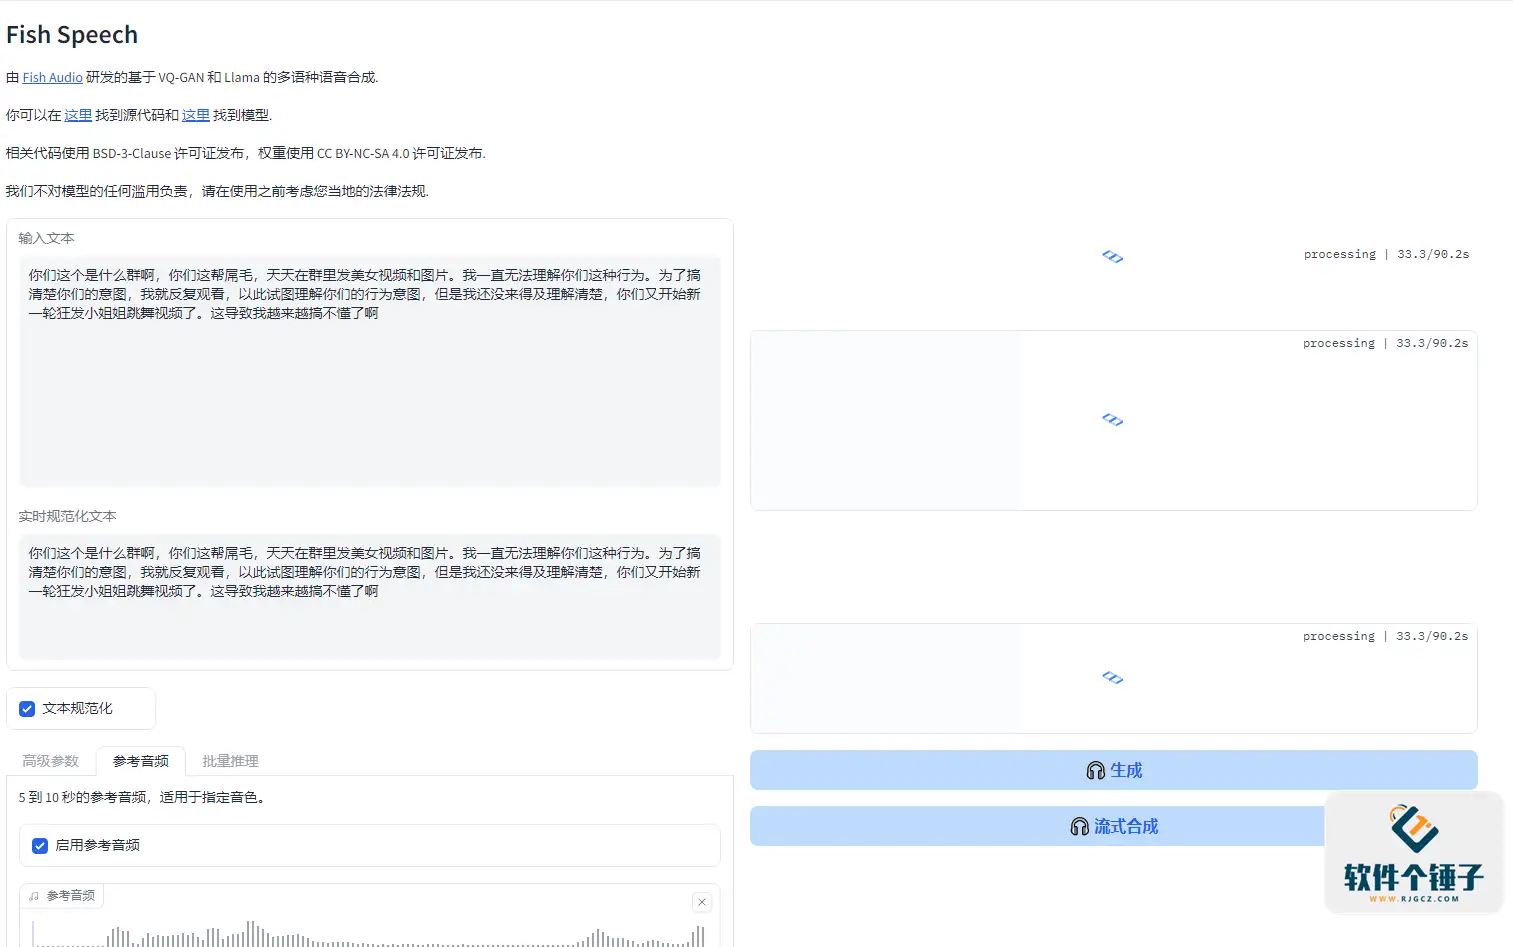

【R2341】Pacote tudo-em-um de conversão de texto em fala com suporte a clonagem de voz Fish Speech v1.5.0 gratuito e de código aberto
-
Plano de Renda com Farm de Ouro em Jogos: ganhe mais de mil por dia, um projeto estável de 3 anos que qualquer pessoa faz no tempo livre
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Curso SOP sistemático de mangá-drama de IA: seleção de webnovels, roteiro, texto para imagem, imagem para vídeo, dublagem e edição – tutorial padronizado de ponta a ponta (atual. 26/08)
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Farming automatizado de jogos populares: 500+/dia, sem experiência, simples – o extra estável a longo prazo mais fiável [Revelado]
Material de estudo de referência — incluído com a assinatura Obter assinatura -
ShuShu desta vez se safou! Não entre em pânico com problemas de formato do Windows: a ferramenta de código aberto ShuShu Format Converter, uma joia popular no GitHub
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Campo de acompanhamento de vendas no Douyin: sem aparecer, iniciantes copiam modelos e produzem vídeos
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Plano de renda com farming de jogos no lançamento: mais de 1.000 por dia, viável para pessoas comuns no tempo livre! [Revelado]
Material de estudo de referência — incluído com a assinatura Obter assinatura






-
ShuShu desta vez se safou! Não entre em pânico com problemas de formato do Windows: a ferramenta de código aberto ShuShu Format Converter, uma joia popular no GitHub
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Lu Master v6.1024.4105.1121, versão enxuta em arquivo único【Software Ge Chui Zi·R1880】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Software de criação de animação de cartoon 2D Moho Pro v14.3 [Software Ge Chuzi · R2355]
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Software de edição e processamento de vídeo para computador Aiseesoft Filmai v1.0.18 【Software Ge Chuzi·R2470】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Microsoft To Do v2.147 Versão oficial gratuita【Software Ge Chuizi·R2618】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Plugin de osciloscópio de correção de cor de vídeo para PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Ge Chui Zi·R2748】
Material de estudo de referência — incluído com a assinatura Obter assinatura





Fish Speech é uma nova tecnologia de conversão de texto em fala (TTS) lançada pela equipe Fish Audio, com o objetivo de usar as mais avançadas tecnologias de aprendizado de máquina e aprendizado profundo para converter texto em saída de fala natural e fluente. Este projeto é publicado sob a licença CC-BY-NC-SA-4.0, o que significa que os usuários podem usar, modificar e compartilhar gratuitamente seu código e modelos, desde que cumpram os termos relevantes.
Destaques técnicos
O projeto Fish Speech adota inúmeras tecnologias de IA líderes, incluindo a arquitetura Transformer, VQ-GAN, Llama e VITS, entre outras. A combinação dessas tecnologias permite que o modelo compreenda e gere melhor a fala de sequências de texto longas, melhorando a precisão e a eficiência da geração de fala. É o mecanismo de autoatenção da arquitetura Transformer que torna o desempenho da síntese de fala mais refinado e aumenta significativamente a velocidade de geração. Além disso, o Fish Speech também combina aprendizado multitarefa com tecnologia eficiente de vocoder de rede neural, permitindo que ele lide facilmente com tarefas complexas de síntese de fala, proporcionando efeitos de fala fluidos e naturais.

Funções principais
- Suporte a idiomas
O Fish Speech suporta chinês, japonês, inglês e vários outros idiomas, possuindo uma poderosa função de síntese de fala multilíngue, atendendo às necessidades de usuários globais. - Expressão emocional
Essa tecnologia não só consegue sintetizar fala em mandarim, mas também gerar fala rica em emoções, como: alegria, tristeza, raiva, etc., tornando a fala mais vívida e aumentando a expressividade. - Clonagem de voz
O Fish Speech possui função de clonagem de voz, capaz de imitar com precisão as características vocais de um falante específico por meio de treinamento com poucas amostras de voz, realizando síntese de fala personalizada. - Síntese de fala em tempo real
Suporta geração de fala em tempo real com baixa latência, ideal para cenários de aplicação que exigem feedback instantâneo, como atendimento online, chatbots, etc. - Eficiente e leve
Apesar de ser poderoso, o Fish Speech não tem requisitos de execução elevados. Basta uma GPU com 4GB de memória de vídeo para funcionar sem problemas, reduzindo bastante a barreira de hardware.
Cenários de aplicação
As poderosas funções e flexibilidade do Fish Speech o tornam aplicável em diversas áreas, incluindo assistentes inteligentes, chatbots, tecnologia de acessibilidade, educação, criação de conteúdo, desenvolvimento de jogos e atendimento ao cliente, entre outras. Seja em conversas cotidianas ou aplicações profissionais, ele oferece uma experiência de fala precisa e natural.

Código aberto e comunidade
O Fish Speech é totalmente de código aberto; os usuários não só podem usar e modificar livremente o código do projeto, como também podem fazer desenvolvimento secundário de acordo com suas necessidades pessoais. A equipe Fish Audio e a comunidade de código aberto também continuam se esforçando para otimizar constantemente o projeto, trazendo uma experiência melhor para usuários globais.
Resumo
Em resumo, o Fish Speech é uma ferramenta de conversão de texto em fala de código aberto eficiente, poderosa e fácil de usar, com amplas perspectivas de aplicação. Se você tem interesse em tecnologia de síntese de fala, vale a pena ir ao GitHub, seguir e experimentar o projeto Fish Speech!
Sobre o desempenho
Testei com minha placa de vídeo 4070ti Super durante uma tarde inteira; gerar um arquivo de fala de 29 segundos leva cerca de 130 segundos, e o uso de memória de vídeo é muito baixo, estimo que uma placa com 6GB de memória de vídeo consiga rodar sem problemas. Durante o teste, a ventoinha da placa de vídeo quase não reagiu, funcionando de forma muito estável.
Demonstração de áudio anexada
Abaixo segue a demonstração de áudio; não sei se vocês conseguem adivinhar qual modelo de voz foi usado como referência.
Cursos relacionados

Poderosa caixa de ferramentas local! Gravação de tela, corte/fusão de áudio e vídeo, compressão/extração de vídeo, etc., gratuito permanente – Kedou Video Converter Master

100% perfeito e grátis! Software PDF tudo-em-um: conversão, compressão, edição, etc., limpo sem anúncios – JOPDF

Ferramenta de desktop remoto de código aberto, superior às versões pagas! Gratuita e ilimitada para uso pessoal e comercial, multiplataforma – HopToDesk

Ferramenta mais recente para baixar livros didáticos do ensino fundamental e médio: recursos de um ano inteiro, slides, vídeos e áudios com um clique

O dia todo olhando para a tela, como ficar sem uma ferramenta de proteção ocular? Aplicativo gratuito de proteção contra luz azul para PC, com um pet que te lembra de descansar na hora certa, Huyanbao

PyIsland: centro de controle do sistema moderno com Dynamic Island na área de trabalho do Windows

Produção de manhuá 3D simulado: prática completa do Seedance 2.0, do zero à criação de manhuá de alta qualidade

Compatível com Win/Mac! Última versão vitalícia: restaure fotos antigas, melhore a nitidez e amplie sem perda - Aiarty Image Enhancer

Ferramenta de download de Bilibili de código aberto no Github: download em lote de vídeos de Bilibili com suporte a 8K e Dolby Vision, fácil de usar, Bilidown

Coleção de ferramentas de desktop Windows! 50+ widgets de desktop práticos e minimalistas, com captura de tela, gravação de tela, tradução, previsão do tempo etc., caixa de ferramentas Duomi

Contact Info
- E-mail: massivesidehustles@outlook.com
