


-
Курсы для одиночного бизнеса
-
 Другое
-
Зарубежные курсы
-
Фотография & Монтаж
-
Сообщество & Приватная зона
-
Написание текстов & Копирайтинг для медиа
-
Проекты дополнительного дохода
-
Электронная коммерция
-
Короткие видео & Прямые эфиры
-
Искусственный интеллект (ИИ)
-
Программное обеспечение & Инструменты
-
Операционные системы
-
Плагины & Скрипты
-
Программы MacOS
-
Программы Android
-
Программы Windows
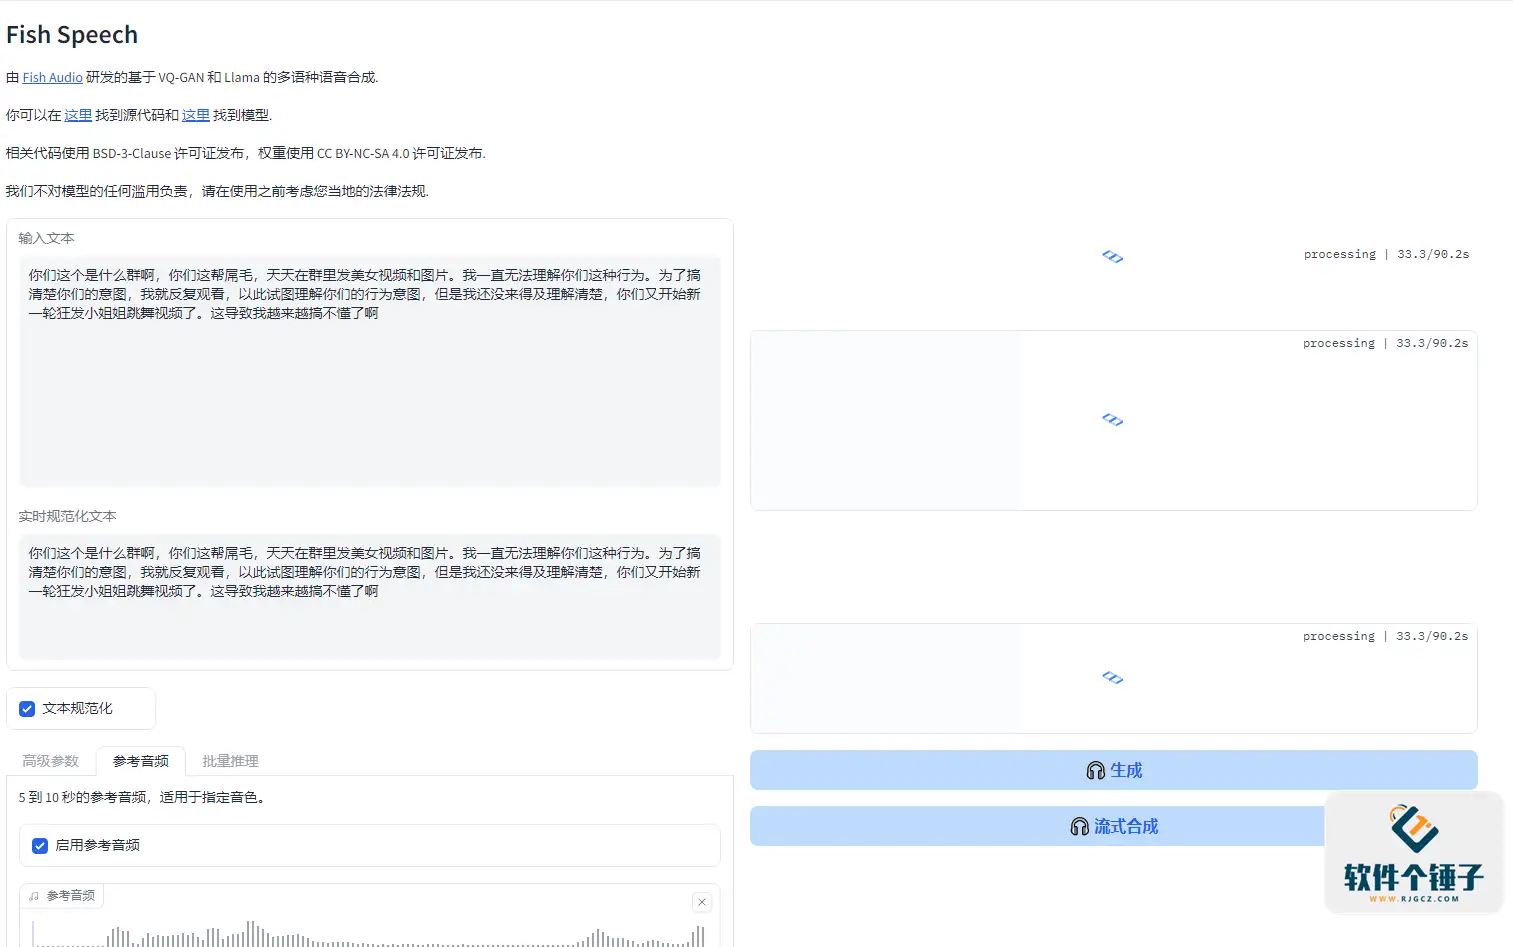

【R2341】Единый интегрированный пакет для преобразования текста в речь с поддержкой клонирования голоса Fish Speech v1.5.0, бесплатный и с открытым исходным кодом
-
Схема заработка на игровом фарме золота: 1000+ в день — стабильный проект на 3 года, который под силу каждому в свободное время
Справочный учебный материал — включён в подписку Оформить подписку -
Систематический курс SOP по AI-комикс-драме: отбор и адаптация веб-новелл, стандарты сценария, готовый фильм через text-to-image и image-to-video, озвучка и монтаж — стандартизированный туториал по полному внедрению (обновление 0826)
Справочный учебный материал — включён в подписку Оформить подписку -
Полностью автоматический фарм в популярных играх: 500+/день, без опыта, простой — самый стабильный долгосрочный игровой заработок [Секрет]
Справочный учебный материал — включён в подписку Оформить подписку -
Мышка на этот раз отличилась! Не паникуйте с проблемами форматов Windows — поможет открытый конвертер ShuShu Format Converter, популярная находка на GitHub
Справочный учебный материал — включён в подписку Оформить подписку -
Кампания сопровождения продаж в Douyin: без реального появления, новички копируют шаблоны и производят продающие видео
Справочный учебный материал — включён в подписку Оформить подписку -
Премьерный план заработка на игровом фарме: 1 000+ в день, обычному человеку по силам в свободное время! 【разоблачение】
Справочный учебный материал — включён в подписку Оформить подписку






-
Мышка на этот раз отличилась! Не паникуйте с проблемами форматов Windows — поможет открытый конвертер ShuShu Format Converter, популярная находка на GitHub
Справочный учебный материал — включён в подписку Оформить подписку -
鲁大师 v6.1024.4105.1121, упрощённая однофайловая версия
Справочный учебный материал — включён в подписку Оформить подписку -
Программное обеспечение для создания двумерной мультипликации Moho Pro v14.3
Справочный учебный материал — включён в подписку Оформить подписку -
Программа для редактирования и обработки видео на ПК Aiseesoft Filmai v1.0.18
Справочный учебный материал — включён в подписку Оформить подписку -
Microsoft To Do v2.147 официальная бесплатная версия
Справочный учебный материал — включён в подписку Оформить подписку -
Плагин-осциллограф для цветокоррекции видео PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138
Справочный учебный материал — включён в подписку Оформить подписку





Fish Speech - это новая технология преобразования текста в речь (TTS), представленная командой Fish Audio, цель которой - использование самых передовых технологий машинного обучения и глубокого обучения для преобразования текста в естественный и плавный речевой вывод. Этот проект выпущен под лицензией CC-BY-NC-SA-4.0, что означает, что пользователи могут бесплатно использовать, изменять и распространять его код и модели при соблюдении соответствующих условий.
Технические особенности
Проект Fish Speech использует множество передовых технологий ИИ, включая архитектуру Transformer, VQ-GAN, Llama и VITS. Сочетание этих технологий позволяет модели лучше понимать и генерировать речь для длинных текстовых последовательностей, повышая точность и эффективность генерации речи. Именно механизм самовнимания архитектуры Transformer делает синтез речи более детальным и значительно увеличивает скорость генерации. Кроме того, Fish Speech сочетает многозадачное обучение с эффективной технологией нейросетевого вокодера, что позволяет ему легко справляться со сложными задачами синтеза речи, обеспечивая плавный и естественный речевой эффект.

Ключевые функции
- Поддержка языков
Fish Speech поддерживает китайский, японский, английский и многие другие языки, обладает мощной функцией кросс-языкового синтеза речи, удовлетворяя потребности пользователей по всему миру. - Эмоциональная выразительность
Эта технология способна синтезировать не только речь на путунхуа, но и генерировать эмоционально окрашенную речь, например: радость, грусть, гнев и т. д., делая речь более живой и усиливая выразительность. - Клонирование голоса
Fish Speech обладает функцией клонирования голоса, позволяя с помощью обучения на небольшом количестве голосовых образцов точно имитировать голосовые характеристики конкретного говорящего и реализовать персонализированный синтез речи. - Синтез речи в реальном времени
Поддерживает генерацию речи в реальном времени с низкой задержкой, что идеально подходит для сценариев, требующих мгновенной обратной связи, таких как онлайн-поддержка, чат-боты и т. д. - Эффективность и лёгкость
Несмотря на мощный функционал, требования Fish Speech к запуску невысоки. Для плавной работы достаточно GPU с 4 ГБ видеопамяти, что значительно снижает порог использования оборудования.
Сценарии применения
Мощные функции и гибкость Fish Speech делают его применимым во многих областях, включая умных помощников, чат-ботов, технологии доступности, образование, создание контента, разработку игр и обслуживание клиентов и т. д. Будь то повседневный диалог или профессиональное применение, он обеспечивает точный и естественный речевой опыт.

Открытый исходный код и сообщество
Fish Speech полностью открыт, пользователи могут не только свободно использовать и изменять код проекта, но и дорабатывать его под свои нужды. Команда Fish Audio и сообщество открытого исходного кода также постоянно работают над оптимизацией проекта, чтобы предоставить пользователям по всему миру лучший опыт.
Итог
В целом, Fish Speech - это эффективный, мощный и простой в использовании инструмент преобразования текста в речь с открытым исходным кодом, имеющий широкие перспективы применения. Если вам интересна технология синтеза речи, загляните на GitHub, чтобы следить за проектом Fish Speech и попробовать его!
О производительности
Я тестировал со своей видеокартой 4070ti Super целый день, генерация 29-секундного аудиофайла занимает около 130 секунд, потребление видеопамяти очень низкое, предположительно видеокарты с 6 ГБ видеопамяти будет достаточно для плавной работы. В процессе тестирования вентиляторы видеокарты почти не реагировали, работа очень стабильная.
Прилагается аудиодемонстрация
Ниже прилагается аудиодемонстрация, интересно, сможете ли вы угадать, какая голосовая модель использовалась в качестве референса.
Похожие курсы

Отличный локальный набор инструментов! Встроенная запись экрана, нарезка и склейка аудио и видео, сжатие и извлечение видео, бесплатно навсегда — Kedou Video Converter


Бесплатный инструмент удалённого доступа с открытым кодом, лучше платных версий! Безлимитно бесплатно для частного и коммерческого использования, на всех платформах – HopToDesk

Новейший инструмент для скачивания учебников для школ: загрузка ресурсов целого класса, сопутствующие презентации, видео и аудио в один клик

Весь день пялишься в экран, как без защиты для глаз? Бесплатное приложение защиты от синего света ПК, еще и питомец напоминает о перерыве, Huyanbao

PyIsland: современный центр управления системой с Dynamic Island на рабочем столе Windows

Производство 3D-иммерсивных маньхуа-драм: полный цикл Seedance 2.0, от 0 до качественной постановки

Для Win и Mac! Свежая бессрочная версия: восстановление старых фото, повышение чёткости и увеличение без потерь - Aiarty Image Enhancer

Открытый GitHub-инструмент для скачивания Bilibili: пакетное скачивание видео Bilibili с поддержкой 8K и Dolby Vision, прост в использовании, Bilidown

Набор настольных инструментов для Windows: 50+ практичных минималистичных виджетов, скриншот, запись экрана, перевод, погода и др. – инструментарий Доми

Contact Info
- Эл. почта: massivesidehustles@outlook.com
