


-
دورات ريادة الأعمال
-
 أخرى
-
دروس من الخارج
-
التصوير والتحرير
-
إدارة المجتمع والنطاق الخاص
-
كتابة المحتوى وكتابة الإعلانات
-
مشاريع الدخل الجانبي
-
التجارة الإلكترونية
-
الفيديو القصير والبث المباشر
-
الذكاء الاصطناعي (AI)
-
البرمجيات والأدوات
-
أنظمة التشغيل
-
الإضافات والسكربتات
-
برمجيات MacOS
-
برمجيات Android
-
برمجيات Windows
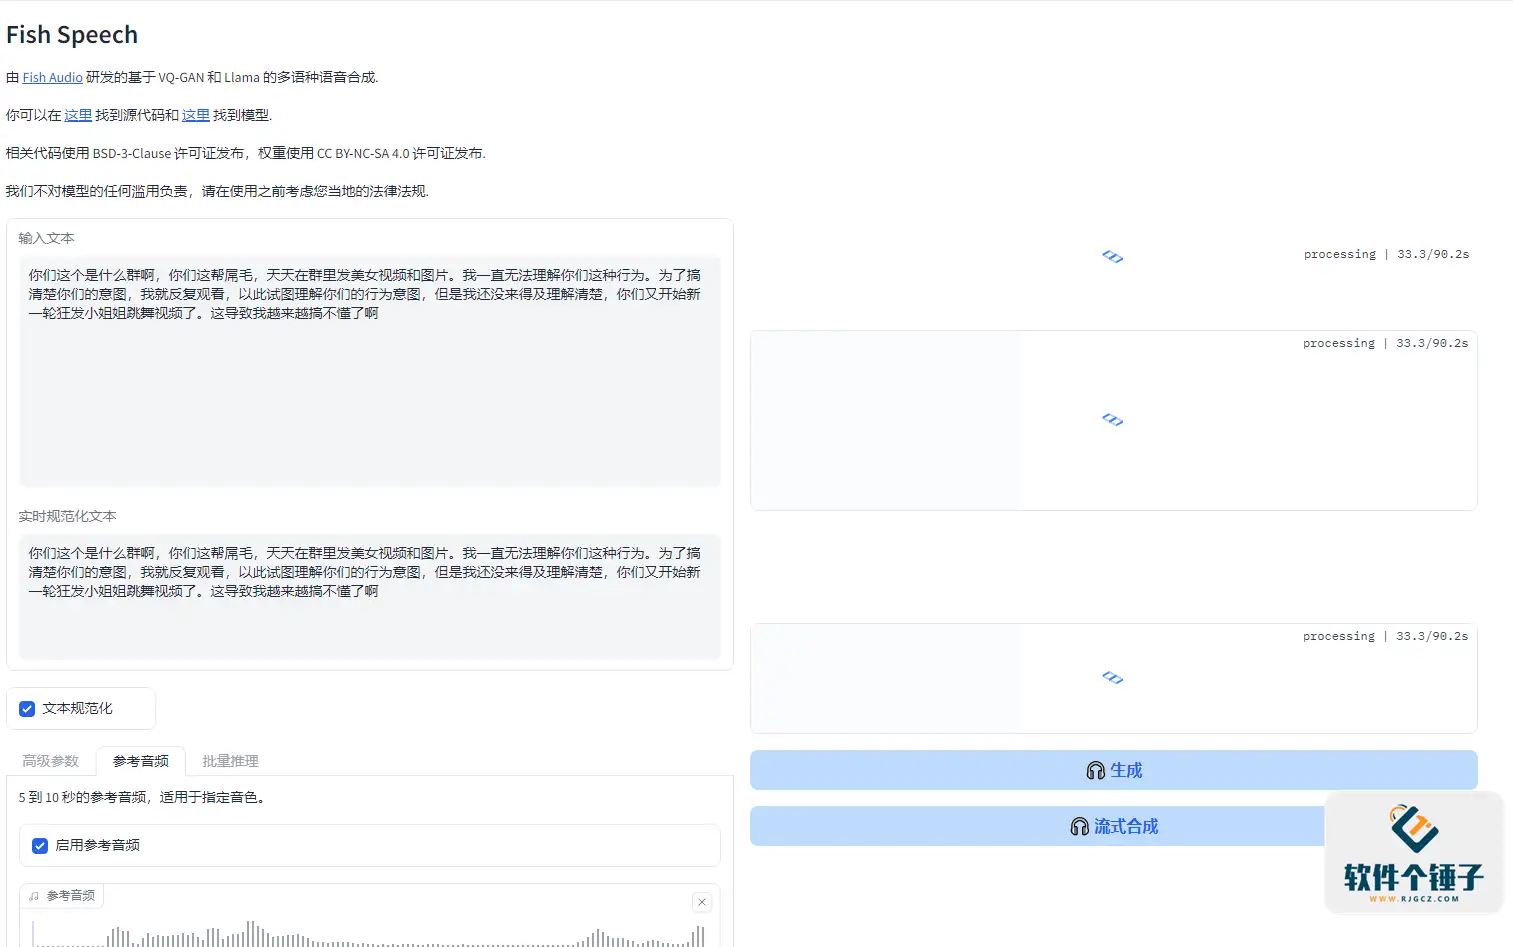

【R2341】حزمة تحويل النص إلى كلام المتكاملة بنقرة واحدة، تدعم استنساخ الصوت Fish Speech v1.5.0 مجاني ومفتوح المصدر
-
خطة كسب المال من زراعة الذهب في الألعاب: اكسب أكثر من ألف يومياً، مشروع مستقر منذ ثلاث سنوات، يمكن لأي شخص فعله في وقت الفراغ
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
العمل التلقائي الكامل داخل الألعاب الرائجة: ربح يومي 500+، دون خبرة وتشغيل بسيط، وهو حالياً أكثر الأعمال الجانبية طويلة الأجل استقراراً كشف
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
معسكر تدريب مشروع بيع المنتجات على دوين: لا حاجة للظهور أمام الكاميرا، المبتدئون ينتجون فيديوهات بيع المنتجات باتباع الخطوات
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
خطة العمل داخل الألعاب الأولى لكسب المال: ربح يومي 1000+، ويستطيع الشخص العادي القيام بها في وقت فراغه كشف
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن






-
Lu Master v6.1024.4105.1121 نسخة مبسطة بملف واحد [Ge Chuzi Software · R1880]
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
برنامج إنشاء رسوم متحركة كرتونية ثنائية الأبعاد Moho Pro v14.3 [برنامج جي تشويزي · R2355]
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
برنامج تحرير ومعالجة الفيديو للحاسوب Aiseesoft Filmai v1.0.18
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
Microsoft To Do v2.147 النسخة الرسمية المجانية
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
PR/AE/DaVinci/FCPX إضافة راسم إشارة تدريج ألوان الفيديو Nobe OmniScope Win1.11.15 / Mac1.10.138【البرمجيات·R2748】
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن





Fish Speech هو تقنية جديدة لتحويل النص إلى كلام (TTS) أطلقها فريق Fish Audio، ويهدف إلى استخدام أحدث تقنيات التعلم الآلي والتعلم العميق لتحويل النص إلى إخراج صوتي طبيعي وسلس. تم إصدار هذا المشروع بموجب رخصة CC-BY-NC-SA-4.0، مما يعني أنه يمكن للمستخدمين استخدام وتعديل ومشاركة الكود والنماذج مجاناً مع الالتزام بالشروط ذات الصلة.
أبرز المزايا التقنية
يعتمد مشروع Fish Speech على العديد من تقنيات الذكاء الاصطناعي الرائدة، بما في ذلك بنية Transformer و VQ-GAN و Llama و VITS وغيرها. هذا المزيج من التقنيات يمكّن النموذج من فهم وإنتاج صوت لتسلسلات نصية طويلة بشكل أفضل، مما يحسّن دقة وكفاءة توليد الصوت. وتحديداً آلية الانتباه الذاتي في بنية Transformer، التي تجعل أداء تركيب الصوت أكثر دقة وترفع سرعة التوليد بشكل كبير. بالإضافة إلى ذلك، يدمج Fish Speech التعلم متعدد المهام وتقنية مرمّز صوتي عصبي عالي الكفاءة، مما يمكّنه من التعامل بسهولة مع مهام تركيب الصوت المعقدة وتقديم تأثيرات صوتية سلسة وطبيعية.

الميزات الأساسية
- دعم اللغات
يدعم Fish Speech لغات متعددة مثل الصينية واليابانية والإنجليزية، ويتمتع بقدرة قوية على تركيب الصوت عبر اللغات، مما يلبي احتياجات المستخدمين حول العالم. - التعبير العاطفي
لا تقتصر هذه التقنية على تركيب الكلام باللغة الصينية الفصحى فحسب، بل يمكنها أيضاً توليد صوت مليء بالمشاعر، مثل: الفرح والحزن والغضب وغيرها، مما يجعل الصوت أكثر حيوية ويعزز التعبيرية. - استنساخ الصوت
يتمتع Fish Speech بوظيفة استنساخ الصوت، حيث يمكنه من خلال التدريب على عدد قليل من عينات الصوت تقليد الخصائص الصوتية لمتحدث معين بدقة، وتحقيق تركيب صوتي مخصص. - تركيب الصوت في الوقت الفعلي
يدعم توليد الصوت في الوقت الفعلي بزمن استجابة منخفض، وهو مناسب جداً لسيناريوهات التطبيقات التي تتطلب ردوداً فورية، مثل خدمة العملاء عبر الإنترنت وروبوتات الدردشة وغيرها. - كفاءة وخفّة
على الرغم من قوته الكبيرة، فإن متطلبات تشغيل Fish Speech ليست عالية. يكفي وحدة معالجة رسومات (GPU) بذاكرة 4GB لتشغيله بسلاسة، مما يقلل بشكل كبير من عتبة متطلبات الأجهزة.
حالات الاستخدام
تجعل وظائف Fish Speech القوية ومرونته مناسباً للعديد من المجالات، بما في ذلك المساعدون الأذكياء وروبوتات الدردشة وتقنيات إمكانية الوصول والتعليم وإنشاء المحتوى وتطوير الألعاب وخدمة العملاء وغيرها. سواء كان محادثة يومية أو تطبيقاً احترافياً، فإنه يوفر تجربة صوتية دقيقة وطبيعية.

المصدر المفتوح والمجتمع
Fish Speech مفتوح المصدر بالكامل، حيث يمكن للمستخدمين ليس فقط استخدام وتعديل كود المشروع بحرية، بل أيضاً إجراء تطوير ثانوي وفقاً لاحتياجاتهم الشخصية. كما يواصل فريق Fish Audio ومجتمع المصدر المفتوح جهودهما المستمرة لتحسين المشروع باستمرار وتقديم تجربة أفضل للمستخدمين حول العالم.
الخلاصة
باختصار، Fish Speech هو أداة تحويل النص إلى كلام مفتوحة المصدر عالية الكفاءة وقوية وسهلة الاستخدام، ولها آفاق تطبيقية واسعة. إذا كنت مهتماً بتقنية تركيب الصوت، فلا تتردد في زيارة GitHub ومتابعة مشروع Fish Speech وتجربته!
حول الأداء
اختبرته ببطاقة الرسوميات 4070ti Super الخاصة بي طوال فترة بعد الظهر، ويستغرق توليد ملف صوتي مدته 29 ثانية حوالي 130 ثانية، واستهلاك ذاكرة الرسوميات منخفض جداً، وأقدّر أن بطاقة رسوميات بذاكرة 6GB يمكنها التشغيل بسلاسة. خلال الاختبار، لم تتحرك مروحة بطاقة الرسوميات تقريباً إطلاقاً، وكان التشغيل مستقراً جداً.
مرفق عرض صوتي
فيما يلي عرض صوتي مرفق، لا أعرف إن كان بإمكانكم تخمين نموذج الصوت المرجعي المستخدم.
دورات ذات صلة

صندوق أدوات محلي خارق: يتضمن تسجيل الشاشة وقص ودمج الصوت والفيديو وضغط الفيديو واستخراجه مجاناً للأبد، تحويل الفيديو

أداة مجانية مثالية 100%: برنامج PDF متعدد الوظائف من مكان واحد، تحويل وضغط وتحرير PDF وغيرها، بسيط بلا إعلانات، JOPDF

أداة سطح المكتب البعيد مفتوحة المصدر، تتفوق على النسخ المدفوعة! مجاني للاستخدام الشخصي والتجاري بلا حدود، تدعم جميع المنصات، HopToDesk

أحدث أداة تنزيل كتب المرحلة المدرسية: تنزيل دفعي لصف دراسي كامل، والوسائط التعليمية والفيديوهات والصوتيات بنقرة واحدة

هويان باو: تطبيق حماية العين من الضوء الأزرق مجاناً مع تذكيرات استراحة بالحيوانات

ويندوز يمكنه الحصول على جزيرة ديناميكية على سطح المكتب! مركز تحكم حديث يضيف نتوءاً أسود لجهازك — PyIsland

إنتاج دراما مصورة ثلاثية الأبعاد واقعية: دورة Seedance2.0 العملية الكاملة من الصفر إلى إنشاء محتوى عالي الجودة

يدعم ويندوز وماك! أحدث إصدار دائم مدى الحياة، إصلاح الصور القديمة، تكبير الصور بلا فقدان الجودة Aiarty Image Enhancer

دورة تدريبية عبر الإنترنت: أداة Github مفتوحة المصدر لتنزيل فيديوهات Bilibili / تدعم 8K وDolby Vision / Bilidown


معلومات الاتصال
- البريد الإلكتروني: massivesidehustles@outlook.com
