


-
คอร์สธุรกิจ
-
 อื่น ๆ
-
บทเรียนจากต่างประเทศ
-
การถ่ายภาพ & ตัดต่อ
-
การดูแลชุมชน & โดเมนส่วนตัว
-
การเขียนสื่อส่วนตัว & การเขียนโฆษณา
-
โปรเจกต์รายได้เสริม
-
อีคอมเมิร์ซ
-
วิดีโอสั้น & สตรีมสด
-
ปัญญาประดิษฐ์ (AI)
-
ซอฟต์แวร์และเครื่องมือ
-
ระบบปฏิบัติการ
-
ปลั๊กอินและสคริปต์
-
ซอฟต์แวร์ MacOS
-
ซอฟต์แวร์ Android
-
ซอฟต์แวร์ Windows
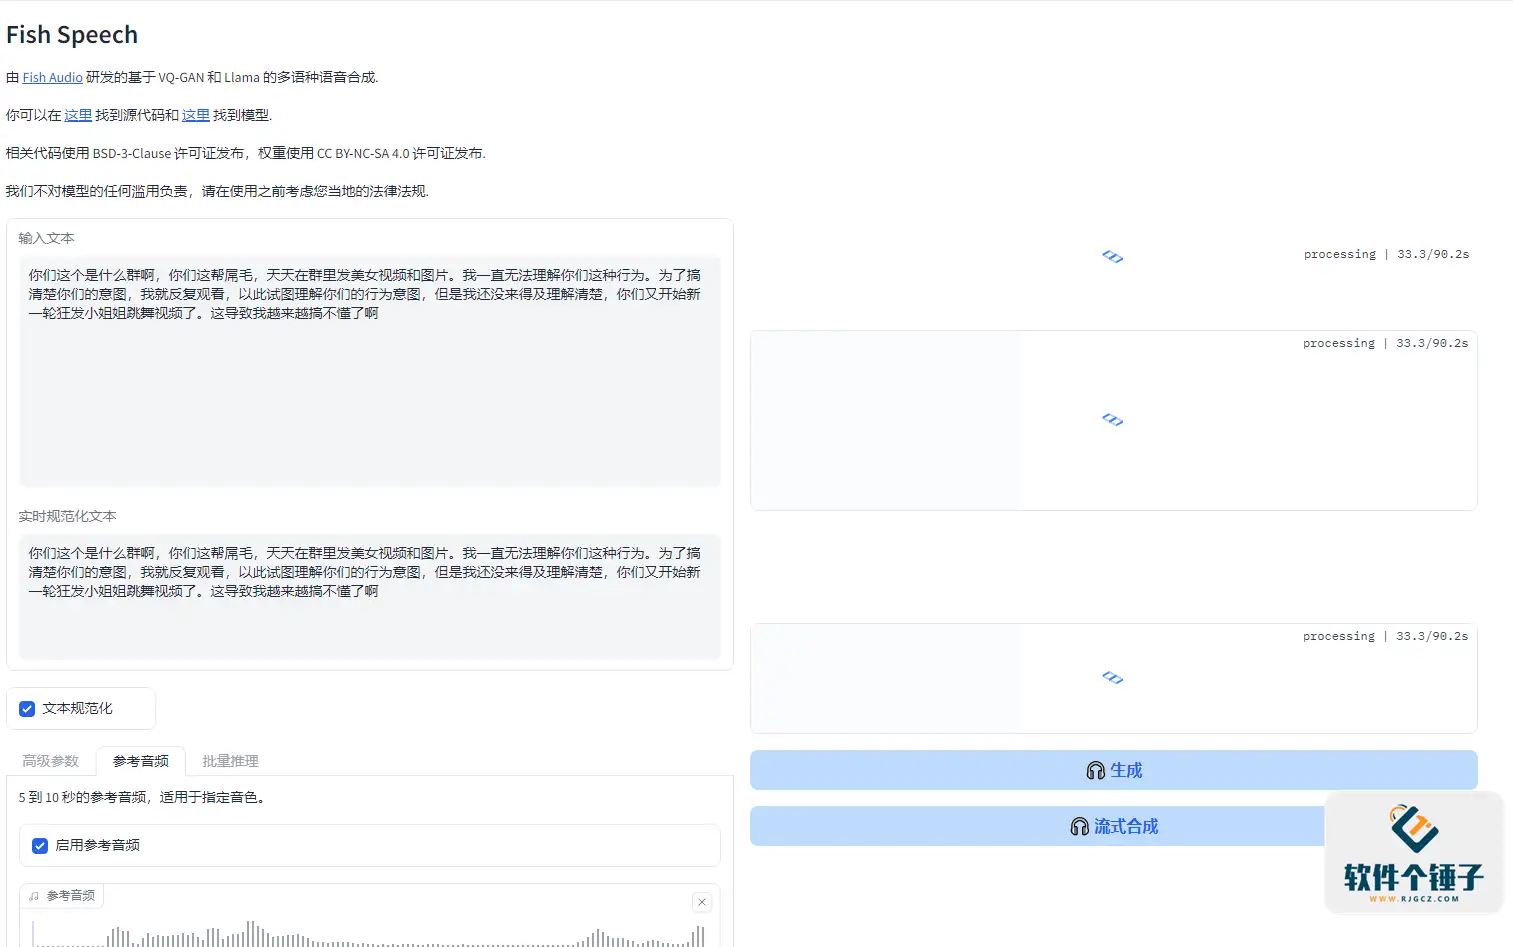

【R2341】ชุดรวม Text-to-Speech ครบจบในตัว รองรับการโคลนเสียง Fish Speech v1.5.0 ฟรีโอเพนซอร์ส
-
แผนหาเงินจากการฟาร์มเกม: รายได้ 1k+ ต่อวัน โปรเจกต์เก่าที่มั่นคงมา 3 ปี คนทั่วไปใช้เวลาว่างก็ทำได้!【เปิดเผย】
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
คอร์สระบบ SOP คอมิกดราม่า AI: การกรองและดัดแปลงนิยายเว็บ กฎบทละคร ข้อความต่อภาพ/ภาพต่อวิดีโองานจบ พากย์และตัดต่อ - สอนลงมือระบบครบวงจร (อัปเดต 0826)
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
การหารายได้เกมฮอตแบบอัตโนมัติเต็มรูปแบบ: 500+ ต่อวัน ไม่ต้องมีประสบการณ์ ดำเนินงานง่าย - อาชีพเสริมหารายได้จากเกมระยะยาวที่มั่นคงที่สุด (เปิดเผย)
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
คราวนี้หนูทำได้ดี! อย่าตื่นกลัวกับปัญหาฟอร์แมต Windows เครื่องมือแปลงฟอร์แมตโอเพนซอร์ส FlyingMouse มาช่วย เครื่องมือขุมทรัพย์ยอดนิยมบน GitHub
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
ค่ายฝึกขายของ Douyin พร้อมโค้ช: ไม่ต้องหน้ากล้อง มือใหม่ทำตามขั้นตอนก็ได้วิดีโอขายของ
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
แผนหาเงินเกมวางแรก: วันละ 1000+ คนทั่วไปใช้เวลาว่างทำได้! [เผย]
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก






-
คราวนี้หนูทำได้ดี! อย่าตื่นกลัวกับปัญหาฟอร์แมต Windows เครื่องมือแปลงฟอร์แมตโอเพนซอร์ส FlyingMouse มาช่วย เครื่องมือขุมทรัพย์ยอดนิยมบน GitHub
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
LuMaster v6.1024.4105.1121 เวอร์ชันย่อไฟล์เดียว[ซอฟต์แวร์ค้อน·R1880]
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
ซอฟต์แวร์สร้างแอนิเมชันการ์ตูน 2D Moho Pro v14.3
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
ซอฟต์แวร์ตัดต่อวิดีโอสำหรับคอมพิวเตอร์ Aiseesoft Filmai v1.0.18
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
Microsoft To Do v2.147 เวอร์ชันฟรีอย่างเป็นทางการ
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก -
PR/AE/DaVinci/FCPX ปลั๊กอินออสซิลโลสโคปปรับสีวิดีโอ Nobe OmniScope Win1.11.15 / Mac1.10.138【ซอฟต์แวร์ก้อกุยจื่อ·R2748】
เอกสารเรียนรู้เพื่ออ้างอิง — รวมอยู่ในสมาชิก สมัครสมาชิก





Fish Speech เป็นเทคโนโลยี Text-to-Speech (TTS) ใหม่ล่าสุดที่พัฒนาโดยทีม Fish Audio โดยมีเป้าหมายที่จะแปลงข้อความเป็นเสียงพูดที่เป็นธรรมชาติและลื่นไหลด้วยเทคโนโลยีแมชชีนเลิร์นนิงและดีพเลิร์นนิงที่ทันสมัยที่สุด โปรเจกต์นี้เผยแพร่ภายใต้สัญญาอนุญาต CC-BY-NC-SA-4.0 ซึ่งหมายความว่าผู้ใช้สามารถใช้ แก้ไข และแชร์โค้ดและโมเดลได้ฟรีภายใต้เงื่อนไขที่กำหนด
จุดเด่นทางเทคโนโลยี
โปรเจกต์ Fish Speech ใช้เทคโนโลยี AI ชั้นนำมากมาย รวมถึงสถาปัตยกรรม Transformer, VQ-GAN, Llama และ VITS การผสมผสานเทคโนโลยีเหล่านี้ทำให้โมเดลสามารถเข้าใจและสร้างเสียงจากลำดับข้อความยาวๆ ได้ดีขึ้น เพิ่มความแม่นยำและประสิทธิภาพในการสร้างเสียง โดยเฉพาะกลไก self-attention ของสถาปัตยกรรม Transformer ที่ทำให้การสังเคราะห์เสียงมีความละเอียดอ่อนมากขึ้นและเพิ่มความเร็วในการสร้างอย่างมาก นอกจากนี้ Fish Speech ยังผสมผสานการเรียนรู้แบบ multi-task และเทคโนโลยี neural network vocoder ที่มีประสิทธิภาพ ทำให้สามารถจัดการงานสังเคราะห์เสียงที่ซับซ้อนได้อย่างง่ายดาย ให้ผลลัพธ์เสียงที่ลื่นไหลและเป็นธรรมชาติ

ฟังก์ชันหลัก
- การรองรับภาษา
Fish Speech รองรับหลายภาษา เช่น จีน ญี่ปุ่น อังกฤษ และอื่นๆ มีความสามารถในการสังเคราะห์เสียงข้ามภาษาที่ทรงพลัง ตอบโจทย์ความต้องการของผู้ใช้ทั่วโลก - การแสดงอารมณ์
เทคโนโลยีนี้ไม่เพียงแต่สังเคราะห์เสียงภาษาจีนกลางได้เท่านั้น แต่ยังสร้างเสียงที่เต็มไปด้วยอารมณ์ เช่น ความสุข ความเศร้า ความโกรธ ทำให้เสียงมีชีวิตชีวามากขึ้นและเพิ่มพลังในการสื่อสาร - การโคลนเสียง
Fish Speech มีฟีเจอร์การโคลนเสียง สามารถฝึกด้วยตัวอย่างเสียงจำนวนน้อยเพื่อเลียนแบบลักษณะเสียงของลำโพงเฉพาะได้อย่างแม่นยำ ทำให้สามารถสังเคราะห์เสียงแบบเฉพาะบุคคลได้ - การสังเคราะห์เสียงแบบเรียลไทม์
รองรับการสร้างเสียงแบบเรียลไทม์ที่มีความหน่วงต่ำ เหมาะมากสำหรับสถานการณ์ที่ต้องการการตอบสนองทันที เช่น ศูนย์บริการออนไลน์ แชทบอท เป็นต้น - มีประสิทธิภาพและน้ำหนักเบา
แม้ว่าจะมีฟีเจอร์ที่ทรงพลัง แต่ความต้องการในการรัน Fish Speech ก็ไม่สูง เพียงใช้ GPU ที่มี VRAM 4GB ก็สามารถรันได้อย่างลื่นไหล ลดอุปสรรคด้านฮาร์ดแวร์ลงอย่างมาก
สถานการณ์การใช้งาน
ฟีเจอร์ที่ทรงพลังและความยืดหยุ่นของ Fish Speech ทำให้เหมาะสำหรับหลายด้าน รวมถึงผู้ช่วยอัจฉริยะ แชทบอท เทคโนโลยีเพื่อการเข้าถึง การศึกษา การสร้างเนื้อหา การพัฒนาเกม และบริการลูกค้า ไม่ว่าจะเป็นการสนทนาประจำวันหรือการใช้งานระดับมืออาชีพ ก็สามารถมอบประสบการณ์เสียงที่แม่นยำและเป็นธรรมชาติได้

โอเพนซอร์สและชุมชน
Fish Speech เป็นโอเพนซอร์สเต็มรูปแบบ ผู้ใช้ไม่เพียงแต่สามารถใช้และแก้ไขโค้ดโปรเจกต์ได้อย่างอิสระ แต่ยังสามารถพัฒนาต่อยอดตามความต้องการส่วนบุคคลได้ ทีม Fish Audio และชุมชนโอเพนซอร์สก็ยังคงพยายามอย่างต่อเนื่องในการปรับปรุงโปรเจกต์ เพื่อมอบประสบการณ์ที่ดีขึ้นให้กับผู้ใช้ทั่วโลก
สรุป
โดยสรุป Fish Speech เป็นเครื่องมือ Text-to-Speech แบบโอเพนซอร์สที่มีประสิทธิภาพ ทรงพลัง และใช้งานง่าย มีศักยภาพการใช้งานที่กว้างขวาง หากคุณสนใจเทคโนโลยีการสังเคราะห์เสียง ลองไปที่ GitHub ติดตามและทดลองใช้โปรเจกต์ Fish Speech ดูสิ!
เกี่ยวกับประสิทธิภาพการทำงาน
ผมทดสอบด้วยการ์ดจอ 4070ti Super ของผมเป็นเวลาหนึ่งบ่าย การสร้างไฟล์เสียง 29 วินาทีใช้เวลาประมาณ 130 วินาที การใช้ VRAM ต่ำมาก คาดว่าการ์ดจอที่มี VRAM 6GB ก็สามารถรันได้อย่างราบรื่น ในระหว่างการทดสอบ พัดลมการ์ดจอแทบไม่ทำงานเลย ทำงานได้เสถียรมาก
พร้อมตัวอย่างเสียงสาธิต
ด้านล่างนี้แนบตัวอย่างเสียงสาธิต ไม่รู้ว่าทุกคนจะเดาออกไหมว่าใช้โมเดลเสียงอะไรเป็นตัวอย่างอ้างอิง
คอร์สที่เกี่ยวข้อง

กล่องเครื่องมือบนเครื่องสุดยอดมาแล้ว! ในตัวมีอัดหน้าจอ ตัด-รวมเสียงและวิดีโอ บีบอัด-แยกวิดีโอ ฟรีตลอดชีพ - Kedou Video Converter

เครื่องมือฟรี 100% สุดยอด! ซอฟต์แวร์ PDF มัลติฟังก์ชันแบบครบวงจร แปลง บีบอัด แก้ไข PDF ฯลฯ เรียบง่ายไม่มีโฆษณา - JOPDF

เครื่องมือรีโมทเดสก์ท็อปโอเพ่นซอร์ส เหนือกว่าเวอร์ชันเสียเงิน! ใช้ฟรีไม่จำกัดทั้งส่วนตัวและเชิงพาณิชย์ รองรับทุกแพลตฟอร์ม HopToDesk

ตัวดาวน์โหลดสื่อเรียน K-12 ล่าสุด: โหลดทั้งชั้นเป็นชุด, สไลด์·วิดีโอ·เสียงคลิกเดียว

HuYanBao: แอปถนอมตาและกรองแสงสีฟ้าฟรีสำหรับคอมพิวเตอร์ พร้อมสัตว์เลี้ยงเตือนให้พักเป็นระยะ

วินโดวส์ก็มี Dynamic Island บนเดสก์ท็อปได้! ศูนย์ควบคุมระบบสุดโมเดิร์น ให้คอมพิวเตอร์มีรอยบากดำเพิ่ม PyIsland

การผลิตคอมิกดราม่า 3D สมจริง: คอร์สปฏิบัติ Seedance2.0 ครบกระบวนการ

รองรับทั้ง Win/Mac! เวอร์ชันถาวรตลอดชีพล่าสุด รองรับการซ่อมภาพเก่า เครื่องมือทำภาพให้คมชัดและขยายแบบไม่สูญเสียคุณภาพ Aiarty Image Enhancer

คอร์สเรียนออนไลน์: Github เครื่องมือดาวน์โหลดวิดีโอ Bilibili โอเพนซอร์ส รองรับ 8K และ Dolby Vision ดาวน์โหลดวิดีโอ Bilibili แบบกลุ่ม ใช้งานง่าย Bilidown

ชุดเครื่องมือเดสก์ท็อป Windows! มีวิดเจ็ตเดสก์ท็อปมินิมัลประยุกต์ในตัวกว่า 50 ตัว ครอบคลุมแคปหน้าจอ บันทึกหน้าจอ แปลภาษา พยากรณ์อากาศ ฯลฯ — กล่องเครื่องมือ DuoMi

