


التصنيفات
اظهار الكل >
-
دورات ريادة الأعمال
-
 أخرى
-
دروس من الخارج
-
التصوير والتحرير
-
إدارة المجتمع والنطاق الخاص
-
كتابة المحتوى وكتابة الإعلانات
-
مشاريع الدخل الجانبي
-
التجارة الإلكترونية
-
الفيديو القصير والبث المباشر
-
الذكاء الاصطناعي (AI)
-
البرمجيات والأدوات
-
أنظمة التشغيل
-
الإضافات والسكربتات
-
برمجيات MacOS
-
برمجيات Android
-
برمجيات Windows

برنامج استنساخ الصوت بسرعة من 3 ثوانٍ من الكلام AI声音克隆TTS CosyVoice v2.0
📚دورة فيديو
🕒آخر تحديث: 31/12/2024
👥رواد الأعمال / صناع المحتوى على وسائل التواصل / العاملون في التجارة الإلكترونية العابرة للحدود / الباحثون عن دخل إضافي
مادة دراسية مرجعية — مشمولة بالعضوية
افتح الدورة بالعضوية
🔓
احصل على هذه الدورة للدراسة المرجعية مع العضوية
📦
انضم للعضوية — ادرس 16741 دورة وأداة برمجية كمرجع
🔄
الدورات تتحدث باستمرار — يدرس الأعضاء المواد الجديدة فور وصولها
شارك:
الدورات الأكثر مبيعاً
-
خطة كسب المال من زراعة الذهب في الألعاب: اكسب أكثر من ألف يومياً، مشروع مستقر منذ ثلاث سنوات، يمكن لأي شخص فعله في وقت الفراغ
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
العمل التلقائي الكامل داخل الألعاب الرائجة: ربح يومي 500+، دون خبرة وتشغيل بسيط، وهو حالياً أكثر الأعمال الجانبية طويلة الأجل استقراراً كشف
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
معسكر تدريب مشروع بيع المنتجات على دوين: لا حاجة للظهور أمام الكاميرا، المبتدئون ينتجون فيديوهات بيع المنتجات باتباع الخطوات
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
خطة العمل داخل الألعاب الأولى لكسب المال: ربح يومي 1000+، ويستطيع الشخص العادي القيام بها في وقت فراغه كشف
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن






أدوات البرمجيات الأكثر مبيعاً
-
Lu Master v6.1024.4105.1121 نسخة مبسطة بملف واحد [Ge Chuzi Software · R1880]
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
برنامج إنشاء رسوم متحركة كرتونية ثنائية الأبعاد Moho Pro v14.3 [برنامج جي تشويزي · R2355]
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
برنامج تحرير ومعالجة الفيديو للحاسوب Aiseesoft Filmai v1.0.18
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
Microsoft To Do v2.147 النسخة الرسمية المجانية
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
PR/AE/DaVinci/FCPX إضافة راسم إشارة تدريج ألوان الفيديو Nobe OmniScope Win1.11.15 / Mac1.10.138【البرمجيات·R2748】
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن





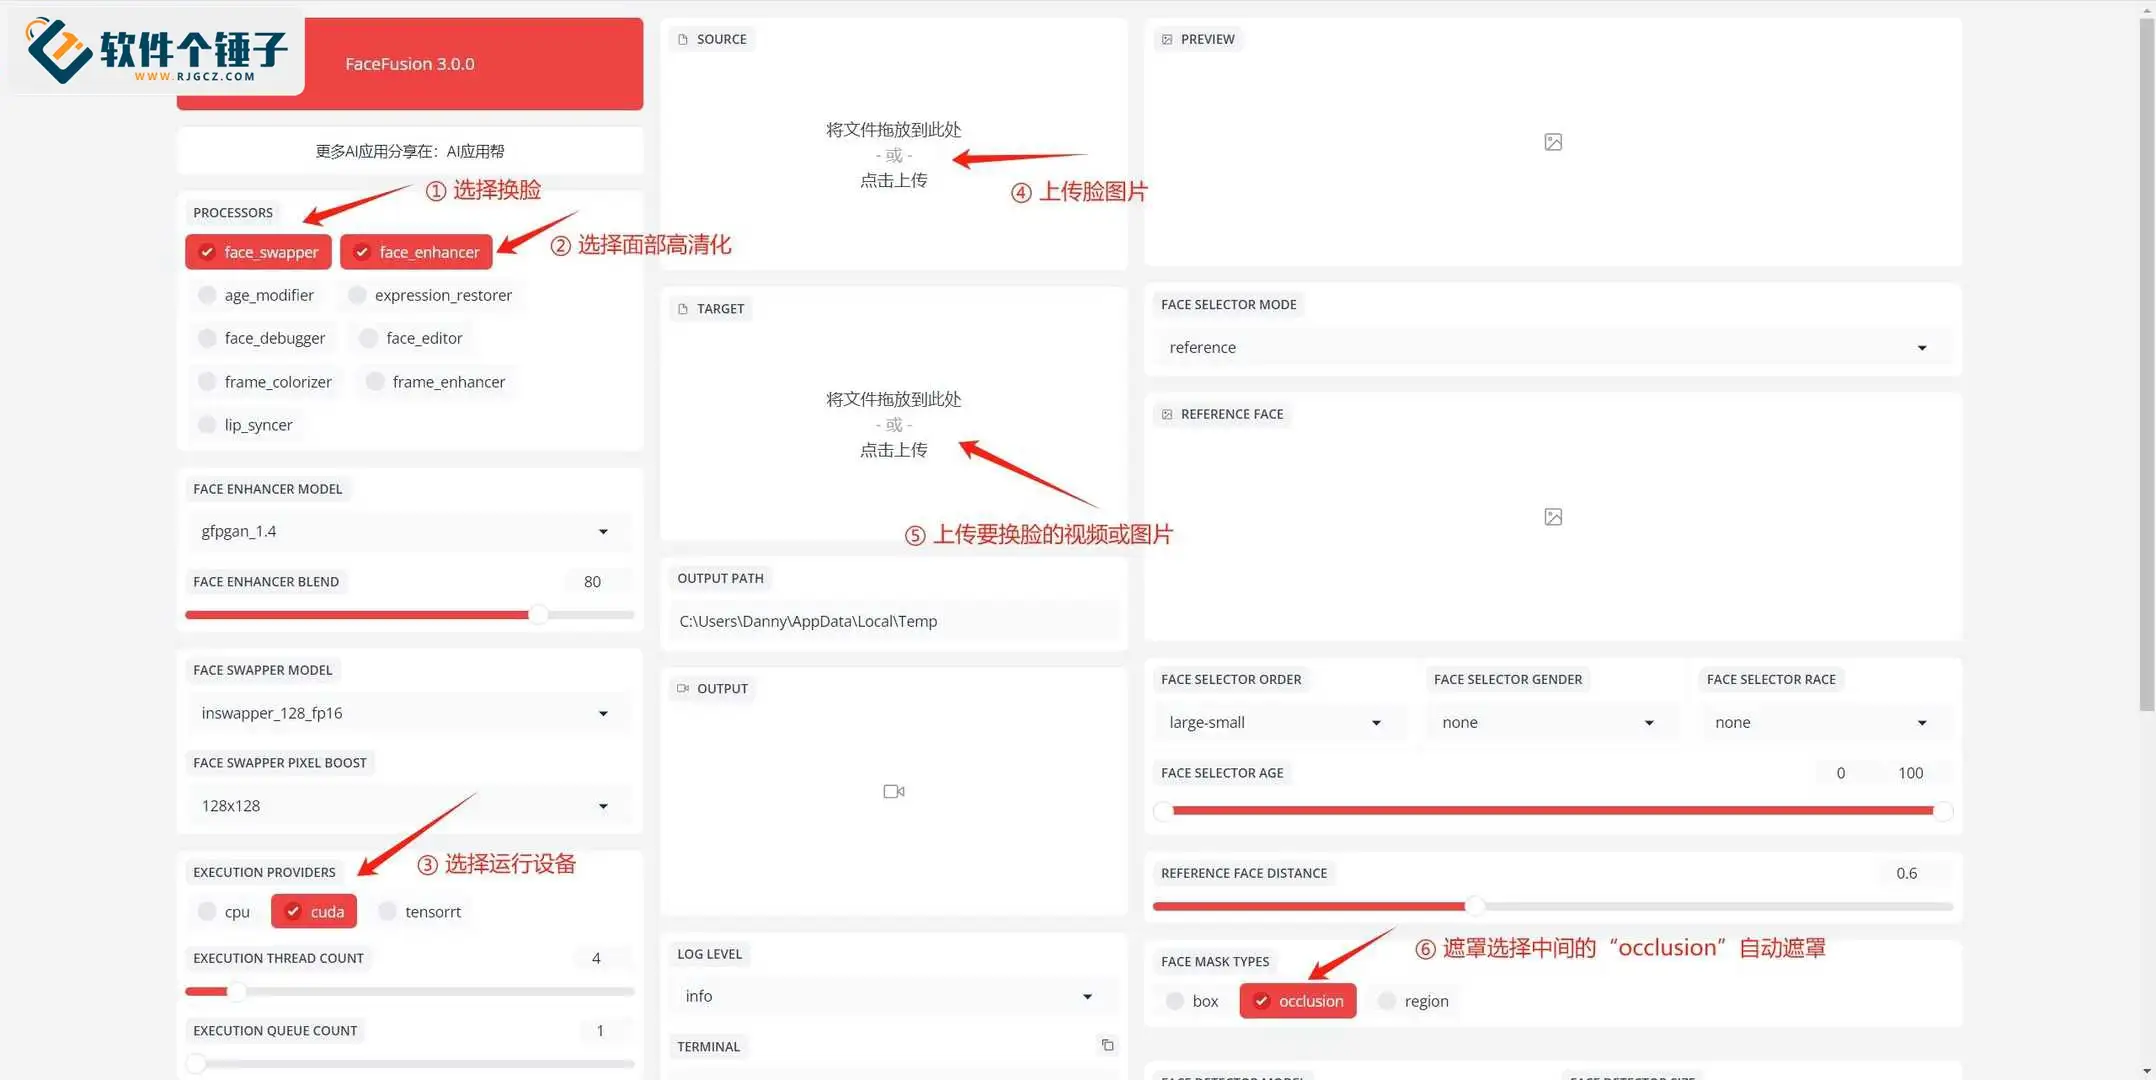
AI音频克隆TTS هي أداة استنساخ صوتي مبنية على تقنية CosyVoice مفتوحة المصدر من علي بابا. إنها مجانية بالكامل، لا تحتاج إلى اتصال بالإنترنت، ولا تتطلب عمليات معقدة، فقط قم بتنزيلها وفك ضغطها وتشغيلها لاستخدامها بسهولة. يحتاج هذا البرنامج إلى عينة صوتية مدتها 3 ثوانٍ فقط لإتمام استنساخ الصوت، بل يدعم أيضًا التعرف على اللغات واللهجات المختلفة وتوليدها، بوظائف قوية جدًا!
أبرز الميزات
- دعم اللغاتيدعم لغات ولهجات متعددة، بما في ذلك الصينية والإنجليزية واليابانية والكورية، بالإضافة إلى اللهجات المحلية الصينية (مثل الكانتونية ولغة سيتشوان ولغة شنغهاي وغيرها).
- ثلاثة أوضاع لاستنساخ الصوت
- استنساخ صوتي من 3 ثوانٍ:استيراد ملف صوتي مرجعي لا يقل عن 3 ثوانٍ، وإدخال النص ونص prompt، وتوليد بنقرة واحدة.
- الاستنساخ عبر اللغات:يدعم استنساخ الصوت بين لغات مختلفة، والاستخدام بنفس السهولة.
- التحكم باللغة الطبيعية:أدخل مباشرة تعليمات مثل "قل هذه الجملة بلهجة سيتشوان"، لإتمام توليد الصوت بسهولة.
- ميزة إضافة النصيمكن النسخ واللصق أو استيراد النص مباشرة، ويدعم ملفات TXT وتنسيق ترجمات SRT، ليلائم احتياجات سيناريوهات متعددة.
ميزات البرنامج
- أداء منخفض التأخير:يدمج تقنيات النمذجة دون اتصال والبث المباشر، مع تأخير في توليد الصوت يصل إلى 150ms.
- إخراج عالي الدقة:النطق أكثر طبيعية، مع انخفاض معدل الأخطاء بنسبة 50% مقارنة بالإصدارات السابقة.
- تحسين الاستقرار:تماسك قوي في نبرة الصوت، وتوليد صوتي أكثر موثوقية عبر اللغات.
خطوات الاستخدام
- نزّل الحزمة وفك ضغطها إلى مجلد بمسار غير صيني.
- شغّل البرنامج بالنقر المزدوج، واستخدمه مجانًا مباشرة.

- اختر وضع الاستدلال حسب الحاجة: للغة الماندرين يمكن اختيار "استنساخ صوت 3 ثوانٍ".
- استورد الصوت المرجعي (بتنسيق WAV، بمعدل عينات لا يقل عن 16kHz).
- أدخل النص المطابق للصوت المرجعي في حقل الإدخال المقابل.
- انقر على "بدء التوليد"، وانتظر قليلًا لإتمام الاستنساخ!

دورات ذات صلة

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
صندوق أدوات محلي خارق: يتضمن تسجيل الشاشة وقص ودمج الصوت والفيديو وضغط الفيديو واستخراجه مجاناً للأبد، تحويل الفيديو

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
أداة مجانية مثالية 100%: برنامج PDF متعدد الوظائف من مكان واحد، تحويل وضغط وتحرير PDF وغيرها، بسيط بلا إعلانات، JOPDF

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
أداة سطح المكتب البعيد مفتوحة المصدر، تتفوق على النسخ المدفوعة! مجاني للاستخدام الشخصي والتجاري بلا حدود، تدعم جميع المنصات، HopToDesk

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
أحدث أداة تنزيل كتب المرحلة المدرسية: تنزيل دفعي لصف دراسي كامل، والوسائط التعليمية والفيديوهات والصوتيات بنقرة واحدة

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
هويان باو: تطبيق حماية العين من الضوء الأزرق مجاناً مع تذكيرات استراحة بالحيوانات

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
ويندوز يمكنه الحصول على جزيرة ديناميكية على سطح المكتب! مركز تحكم حديث يضيف نتوءاً أسود لجهازك — PyIsland

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
إنتاج دراما مصورة ثلاثية الأبعاد واقعية: دورة Seedance2.0 العملية الكاملة من الصفر إلى إنشاء محتوى عالي الجودة

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
يدعم ويندوز وماك! أحدث إصدار دائم مدى الحياة، إصلاح الصور القديمة، تكبير الصور بلا فقدان الجودة Aiarty Image Enhancer

مادة دراسية مرجعية — مشمولة بالعضوية
اشترك الآن
دورة تدريبية عبر الإنترنت: أداة Github مفتوحة المصدر لتنزيل فيديوهات Bilibili / تدعم 8K وDolby Vision / Bilidown

شبكة المؤسس الفردي — شخص واحد، شركة واحدة. بلا فريق أو وسطاء. كل نموذج هنا مُثبت في السوق الصينية. انضم للعضوية، ادرسها كمرجع، وأطلقها محليًا في بلدك.
