


-
Solounternehmens-Kurse
-
 Sonstiges
-
Auslandskurse
-
Fotografie & Schnitt
-
Community & Private Domain
-
Schreiben & Texten für Medien
-
Nebenverdienst-Projekte
-
E-Commerce
-
Kurzvideos & Live-Streaming
-
Künstliche Intelligenz (KI)
-
Software & Tools
-
Betriebssysteme
-
Plugins & Skripte
-
MacOS-Software
-
Android-Software
-
Windows-Software
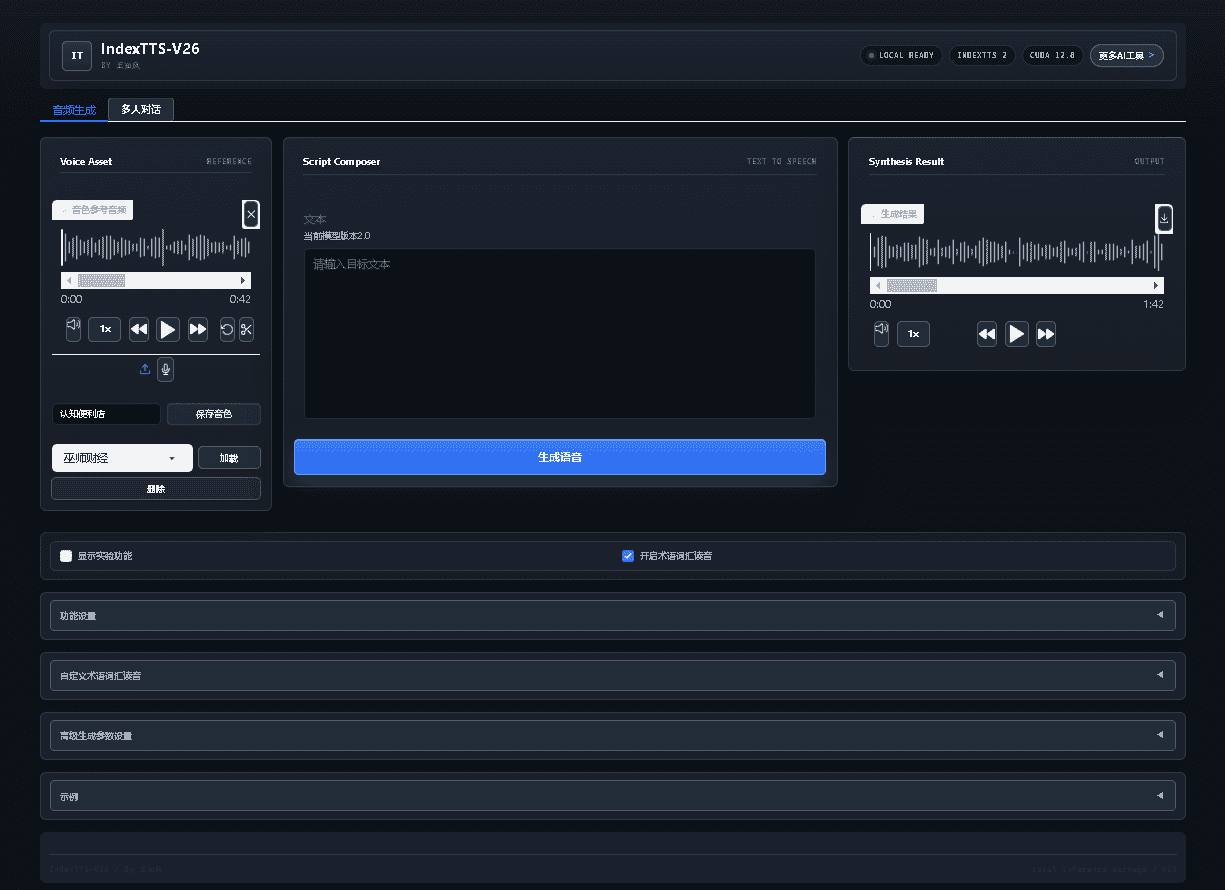
Von Bilibili produziertes super starkes Text-zu-Sprache- und Stimmklon-Offline-Integrationspaket IndexTTS 26
-
Goldfarming-Geldverdienplan für Spiele: täglich über 1.000 verdienen – ein stabiles 3-Jahres-Projekt, das jeder in der Freizeit umsetzen kann
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
AI-Comic-Drama-SOP-Systemkurs: Web-Novel-Auswahl und -Adaption, Drehbuchnormen, Text-zu-Bild/Bild-zu-Video-Fertigfilm, Voice-over und Schnitt – standardisiertes Full-Flow-Umsetzungs-Tutorial (Update 0826)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Hot-Game-vollautomatisiertes Verdienen: 500+ pro Tag, keine Erfahrung, einfache Bedienung – das stetigste langfristige Game-Verdienst-Nebenprojekt (enthüllt)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Douyin-Verkaufs-Begleitcamp: kein echtes Auftreten nötig, Anfänger kopieren Vorlagen und produzieren Verkaufsvideos
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Premier-Game-Farming-Geldplan: 1.000+ täglich, für Normalverdiener in der Freizeit machbar! [Enthüllung]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten






-
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Lu Master v6.1024.4105.1121 schlanke Single-File-Version [Software Ge Chuzi · R1880]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Software zur Erstellung zweidimensionaler Cartoon-Animationen Moho Pro v14.3 [Software Gezhi Chuzi · R2355]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PC-Videobearbeitungssoftware Aiseesoft Filmai v1.0.18 【Software Gezhi·R2470】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Microsoft To Do v2.147 Offizielle kostenlose Version [Software Gechui·R2618]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PR/AE/DaVinci/FCPX Video-Farbkorrektur-Oszilloskop-Plugin Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Gechui·R2748】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten





IndexTTS ist das neueste von Bilibili vorgestellte Text-zu-Sprache-(TTS)-Modell. Es kann die Aussprache chinesischer Schriftzeichen mithilfe von Pinyin korrigieren und Pausen an beliebigen Positionen durch Satzzeichen steuern. Im chinesischen Szenario zeigt es herausragende Leistung und hat Branchenrekorde gebrochen. IndexTTS verbessert durch fortschrittliche Technologien wie chinesische Schriftzeichen-Pinyin-Hybridmodellierung, präzise Pausensteuerung und Cross-Modal-Optimierung die Genauigkeit und Natürlichkeit der Sprachgenerierung erheblich.

Leistungsstarke Technologie und Performance
Das IndexTTS-System wurde mit Zehntausenden Stunden an Daten trainiert und erreicht branchenführende Leistung, die aktuelle populäre TTS-Systeme wie XTTS, CosyVoice2, Fish-Speech und F5-TTS übertrifft. Mehrere Module des Systems wurden verbessert, mit tiefgreifenden Verbesserungen bei der Darstellung von Sprecher-Konditionsmerkmalen und der Audioqualitätsoptimierung. Durch die Einführung hybrider Modellierung kann IndexTTS falsch gelesene chinesische Schriftzeichen schnell korrigieren und verbessert das Nutzungserlebnis.
Verbesserungen durch die neueste Version
Die heute geteilte V3-Version aktualisiert das leistungsstärkere IndexTTS-1.5-Modell und verbessert die Stabilität des Modells sowie die englische Sprachleistung erheblich. Diese Version zeigt nicht nur hervorragende Leistung bei der chinesischen Sprachgenerierung, sondern erweitert auch die Unterstützung für Sprachen, wodurch die Anwendungsszenarien vielfältiger werden.
Anwendungsszenarien
Der Erfolg von IndexTTS liegt im tiefen Verständnis der Besonderheiten der chinesischen Sprache und innovativer Anwendung. Es eignet sich für Szenarien, die hochpräzise und natürliche Sprachgenerierung erfordern, wie Bildung, Unterhaltung, Nachrichtensprechen usw. Seine präzise Pausensteuerung und Fähigkeit zur Verarbeitung von Mehrfachlesungen verleihen ihm deutliche Vorteile im Bereich des chinesischen Vorlesens und der Sprachsynthese.
Anleitung
Die IndexTTS-Anleitung lautet wie folgt: Es wird empfohlen, eine N-Karte zu verwenden, ab 4 GB VRAM, unterstützt 50er-Grafikkarten, basierend auf CUDA 12.8.
Schritt 1: Referenzaudio hochladen
Laden Sie Referenzaudio hoch, um dem Modell zu helfen, Sprache besser zu generieren.
Schritt 2: Text eingeben
Geben Sie im Texteingabefeld den Textinhalt ein, der in Sprache umgewandelt werden soll.
Schritt 3: Sprache generieren
Wählen Sie je nach Textlänge „Normale Inferenz" oder „Batch-Inferenz". Im Test nutzt „Batch-Inferenz" den VRAM voll aus, die Generierungsgeschwindigkeit wird um mehr als das 10-Fache erhöht, aber die Stabilität ist etwas geringer als bei „Normale Inferenz". Jeder kann es nach Bedarf selbst anpassen.
Ähnliche Kurse

Super lokale Toolbox! Integrierte Bildschirmaufnahme, Audio-/Video-Schnitt & -Zusammenführung, Video-Komprimierung & -Extraktion, für immer gratis – Kedou Video Converter

100%% perfektes Gratis-Tool! Alles-in-einem-Multifunktions-PDF-Software: PDF konvertieren, komprimieren, bearbeiten etc., minimalistisch, keine Werbung, so schön – JOPDF

Open-Source-Desktop-Fernzugriffstool, weit besser als kostenpflichtige Versionen! Kostenlos und unbegrenzt für Privat und Gewerbe nutzbar, plattformübergreifend, Desktop-Fernsteuerung – HopToDesk

Neuestes Tool zum Herunterladen von Lehrmaterialien für Grund- und Mittelschule: komplette Jahrgangsstufen, mit begleitenden Folien, Videos und Audios auf einen Klick

Den ganzen Tag auf den Bildschirm, ohne Augenschutz-Tool? Kostenlose Blaulicht-Schutz-App für PC, mit Haustier, das dich an Pausen erinnert, Huyanbao

PyIsland: Modernes System-Control-Center mit Desktop-Dynamic-Island für Windows

3D-Simulation-Manju-Produktion: Seedance 2.0 Komplettprozess-Praxis, von 0 bis zur hochwertigen Manju-Kreation

Für Win und Mac! Neueste lebenslange Version: Restaurierung alter Fotos, Bildklarheit und verlustfreie Vergrößerung - Aiarty Image Enhancer

Github Open-Source-Bilibili-Downloader: Stapel-Download von Bilibili-Videos mit 8K und Dolby Vision-Unterstützung – einfach zu bedienen, Bilidown

Windows-Desktop-Werkzeugsammlung: 50+ praktische, schlichte Desktop-Widgets, mit Screenshot, Screenrecording, Übersetzung, Wetter u.v.m. – Duomi-Toolbox

Contact Info
- E-Mail: massivesidehustles@outlook.com
