


-
Corsi per imprenditori solisti
-
 Altri
-
Tutorial esteri
-
Fotografia & Montaggio
-
Community & Dominio privato
-
Scrittura & Copywriting per media
-
Progetti di reddito extra
-
E-commerce
-
Video brevi & Live streaming
-
Intelligenza Artificiale (IA)
-
Software & Strumenti
-
Sistemi operativi
-
Plugin & Script
-
Software MacOS
-
Software Android
-
Software Windows
Pacchetto offline integrato IndexTTS 26 di conversione testo-in-voce e clonazione vocale super potente prodotto da Bilibili
-
Piano di guadagno con il farming di oro nei videogiochi: guadagna oltre 1k al giorno, un progetto stabile da 3 anni che chiunque può fare nel tempo libero
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Corso sistematico SOP per AI comic drama: selezione e adattamento di web novel, norme per le sceneggiature, da testo a immagine e da immagine a video fino al film finito, doppiaggio e montaggio - tutorial completo e standardizzato (aggiornamento 0826)
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Farming automatizzato di giochi popolari: 500+/giorno, senza esperienza, semplice – l'extra stabile a lungo termine più affidabile [Rivelato]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
ShuShu questa volta si è fatto onore! Niente panico con i problemi di formato di Windows: lo strumento open source ShuShu Format Converter, un gioiello popolare su GitHub
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Camp di accompagnamento vendite Douyin: senza apparizione reale, principianti copiano template e producono video
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Piano di guadagno con il farming nei giochi in anteprima: 1.000+ al giorno, fattibile dalle persone comuni nel tempo libero
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati






-
ShuShu questa volta si è fatto onore! Niente panico con i problemi di formato di Windows: lo strumento open source ShuShu Format Converter, un gioiello popolare su GitHub
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Lu Master v6.1024.4105.1121 versione alleggerita in file singolo [Software Ge Chuizi - R1880]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Software per la creazione di animazioni cartonate bidimensionali Moho Pro v14.3 [Software Ge Chuzi · R2355]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Software di editing e elaborazione video per PC Aiseesoft Filmai v1.0.18 【Software Ge Chuzi·R2470】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Microsoft To Do v2.147 versione ufficiale gratuita【Software Gechuzi·R2618】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Plugin oscilloscopio per color grading video PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Ge Chuizi·R2748】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati





IndexTTS è il più recente modello di sintesi vocale (TTS) lanciato da Bilibili; è in grado di correggere la pronuncia dei caratteri cinesi tramite pinyin e di controllare le pause in qualsiasi posizione tramite la punteggiatura. In ambito cinese mostra prestazioni eccezionali e ha stabilito nuovi record del settore. IndexTTS, attraverso tecnologie avanzate come la modellazione mista carattere cinese-pinyin, il controllo preciso delle pause e l'ottimizzazione cross-modale, migliora significativamente la precisione e la naturalezza della generazione vocale.

Tecnologia e prestazioni potenti
Il sistema IndexTTS è stato addestrato con decine di migliaia di ore di dati e ha raggiunto prestazioni leader del settore, superando gli attuali sistemi TTS popolari come XTTS, CosyVoice2, Fish-Speech e F5-TTS. Diversi moduli del sistema sono stati potenziati, con profondi miglioramenti nella rappresentazione delle caratteristiche condizionate dal parlante e nell'ottimizzazione della qualità audio. Introducendo la modellazione mista, IndexTTS è in grado di correggere rapidamente i caratteri cinesi letti erroneamente, migliorando l'esperienza d'uso.
Miglioramenti apportati dalla versione più recente
La versione V3 condivisa oggi aggiorna il modello IndexTTS-1.5 più potente, migliorando significativamente la stabilità del modello e le prestazioni in lingua inglese. Questa versione non solo eccelle nella generazione vocale in cinese, ma estende anche il supporto ad altre lingue, ampliando ulteriormente gli scenari applicativi.
Scenari d'uso
Il successo di IndexTTS risiede nella profonda comprensione delle caratteristiche della lingua cinese e nell'applicazione innovativa, adatto a scenari che richiedono una generazione vocale ad alta precisione e naturalezza, come istruzione, intrattenimento, lettura di notizie, ecc. Il suo controllo preciso delle pause e la capacità di gestione dei caratteri polifonici gli conferiscono un vantaggio significativo nel campo della lettura in cinese e della sintesi vocale.
Guida all'uso
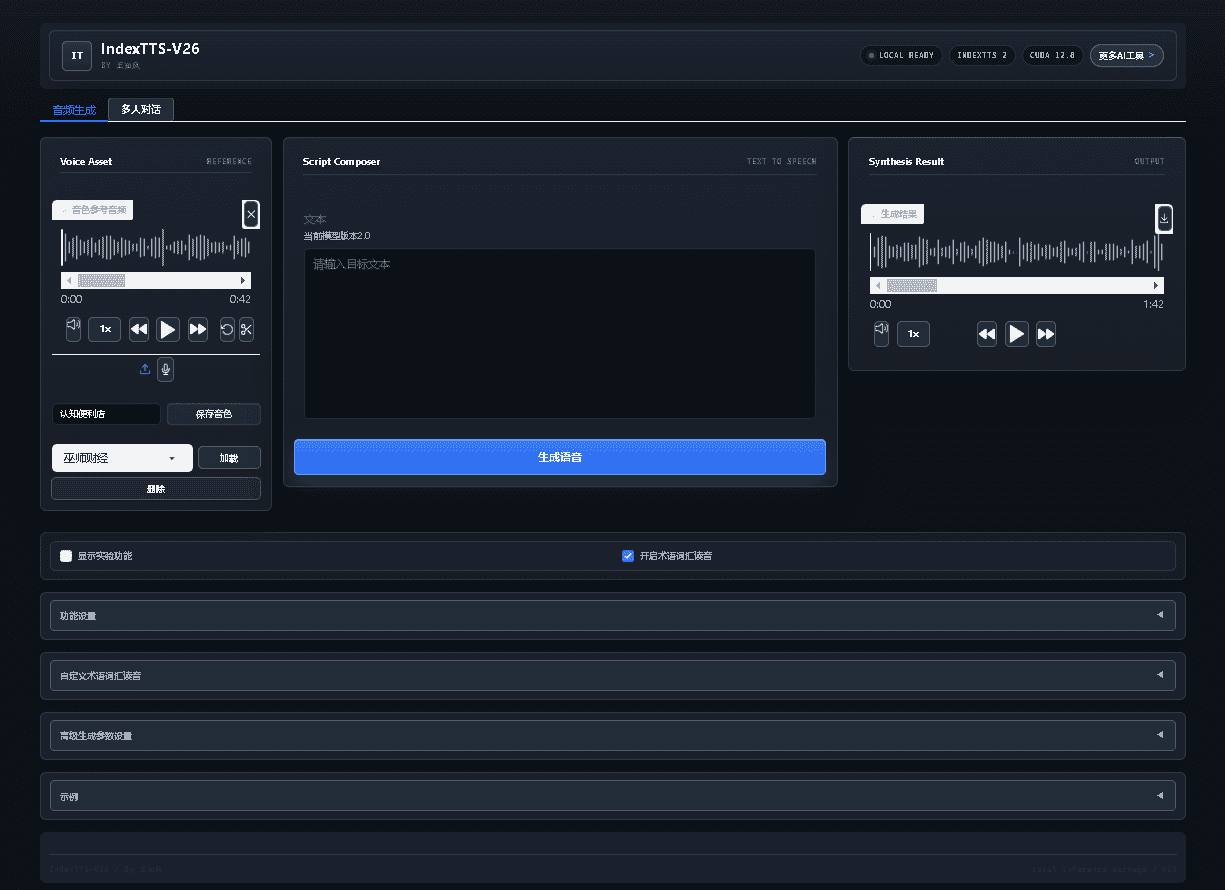
Il tutorial d'uso di IndexTTS è il seguente; si consiglia di utilizzare una GPU N, con memoria video da 4G in su, supporta le schede della serie 50, basato su CUDA 12.8.
Passaggio 1: caricare l'audio di riferimento
Carica l'audio di riferimento per aiutare il modello a generare meglio la voce.
Passaggio 2: inserire il testo
Inserisci nel campo di testo il contenuto testuale da convertire in voce.
Passaggio 3: generare la voce
In base alla lunghezza del testo, scegli tra "inferenza normale" e "inferenza batch". Nei test, l'"inferenza batch" sfrutta appieno la memoria video, con una velocità di generazione aumentata di oltre 10 volte, ma con stabilità leggermente inferiore all'"inferenza normale". Ognuno può regolare secondo le proprie esigenze.
Corsi correlati

Toolbox super locale! Con registrazione dello schermo integrata, taglio e unione di audio/video, compressione ed estrazione video, gratis per sempre - Kedou Video Converter

Strumento gratis perfetto al 100%%! Software PDF multifunzione tutto in uno: converti, comprimi, modifica PDF ecc., minimal, senza pubblicità, fantastico - JOPDF

Strumento di desktop remoto open source, superiore alle versioni a pagamento! Gratuito e illimitato per uso personale e commerciale, multipiattaforma – HopToDesk

Ultimo strumento di download di libri di testo per scuola elementare e media: download delle risorse di un intero anno, slide, video e audio con un clic

Tutto il giorno davanti allo schermo, senza uno strumento di protezione per gli occhi? Ecco l'app gratuita anti-luce blu per PC, con un animale che ti ricorda di riposare. Huyanbao

PyIsland: centro di controllo di sistema moderno con Dynamic Island sul desktop Windows

Produzione di drammi anime 3D simulati: pratica completa con Seedance 2.0, ti guida da 0 a 1 nella creazione di drammi anime di alta qualità

Compatibile Win/Mac! Ultima versione a vita: ripristina vecchie foto, migliora la nitidezza e ingrandisci senza perdita - Aiarty Image Enhancer

Tool di download Bilibili open source su Github: download in batch di video Bilibili con supporto 8K e Dolby Vision, semplice, Bilidown

Collezione di strumenti desktop Windows: 50+ widget pratici ed essenziali, con screenshot, registrazione, traduzione, meteo ecc. – toolbox Duomi

