


-
Курсы для одиночного бизнеса
-
 Другое
-
Зарубежные курсы
-
Фотография & Монтаж
-
Сообщество & Приватная зона
-
Написание текстов & Копирайтинг для медиа
-
Проекты дополнительного дохода
-
Электронная коммерция
-
Короткие видео & Прямые эфиры
-
Искусственный интеллект (ИИ)
-
Программное обеспечение & Инструменты
-
Операционные системы
-
Плагины & Скрипты
-
Программы MacOS
-
Программы Android
-
Программы Windows
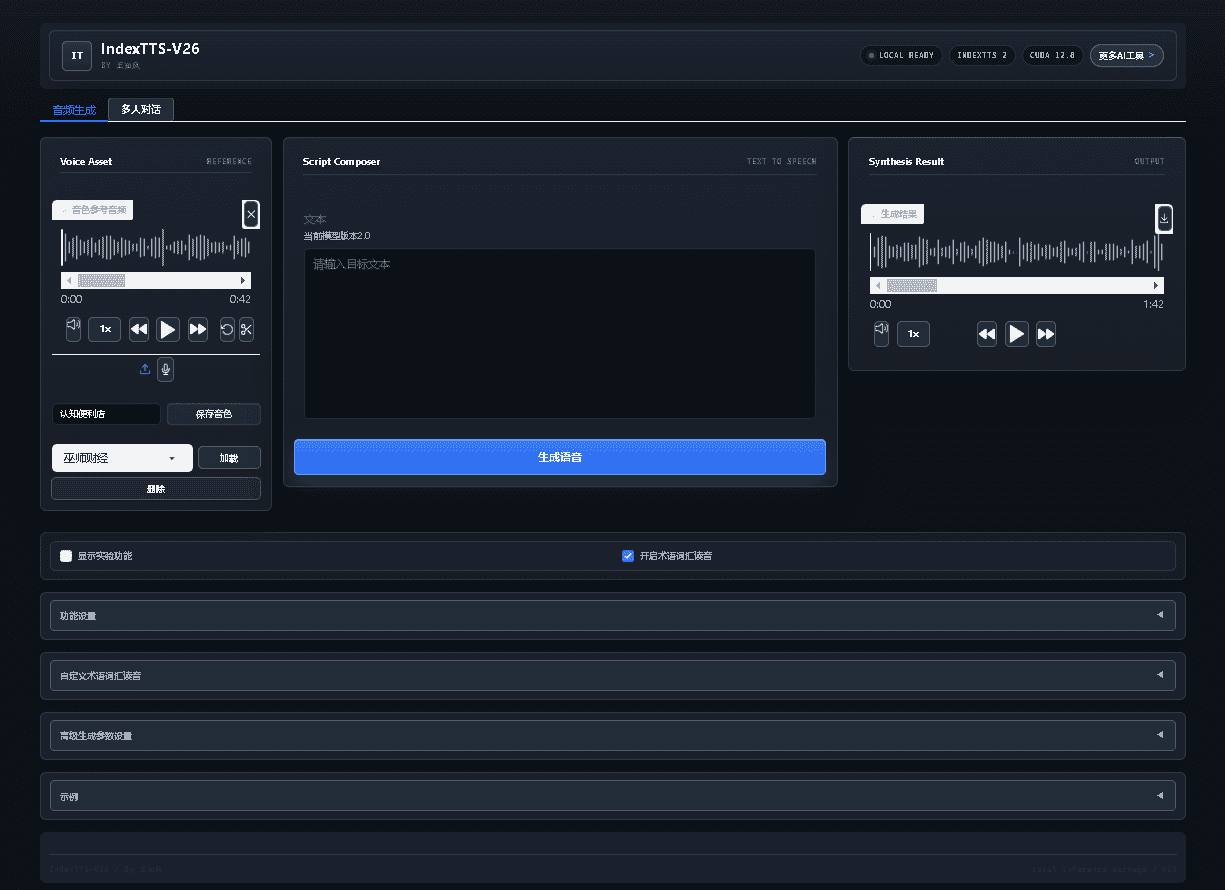
Сверхмощный офлайн-пакет для преобразования текста в речь и клонирования голоса IndexTTS 26 от Bilibili
-
Схема заработка на игровом фарме золота: 1000+ в день — стабильный проект на 3 года, который под силу каждому в свободное время
Справочный учебный материал — включён в подписку Оформить подписку -
Систематический курс SOP по AI-комикс-драме: отбор и адаптация веб-новелл, стандарты сценария, готовый фильм через text-to-image и image-to-video, озвучка и монтаж — стандартизированный туториал по полному внедрению (обновление 0826)
Справочный учебный материал — включён в подписку Оформить подписку -
Полностью автоматический фарм в популярных играх: 500+/день, без опыта, простой — самый стабильный долгосрочный игровой заработок [Секрет]
Справочный учебный материал — включён в подписку Оформить подписку -
Мышка на этот раз отличилась! Не паникуйте с проблемами форматов Windows — поможет открытый конвертер ShuShu Format Converter, популярная находка на GitHub
Справочный учебный материал — включён в подписку Оформить подписку -
Кампания сопровождения продаж в Douyin: без реального появления, новички копируют шаблоны и производят продающие видео
Справочный учебный материал — включён в подписку Оформить подписку -
Премьерный план заработка на игровом фарме: 1 000+ в день, обычному человеку по силам в свободное время! 【разоблачение】
Справочный учебный материал — включён в подписку Оформить подписку






-
Мышка на этот раз отличилась! Не паникуйте с проблемами форматов Windows — поможет открытый конвертер ShuShu Format Converter, популярная находка на GitHub
Справочный учебный материал — включён в подписку Оформить подписку -
鲁大师 v6.1024.4105.1121, упрощённая однофайловая версия
Справочный учебный материал — включён в подписку Оформить подписку -
Программное обеспечение для создания двумерной мультипликации Moho Pro v14.3
Справочный учебный материал — включён в подписку Оформить подписку -
Программа для редактирования и обработки видео на ПК Aiseesoft Filmai v1.0.18
Справочный учебный материал — включён в подписку Оформить подписку -
Microsoft To Do v2.147 официальная бесплатная версия
Справочный учебный материал — включён в подписку Оформить подписку -
Плагин-осциллограф для цветокоррекции видео PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138
Справочный учебный материал — включён в подписку Оформить подписку





IndexTTS — это новейшая модель преобразования текста в речь (TTS), представленная Bilibili. Она способна использовать пиньинь для исправления произношения китайских иероглифов и управлять паузами в любом месте с помощью знаков препинания. В китайскоязычных сценариях она демонстрирует выдающиеся результаты и обновляет отраслевые рекорды. IndexTTS за счет таких передовых технологий, как гибридное моделирование китайских иероглифов и пиньиня, точное управление паузами и кросс-модальная оптимизация, значительно повышает точность и естественность генерации речи.

Мощные технологии и производительность
Система IndexTTS обучена на десятках тысяч часов данных и достигла ведущей в отрасли производительности, превзойдя популярные TTS-системы, такие как XTTS, CosyVoice2, Fish-Speech и F5-TTS. Многие модули системы были усовершенствованы — проведены глубокие улучшения в представлении характеристик условий динамика и оптимизации качества аудио. Благодаря внедрению гибридного моделирования IndexTTS способна быстро исправлять ошибочно прочитанные китайские иероглифы, повышая удобство использования.
Улучшения в последней версии
В версии V3, которой мы делимся сегодня, обновлена более мощная модель IndexTTS-1.5, что значительно повысило стабильность модели и производительность в английском языке. Эта версия не только отлично показывает себя в генерации китайской речи, но и расширила поддержку языков, делая сценарии применения более широкими.
Сценарии применения
Успех IndexTTS заключается в глубоком понимании особенностей китайского языка и инновационном применении, подходит для сценариев, требующих высокоточной и естественной генерации речи, таких как образование, развлечения, новостное вещание и другие. Точное управление паузами и обработка многозначных иероглифов дают ему значительные преимущества в области чтения на китайском и синтеза речи.
Руководство по использованию
Руководство по использованию IndexTTS приведено ниже. Рекомендуется использовать видеокарту N, от 4 ГБ видеопамяти, поддерживаются видеокарты 50-й серии, на базе CUDA 12.8.
Шаг 1: Загрузка референсного аудио
Загрузите референсное аудио, чтобы помочь модели лучше генерировать речь.
Шаг 2: Ввод текста
Введите в текстовое поле текст, который нужно преобразовать в речь.
Шаг 3: Генерация речи
В зависимости от длины текста выберите «Обычный вывод» или «Пакетный вывод». По результатам тестирования «Пакетный вывод» полностью использует видеопамять, скорость генерации возрастает более чем в 10 раз, но стабильность немного уступает «Обычному выводу». Вы можете调整 по своему усмотрению.
Похожие курсы

Отличный локальный набор инструментов! Встроенная запись экрана, нарезка и склейка аудио и видео, сжатие и извлечение видео, бесплатно навсегда — Kedou Video Converter


Бесплатный инструмент удалённого доступа с открытым кодом, лучше платных версий! Безлимитно бесплатно для частного и коммерческого использования, на всех платформах – HopToDesk

Новейший инструмент для скачивания учебников для школ: загрузка ресурсов целого класса, сопутствующие презентации, видео и аудио в один клик

Весь день пялишься в экран, как без защиты для глаз? Бесплатное приложение защиты от синего света ПК, еще и питомец напоминает о перерыве, Huyanbao

PyIsland: современный центр управления системой с Dynamic Island на рабочем столе Windows

Производство 3D-иммерсивных маньхуа-драм: полный цикл Seedance 2.0, от 0 до качественной постановки

Для Win и Mac! Свежая бессрочная версия: восстановление старых фото, повышение чёткости и увеличение без потерь - Aiarty Image Enhancer

Открытый GitHub-инструмент для скачивания Bilibili: пакетное скачивание видео Bilibili с поддержкой 8K и Dolby Vision, прост в использовании, Bilidown

Набор настольных инструментов для Windows: 50+ практичных минималистичных виджетов, скриншот, запись экрана, перевод, погода и др. – инструментарий Доми

Contact Info
- Эл. почта: massivesidehustles@outlook.com
