


-
دورات ريادة الأعمال
-
 أخرى
-
دروس من الخارج
-
التصوير والتحرير
-
إدارة المجتمع والنطاق الخاص
-
كتابة المحتوى وكتابة الإعلانات
-
مشاريع الدخل الجانبي
-
التجارة الإلكترونية
-
الفيديو القصير والبث المباشر
-
الذكاء الاصطناعي (AI)
-
البرمجيات والأدوات
-
أنظمة التشغيل
-
الإضافات والسكربتات
-
برمجيات MacOS
-
برمجيات Android
-
برمجيات Windows
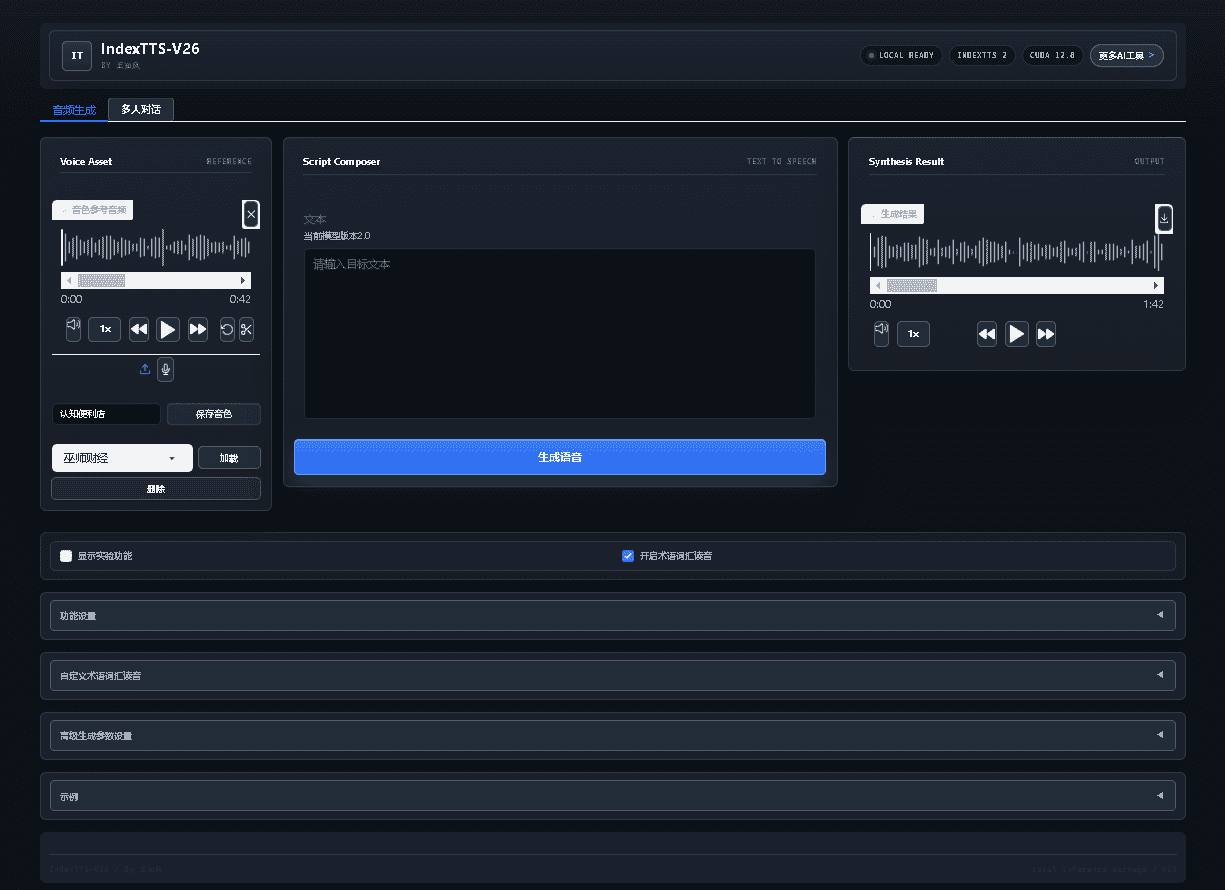
حزمة متكاملة دون اتصال لتحويل النص إلى كلام واستنساخ الصوت فائقة القوة من إنتاج B站 IndexTTS 26
-
خطة كسب المال من زراعة الذهب في الألعاب: اكسب أكثر من ألف يومياً، مشروع مستقر منذ ثلاث سنوات، يمكن لأي شخص فعله في وقت الفراغ
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
العمل التلقائي الكامل داخل الألعاب الرائجة: ربح يومي 500+، دون خبرة وتشغيل بسيط، وهو حالياً أكثر الأعمال الجانبية طويلة الأجل استقراراً كشف
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
معسكر تدريب مشروع بيع المنتجات على دوين: لا حاجة للظهور أمام الكاميرا، المبتدئون ينتجون فيديوهات بيع المنتجات باتباع الخطوات
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
خطة العمل داخل الألعاب الأولى لكسب المال: ربح يومي 1000+، ويستطيع الشخص العادي القيام بها في وقت فراغه كشف
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن






-
Lu Master v6.1024.4105.1121 نسخة مبسطة بملف واحد [Ge Chuzi Software · R1880]
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
برنامج إنشاء رسوم متحركة كرتونية ثنائية الأبعاد Moho Pro v14.3 [برنامج جي تشويزي · R2355]
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
برنامج تحرير ومعالجة الفيديو للحاسوب Aiseesoft Filmai v1.0.18
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
Microsoft To Do v2.147 النسخة الرسمية المجانية
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
PR/AE/DaVinci/FCPX إضافة راسم إشارة تدريج ألوان الفيديو Nobe OmniScope Win1.11.15 / Mac1.10.138【البرمجيات·R2748】
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن





IndexTTS هو أحدث نموذج لتحويل النص إلى كلام (TTS) أطلقته B站، يمكنه استخدام Pinyin لتصحيح نطق الأحرف الصينية، والتحكم في التوقف عند أي موضع من خلال علامات الترقيم. في السياقات الصينية، أظهر أداءً متميزاً وحطم الأرقام القياسية في المجال. من خلال تقنيات متقدمة مثل النمذجة المختلطة بين الأحرف الصينية وPinyin، والتحكم الدقيق في التوقف، والتحسين متعدد الوسائط، حسّن IndexTTS بشكل ملحوظ دقة توليد الكلام وطبيعيته.

تقنيات وأداء قوي
تم تدريب نظام IndexTTS على عشرات الآلاف من الساعات من البيانات، وحقق أداءً رائداً في المجال، متجاوزاً أنظمة TTS الشائعة حالياً مثل XTTS وCosyVoice2 وFish-Speech وF5-TTS وغيرها. تم تعزيز عدة وحدات في النظام، مع تحسينات عميقة في تمثيل خصائص حالة المتحدث وتحسين جودة الصوت. من خلال إدخال أسلوب النمذجة المختلطة، يمكن لـ IndexTTS تصحيح الأحرف الصينية المقروءة خطأً بسرعة، مما يحسن تجربة المستخدم.
التحسينات التي يجلبها الإصدار الأحدث
إصدار V3 الذي نشاركه اليوم، حدّث نموذج IndexTTS-1.5 الأقوى، مما حسّن بشكل ملحوظ استقرار النموذج وأداء اللغة الإنجليزية. هذا الإصدار لا يتميز فقط في توليد الكلام الصيني، بل وسّع أيضاً دعم اللغات، مما جعل سيناريوهات التطبيق أكثر اتساعاً.
حالات الاستخدام
يكمن نجاح IndexTTS في الفهم العميق لخصائص اللغة الصينية والتطبيق المبتكر، وهو مناسب للسيناريوهات التي تتطلب توليد كلام عالي الدقة والطبيعية، مثل التعليم والترفيه وبث الأخبار وغيرها. قدرته على التحكم الدقيق في التوقف ومعالجة الأحرف متعددة النطق تمنحه ميزة واضحة في مجال القراءة الصينية وتركيب الكلام.
دليل الاستخدام
دليل استخدام IndexTTS كما يلي، يُنصح باستخدام بطاقة N، بذاكرة رسوميات من 4G فما فوق، يدعم سلسلة 50 من بطاقات الرسوميات، بناءً على CUDA 12.8.
الخطوة 1: رفع الصوت المرجعي
ارفع الصوت المرجعي لمساعدة النموذج على توليد الكلام بشكل أفضل.
الخطوة 2: إدخال النص
أدخل محتوى النص المراد تحويله إلى كلام في مربع إدخال النص.
الخطوة 3: توليد الكلام
اختر "الاستدلال العادي" أو "الاستدلال بالدفعات" وفقاً لطول النص. أظهرت الاختبارات أن "الاستدلال بالدفعات" يستفيد بشكل كامل من ذاكرة الرسوميات، ويزيد سرعة التوليد أكثر من 10 أضعاف، لكن استقراره أقل قليلاً من "الاستدلال العادي". يمكن للجميع الضبط حسب الحاجة.
دورات ذات صلة

صندوق أدوات محلي خارق: يتضمن تسجيل الشاشة وقص ودمج الصوت والفيديو وضغط الفيديو واستخراجه مجاناً للأبد، تحويل الفيديو

أداة مجانية مثالية 100%: برنامج PDF متعدد الوظائف من مكان واحد، تحويل وضغط وتحرير PDF وغيرها، بسيط بلا إعلانات، JOPDF

أداة سطح المكتب البعيد مفتوحة المصدر، تتفوق على النسخ المدفوعة! مجاني للاستخدام الشخصي والتجاري بلا حدود، تدعم جميع المنصات، HopToDesk

أحدث أداة تنزيل كتب المرحلة المدرسية: تنزيل دفعي لصف دراسي كامل، والوسائط التعليمية والفيديوهات والصوتيات بنقرة واحدة

هويان باو: تطبيق حماية العين من الضوء الأزرق مجاناً مع تذكيرات استراحة بالحيوانات

ويندوز يمكنه الحصول على جزيرة ديناميكية على سطح المكتب! مركز تحكم حديث يضيف نتوءاً أسود لجهازك — PyIsland

إنتاج دراما مصورة ثلاثية الأبعاد واقعية: دورة Seedance2.0 العملية الكاملة من الصفر إلى إنشاء محتوى عالي الجودة

يدعم ويندوز وماك! أحدث إصدار دائم مدى الحياة، إصلاح الصور القديمة، تكبير الصور بلا فقدان الجودة Aiarty Image Enhancer

دورة تدريبية عبر الإنترنت: أداة Github مفتوحة المصدر لتنزيل فيديوهات Bilibili / تدعم 8K وDolby Vision / Bilidown


معلومات الاتصال
- البريد الإلكتروني: massivesidehustles@outlook.com
