


-
Solounternehmens-Kurse
-
 Sonstiges
-
Auslandskurse
-
Fotografie & Schnitt
-
Community & Private Domain
-
Schreiben & Texten für Medien
-
Nebenverdienst-Projekte
-
E-Commerce
-
Kurzvideos & Live-Streaming
-
Künstliche Intelligenz (KI)
-
Software & Tools
-
Betriebssysteme
-
Plugins & Skripte
-
MacOS-Software
-
Android-Software
-
Windows-Software
KI-Stimmenklon-Software FastVits v22 unterstützt TXT-Text-zu-Klon-Stimme, Offline-Version
-
Goldfarming-Geldverdienplan für Spiele: täglich über 1.000 verdienen – ein stabiles 3-Jahres-Projekt, das jeder in der Freizeit umsetzen kann
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
AI-Comic-Drama-SOP-Systemkurs: Web-Novel-Auswahl und -Adaption, Drehbuchnormen, Text-zu-Bild/Bild-zu-Video-Fertigfilm, Voice-over und Schnitt – standardisiertes Full-Flow-Umsetzungs-Tutorial (Update 0826)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Hot-Game-vollautomatisiertes Verdienen: 500+ pro Tag, keine Erfahrung, einfache Bedienung – das stetigste langfristige Game-Verdienst-Nebenprojekt (enthüllt)
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Douyin-Verkaufs-Begleitcamp: kein echtes Auftreten nötig, Anfänger kopieren Vorlagen und produzieren Verkaufsvideos
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Premier-Game-Farming-Geldplan: 1.000+ täglich, für Normalverdiener in der Freizeit machbar! [Enthüllung]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten






-
ShuShu hat diesmal einen Verdienst! Keine Panik bei Windows-Formatproblemen – das Open-Source-Tool ShuShu Format Converter hilft, ein beliebtes GitHub-Juwel
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Lu Master v6.1024.4105.1121 schlanke Single-File-Version [Software Ge Chuzi · R1880]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Software zur Erstellung zweidimensionaler Cartoon-Animationen Moho Pro v14.3 [Software Gezhi Chuzi · R2355]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PC-Videobearbeitungssoftware Aiseesoft Filmai v1.0.18 【Software Gezhi·R2470】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
Microsoft To Do v2.147 Offizielle kostenlose Version [Software Gechui·R2618]
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten -
PR/AE/DaVinci/FCPX Video-Farbkorrektur-Oszilloskop-Plugin Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Gechui·R2748】
Referenz-Lernmaterial — in der Mitgliedschaft enthalten Mitgliedschaft erhalten





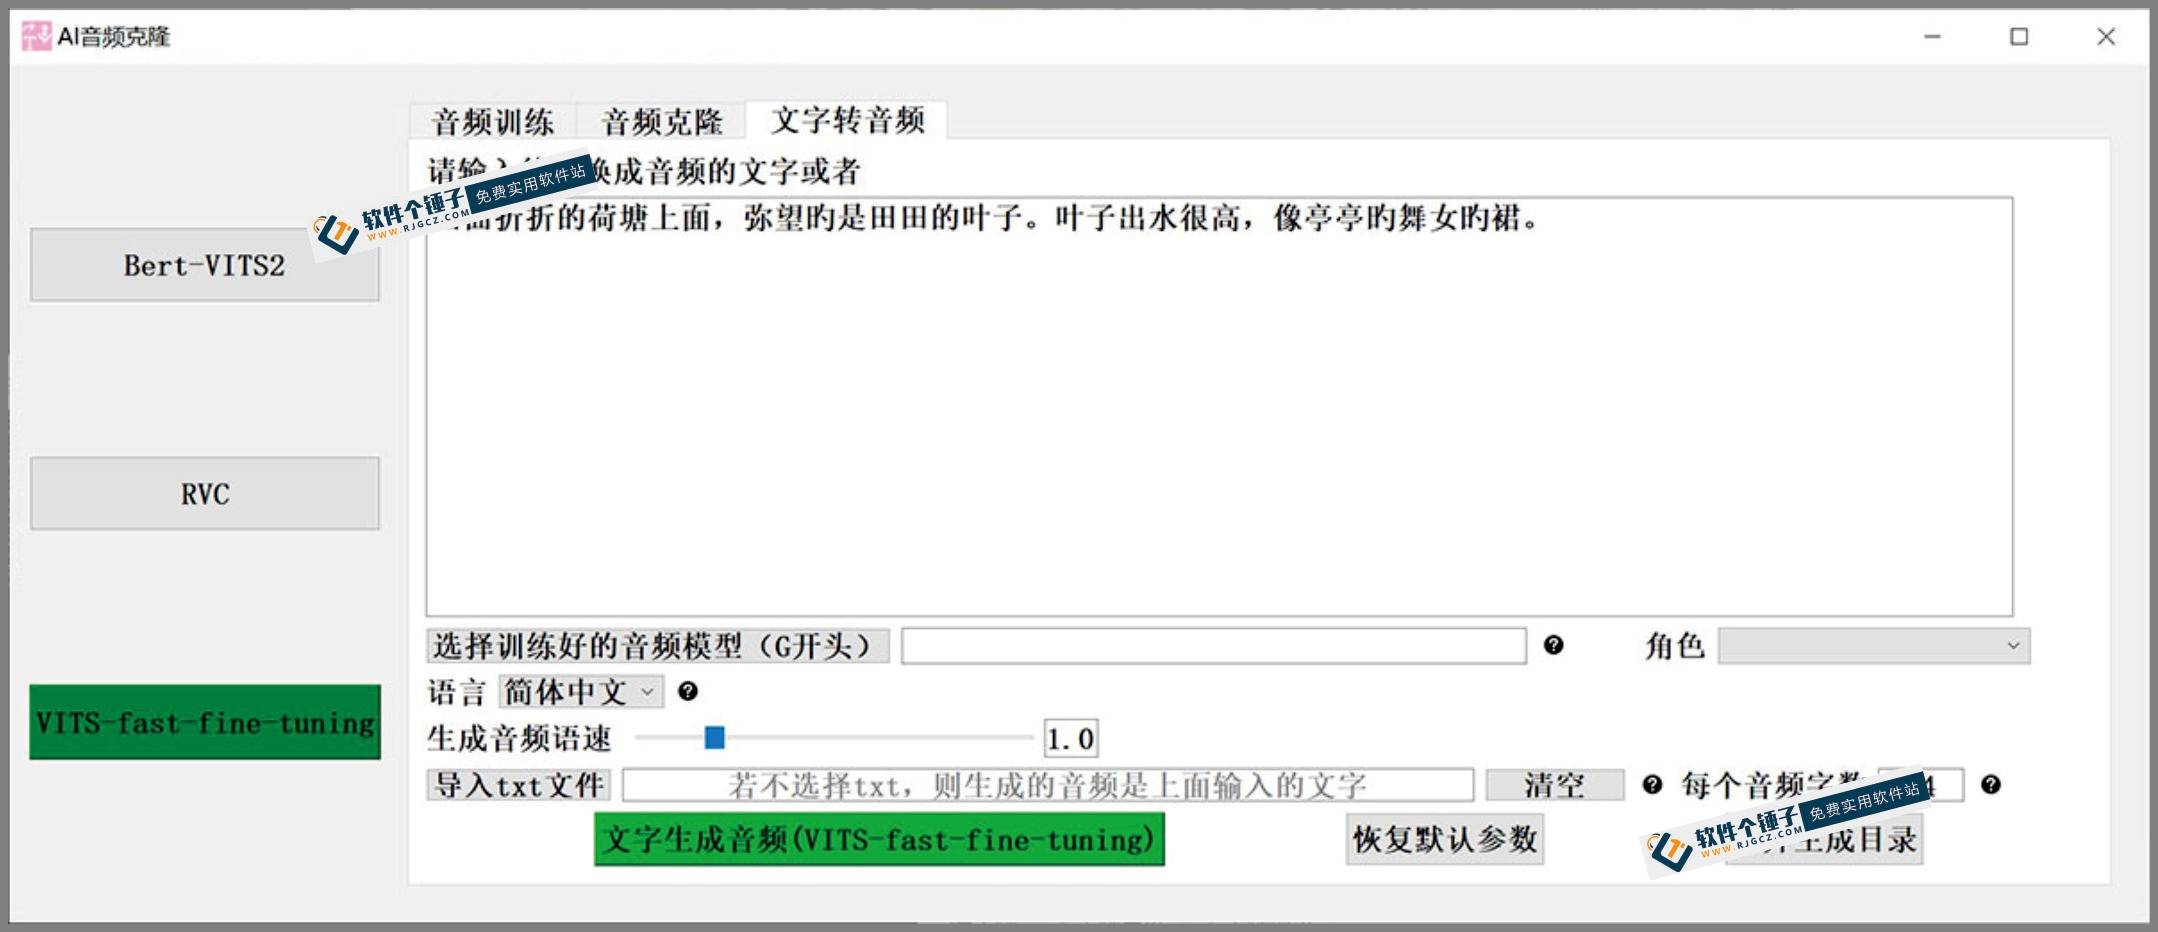
Die KI-Audio-Klon-Software ist ein leistungsstarkes Stimmenklon-Tool, das speziell für den PC entwickelt wurde und vollständig lokal und unabhängig läuft. Der ursprüngliche Zweck dieses Tools ist es, Nutzern zu helfen, bestimmte Stimmklänge mühelos zu klonen und Textinhalte in Sprachausgabe umzuwandeln, wobei der Simulationseffekt dem Original sehr nahe kommt. Bemerkenswert ist, dass die Software nicht installiert werden muss und nach dem Entpacken sofort verwendet werden kann – einfach und schnell in der Bedienung.

Vollständig offline betreibbar, jederzeit einsatzbereit
Die KI-Audio-Klon-Software ist nicht auf eine Netzwerkverbindung angewiesen und läuft vollständig auf dem lokalen Computer. Das bedeutet, Sie können jederzeit jeden Text in Sprache umwandeln, ideal für die Erstellung von Hörbüchern oder anderen Sprachanwendungen. Dank der fortschrittlichen lokalen KI-Engine erreicht das Softwarepaket eine Größe von 10 GB, was hochwertige Ausgabe und schnelle Verarbeitung gewährleistet.
Hauptfunktionen
- Stimmenklonen:Trainiert die von Ihnen bereitgestellten Sprachproben zu einem präzisen Sprachmodell.
- Text-zu-Sprache:Die Software kann Text aus dem Eingabefeld oder aus TXT-Dokumenten in eine Sprachausgabe mit demselben Stimmklang umwandeln. Wenn sowohl Eingabetext als auch ein TXT-Dokument vorhanden sind, wird standardmäßig der Inhalt des TXT-Dokuments bevorzugt verarbeitet.
Software-Update-Verlauf
- Version V2.2 (Aktualisierungsdatum: 2024-02-08):Upgrade auf Bert-VITS2, verbesserte Modellverarbeitungsfähigkeit.
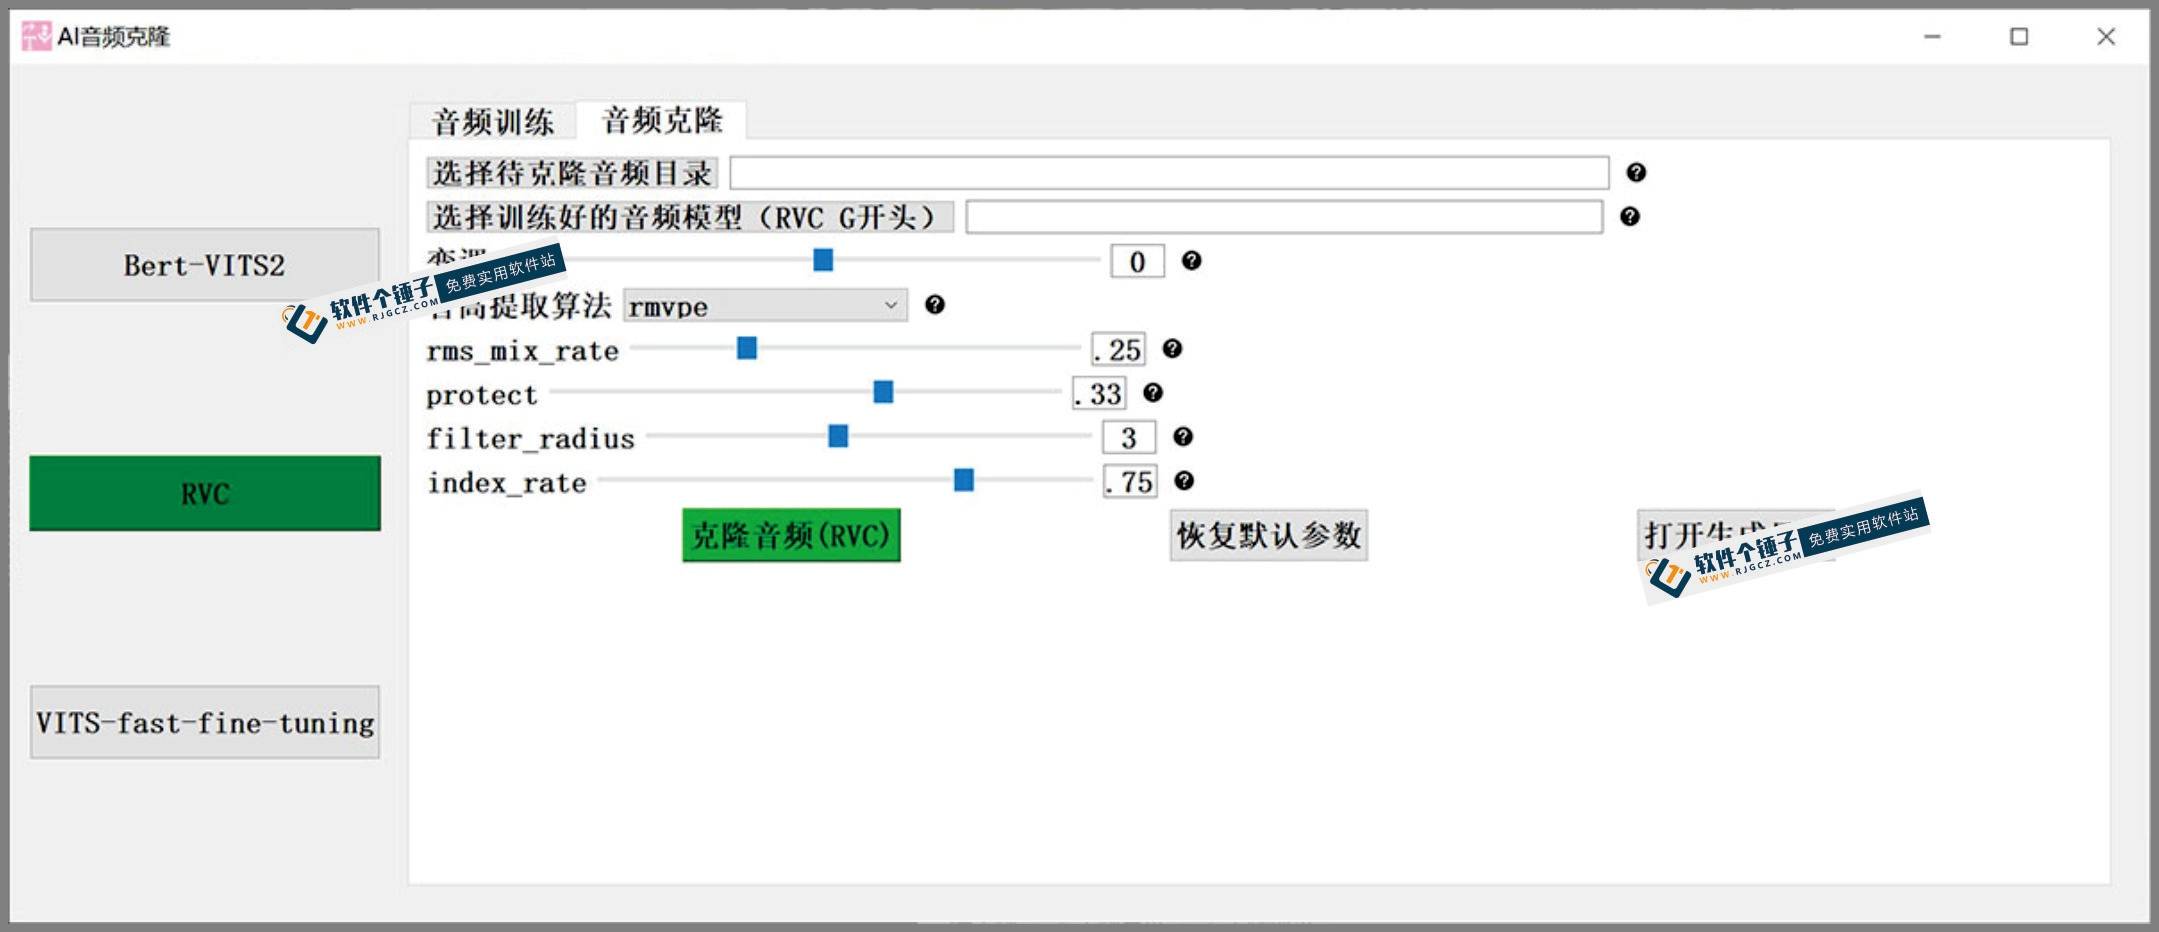
- Version V2.0 (Aktualisierungsdatum: 2023-11-11):Neu hinzugefügt: das leistungsstarke Audio-Klon-Projekt RVC, das komplexere Aufgaben zum Klonen von Gesangs- und Singstimmen unterstützt.
Die KI-Audio-Klon-Software bietet Nutzern durch ihre leistungsstarken Funktionen und benutzerfreundliche Bedienung eine effiziente und komfortable Sprachsynthese-Lösung. Ob für persönliche Unterhaltung oder professionelle Produktion – sie ist eine unverzichtbare Werkzeugwahl.
Die Methode zur Erstellung und Synthese individueller Stimmen mit der KI-Audio-Klon-Software lässt sich in zwei große Schritte unterteilen:
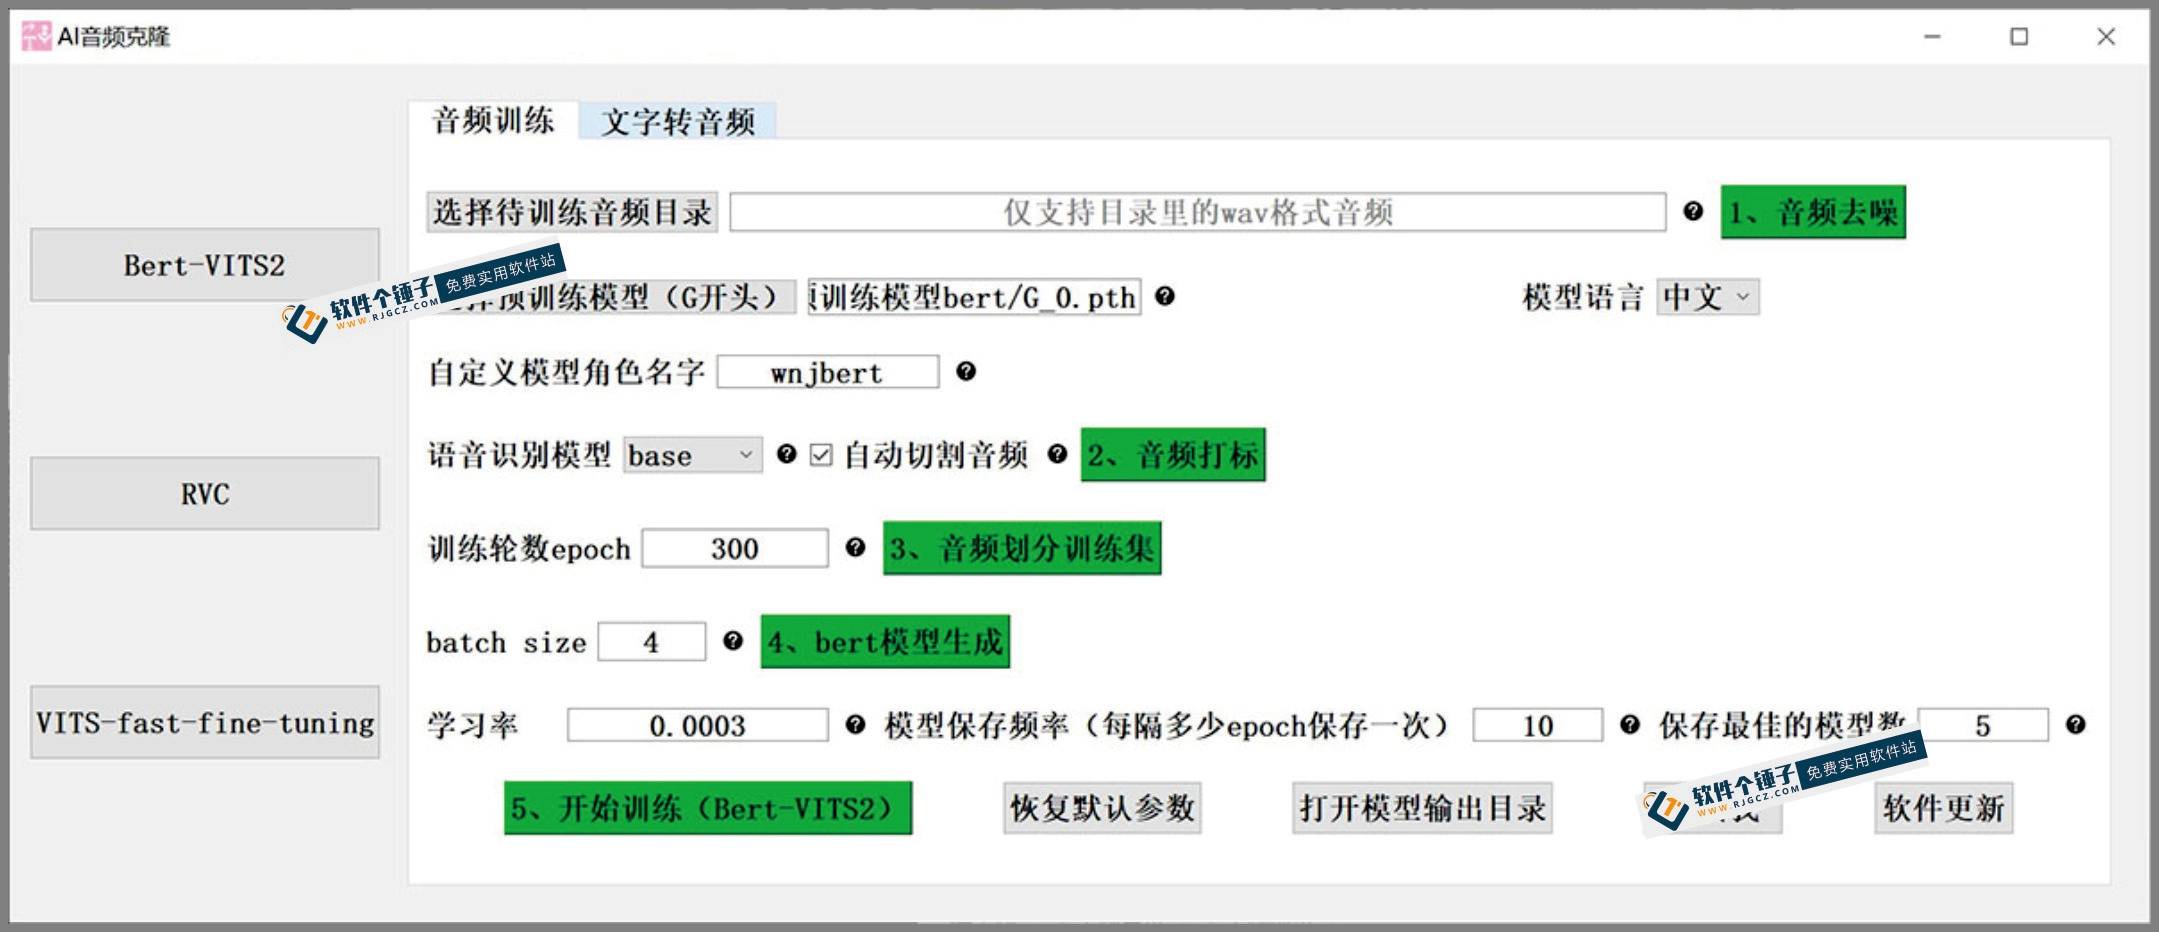
1. Erstellung einer Sprachvorlage
Das Ziel dieser Phase ist es, eine an Ihre Bedürfnisse angepasste Sprachvorlage zu erstellen.
1. Wählen Sie den zu trainierenden Audioordner: Die Software verarbeitet automatisch Ordner mit WAV-Audio, führt Schneiden, Entfernen von Hintergrundmusik und Rauschen sowie weitere Vorverarbeitungsaufgaben durch.



2. Verwenden Sie ein vortrainiertes Modell: In der Regel ist kein manueller Eingriff erforderlich, die Software lädt standardmäßig das vom Autor bereitgestellte Modell. Wenn eine manuelle Auswahl erforderlich ist, können Sie direkt im Ordner mit den gespeicherten Modellen auswählen.
3. Benennen Sie die Rolle Ihres benutzerdefinierten Modells: Geben Sie Ihrem Modell einen Namen, verwenden Sie einen englischen Namen.
4. Wählen Sie das Spracherkennungsmodell: In der Regel reicht das Standard-Base-Modell aus.
5. Legen Sie die Anzahl der Trainingsepochen (epoch) fest: Empfohlen werden 200; obwohl oft schon einige Dutzend Runden ausreichen, erzielen 300 Runden ein besseres Ergebnis.
6. Legen Sie die Batch-Größe (batch size) fest: Dies sollte entsprechend Ihrer VRAM-Kapazität angepasst werden, in der Regel eher kleiner eingestellt.
7. Legen Sie die Lernrate fest: Die Standardeinstellung kann verwendet werden. Nach Abschluss der oben genannten Einstellungen klicken Sie auf Training starten, um mit der Erstellung der Sprachvorlage zu beginnen.

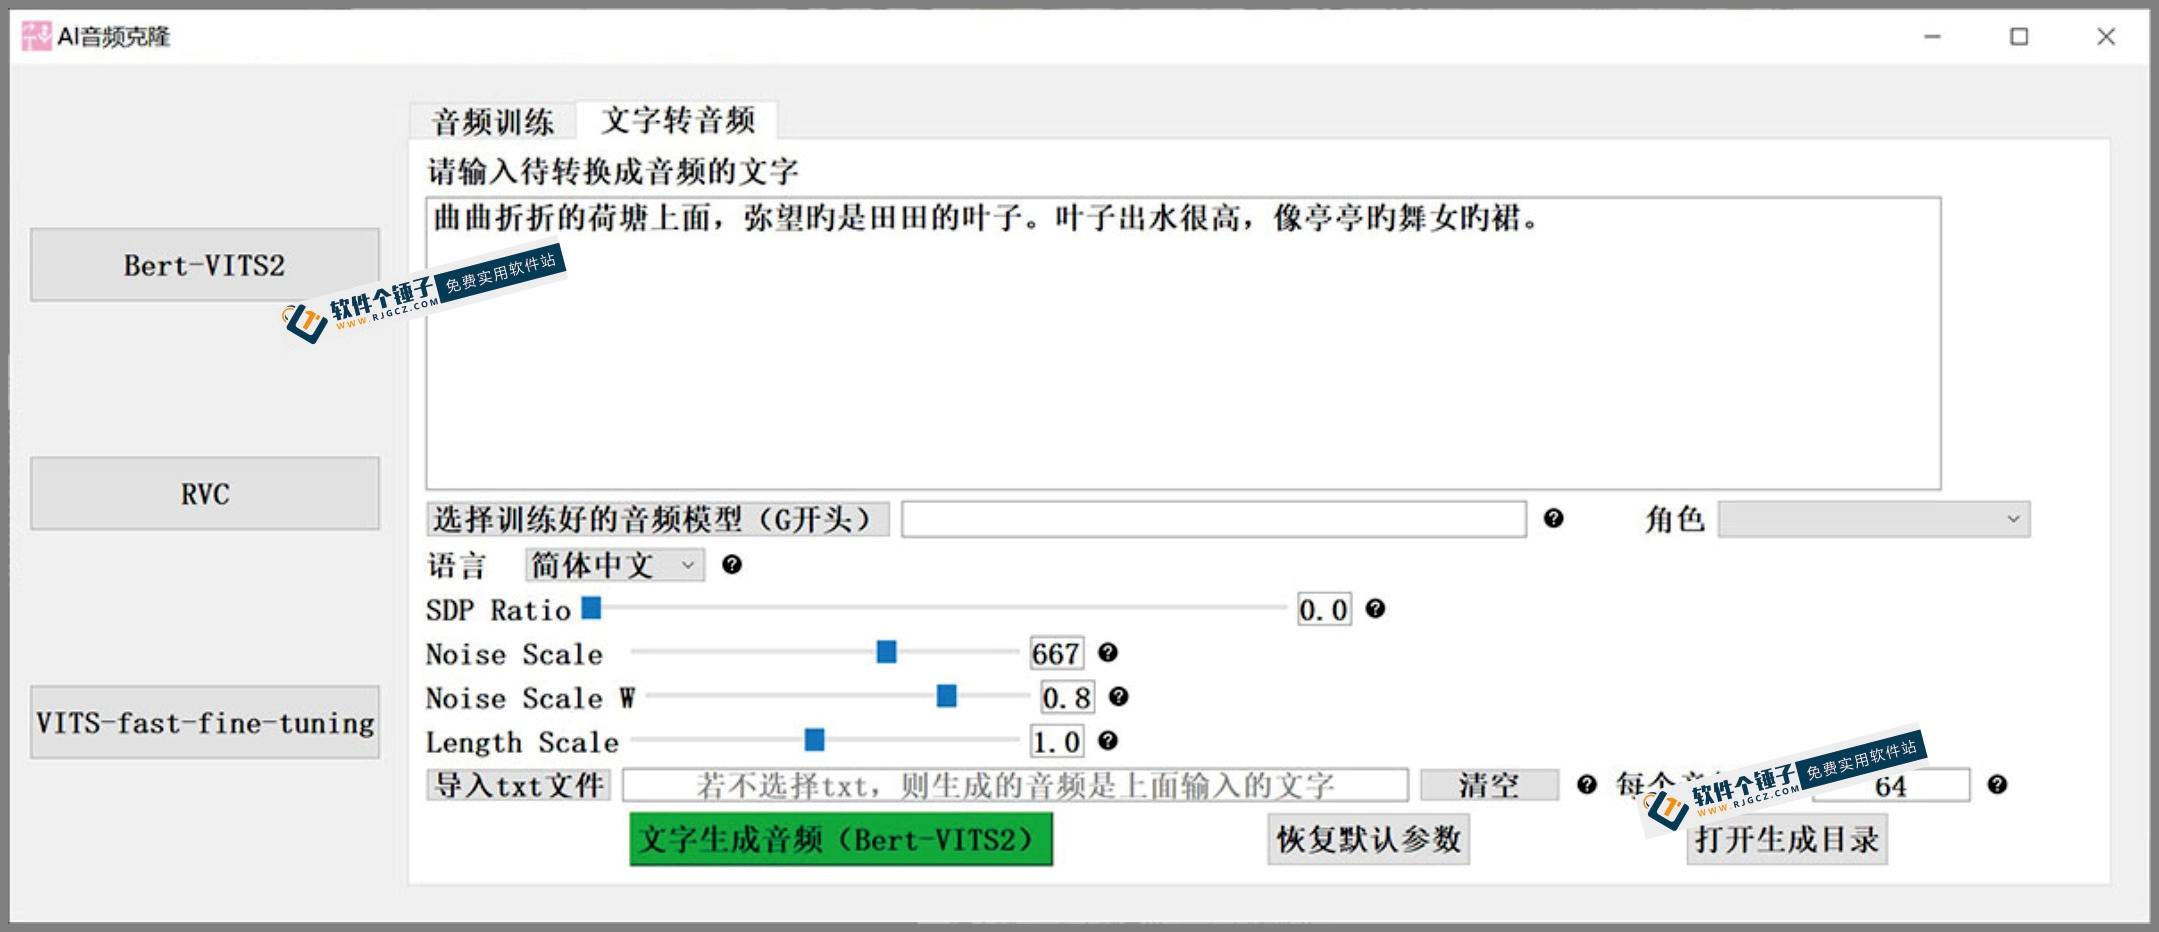
2. Text-zu-Sprache-Synthese
Nachdem Sie die Sprachvorlage erstellt haben, können Sie mit der Umwandlung von Text in Sprache beginnen.
1. Text eingeben oder importieren: Geben Sie den Text direkt in die Software ein oder fügen Sie den umzuwandelnden Text durch Importieren einer TXT-Datei hinzu. (Wenn beides vorhanden ist, wird der Text in der TXT-Datei bevorzugt verarbeitet)
2. Wählen Sie das trainierte Audiomodell: Wählen Sie das in den vorherigen Schritten erstellte Audiomodell, das mit G beginnt.


3. Beibehalten der Standardeinstellungen: Andere Einstellungen wie SDP-Mischverhältnis, Rauschpegel, Sprechgeschwindigkeit usw. können auf Standard belassen werden.
4. Sprache generieren: Nach Abschluss der Einstellungen klicken Sie auf Sprache generieren, und die Software erzeugt die Sprache basierend auf dem eingegebenen Text und dem ausgewählten Modell.
Mit diesen beiden Schritten können Sie ganz einfach KI-Audio-Klonsoftware nutzen, um personalisierte Sprachvorlagen zu erstellen und jeden Text in eine bestimmte Stimme umzuwandeln.
Ähnliche Kurse

Super lokale Toolbox! Integrierte Bildschirmaufnahme, Audio-/Video-Schnitt & -Zusammenführung, Video-Komprimierung & -Extraktion, für immer gratis – Kedou Video Converter

100%% perfektes Gratis-Tool! Alles-in-einem-Multifunktions-PDF-Software: PDF konvertieren, komprimieren, bearbeiten etc., minimalistisch, keine Werbung, so schön – JOPDF

Open-Source-Desktop-Fernzugriffstool, weit besser als kostenpflichtige Versionen! Kostenlos und unbegrenzt für Privat und Gewerbe nutzbar, plattformübergreifend, Desktop-Fernsteuerung – HopToDesk

Neuestes Tool zum Herunterladen von Lehrmaterialien für Grund- und Mittelschule: komplette Jahrgangsstufen, mit begleitenden Folien, Videos und Audios auf einen Klick

Den ganzen Tag auf den Bildschirm, ohne Augenschutz-Tool? Kostenlose Blaulicht-Schutz-App für PC, mit Haustier, das dich an Pausen erinnert, Huyanbao

PyIsland: Modernes System-Control-Center mit Desktop-Dynamic-Island für Windows

3D-Simulation-Manju-Produktion: Seedance 2.0 Komplettprozess-Praxis, von 0 bis zur hochwertigen Manju-Kreation

Für Win und Mac! Neueste lebenslange Version: Restaurierung alter Fotos, Bildklarheit und verlustfreie Vergrößerung - Aiarty Image Enhancer

Github Open-Source-Bilibili-Downloader: Stapel-Download von Bilibili-Videos mit 8K und Dolby Vision-Unterstützung – einfach zu bedienen, Bilidown

Windows-Desktop-Werkzeugsammlung: 50+ praktische, schlichte Desktop-Widgets, mit Screenshot, Screenrecording, Übersetzung, Wetter u.v.m. – Duomi-Toolbox

