


-
Cursos de negocio en solitario
-
 Otros
-
Tutoriales en el extranjero
-
Fotografía & Edición
-
Comunidad & Dominio privado
-
Escritura & Redacción para medios
-
Proyectos de ingresos extra
-
Comercio electrónico
-
Vídeo corto & Transmisión en vivo
-
Inteligencia Artificial (IA)
-
Software & Herramientas
-
Sistemas operativos
-
Plugins & Scripts
-
Software MacOS
-
Software Android
-
Software Windows
Software de clonación de voz con IA FastVits v22 compatible con conversión de texto TXT a voz clonada, versión offline
-
Plan para ganar dinero con la cría de oro en juegos: gana más de 1000 al día, un proyecto estable de 3 años que cualquiera puede hacer en su tiempo libre
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Curso sistemático con SOP de drama de cómic con IA: selección y adaptación de novelas web, normas de guion, película terminada de texto a imagen e imagen a video, edición de locución: tutorial estanda
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Farming automatizado de juegos populares: 500+/día, sin experiencia, sencillo – el extra estable a largo plazo más fiable [Revelado]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
ShuShu esta vez sí cumplió! No te asustes con los problemas de formato de Windows: la herramienta open source ShuShu Format Converter, una joya popular en GitHub
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Campamento de acompañamiento de ventas en Douyin: sin aparecer en cámara, principiantes copian plantillas y producen videos
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Plan de ingresos por farming de juegos en su estreno: más de 1.000 al día, ¡apto para gente normal en su tiempo libre! [Revelación]
Material de estudio de referencia — incluido con la membresía Obtener membresía






-
ShuShu esta vez sí cumplió! No te asustes con los problemas de formato de Windows: la herramienta open source ShuShu Format Converter, una joya popular en GitHub
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Master Lu v6.1024.4105.1121 versión simplificada de archivo único [Software Ge Chuizi · R1880]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Software de creación de animación de dibujos animados 2D Moho Pro v14.3 [Software Ge Chuzi · R2355]
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Software de edición y procesamiento de video para PC Aiseesoft Filmai v1.0.18
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Microsoft To Do v2.147 versión oficial gratuita【Software Ge Chuizi·R2618】
Material de estudio de referencia — incluido con la membresía Obtener membresía -
Plugin de osciloscopio de corrección de color de vídeo para PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138 [Software Gechuzi·R2748]
Material de estudio de referencia — incluido con la membresía Obtener membresía





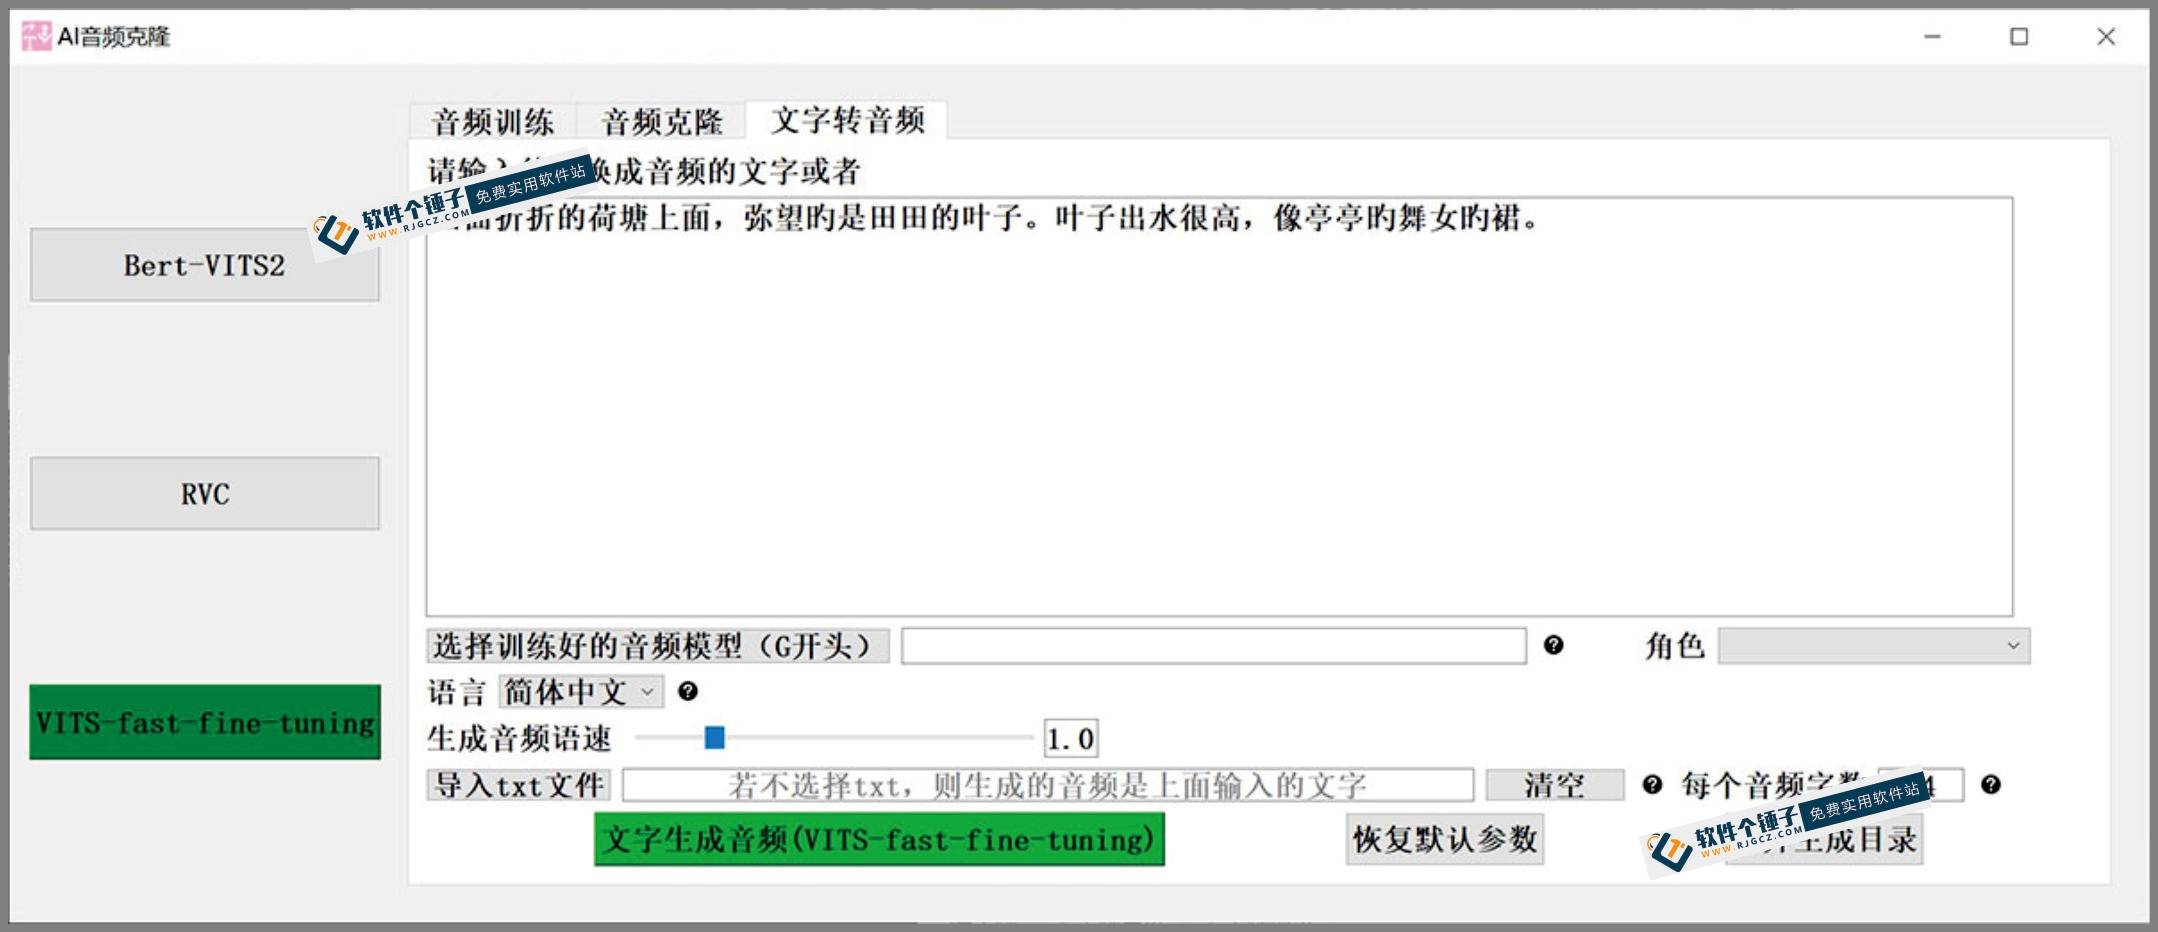
El software de clonación de audio con IA es una potente herramienta de clonación de voz desarrollada específicamente para PC, que puede funcionar de forma completamente independiente en local. Esta herramienta fue diseñada con el propósito de ayudar a los usuarios a clonar fácilmente un timbre de voz específico y convertir el contenido de texto en salida de voz, con un efecto de simulación extremadamente similar a la voz original. Es digno de elogio que el software no requiere instalación y se puede usar tras descomprimirlo, con una operación sencilla y rápida.

Funcionamiento completamente offline, disponible en cualquier momento
El software de clonación de audio con IA no depende de la conexión a internet y funciona completamente en la computadora local. Esto significa que puede convertir cualquier texto a voz en cualquier momento, ideal para crear audiolibros u otras aplicaciones de voz. Gracias al uso de un avanzado motor de IA local, el paquete del software alcanza los 10 GB, lo que garantiza una salida de alta calidad y una velocidad de procesamiento rápida.
Funciones principales
- Clonación de voz:Entrena la muestra de voz que proporcione hasta obtener un modelo de voz preciso.
- Texto a voz:El software puede convertir el texto del cuadro de entrada o de un documento TXT en salida de voz con el mismo timbre. Si existen simultáneamente texto de entrada y documento TXT, se procesará por defecto primero el contenido del documento TXT.
Historial de actualizaciones del software
- Versión V2.2 (fecha de actualización: 2024-02-08):Actualizado a Bert-VITS2, mejorando la capacidad de procesamiento del modelo.
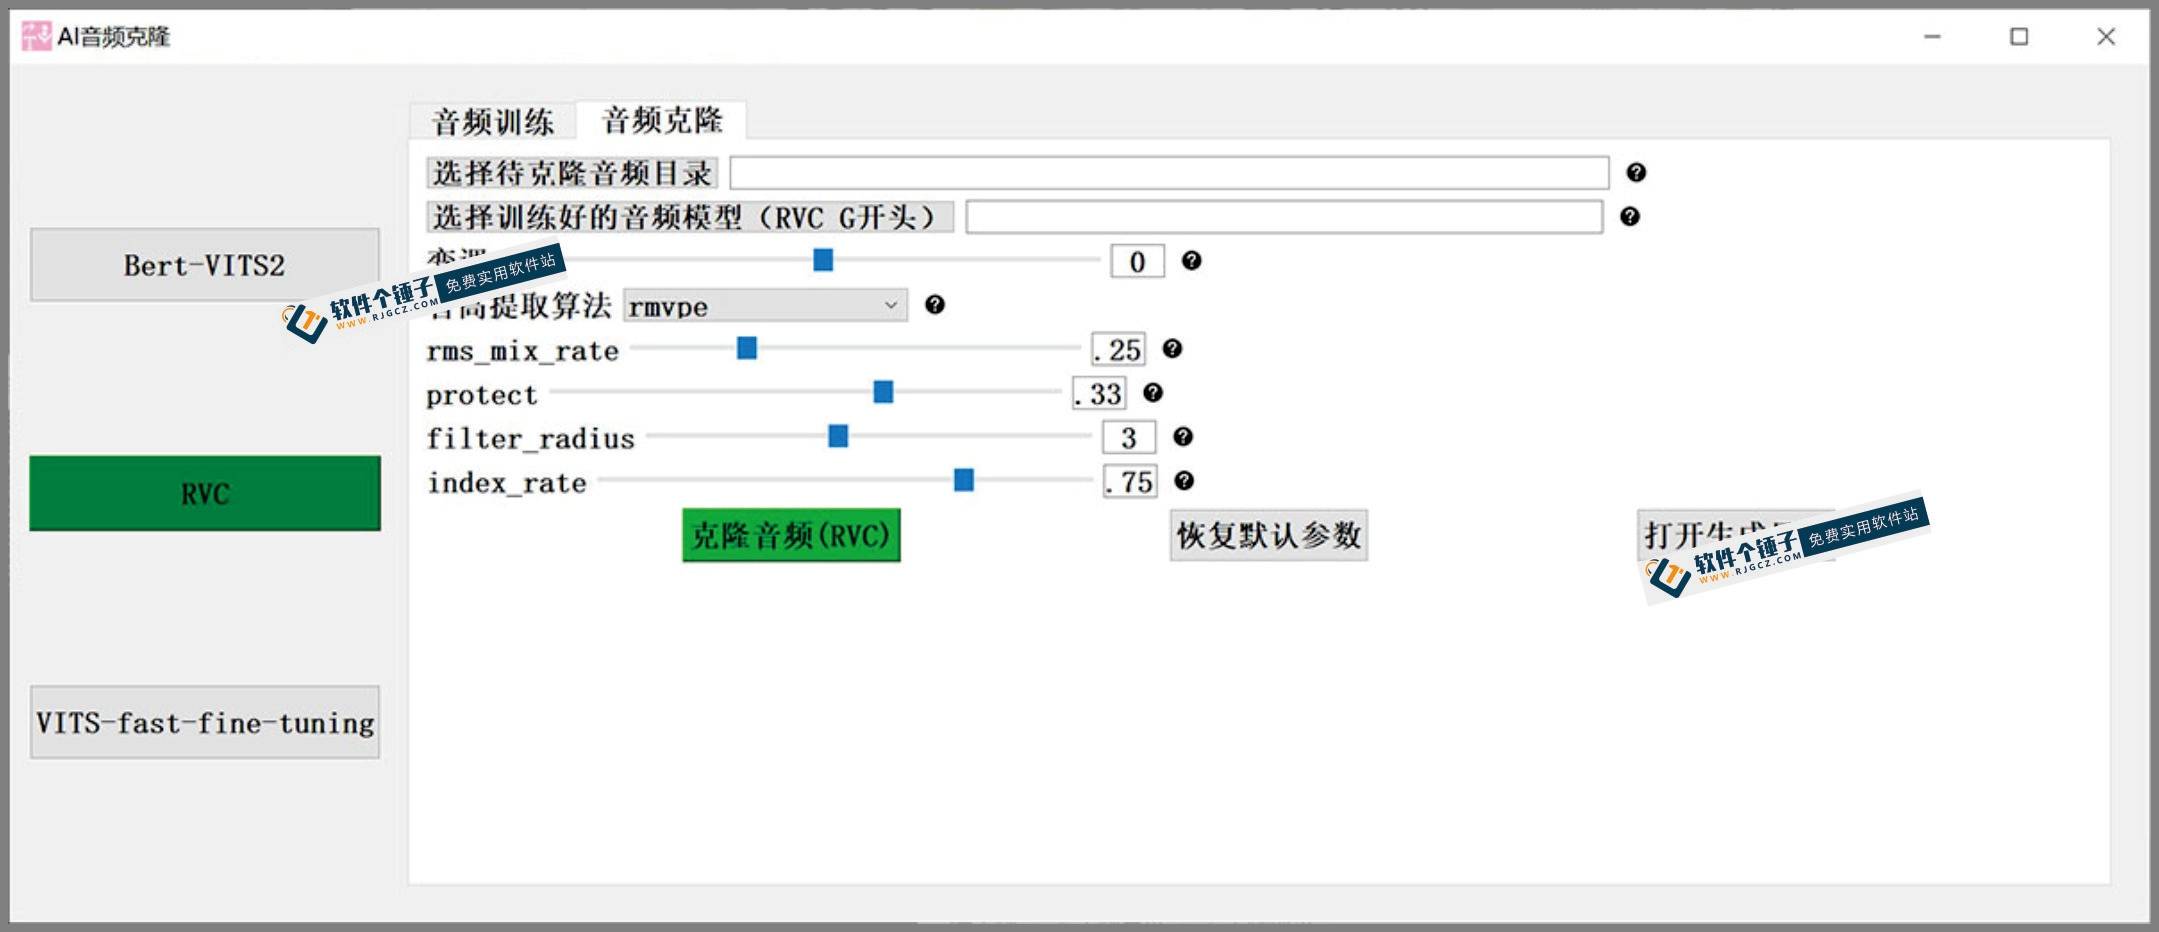
- Versión V2.0 (fecha de actualización: 2023-11-11):Se añade el potente proyecto de clonación de audio RVC, compatible con tareas de clonación de voz humana y canto más complejas.
El software de clonación de audio con IA, gracias a sus potentes funciones y su operación fácil de usar, ofrece a los usuarios una solución de síntesis de voz eficiente y conveniente. Ya sea para entretenimiento personal o producción profesional, es una opción de herramienta excepcional.
El método para crear y sintetizar voces personalizadas con el software de clonación de audio con IA se puede dividir en dos grandes pasos:
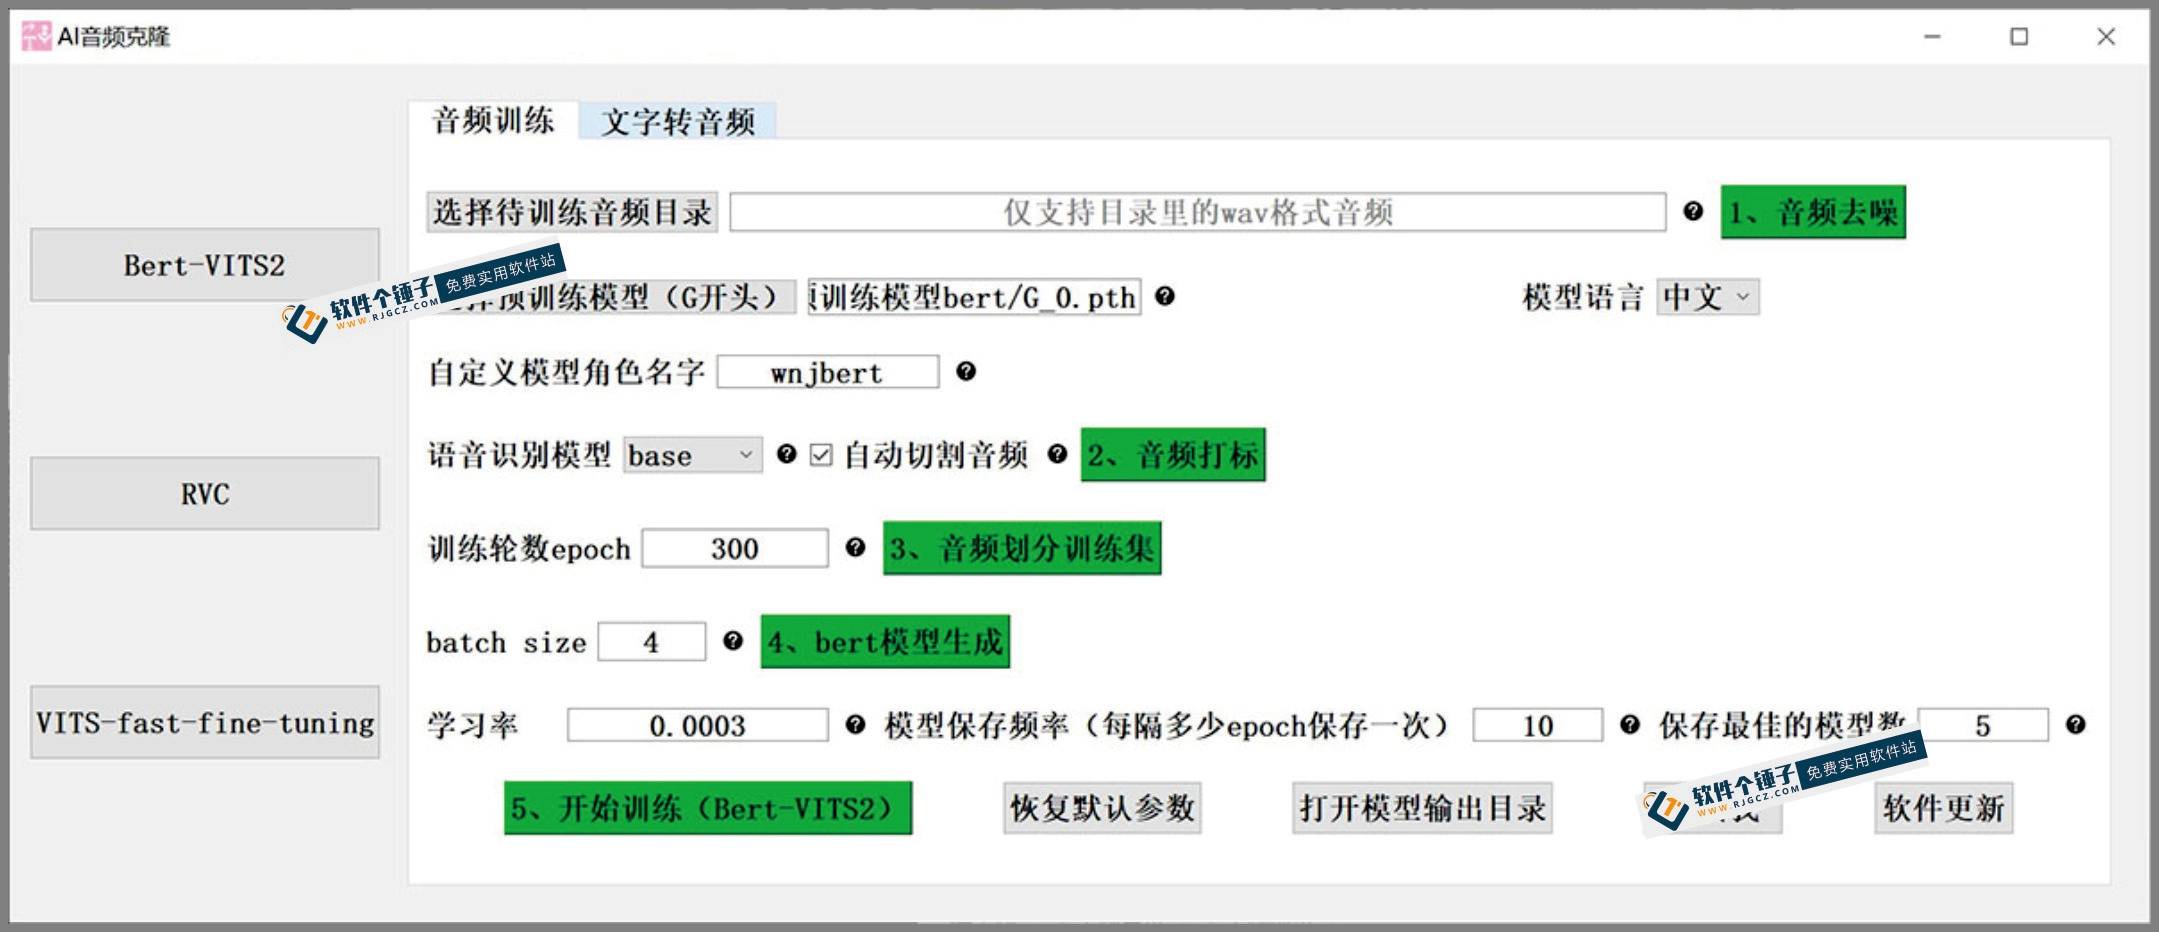
1. Crear una plantilla de voz
El objetivo de esta etapa es crear una plantilla de voz personalizada según sus necesidades.
1. Seleccionar la carpeta de audio a entrenar: el software procesará automáticamente la carpeta que contenga audio en formato WAV, realizando tareas de preprocesamiento como corte, eliminación de música de fondo y ruido.



2. Usar un modelo preentrenado: normalmente no se requiere operación manual, el software cargará por defecto el modelo proporcionado por el autor. Si necesita seleccionarlo manualmente, puede elegirlo directamente en la carpeta donde se almacena el modelo.
3. Nombrar el rol del modelo personalizado: asigne un nombre a su modelo, usando un nombre en inglés.
4. Seleccionar el modelo de reconocimiento de voz: generalmente basta con usar el modelo base predeterminado.
5. Establecer el número de rondas de entrenamiento (epoch): se recomienda establecerlo en 200; aunque normalmente unas pocas decenas de rondas son suficientes, 300 rondas pueden lograr un mejor efecto.
6. Establecer el tamaño de lote (batch size): esto debe ajustarse según la capacidad de su memoria de video; generalmente se establece un valor más pequeño.
7. Establecer la tasa de aprendizaje: basta con usar la configuración predeterminada. Después de completar los ajustes anteriores, haga clic en iniciar entrenamiento para comenzar a crear la plantilla de voz.

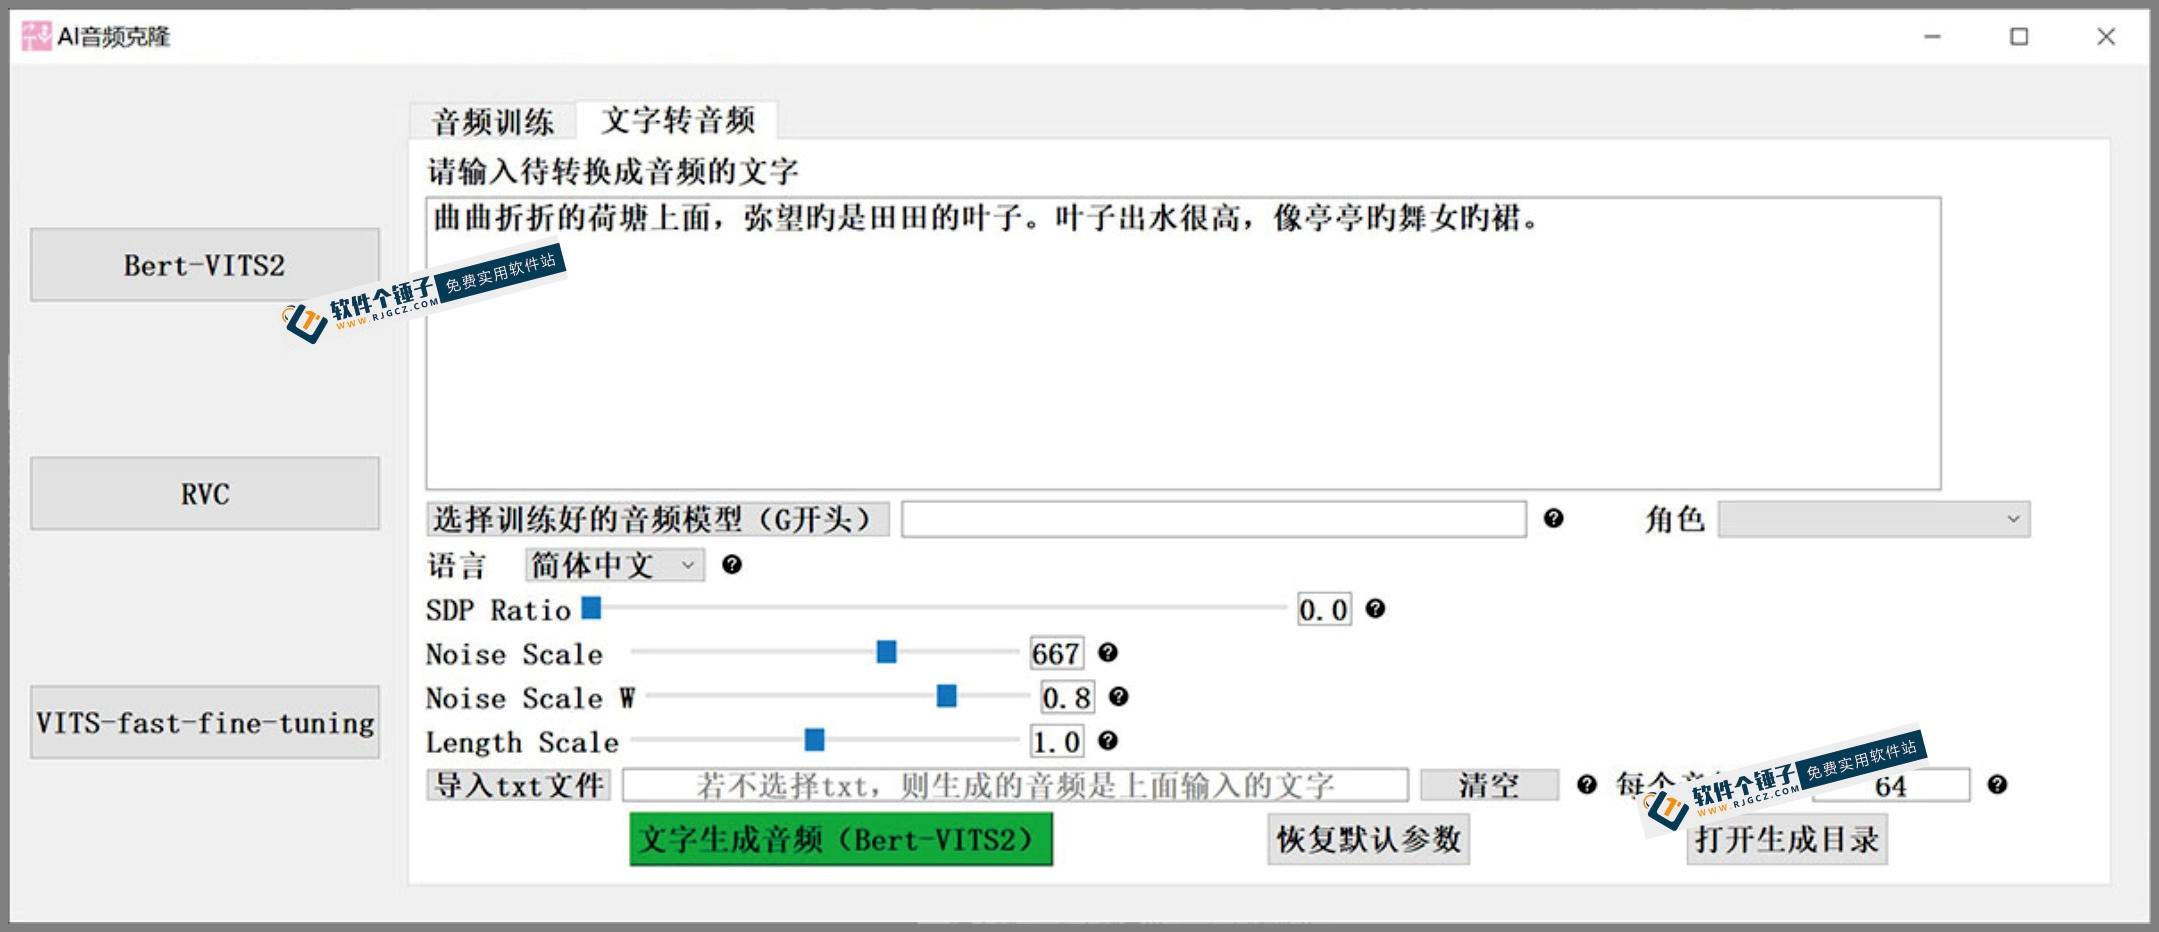
2. Síntesis de texto a voz
Una vez creada la plantilla de voz, puede comenzar a convertir texto en voz.
1. Introducir o importar texto: introduzca el texto directamente en el software o añada el texto que desea convertir mediante la importación de un archivo TXT. (Si existen ambos, se procesará primero el texto del archivo TXT)
2. Seleccionar el modelo de audio entrenado: seleccione el modelo de audio que comienza con G creado en los pasos anteriores.


3. Mantener la configuración predeterminada: otras configuraciones como la proporción de mezcla SDP, el nivel de ruido, la velocidad de habla, etc., pueden mantenerse por defecto.
4. Generar voz: después de completar la configuración, haga clic en generar voz y el software generará la voz según el texto introducido y el modelo seleccionado.
Con estos dos pasos, puedes usar fácilmente el software de clonación de audio con IA para crear plantillas de voz personalizadas y convertir cualquier texto en una voz específica.
Cursos relacionados

¡Súper caja de herramientas local! Grabación de pantalla integrada, corte y unión de audio y vídeo, compresión y extracción de vídeo, gratis para siempre - Kedou Video Converter

¡Herramienta gratis 100% perfecta! Software PDF multifunción todo en uno: convertir, comprimir y editar PDF, minimalista, sin anuncios, tan bueno - JOPDF

¡Herramienta de escritorio remoto de código abierto, superior a las versiones de pago! Gratis e ilimitada para uso personal y comercial, multiplataforma – HopToDesk

Última herramienta de descarga de libros de primaria y secundaria: recursos de un curso completo, diapositivas, videos y audio con un clic

Todo el día frente a la pantalla, ¿sin una herramienta de protección ocular? Llega una aplicación gratuita de protección contra la luz azul para PC, con una mascota que te recuerda descansar, Huyanbao

PyIsland: centro de control del sistema moderno con Dynamic Island en el escritorio de Windows

Producción de manhua 3D simulada: práctica completa de Seedance 2.0, te lleva de 0 a 1 a crear manhuas de alta calidad

¡Compatible con Win/Mac! Última versión de por vida: restaura fotos antiguas, mejora la nitidez y amplía sin pérdida - Aiarty Image Enhancer

Herramienta de descarga de Bilibili de código abierto en Github: descarga por lotes de vídeos de Bilibili con soporte 8K y Dolby Vision, fácil de usar, Bilidown

Colección de herramientas de escritorio para Windows: más de 50 widgets prácticos y minimalistas, con captura de pantalla, grabación, traducción, clima, etc., caja de herramientas Duomi

