


-
Corsi per imprenditori solisti
-
 Altri
-
Tutorial esteri
-
Fotografia & Montaggio
-
Community & Dominio privato
-
Scrittura & Copywriting per media
-
Progetti di reddito extra
-
E-commerce
-
Video brevi & Live streaming
-
Intelligenza Artificiale (IA)
-
Software & Strumenti
-
Sistemi operativi
-
Plugin & Script
-
Software MacOS
-
Software Android
-
Software Windows
Software di clonazione vocale AI FastVits v22 supporta la conversione di testo TXT in voce clonata Versione offline
-
Piano di guadagno con il farming di oro nei videogiochi: guadagna oltre 1k al giorno, un progetto stabile da 3 anni che chiunque può fare nel tempo libero
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Corso sistematico SOP per AI comic drama: selezione e adattamento di web novel, norme per le sceneggiature, da testo a immagine e da immagine a video fino al film finito, doppiaggio e montaggio - tutorial completo e standardizzato (aggiornamento 0826)
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Farming automatizzato di giochi popolari: 500+/giorno, senza esperienza, semplice – l'extra stabile a lungo termine più affidabile [Rivelato]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
ShuShu questa volta si è fatto onore! Niente panico con i problemi di formato di Windows: lo strumento open source ShuShu Format Converter, un gioiello popolare su GitHub
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Camp di accompagnamento vendite Douyin: senza apparizione reale, principianti copiano template e producono video
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Piano di guadagno con il farming nei giochi in anteprima: 1.000+ al giorno, fattibile dalle persone comuni nel tempo libero
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati






-
ShuShu questa volta si è fatto onore! Niente panico con i problemi di formato di Windows: lo strumento open source ShuShu Format Converter, un gioiello popolare su GitHub
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Lu Master v6.1024.4105.1121 versione alleggerita in file singolo [Software Ge Chuizi - R1880]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Software per la creazione di animazioni cartonate bidimensionali Moho Pro v14.3 [Software Ge Chuzi · R2355]
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Software di editing e elaborazione video per PC Aiseesoft Filmai v1.0.18 【Software Ge Chuzi·R2470】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Microsoft To Do v2.147 versione ufficiale gratuita【Software Gechuzi·R2618】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati -
Plugin oscilloscopio per color grading video PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Ge Chuizi·R2748】
Materiale di studio di riferimento — incluso con l'abbonamento Abbonati





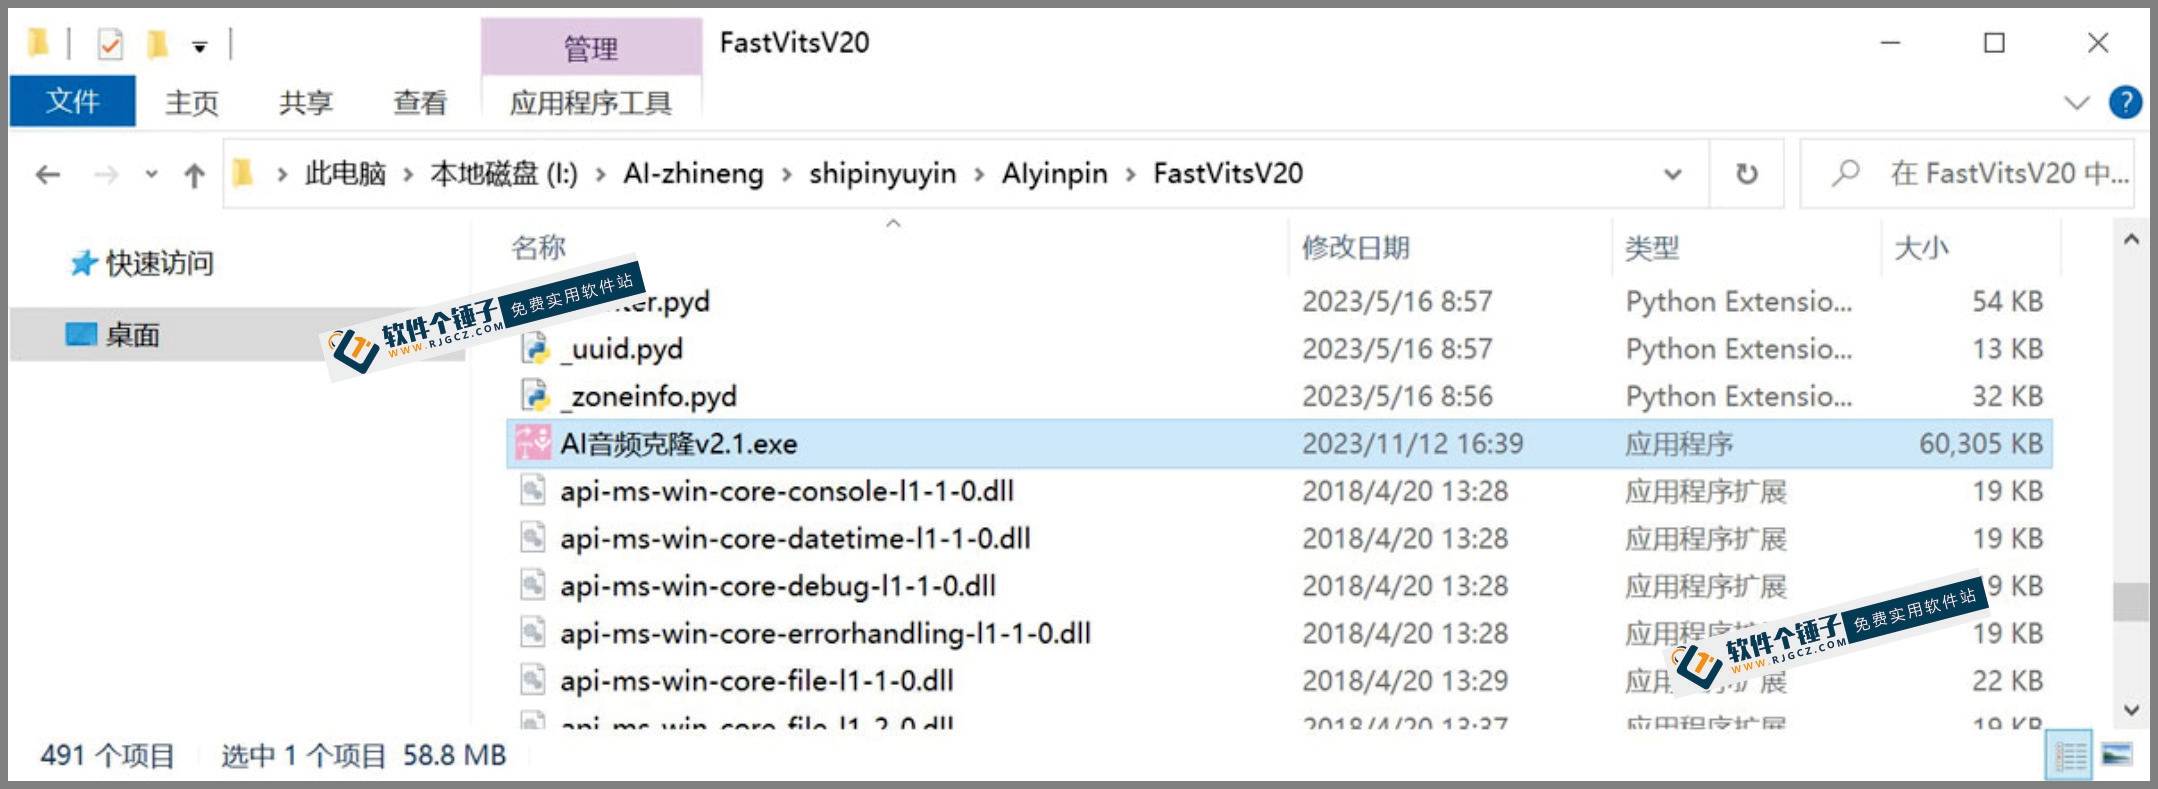
Il software di clonazione audio AI è un potente strumento di clonazione vocale sviluppato appositamente per PC, in grado di funzionare in modo completamente indipendente in locale. Questo strumento è stato progettato con l'intento di aiutare gli utenti a clonare facilmente timbri vocali specifici e a convertire il contenuto testuale in output vocale, con un effetto di simulazione estremamente simile alla voce originale. Notevole è il fatto che il software non richiede installazione: è sufficiente decomprimerlo per utilizzarlo, con un funzionamento semplice e rapido.

Funzionamento completamente offline, disponibile in qualsiasi momento
Il software di clonazione audio AI non dipende dalla connessione di rete e funziona completamente sul computer locale. Ciò significa che puoi convertire qualsiasi testo in voce in qualsiasi momento, ideale per creare audiolibri o altre applicazioni vocali. Grazie all'utilizzo di un avanzato motore AI locale, il pacchetto software raggiunge i 10GB, garantendo output di alta qualità e velocità di elaborazione rapida.
Funzioni principali
- Clonazione vocale:Addestra il campione vocale fornito in un modello vocale preciso.
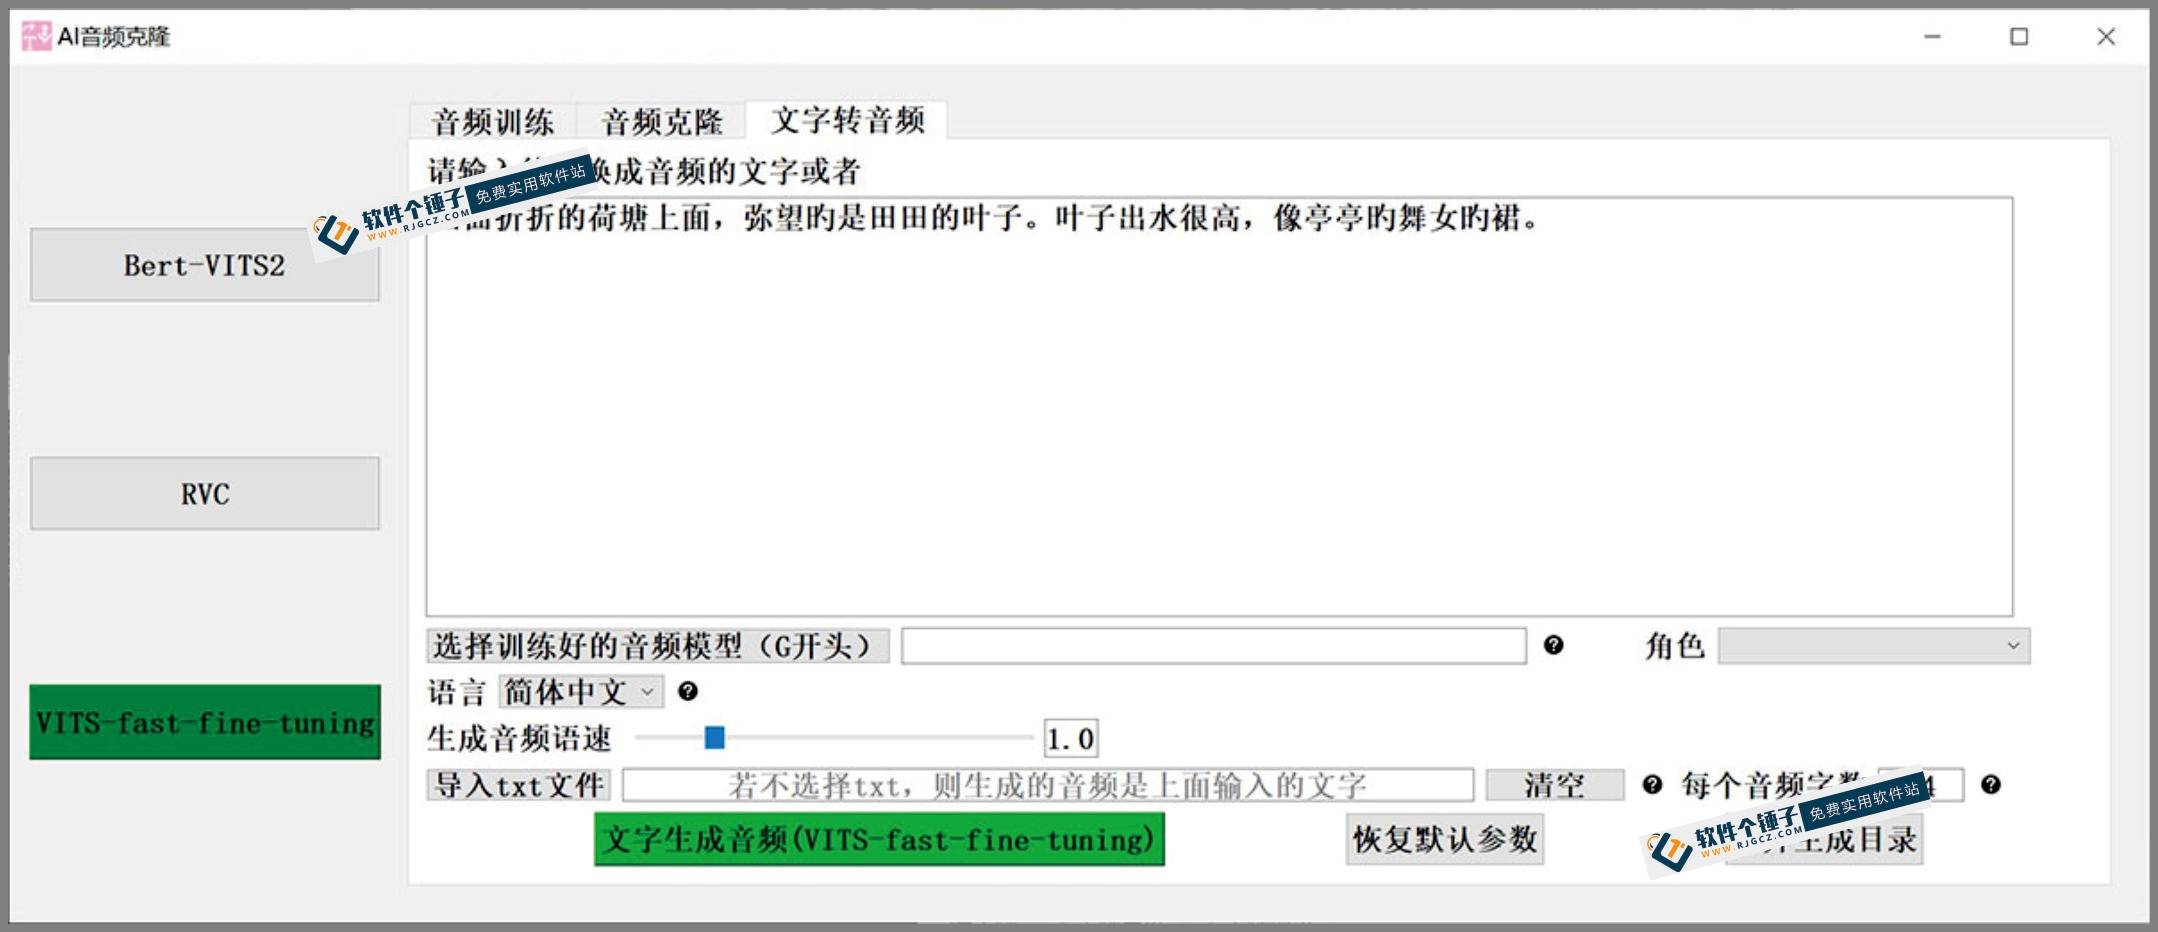
- Da testo a voce:Il software è in grado di convertire il testo inserito nella casella di input o in un documento TXT in output vocale con lo stesso timbro. Se sono presenti contemporaneamente testo inserito e documento TXT, verrà data priorità predefinita al contenuto del documento TXT.
Cronologia aggiornamenti del software
- Versione V2.2 (data di aggiornamento: 2024-02-08):Aggiornamento a Bert-VITS2, potenziamento della capacità di elaborazione del modello.
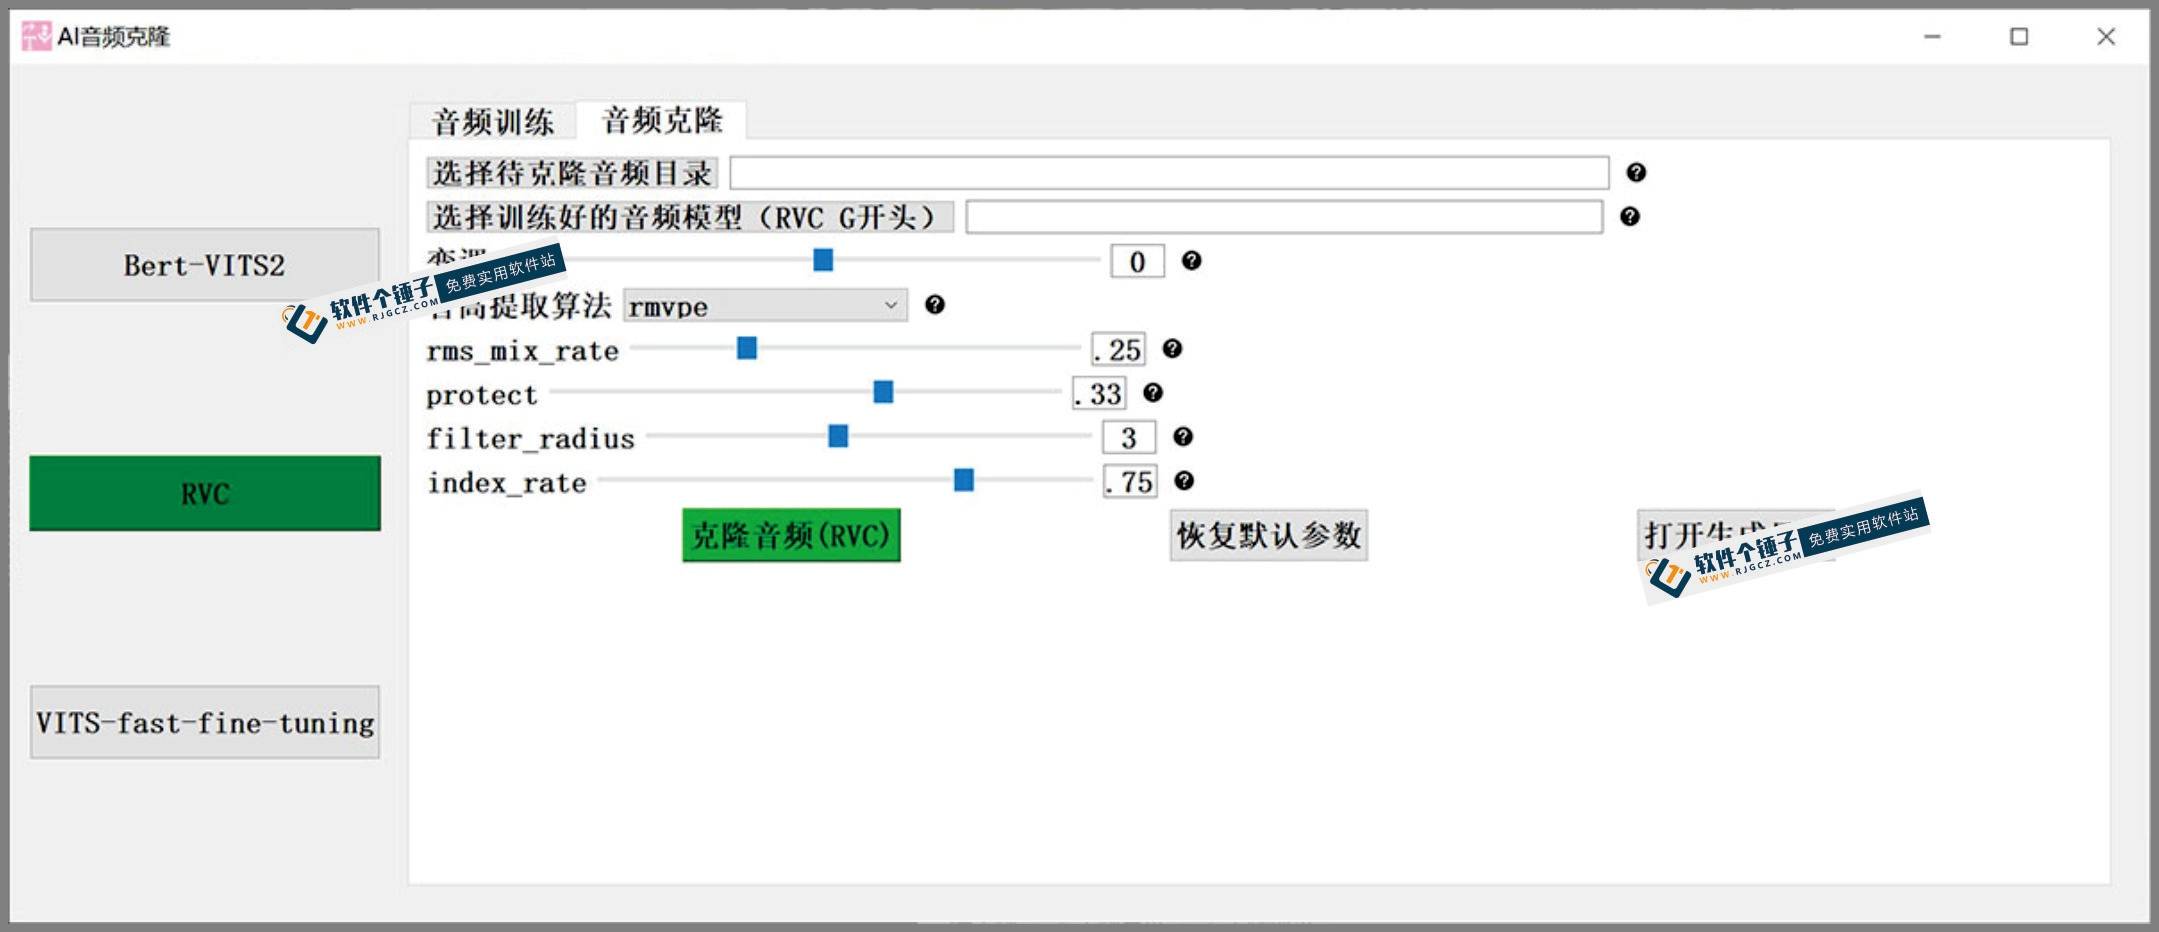
- Versione V2.0 (data di aggiornamento: 2023-11-11):Aggiunto il potente progetto di clonazione audio RVC, che supporta attività di clonazione vocale e canora più complesse.
Il software di clonazione audio AI, grazie alle sue potenti funzionalità e all'operatività user-friendly, offre agli utenti una soluzione di sintesi vocale efficiente e pratica. Che si tratti di intrattenimento personale o produzione professionale, è una scelta strumentale preziosa.
Il metodo per creare e sintetizzare voci personalizzate con il software di clonazione audio AI può essere suddiviso in due grandi passaggi:
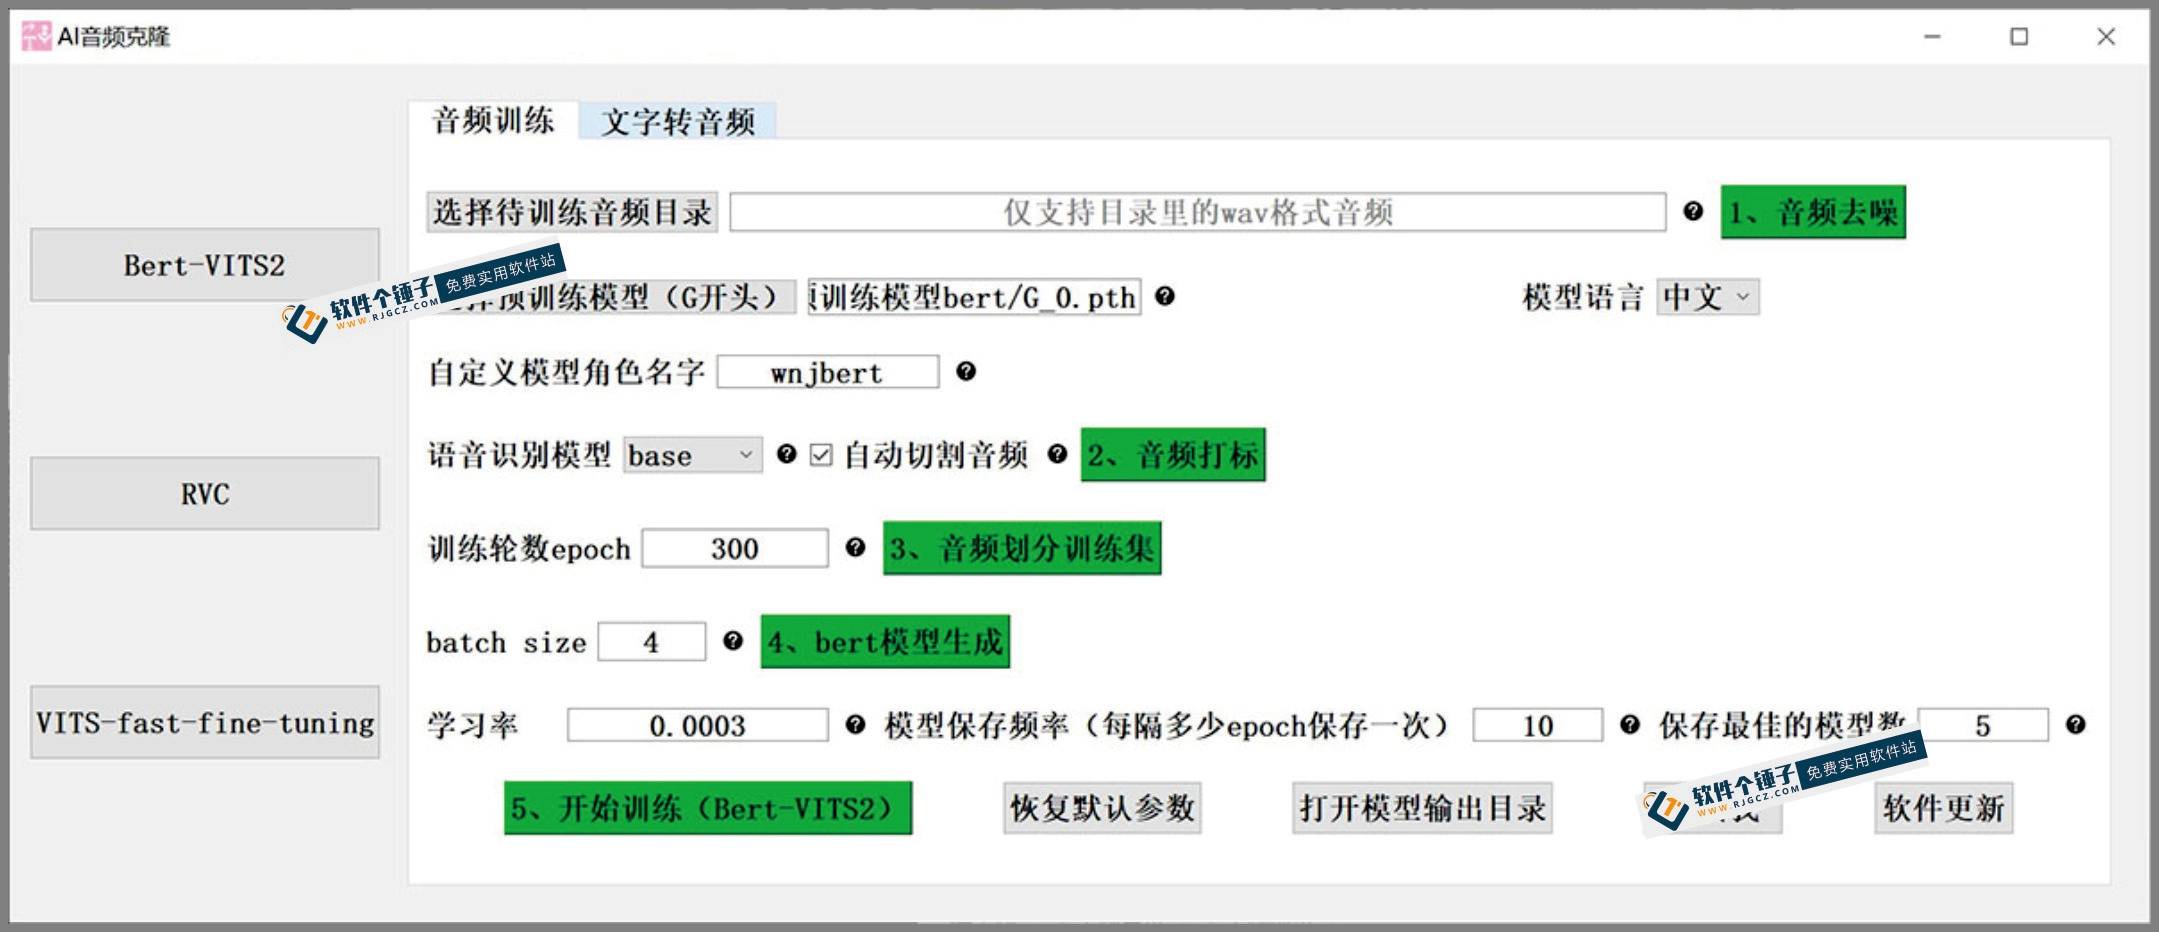
1. Creazione del modello vocale
Lo scopo di questa fase è creare un modello vocale personalizzato in base alle tue esigenze.
1. Seleziona la cartella audio da addestrare: il software elaborerà automaticamente la cartella contenente file audio in formato WAV, eseguendo attività di pre-elaborazione come taglio, rimozione della musica di sottofondo e dei rumori.



2. Utilizza il modello pre-addestrato: di solito non è necessaria alcuna operazione manuale, il software carica per impostazione predefinita il modello fornito dall'autore. Se è necessario selezionarlo manualmente, è possibile sceglierlo direttamente nella cartella di archiviazione dei modelli.
3. Assegna un nome al ruolo del modello personalizzato: dai un nome al tuo modello, utilizzando un nome in inglese.
4. Seleziona il modello di riconoscimento vocale: generalmente è sufficiente utilizzare il modello base predefinito.
5. Imposta il numero di epoche di addestramento (epoch): si consiglia di impostarlo a 200; sebbene di solito qualche decina di epoche sia sufficiente, 300 epoche permettono di ottenere risultati migliori.
6. Imposta la dimensione del batch (batch size): questa dovrebbe essere regolata in base alla capacità della tua memoria video; generalmente è consigliabile impostarla su un valore più piccolo.
7. Imposta il tasso di apprendimento: è sufficiente utilizzare l'impostazione predefinita. Dopo aver completato le impostazioni precedenti, fai clic su Avvia addestramento per iniziare a creare il modello vocale.

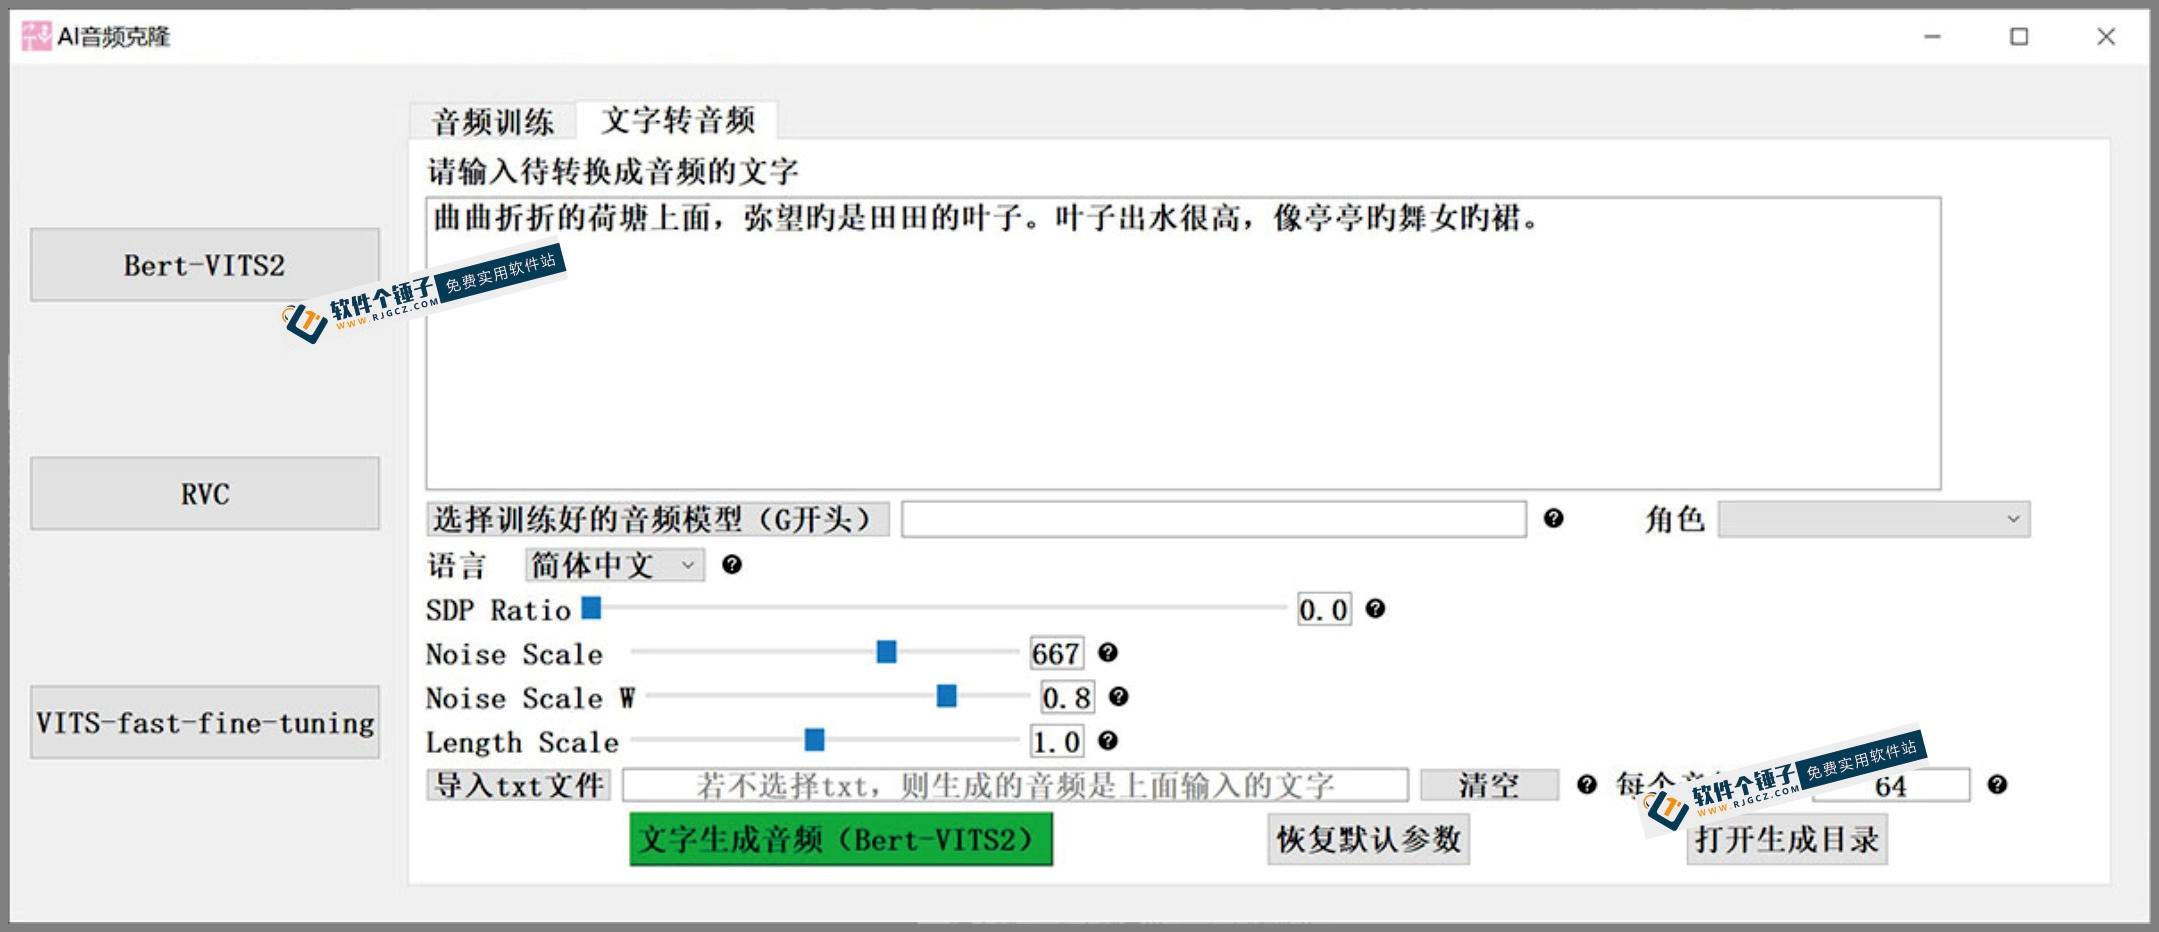
2. Sintesi da testo a voce
Dopo aver creato il modello vocale, puoi iniziare a convertire il testo in voce.
1. Inserisci o importa il testo: inserisci direttamente il testo nel software o aggiungi il testo da convertire importando un file TXT. (Se sono presenti entrambi, verrà data priorità al testo nel file TXT)
2. Seleziona il modello audio addestrato: seleziona il modello audio che inizia con G creato nei passaggi precedenti.


3. Mantieni le impostazioni predefinite: per le altre impostazioni come il rapporto di miscelazione SDP, il livello di rumore, la velocità del parlato, è sufficiente mantenere i valori predefiniti.
4. Genera la voce: dopo aver completato le impostazioni, fai clic su Genera voce; il software genererà la voce in base al testo inserito e al modello selezionato.
Attraverso questi due passaggi, puoi facilmente utilizzare un software di clonazione audio AI per creare modelli vocali personalizzati e convertire qualsiasi testo in una voce specifica.
Corsi correlati

Toolbox super locale! Con registrazione dello schermo integrata, taglio e unione di audio/video, compressione ed estrazione video, gratis per sempre - Kedou Video Converter

Strumento gratis perfetto al 100%%! Software PDF multifunzione tutto in uno: converti, comprimi, modifica PDF ecc., minimal, senza pubblicità, fantastico - JOPDF

Strumento di desktop remoto open source, superiore alle versioni a pagamento! Gratuito e illimitato per uso personale e commerciale, multipiattaforma – HopToDesk

Ultimo strumento di download di libri di testo per scuola elementare e media: download delle risorse di un intero anno, slide, video e audio con un clic

Tutto il giorno davanti allo schermo, senza uno strumento di protezione per gli occhi? Ecco l'app gratuita anti-luce blu per PC, con un animale che ti ricorda di riposare. Huyanbao

PyIsland: centro di controllo di sistema moderno con Dynamic Island sul desktop Windows

Produzione di drammi anime 3D simulati: pratica completa con Seedance 2.0, ti guida da 0 a 1 nella creazione di drammi anime di alta qualità

Compatibile Win/Mac! Ultima versione a vita: ripristina vecchie foto, migliora la nitidezza e ingrandisci senza perdita - Aiarty Image Enhancer

Tool di download Bilibili open source su Github: download in batch di video Bilibili con supporto 8K e Dolby Vision, semplice, Bilidown

Collezione di strumenti desktop Windows: 50+ widget pratici ed essenziali, con screenshot, registrazione, traduzione, meteo ecc. – toolbox Duomi

