


AI 음성 복제 소프트웨어 FastVits v22 TXT 텍스트를 복제 음성으로 변환 지원 오프라인 버전
-

선착순 게임 노가다 돈벌기 계획, 일 1k+, 일반인 한가한 시간에 가능! (공개)
회원 참고 학습 자료 멤버십 가입











AI 오디오 복제 소프트웨어는 PC용으로 개발된 강력한 음성 복제 도구로, 로컬에서 완전히 독립적으로 실행할 수 있습니다. 이 도구의 설계 목적은 사용자가 특정 음성 톤을 쉽게 복제하고 텍스트 내용을 음성으로 변환하여 출력할 수 있도록 돕는 것이며, 그 시뮬레이션 효과는 원음과 매우 유사합니다. 놀라운 점은 이 소프트웨어가 설치가 필요 없고 압축을 풀면 바로 사용할 수 있어 조작이 간편하고 빠릅니다.

완전 오프라인 실행, 언제든 사용 가능
AI 오디오 복제 소프트웨어는 네트워크 연결에 의존하지 않고 완전히 로컬 컴퓨터에서 실행됩니다. 이는 언제든지 모든 텍스트를 음성으로 변환할 수 있음을 의미하며, 오디오북 제작이나 기타 음성 응용에 매우 적합합니다. 첨단 로컬 AI 엔진을 채택하여 소프트웨어 패키지 용량이 10GB에 달하며, 고품질 출력과 빠른 처리 속도를 보장합니다.
주요 기능
- 음성 복제:제공하신 음성 샘플을 정확한 음성 모델로 훈련시킵니다.
- 텍스트에서 음성으로:소프트웨어는 입력 상자 또는 TXT 문서의 텍스트를 동일한 음성 톤의 음성 출력으로 변환할 수 있습니다. 입력 텍스트와 TXT 문서가 동시에 존재하는 경우, 기본적으로 TXT 문서의 내용을 우선 처리합니다.
소프트웨어 업데이트 내역
- V2.2 버전 (업데이트 날짜: 2024-02-08):Bert-VITS2로 업그레이드하여 모델 처리 능력을 강화했습니다.
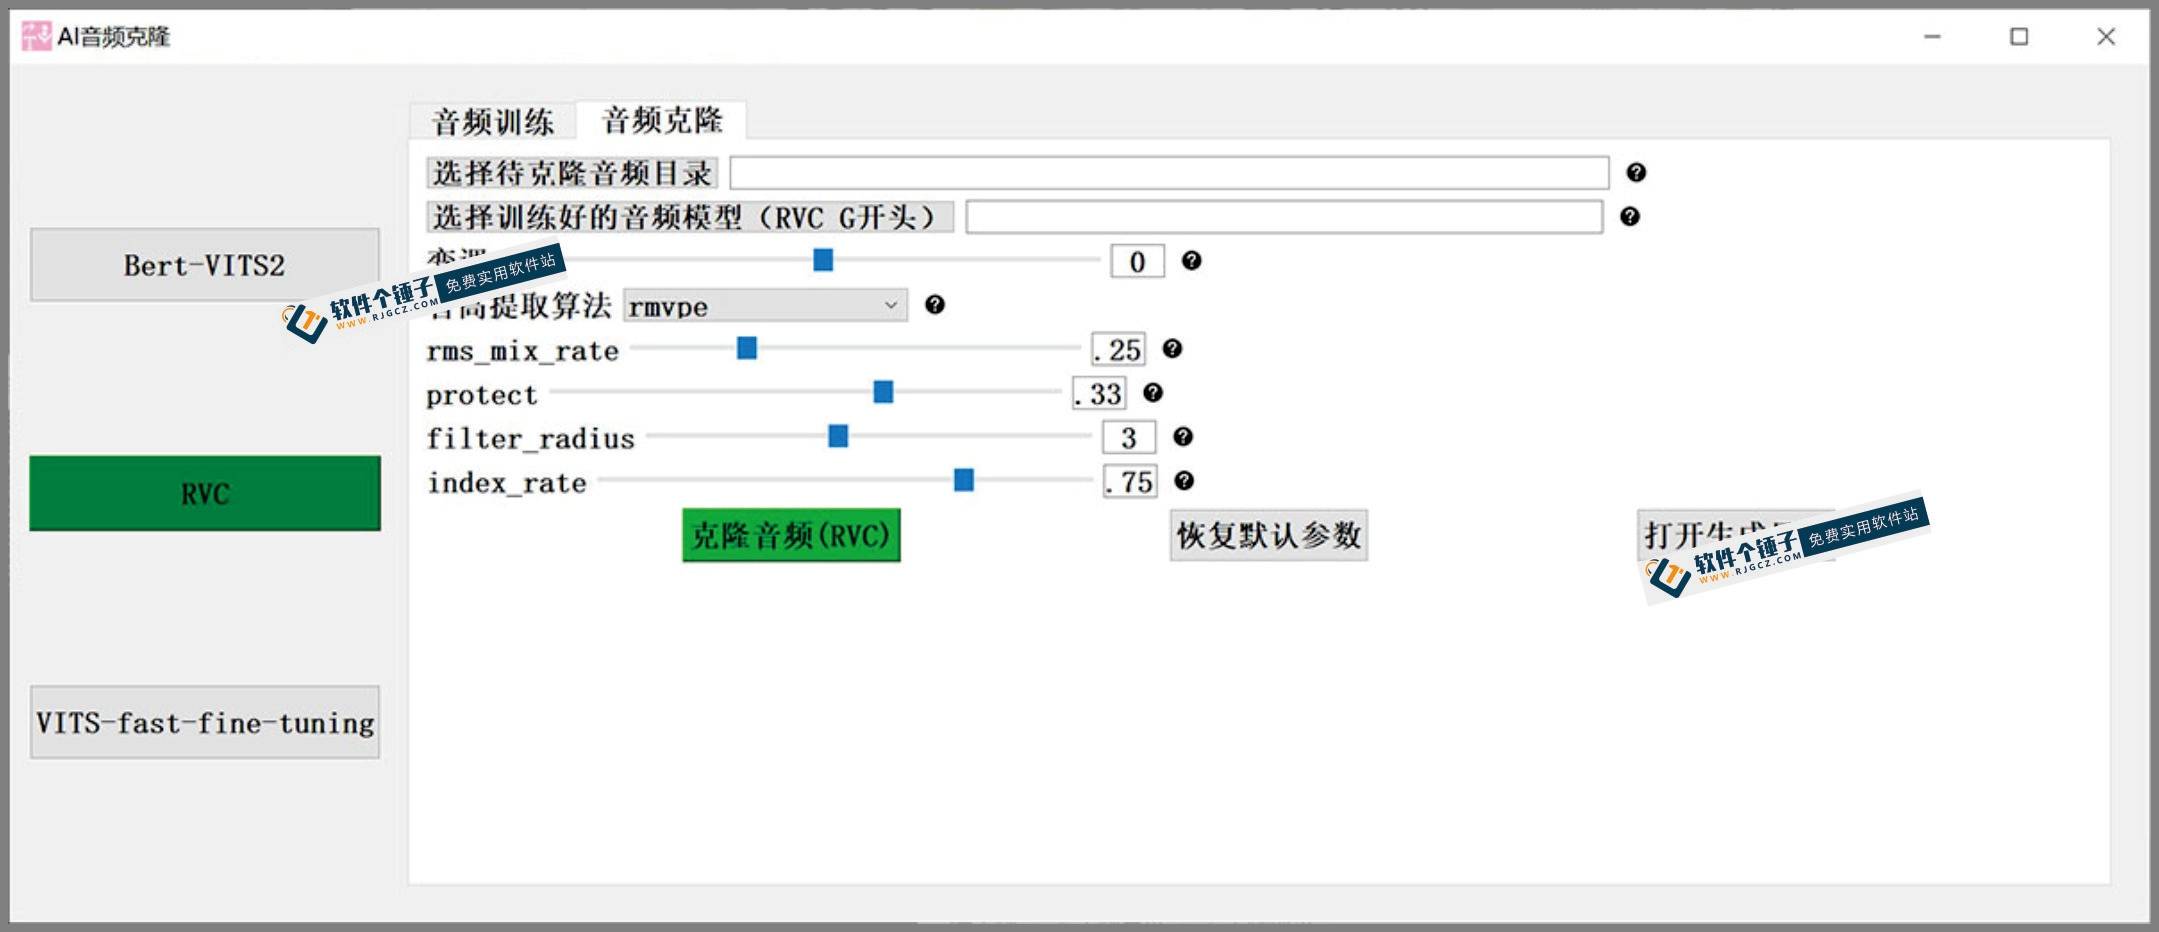
- V2.0 버전 (업데이트 날짜: 2023-11-11):강력한 오디오 복제 프로젝트 RVC를 새로 추가하여 더 복잡한 사람 목소리 및 노래 복제 작업을 지원합니다.
AI 오디오 복제 소프트웨어는 강력한 기능과 사용자 친화적인 조작을 통해广大 사용자에게 효율적이고 편리한 음성 합성 솔루션을 제공합니다. 개인 오락이든 전문 제작이든 놓칠 수 없는 도구 선택입니다.
AI 오디오 복제 소프트웨어를 사용하여 맞춤형 음성을 생성하고 합성하는 방법은 크게 두 단계로 나눌 수 있습니다:
一、음성 템플릿 제작
이 단계의 목적은 귀하의 요구에 맞춤화된 음성 템플릿을 만드는 것입니다.
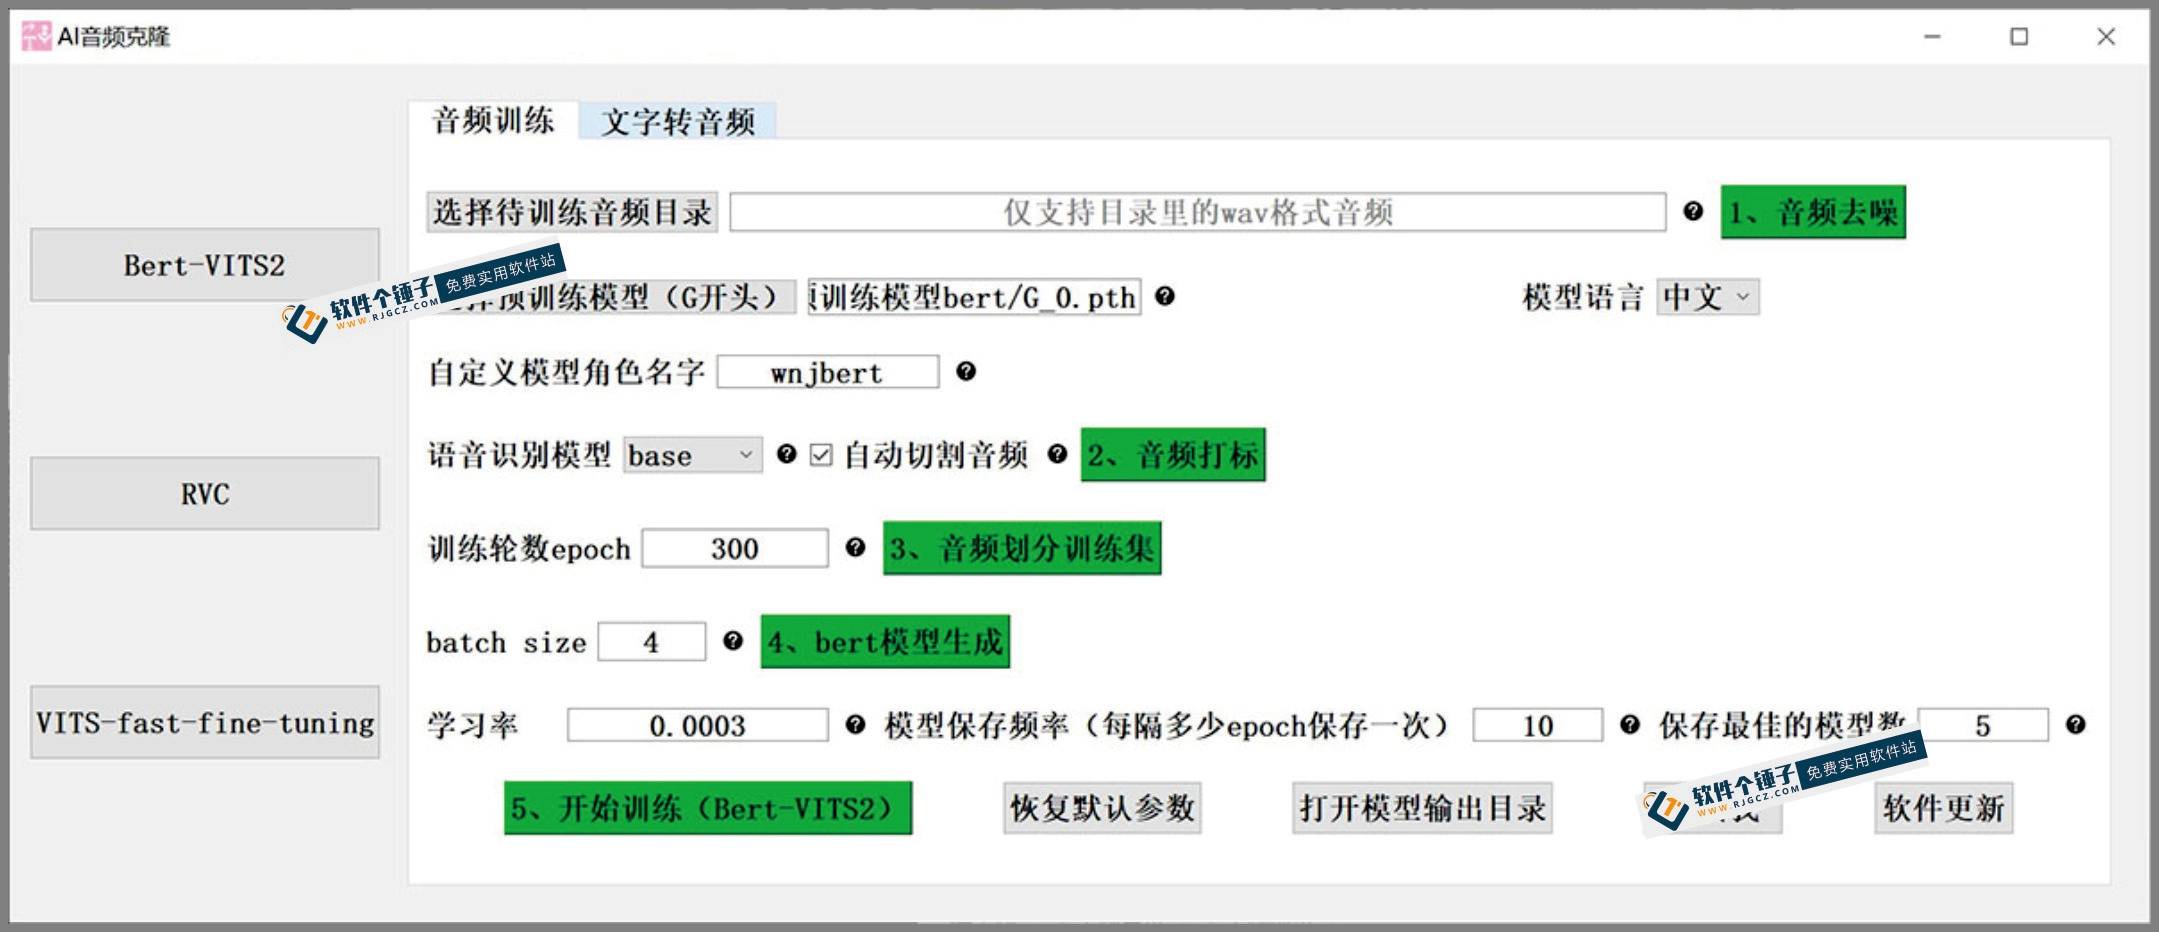
1. 훈련할 오디오 폴더 선택: 소프트웨어가 WAV 형식 오디오가 포함된 폴더를 자동으로 처리하여 분할, 배경 음악 및 노이즈 제거 등의 전처리 작업을 수행합니다.



2. 사전 훈련 모델 사용: 일반적으로 수동 조작이 필요 없으며, 소프트웨어가 작성자가 제공한 모델을 기본으로 로드합니다. 수동으로 선택해야 하는 경우 모델이 저장된 폴더에서 직접 선택할 수 있습니다.
3. 사용자 정의 모델의 역할 이름: 모델에 영어 이름을 사용하여 이름을 지정합니다.
4. 음성 인식 모델 선택: 일반적으로 기본 base 모델을 사용하면 됩니다.
5. 훈련 에포크(epoch) 설정: 200으로 설정하는 것을 권장하며, 보통 수십 에포크면 충분하지만 300 에포크가 더 우수한 효과를 낼 수 있습니다.
6. 배치 크기(batch size) 설정: 이는 귀하의 VRAM 용량에 따라 조정해야 하며, 일반적으로 작게 설정합니다.
7. 학습률 설정: 기본 설정을 사용하면 됩니다. 위 설정을 완료한 후 훈련 시작을 클릭하여 음성 템플릿 제작을 시작합니다.

二、텍스트에서 음성 합성
음성 템플릿을 제작한 후 텍스트를 음성으로 변환할 수 있습니다.
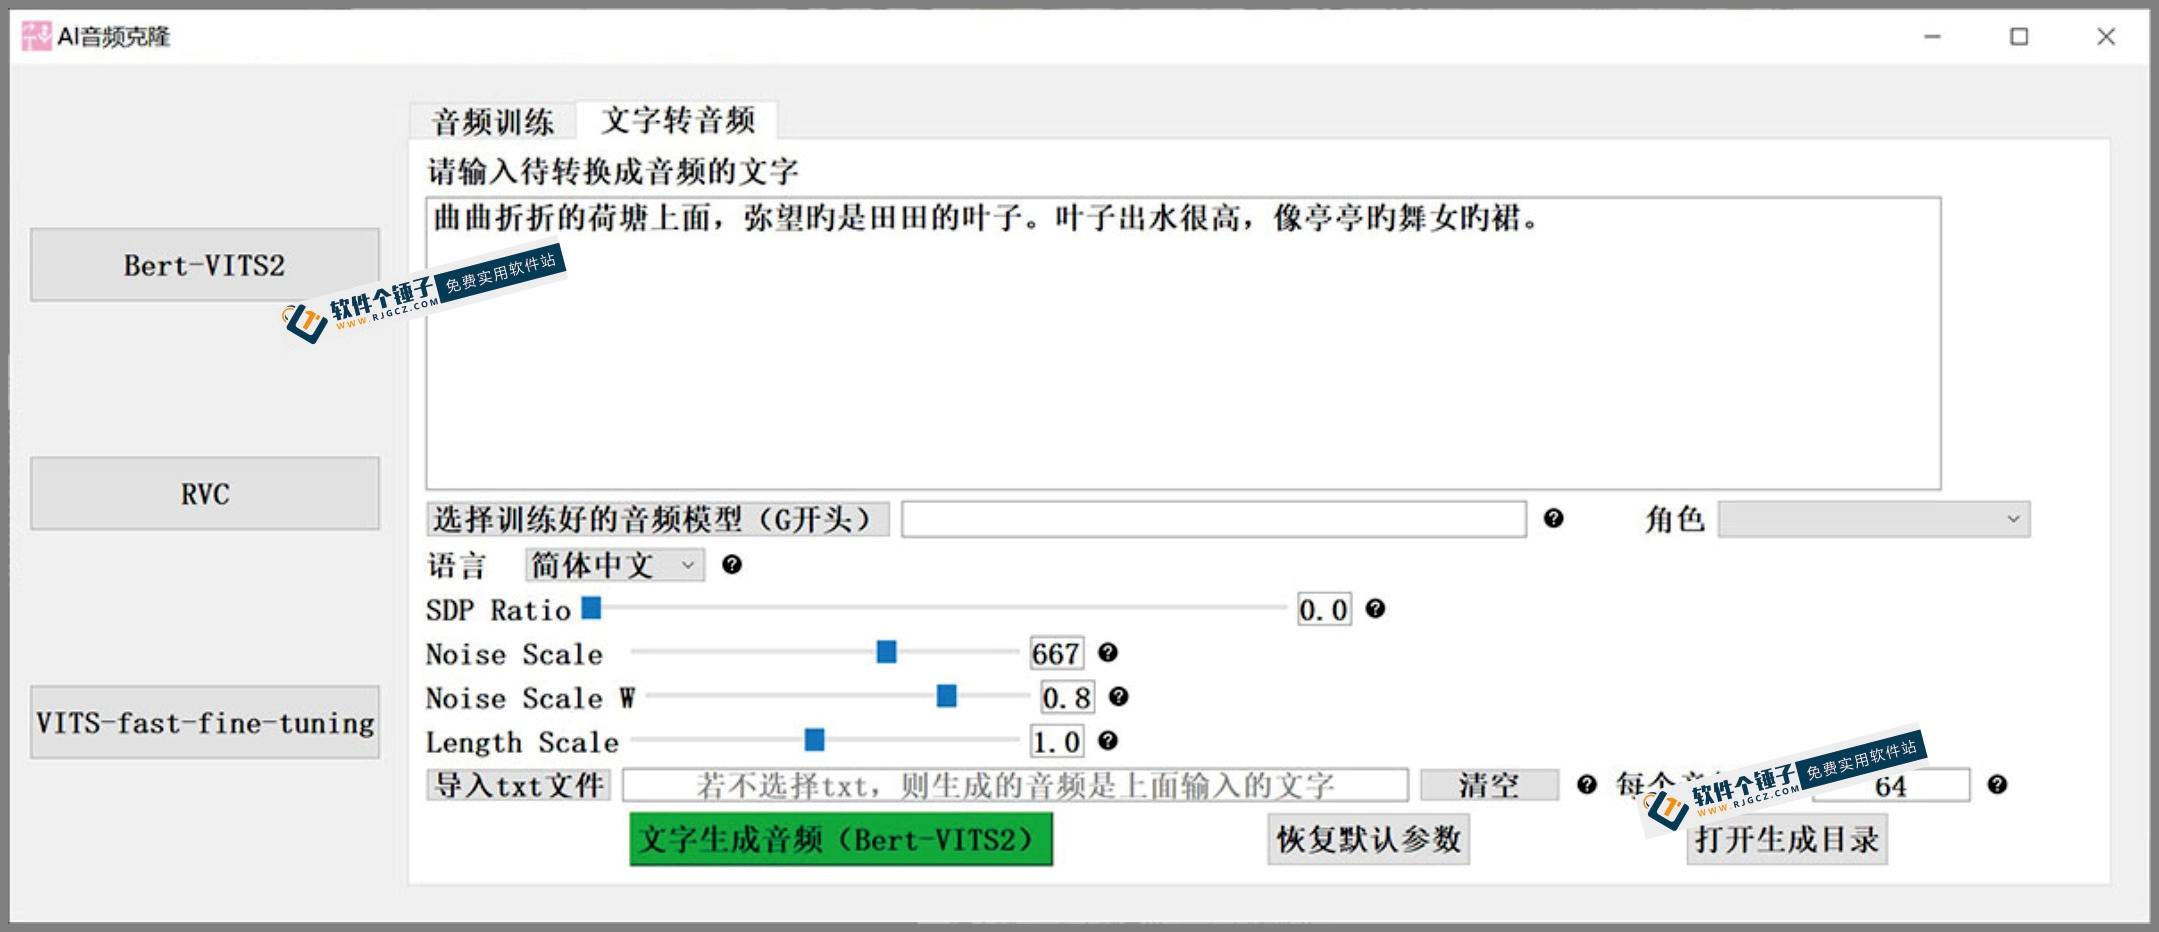
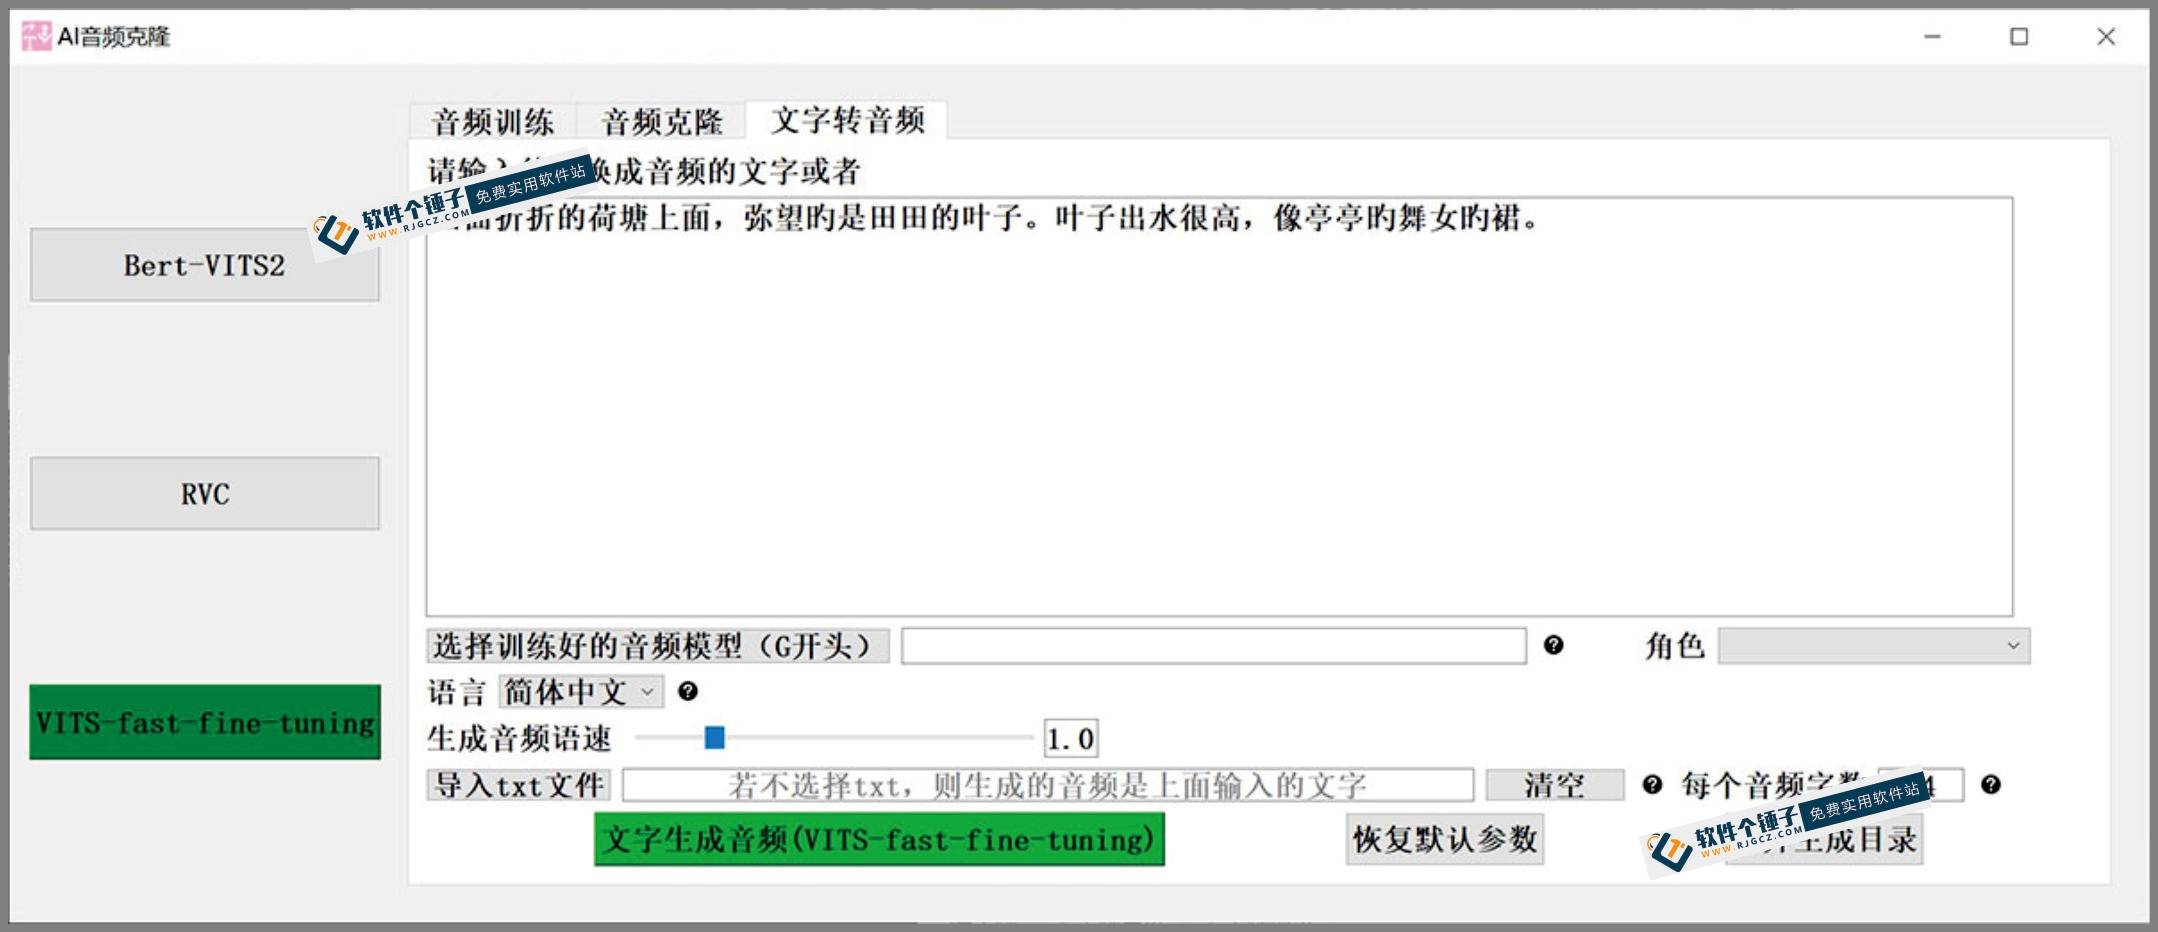
1. 텍스트 입력 또는 가져오기: 소프트웨어에 직접 텍스트를 입력하거나 TXT 파일을 가져와 변환할 텍스트를 추가합니다. (동시에 존재하는 경우 TXT 파일의 텍스트가 우선 처리됩니다)
2. 훈련된 오디오 모델 선택: 이전 단계에서 제작한 G로 시작하는 오디오 모델을 선택합니다.


3. 기본 설정 유지: SDP 혼합 비율, 노이즈 레벨, 말하기 속도 등 기타 설정은 기본값으로 유지하면 됩니다.
4. 음성 생성: 설정을 완료한 후 음성 생성을 클릭하면 소프트웨어가 입력된 텍스트와 선택한 모델에 따라 음성을 생성합니다.
이 두 단계를 통해 AI 오디오 클론 소프트웨어를 사용하여 개인화된 음성 템플릿을 쉽게 만들고, 모든 텍스트를 특정 음성으로 변환할 수 있습니다.
관련 강의





후옌바오: 반려동물 휴식 알림이 있는 무료 블루라이트 눈보호 앱






