


-
Cursos de negócio solo
-
 Outros
-
Tutoriais no exterior
-
Fotografia & Edição
-
Comunidade & Domínio privado
-
Escrita & Copywriting para mídias
-
Projetos de renda extra
-
Comércio eletrônico
-
Vídeo curto & Transmissão ao vivo
-
Inteligência Artificial (IA)
-
Software & Ferramentas
-
Sistemas operacionais
-
Plugins & Scripts
-
Software MacOS
-
Software Android
-
Software Windows
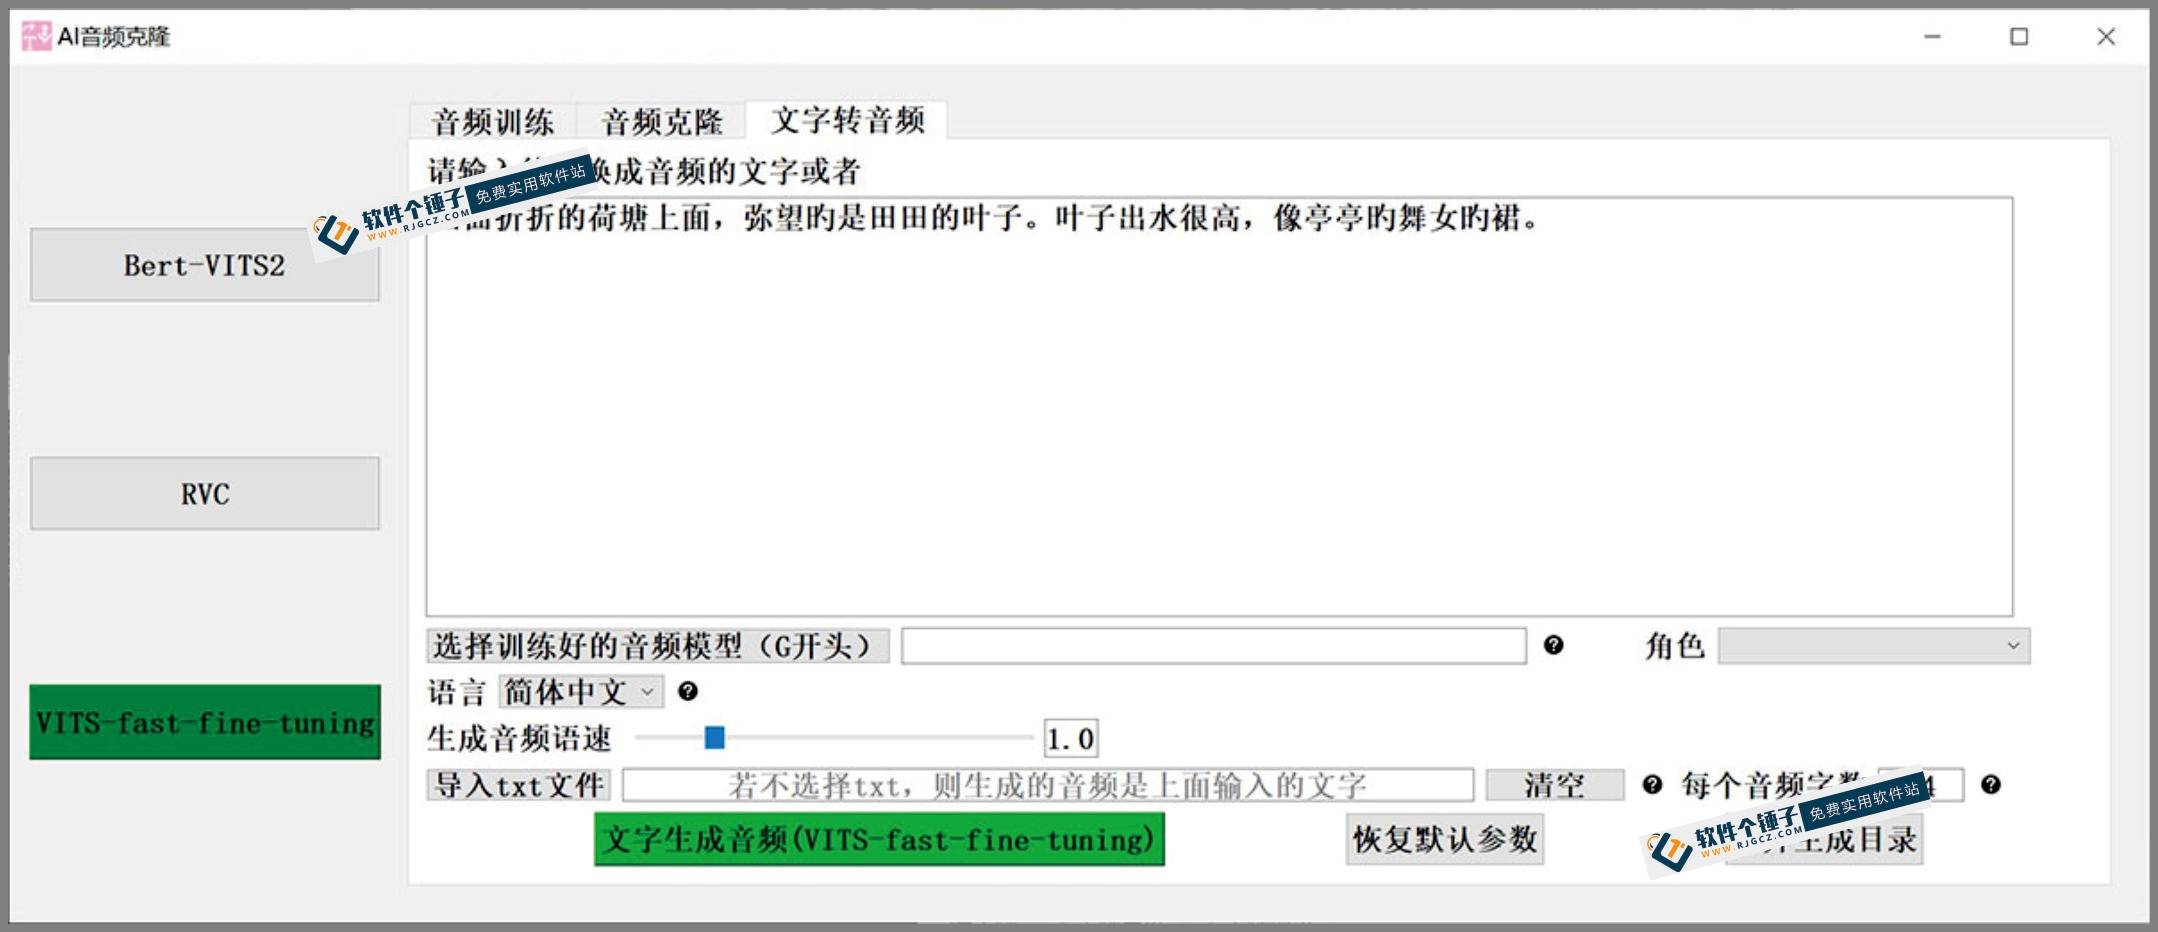
Software de clonagem de voz com IA FastVits v22 com suporte para conversão de texto TXT em voz clonada Versão offline
-
Plano de Renda com Farm de Ouro em Jogos: ganhe mais de mil por dia, um projeto estável de 3 anos que qualquer pessoa faz no tempo livre
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Curso SOP sistemático de mangá-drama de IA: seleção de webnovels, roteiro, texto para imagem, imagem para vídeo, dublagem e edição – tutorial padronizado de ponta a ponta (atual. 26/08)
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Farming automatizado de jogos populares: 500+/dia, sem experiência, simples – o extra estável a longo prazo mais fiável [Revelado]
Material de estudo de referência — incluído com a assinatura Obter assinatura -
ShuShu desta vez se safou! Não entre em pânico com problemas de formato do Windows: a ferramenta de código aberto ShuShu Format Converter, uma joia popular no GitHub
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Campo de acompanhamento de vendas no Douyin: sem aparecer, iniciantes copiam modelos e produzem vídeos
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Plano de renda com farming de jogos no lançamento: mais de 1.000 por dia, viável para pessoas comuns no tempo livre! [Revelado]
Material de estudo de referência — incluído com a assinatura Obter assinatura






-
ShuShu desta vez se safou! Não entre em pânico com problemas de formato do Windows: a ferramenta de código aberto ShuShu Format Converter, uma joia popular no GitHub
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Lu Master v6.1024.4105.1121, versão enxuta em arquivo único【Software Ge Chui Zi·R1880】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Software de criação de animação de cartoon 2D Moho Pro v14.3 [Software Ge Chuzi · R2355]
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Software de edição e processamento de vídeo para computador Aiseesoft Filmai v1.0.18 【Software Ge Chuzi·R2470】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Microsoft To Do v2.147 Versão oficial gratuita【Software Ge Chuizi·R2618】
Material de estudo de referência — incluído com a assinatura Obter assinatura -
Plugin de osciloscópio de correção de cor de vídeo para PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Software Ge Chui Zi·R2748】
Material de estudo de referência — incluído com a assinatura Obter assinatura





O software de clonagem de áudio com IA é uma poderosa ferramenta de clonagem de voz desenvolvida especificamente para PC, que pode ser executada de forma totalmente independente no computador local. Este software foi projetado para ajudar os usuários a clonar facilmente timbres de voz específicos e converter conteúdo de texto em saída de voz, com efeito de simulação extremamente próximo ao original. Cabe destacar que o software não requer instalação, bastando descompactá-lo para usar, com operação simples e rápida.

Funcionamento totalmente offline, disponível a qualquer momento
O software de clonagem de áudio com IA não depende de conexão com a internet, funcionando completamente no computador local. Isso significa que você pode converter qualquer texto em voz a qualquer momento, sendo ideal para produzir audiolivros ou outros aplicativos de voz. Graças ao avançado mecanismo de IA local, o pacote do software chega a 10GB, garantindo saída de alta qualidade e velocidade de processamento rápida.
Principais funções
- Clonagem de voz:Treina a amostra de voz fornecida por você em um modelo de voz preciso.
- Texto para voz:O software é capaz de converter o texto da caixa de entrada ou de documentos TXT em saída de voz com o mesmo timbre. Se houver simultaneamente texto de entrada e documento TXT, o conteúdo do documento TXT será processado prioritariamente por padrão.
Histórico de atualizações do software
- Versão V2.2 (data de atualização: 2024-02-08):Atualizado para Bert-VITS2, aprimorando a capacidade de processamento do modelo.
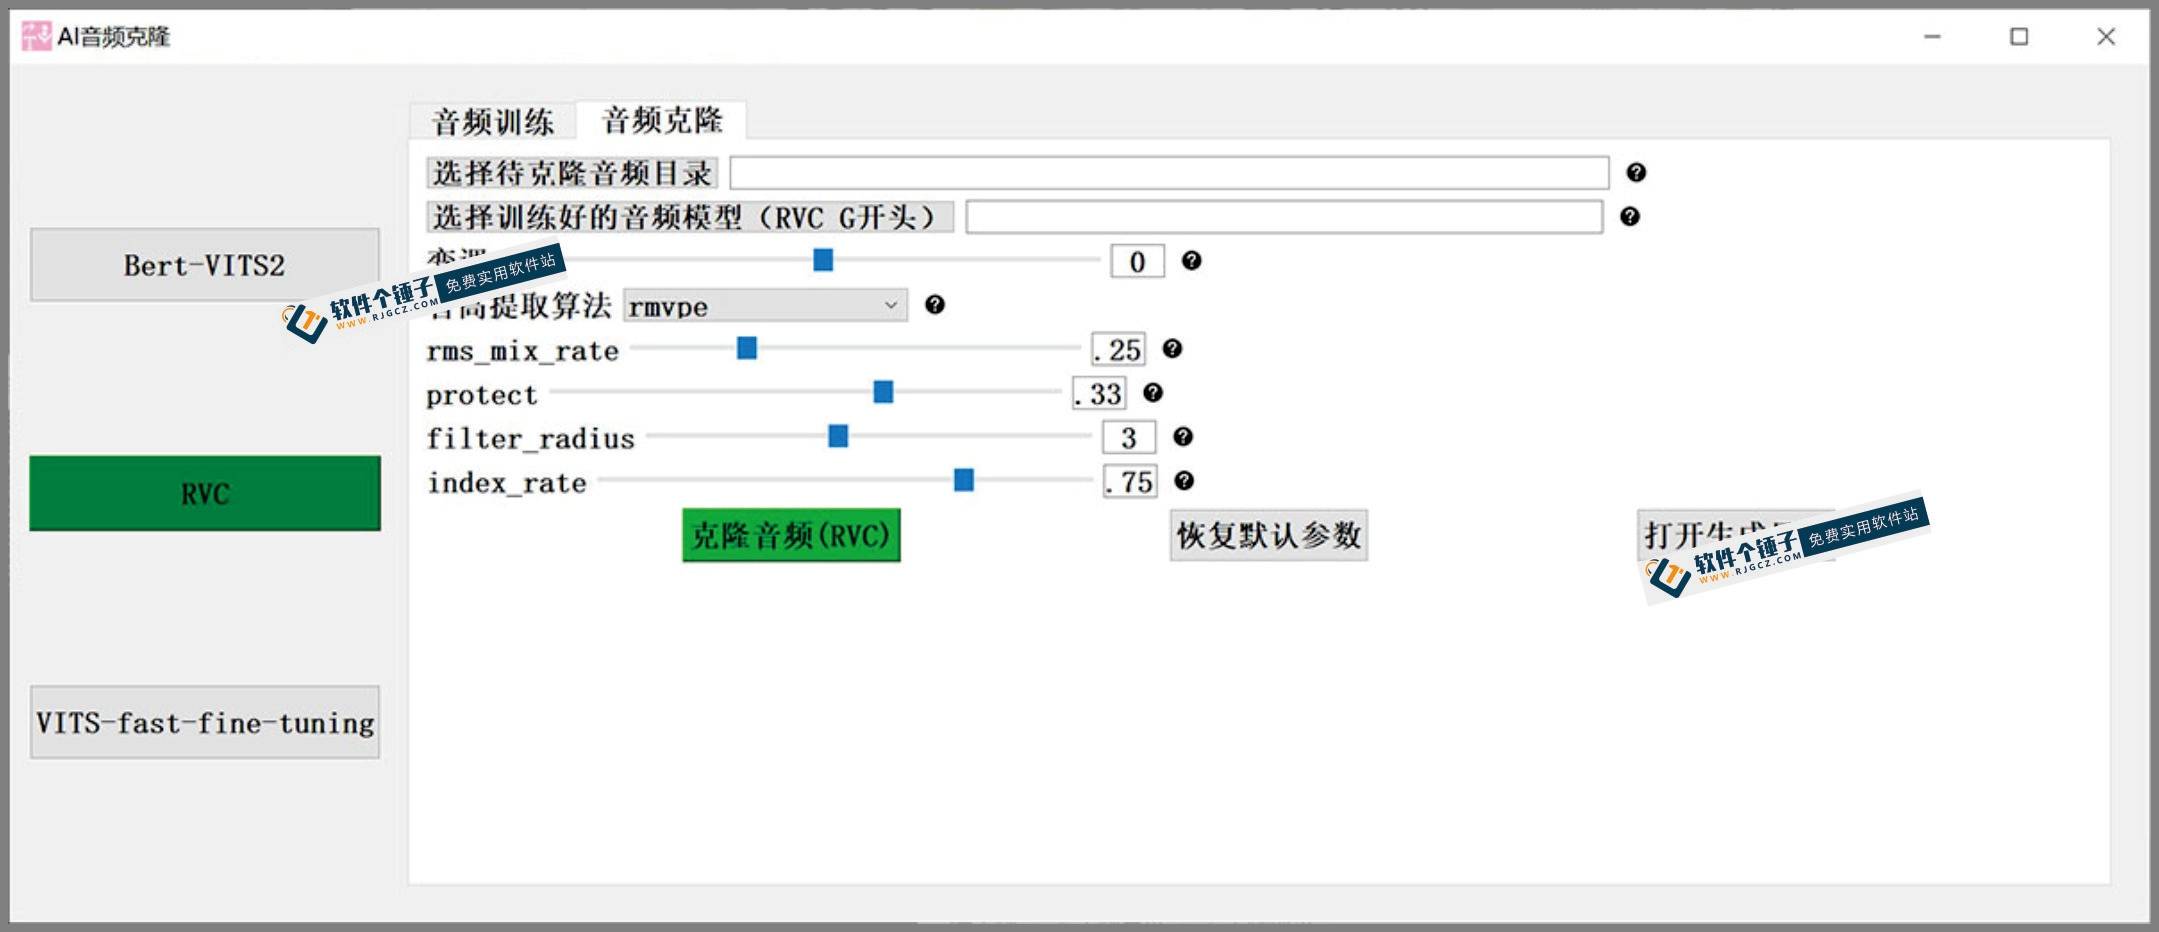
- Versão V2.0 (data de atualização: 2023-11-11):Adicionado o poderoso projeto de clonagem de áudio RVC, com suporte para tarefas mais complexas de clonagem de voz humana e canto.
O software de clonagem de áudio com IA, por meio de suas poderosas funções e operação amigável, oferece aos usuários uma solução eficiente e prática de síntese de voz. Seja para entretenimento pessoal ou produção profissional, é uma ferramenta indispensável.
O método para criar e sintetizar vozes personalizadas usando o software de clonagem de áudio com IA pode ser dividido em duas etapas principais:
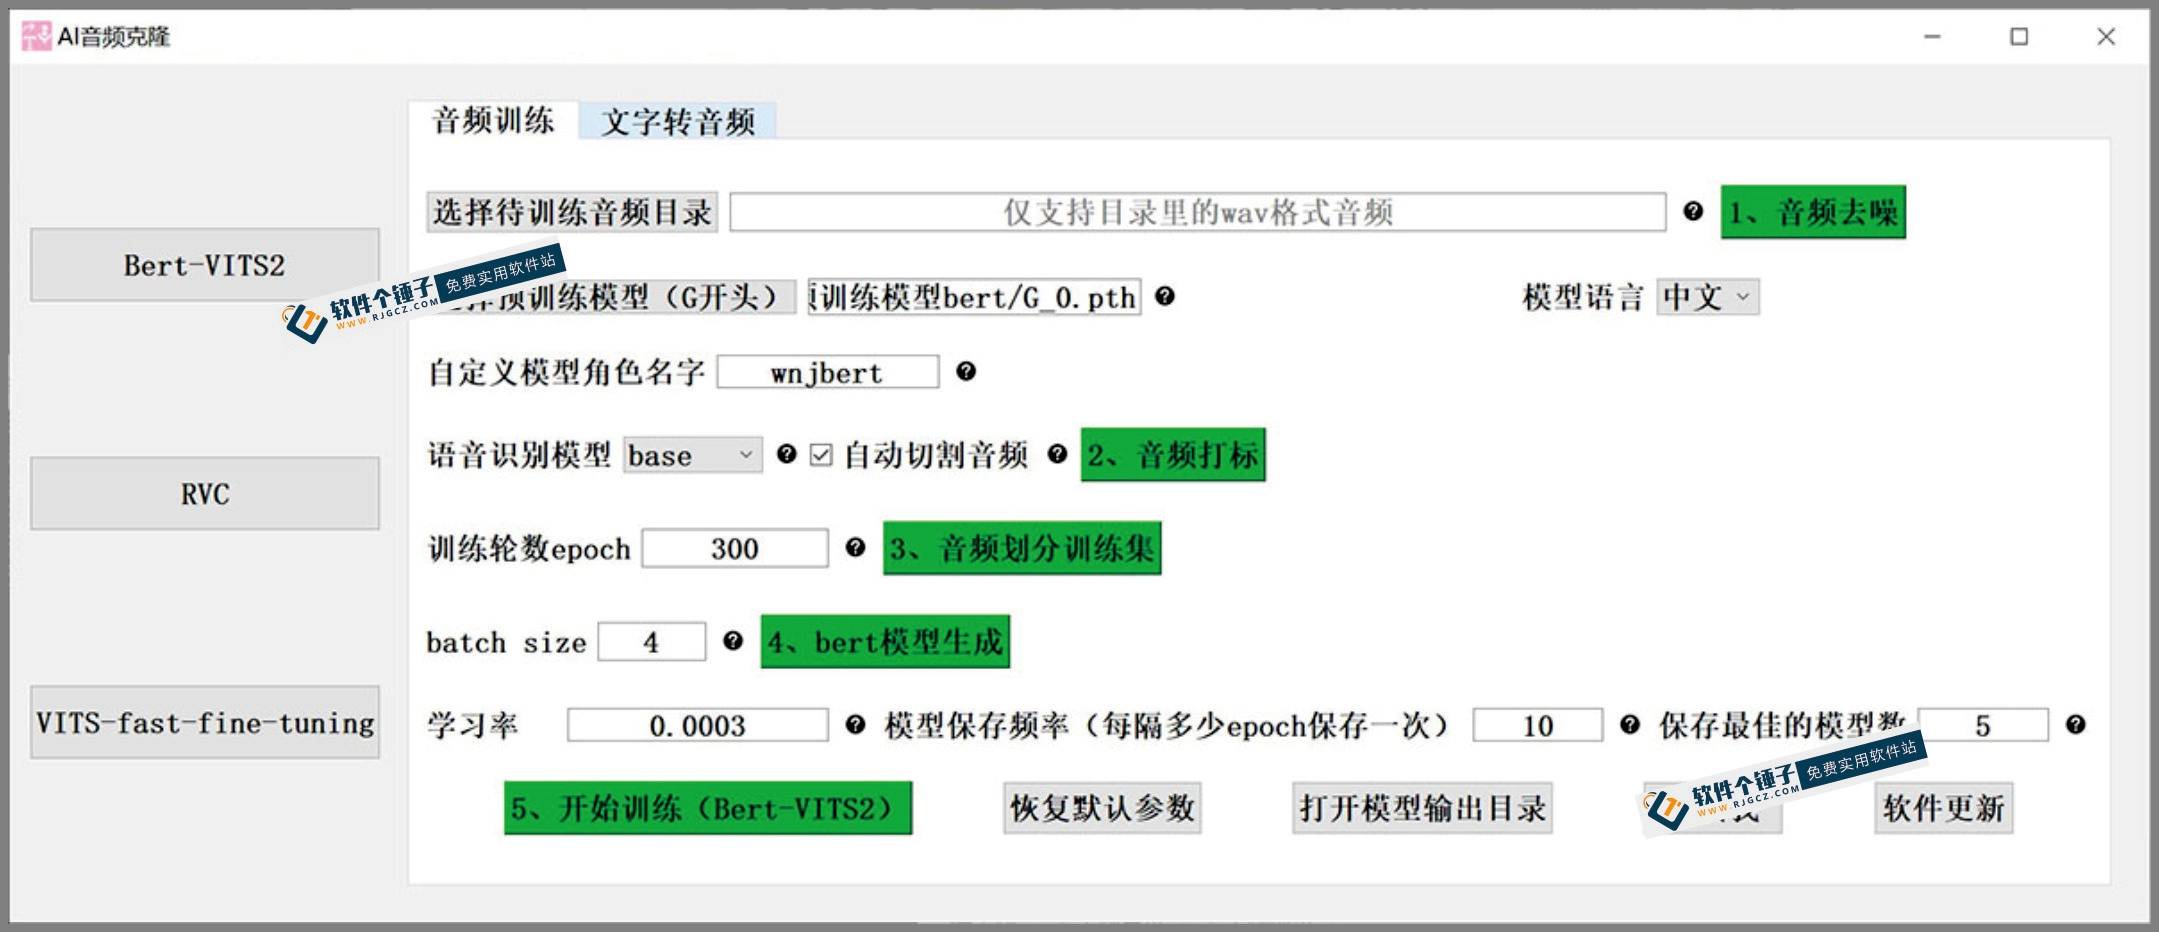
1. Criar um modelo de voz
O objetivo desta etapa é criar um modelo de voz personalizado de acordo com suas necessidades.
1. Selecione a pasta de áudio a ser treinada: o software processará automaticamente a pasta contendo áudios no formato WAV, executando tarefas de pré-processamento como corte, remoção de música de fundo e ruídos.



2. Use o modelo pré-treinado: geralmente não é necessário operação manual, pois o software carrega por padrão o modelo fornecido pelo autor. Se precisar selecionar manualmente, basta escolher diretamente na pasta de armazenamento de modelos.
3. Nomeie o personagem do modelo personalizado: dê um nome ao seu modelo, usando um nome em inglês.
4. Selecione o modelo de reconhecimento de voz: geralmente, basta usar o modelo base padrão.
5. Defina o número de épocas de treinamento (epoch): recomenda-se definir como 200. Embora algumas dezenas de épocas geralmente sejam suficientes, 300 épocas podem alcançar melhores resultados.
6. Defina o tamanho do lote (batch size): isso deve ser ajustado de acordo com a capacidade da sua memória de vídeo, geralmente definido com um valor menor.
7. Defina a taxa de aprendizado: basta usar a configuração padrão. Após concluir as configurações acima, clique em iniciar treinamento para começar a criar o modelo de voz.

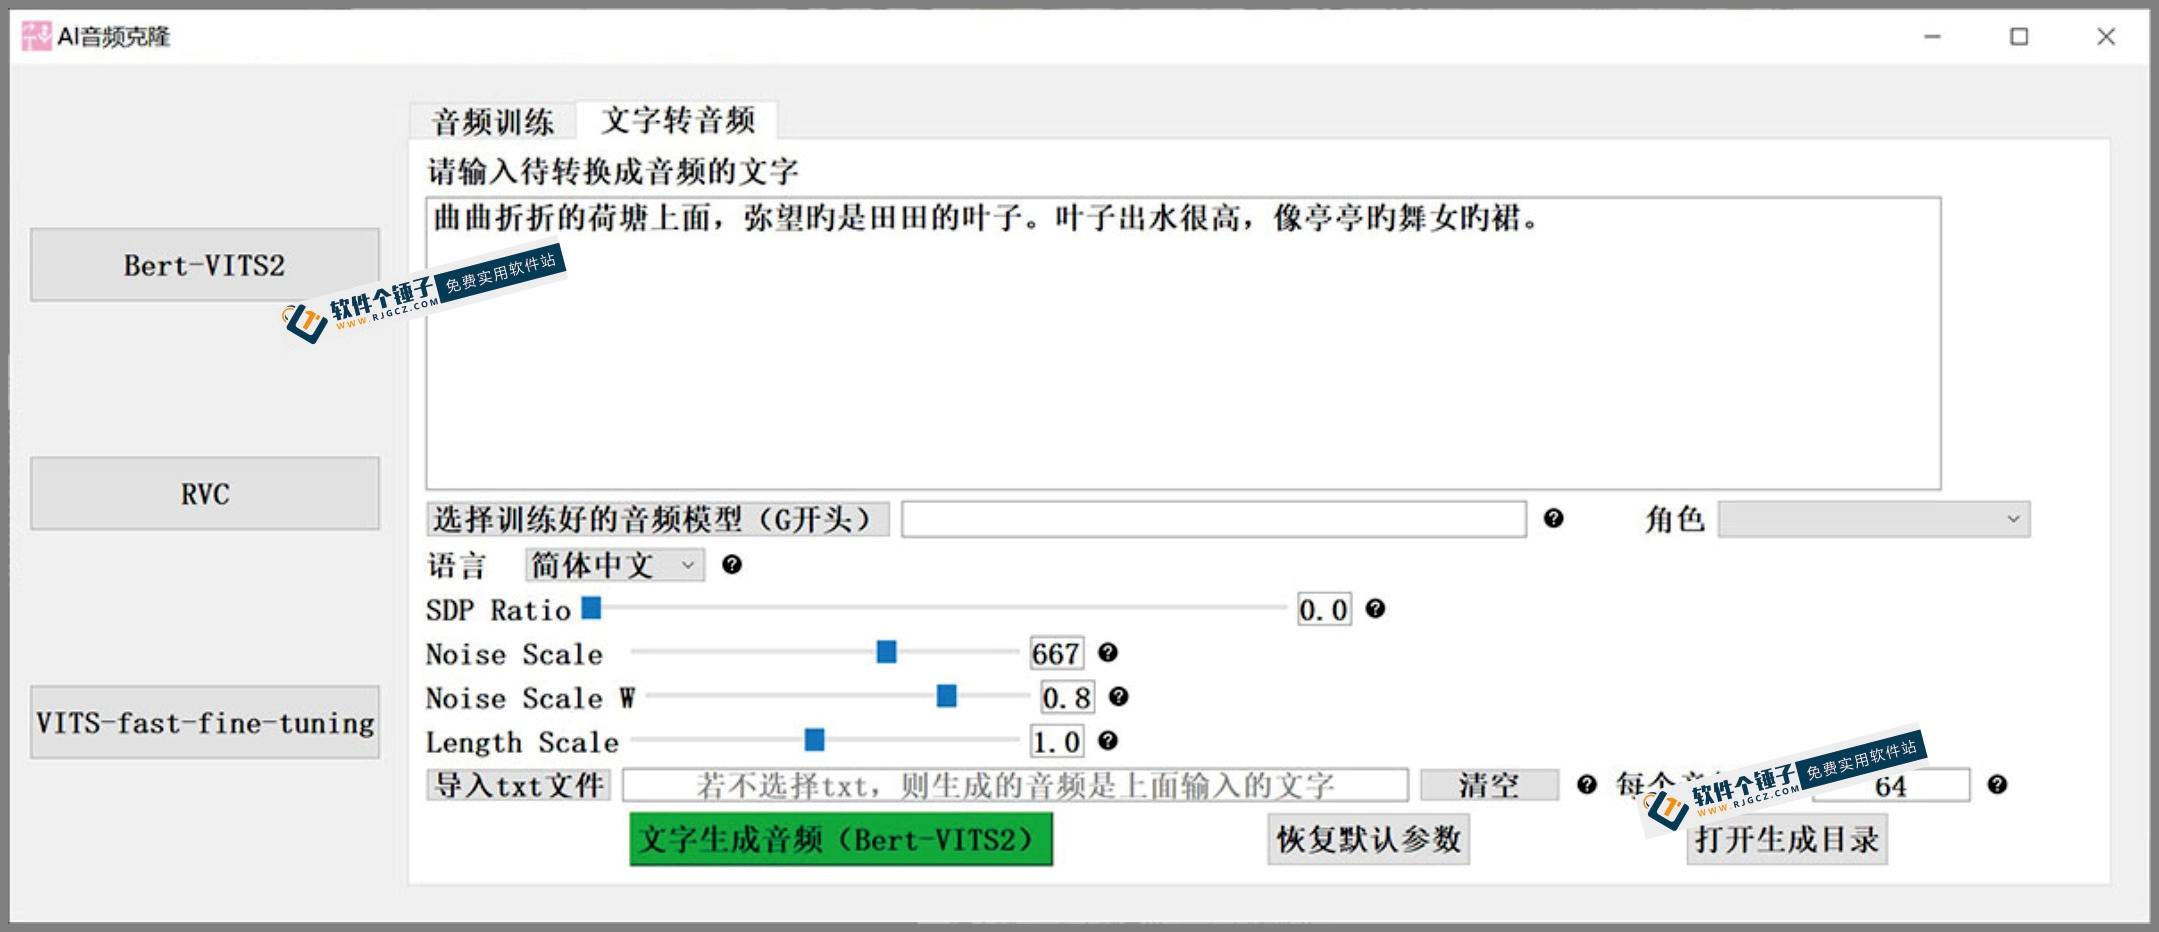
2. Síntese de texto para voz
Após criar o modelo de voz, você pode começar a converter texto em voz.
1. Insira ou importe o texto: insira o texto diretamente no software ou adicione o texto a ser convertido importando um arquivo TXT. (Se ambos existirem, o texto do arquivo TXT será processado prioritariamente)
2. Selecione o modelo de áudio treinado: escolha o modelo de áudio que começa com G, criado nas etapas anteriores.


3. Mantenha as configurações padrão: outras configurações, como proporção de mistura SDP, nível de ruído, velocidade da fala, etc., podem ser mantidas no padrão.
4. Gere a voz: após concluir as configurações, clique em gerar voz, e o software gerará a voz com base no texto inserido e no modelo selecionado.
Com estes dois passos, você pode facilmente usar um software de clonagem de áudio com IA para criar modelos de voz personalizados e converter qualquer texto em uma voz específica.
Cursos relacionados

Poderosa caixa de ferramentas local! Gravação de tela, corte/fusão de áudio e vídeo, compressão/extração de vídeo, etc., gratuito permanente – Kedou Video Converter Master

100% perfeito e grátis! Software PDF tudo-em-um: conversão, compressão, edição, etc., limpo sem anúncios – JOPDF

Ferramenta de desktop remoto de código aberto, superior às versões pagas! Gratuita e ilimitada para uso pessoal e comercial, multiplataforma – HopToDesk

Ferramenta mais recente para baixar livros didáticos do ensino fundamental e médio: recursos de um ano inteiro, slides, vídeos e áudios com um clique

O dia todo olhando para a tela, como ficar sem uma ferramenta de proteção ocular? Aplicativo gratuito de proteção contra luz azul para PC, com um pet que te lembra de descansar na hora certa, Huyanbao

PyIsland: centro de controle do sistema moderno com Dynamic Island na área de trabalho do Windows

Produção de manhuá 3D simulado: prática completa do Seedance 2.0, do zero à criação de manhuá de alta qualidade

Compatível com Win/Mac! Última versão vitalícia: restaure fotos antigas, melhore a nitidez e amplie sem perda - Aiarty Image Enhancer

Ferramenta de download de Bilibili de código aberto no Github: download em lote de vídeos de Bilibili com suporte a 8K e Dolby Vision, fácil de usar, Bilidown

Coleção de ferramentas de desktop Windows! 50+ widgets de desktop práticos e minimalistas, com captura de tela, gravação de tela, tradução, previsão do tempo etc., caixa de ferramentas Duomi

