


-
دورات ريادة الأعمال
-
 أخرى
-
دروس من الخارج
-
التصوير والتحرير
-
إدارة المجتمع والنطاق الخاص
-
كتابة المحتوى وكتابة الإعلانات
-
مشاريع الدخل الجانبي
-
التجارة الإلكترونية
-
الفيديو القصير والبث المباشر
-
الذكاء الاصطناعي (AI)
-
البرمجيات والأدوات
-
أنظمة التشغيل
-
الإضافات والسكربتات
-
برمجيات MacOS
-
برمجيات Android
-
برمجيات Windows
برنامج استنساخ الصوت بالذكاء الاصطناعي FastVits v22 يدعم تحويل نص TXT إلى صوت مستنسخ - إصدار غير متصل بالإنترنت
-
خطة كسب المال من زراعة الذهب في الألعاب: اكسب أكثر من ألف يومياً، مشروع مستقر منذ ثلاث سنوات، يمكن لأي شخص فعله في وقت الفراغ
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
العمل التلقائي الكامل داخل الألعاب الرائجة: ربح يومي 500+، دون خبرة وتشغيل بسيط، وهو حالياً أكثر الأعمال الجانبية طويلة الأجل استقراراً كشف
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
معسكر تدريب مشروع بيع المنتجات على دوين: لا حاجة للظهور أمام الكاميرا، المبتدئون ينتجون فيديوهات بيع المنتجات باتباع الخطوات
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
خطة العمل داخل الألعاب الأولى لكسب المال: ربح يومي 1000+، ويستطيع الشخص العادي القيام بها في وقت فراغه كشف
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن






-
Lu Master v6.1024.4105.1121 نسخة مبسطة بملف واحد [Ge Chuzi Software · R1880]
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
برنامج إنشاء رسوم متحركة كرتونية ثنائية الأبعاد Moho Pro v14.3 [برنامج جي تشويزي · R2355]
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
برنامج تحرير ومعالجة الفيديو للحاسوب Aiseesoft Filmai v1.0.18
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
Microsoft To Do v2.147 النسخة الرسمية المجانية
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن -
PR/AE/DaVinci/FCPX إضافة راسم إشارة تدريج ألوان الفيديو Nobe OmniScope Win1.11.15 / Mac1.10.138【البرمجيات·R2748】
مادة دراسية مرجعية — مشمولة بالعضوية اشترك الآن





برنامج استنساخ الصوت بالذكاء الاصطناعي هو أداة قوية لاستنساخ الصوت مطورة خصيصاً لأجهزة الكمبيوتر، ويمكن تشغيلها بشكل مستقل تماماً محلياً. الهدف من تصميم هذه الأداة هو مساعدة المستخدمين على استنساخ نبرة صوت معينة بسهولة، وتحويل محتوى النص إلى إخراج صوتي، مع تأثير محاكاة قريب جداً من الصوت الأصلي. ومن الجدير بالثناء أن هذا البرنامج لا يحتاج إلى تثبيت، ويمكن استخدامه مباشرة بعد فك الضغط، مما يجعل التشغيل بسيطاً وسريعاً.

يعمل بشكل غير متصل بالإنترنت تماماً، ومتاح في أي وقت
لا يعتمد برنامج استنساخ الصوت بالذكاء الاصطناعي على اتصال الشبكة، ويعمل بالكامل على الكمبيوتر المحلي. وهذا يعني أنه يمكنك تحويل أي نص إلى صوت في أي وقت، وهو مثالي لإنشاء الكتب الصوتية أو تطبيقات صوتية أخرى. ونظراً لاستخدام محرك ذكاء اصطناعي محلي متقدم، يبلغ حجم حزمة البرنامج 10GB، مما يضمن إخراجاً عالي الجودة وسرعة معالجة عالية.
الوظائف الرئيسية
- استنساخ الصوت:تدريب عينة الصوت التي توفرها إلى نموذج صوتي دقيق.
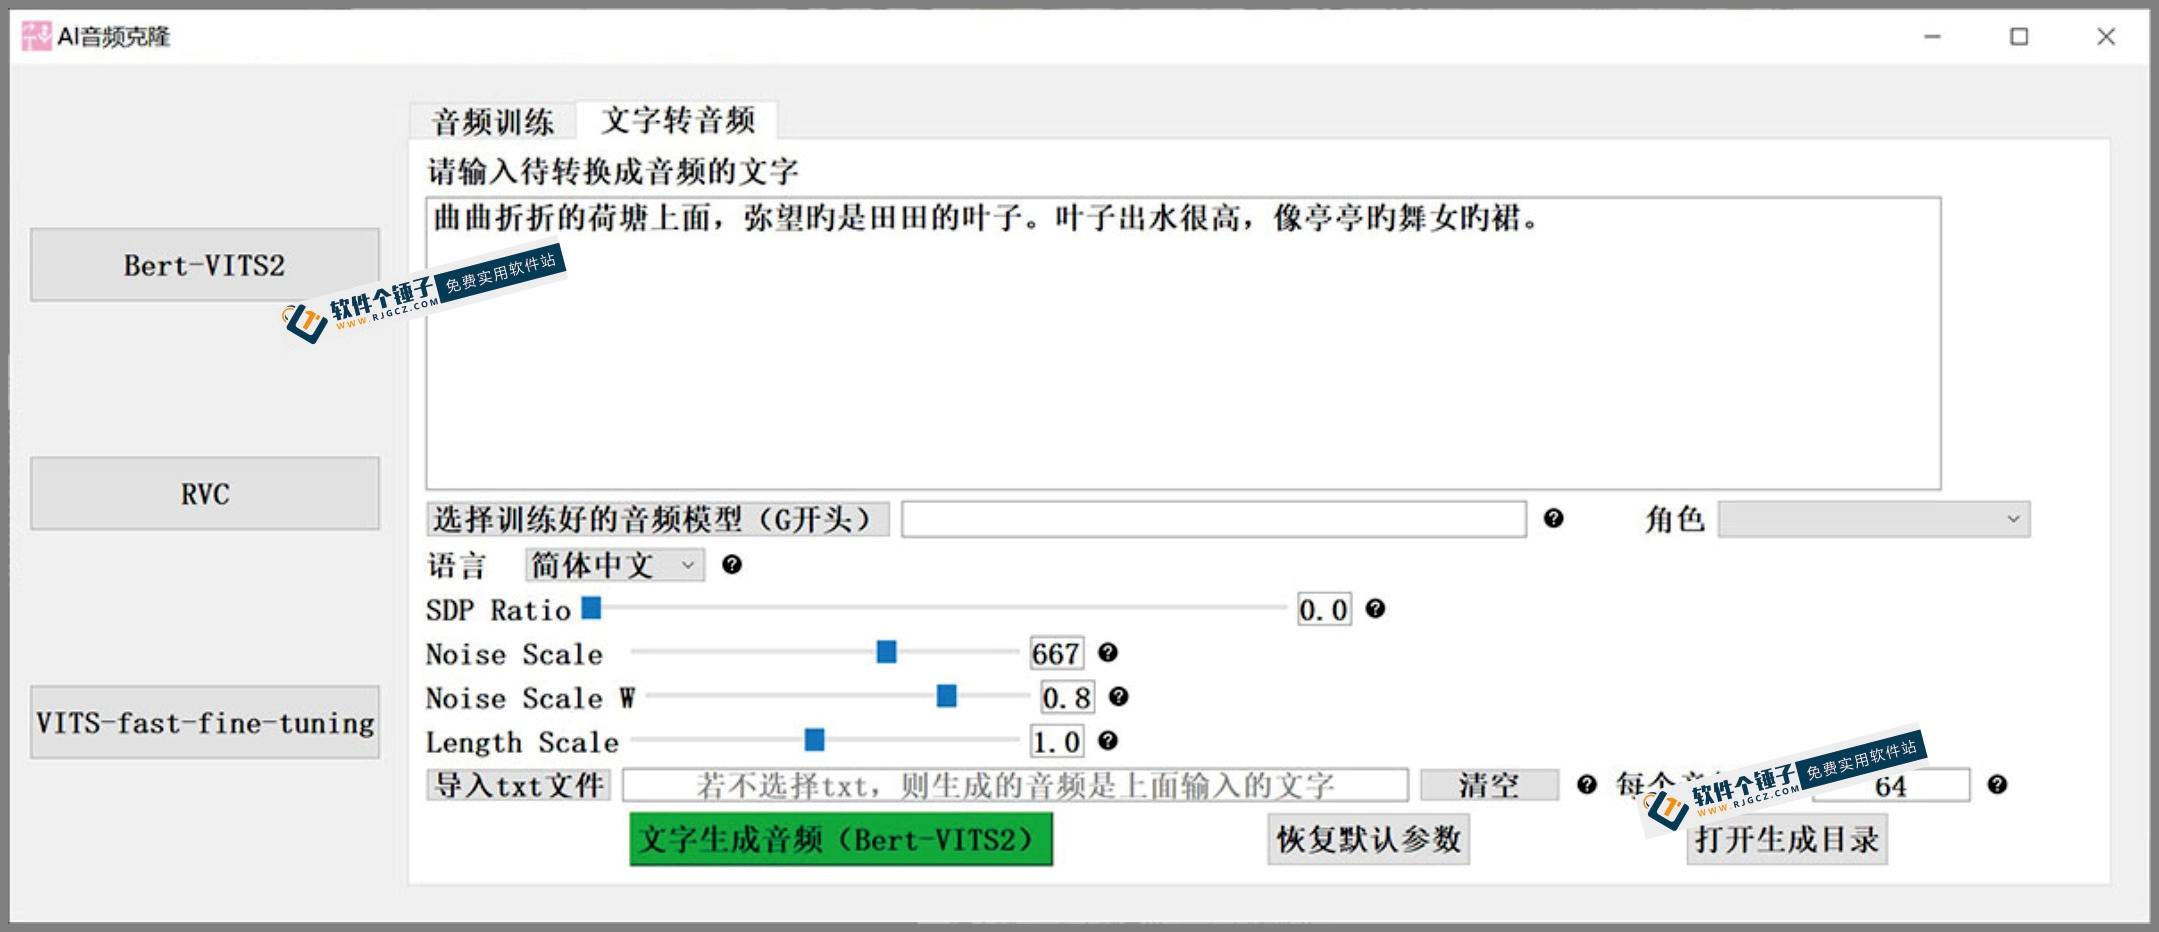
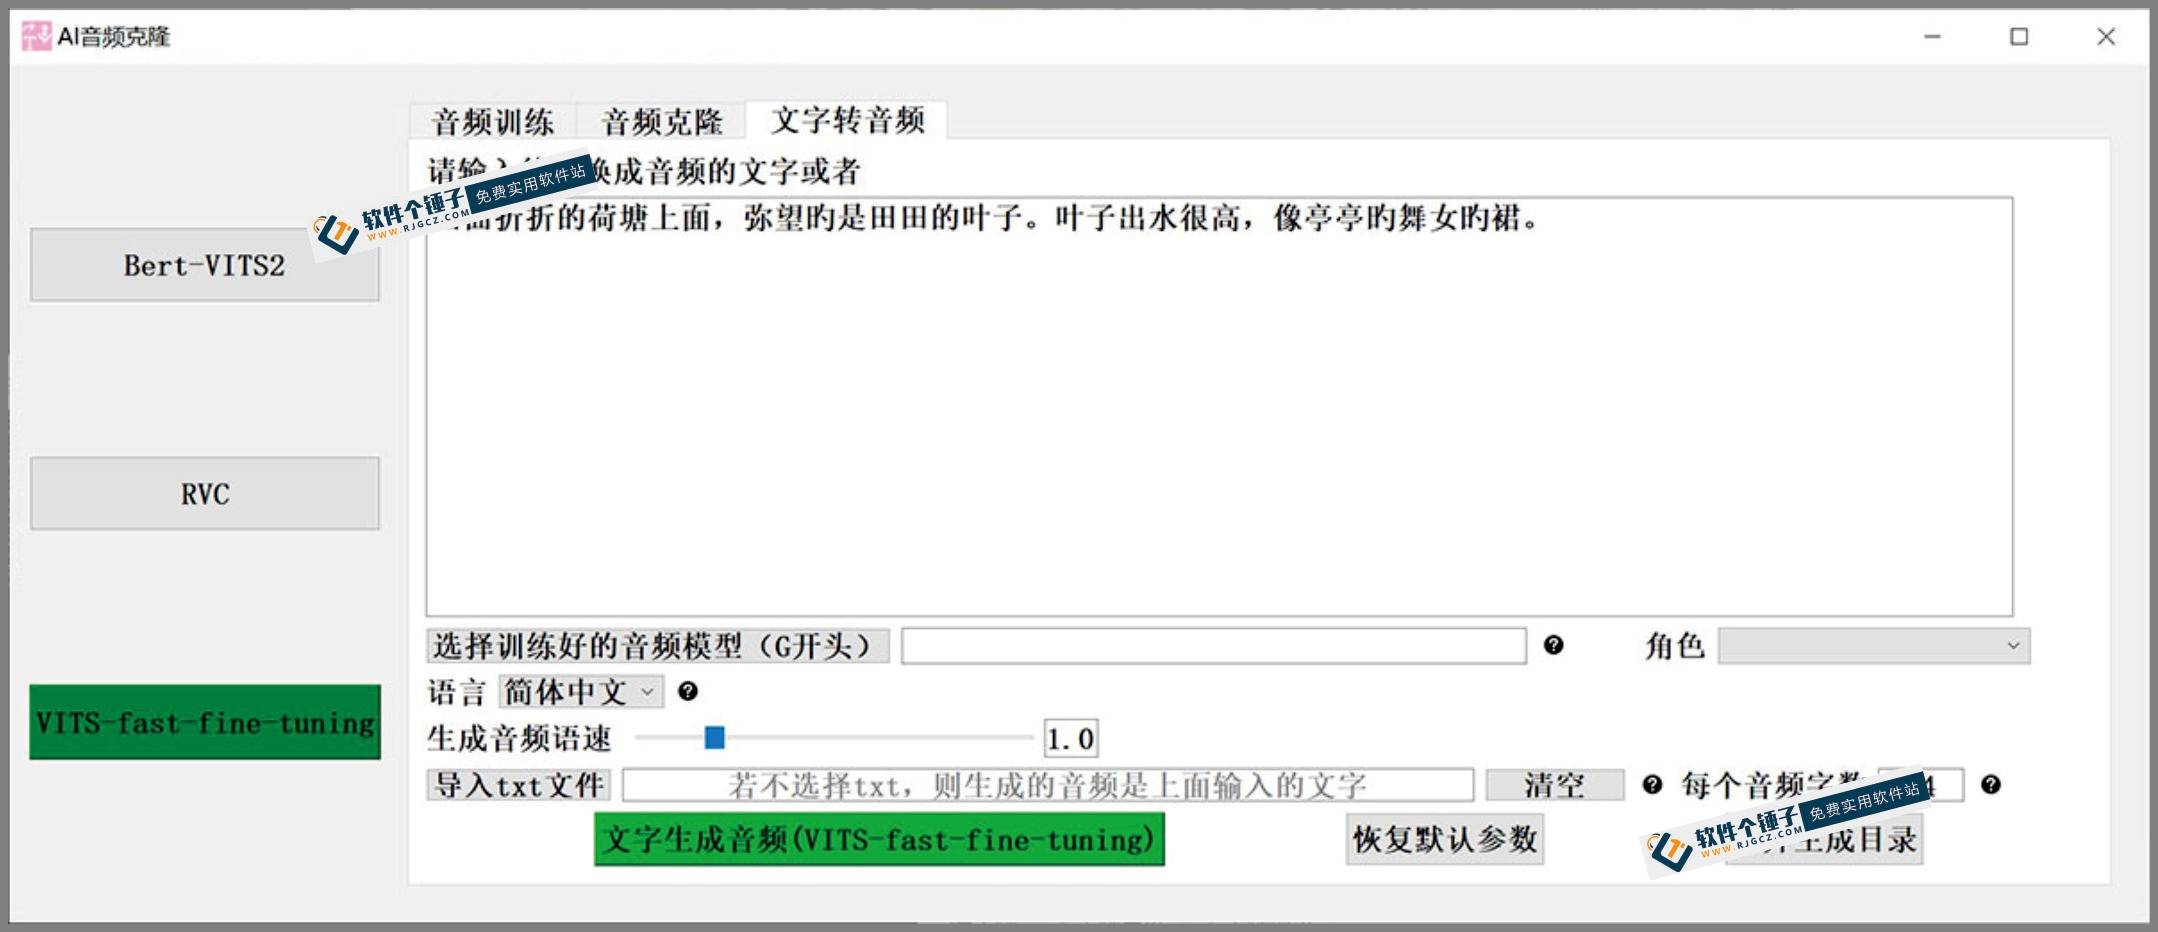
- تحويل النص إلى صوت:يمكن للبرنامج تحويل النص الموجود في مربع الإدخال أو مستند TXT إلى إخراج صوتي بنفس نبرة الصوت. وإذا وُجد نص مُدخل ومستند TXT في نفس الوقت، فستتم معالجة محتوى مستند TXT بشكل افتراضي أولاً.
سجل تحديثات البرنامج
- إصدار V2.2 (تاريخ التحديث: 2024-02-08):الترقية إلى Bert-VITS2، مما يعزز قدرة معالجة النموذج.
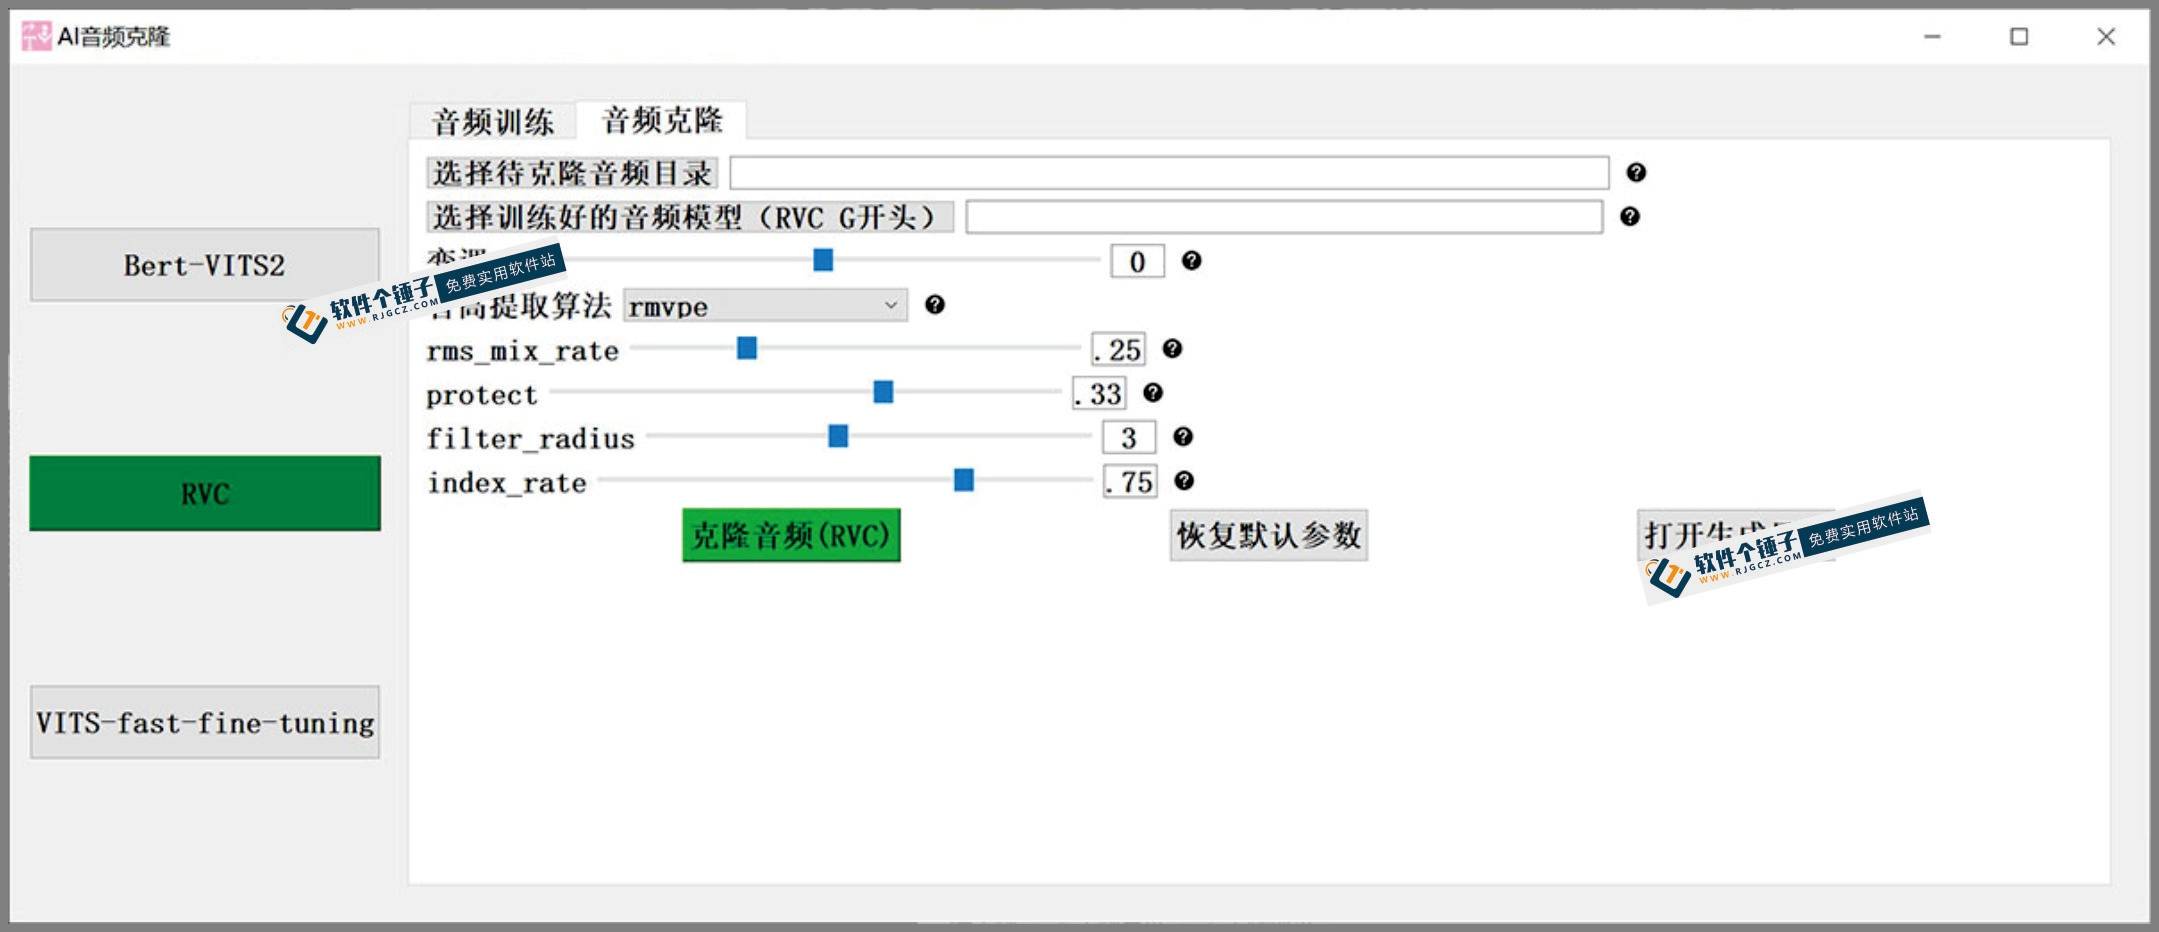
- إصدار V2.0 (تاريخ التحديث: 2023-11-11):إضافة مشروع استنساخ الصوت القوي RVC، مما يدعم مهام استنساخ أكثر تعقيداً للأصوات البشرية والأغاني.
يوفر برنامج استنساخ الصوت بالذكاء الاصطناعي من خلال وظائفه القوية وتشغيله السهل للمستخدمين حلاً فعالاً ومريحاً لتركيب الصوت. سواء كان للترفيه الشخصي أو الإنتاج الاحترافي، فهو خيار لا غنى عنه من الأدوات.
يمكن تقسيم طريقة إنشاء وتركيب الأصوات المخصصة باستخدام برنامج استنساخ الصوت بالذكاء الاصطناعي إلى خطوتين رئيسيتين:
أولاً، إنشاء قالب صوتي
الهدف من هذه المرحلة هو إنشاء قالب صوتي مخصص وفقاً لاحتياجاتك.
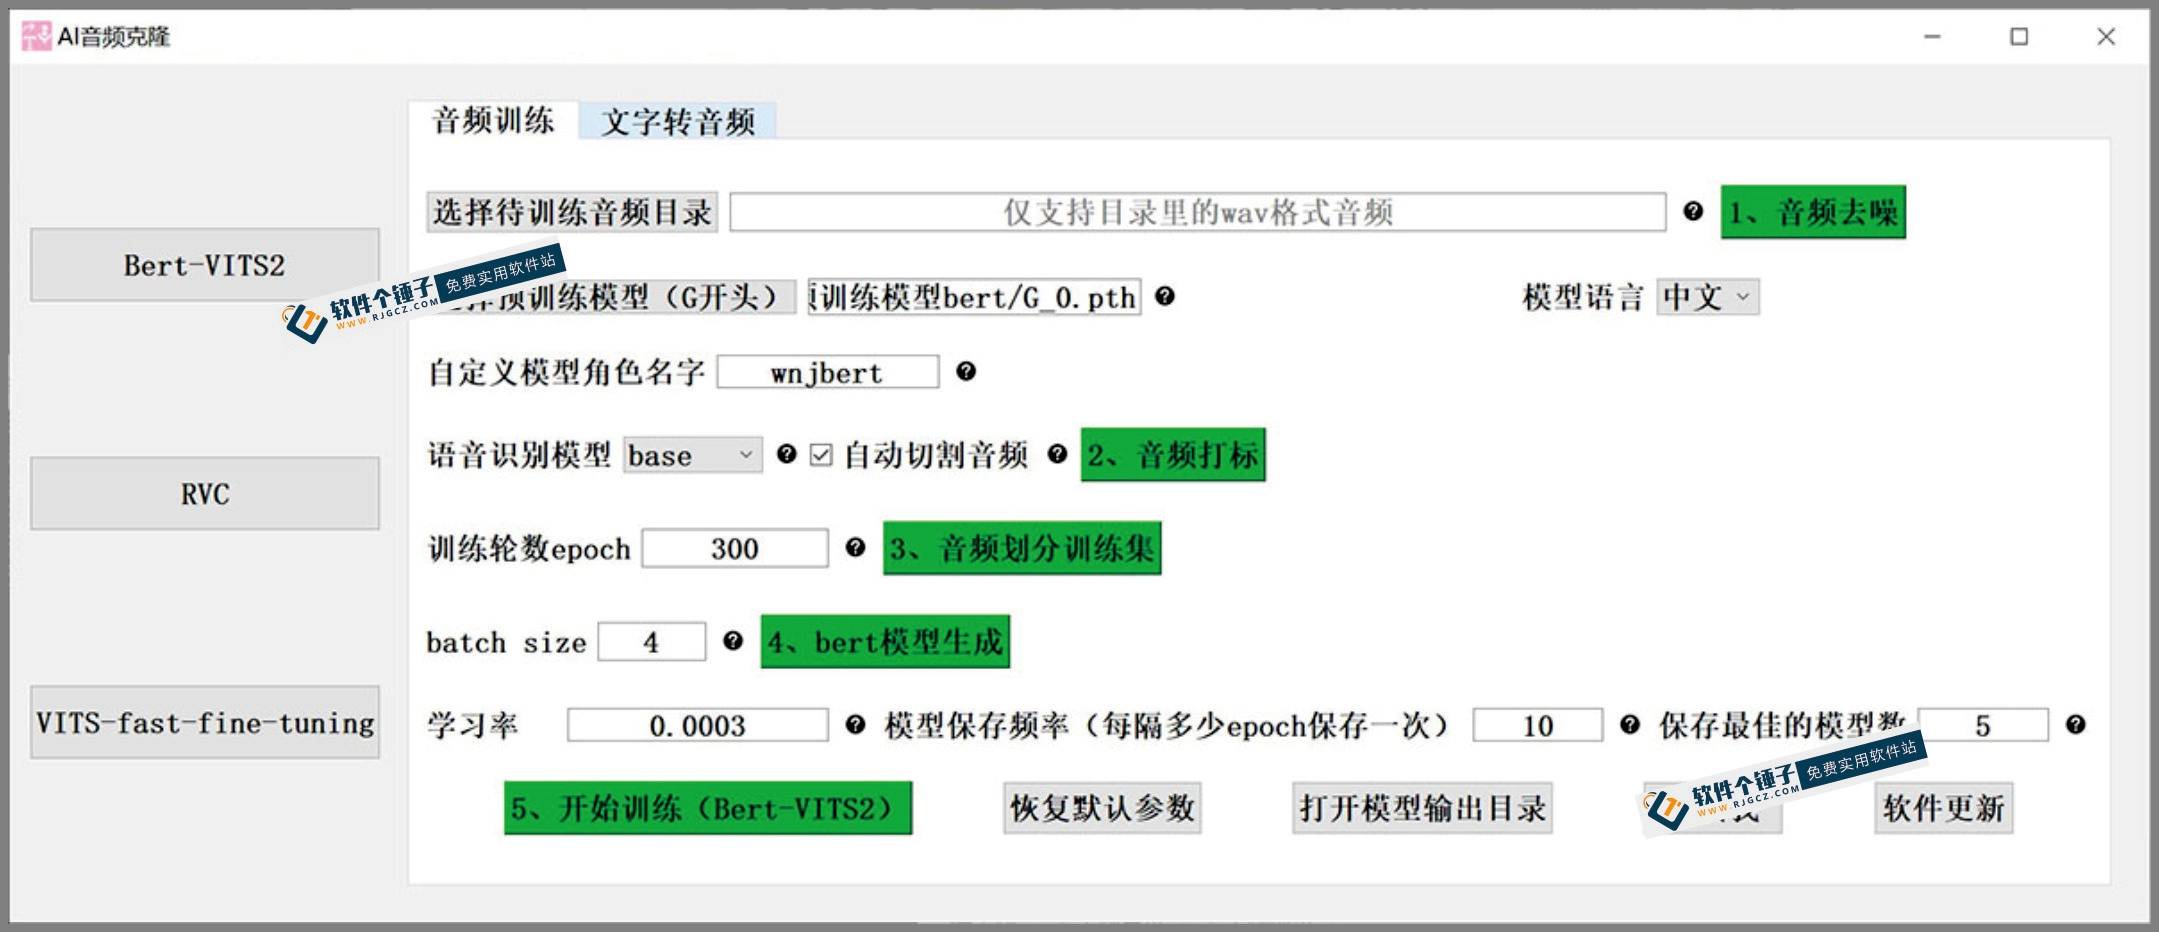
1. اختيار مجلد الصوت المراد تدريبه: سيعالج البرنامج تلقائياً المجلد الذي يحتوي على ملفات صوتية بصيغة WAV، وينفذ مهام المعالجة المسبقة مثل القطع وإزالة الموسيقى الخلفية والضوضاء.



2. استخدام النموذج المُدرَّب مسبقاً: عادةً لا حاجة لعملية يدوية، حيث يحمّل البرنامج افتراضياً النموذج الذي يوفره المؤلف. وإذا كنت بحاجة إلى الاختيار اليدوي، يمكنك التحديد مباشرة من المجلد الذي يُخزَّن فيه النموذج.
3. تسمية دور النموذج المخصص: قم بتسمية نموذجك باستخدام اسم بالإنجليزية.
4. اختيار نموذج التعرف على الصوت: عادةً يكفي استخدام نموذج base الافتراضي.
5. ضبط عدد دورات التدريب (epoch): يُنصح بضبطه على 200، ورغم أن بضع عشرات من الدورات تكون كافية عادةً، إلا أن 300 دورة يمكن أن تحقق نتائج أفضل.
6. ضبط حجم الدفعة (batch size): يجب ضبطه وفقاً لسعة ذاكرة الرسوميات لديك، وعادةً يُضبط بقيمة أصغر.
7. تحديد معدل التعلم: يكفي استخدام الإعداد الافتراضي. بعد إتمام الإعدادات المذكورة أعلاه، انقر على بدء التدريب لبدء إنشاء القالب الصوتي.

ثانياً، تركيب تحويل النص إلى صوت
بعد إنشاء القالب الصوتي، يمكنك البدء في تحويل النص إلى صوت.
1. إدخال أو استيراد النص: أدخل النص مباشرة في البرنامج أو أضف النص المراد تحويله عبر استيراد ملف TXT. (إذا وُجدا معاً، ستتم معالجة النص الموجود في ملف TXT أولاً)
2. اختيار نموذج الصوت المُدرَّب: اختر نموذج الصوت الذي يبدأ بحرف G والذي تم إنشاؤه في الخطوات السابقة.


3. الإبقاء على الإعدادات الافتراضية: يمكن الإبقاء على الإعدادات الأخرى مثل نسبة مزج SDP ومستوى الضوضاء وسرعة الكلام على الوضع الافتراضي.
4. إنشاء الصوت: بعد إتمام الإعدادات، انقر على إنشاء الصوت، وسيقوم البرنامج بإنشاء الصوت بناءً على النص المُدخل والنموذج المختار.
من خلال هاتين الخطوتين، يمكنك بسهولة استخدام برنامج استنساخ الصوت بالذكاء الاصطناعي لإنشاء قوالب صوتية مخصصة، وتحويل أي نص إلى صوت محدد.
دورات ذات صلة

صندوق أدوات محلي خارق: يتضمن تسجيل الشاشة وقص ودمج الصوت والفيديو وضغط الفيديو واستخراجه مجاناً للأبد، تحويل الفيديو

أداة مجانية مثالية 100%: برنامج PDF متعدد الوظائف من مكان واحد، تحويل وضغط وتحرير PDF وغيرها، بسيط بلا إعلانات، JOPDF

أداة سطح المكتب البعيد مفتوحة المصدر، تتفوق على النسخ المدفوعة! مجاني للاستخدام الشخصي والتجاري بلا حدود، تدعم جميع المنصات، HopToDesk

أحدث أداة تنزيل كتب المرحلة المدرسية: تنزيل دفعي لصف دراسي كامل، والوسائط التعليمية والفيديوهات والصوتيات بنقرة واحدة

هويان باو: تطبيق حماية العين من الضوء الأزرق مجاناً مع تذكيرات استراحة بالحيوانات

ويندوز يمكنه الحصول على جزيرة ديناميكية على سطح المكتب! مركز تحكم حديث يضيف نتوءاً أسود لجهازك — PyIsland

إنتاج دراما مصورة ثلاثية الأبعاد واقعية: دورة Seedance2.0 العملية الكاملة من الصفر إلى إنشاء محتوى عالي الجودة

يدعم ويندوز وماك! أحدث إصدار دائم مدى الحياة، إصلاح الصور القديمة، تكبير الصور بلا فقدان الجودة Aiarty Image Enhancer

دورة تدريبية عبر الإنترنت: أداة Github مفتوحة المصدر لتنزيل فيديوهات Bilibili / تدعم 8K وDolby Vision / Bilidown


