


AI画像生成神器 ワンクリック統合パッケージ FLUX.1 無料オープンソース
-

热門游戏全自動搬砖、日入500+、无需経験操作簡単、目前最稳定的長期搬砖副業「揭秘」
会員向け参考学習資料 会員になる






-
PC版 動画編集処理ソフト Aiseesoft Filmai v1.0.18
会員向け参考学習資料 会員になる -
Microsoft To Do v2.147 公式無料版
会員向け参考学習資料 会員になる





FLUX.1について
「Stable Diffusion」の開発者が設立したBlack Forest Lab 黒森林研究所が、最近話題の画像生成モデル「FLUX.1」を発表しました。この新モデルは中国語入力に対応し、卓越した言語理解とテキスト制御能力を発揮します。FLUX.1は3種類の画像生成モデルを提供しており、そのうち2つはオープンソースで、さまざまなユーザーに多様な選択肢を提供します。
FLUX.1 モデル概要
- FLUX.1 [pro]:クローズドソース版。API経由での呼び出しが必要で、プロフェッショナルユーザーに適しています。
- FLUX.1 [dev]:開発版モデル。非商用ライセンスのオープンソースで、開発者や個人利用に適しています。
- FLUX.1 [schnell]:基本版簡素化モデル。動作速度が速く、Apache 2ライセンスを使用し、商用利用が可能です。
モデル性能比較
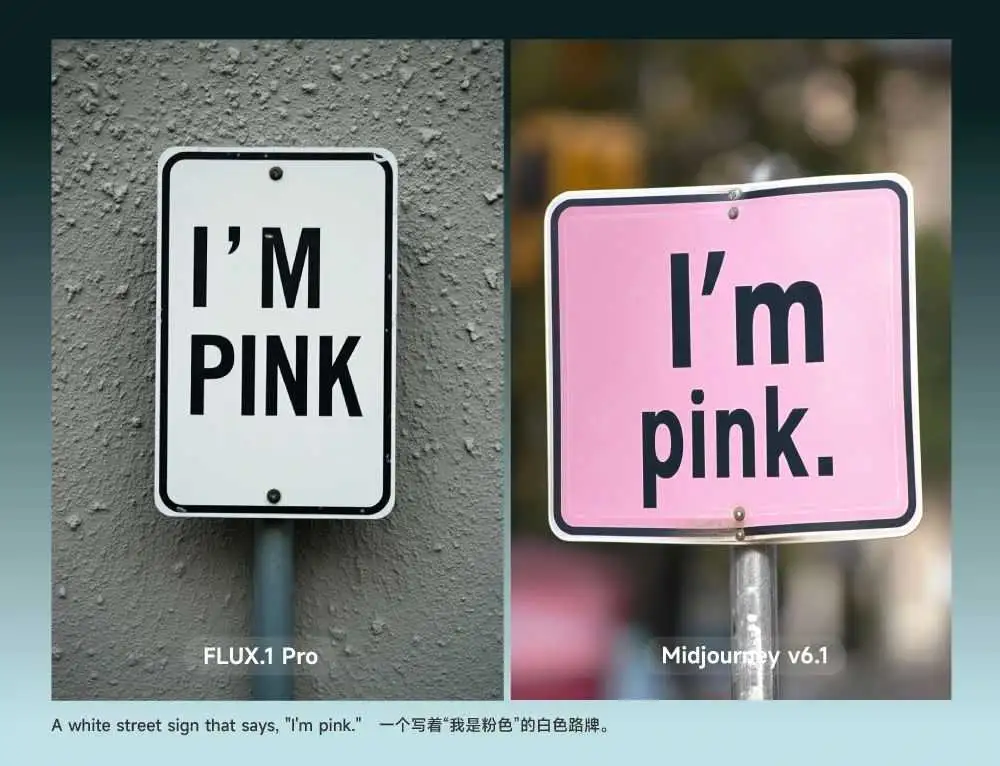
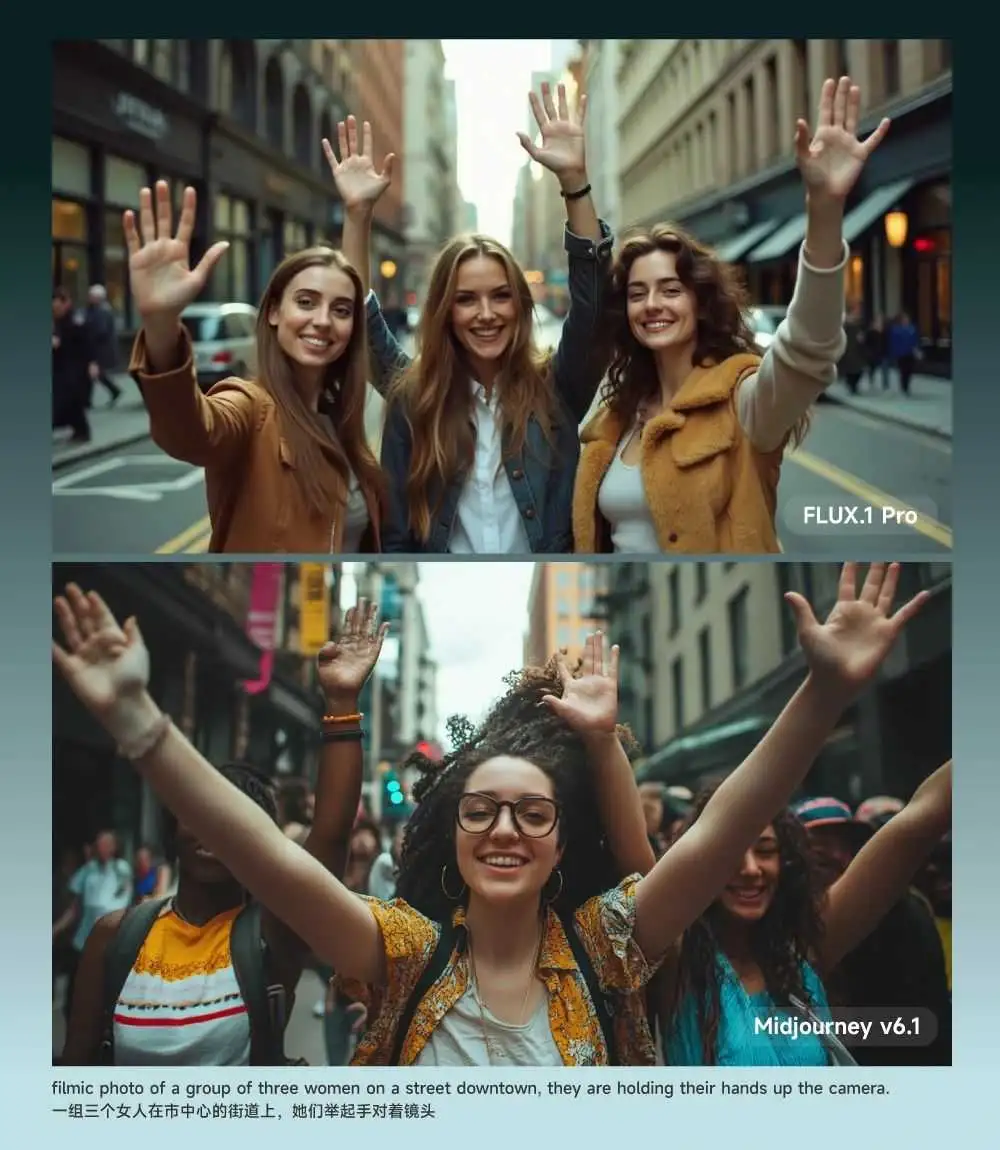
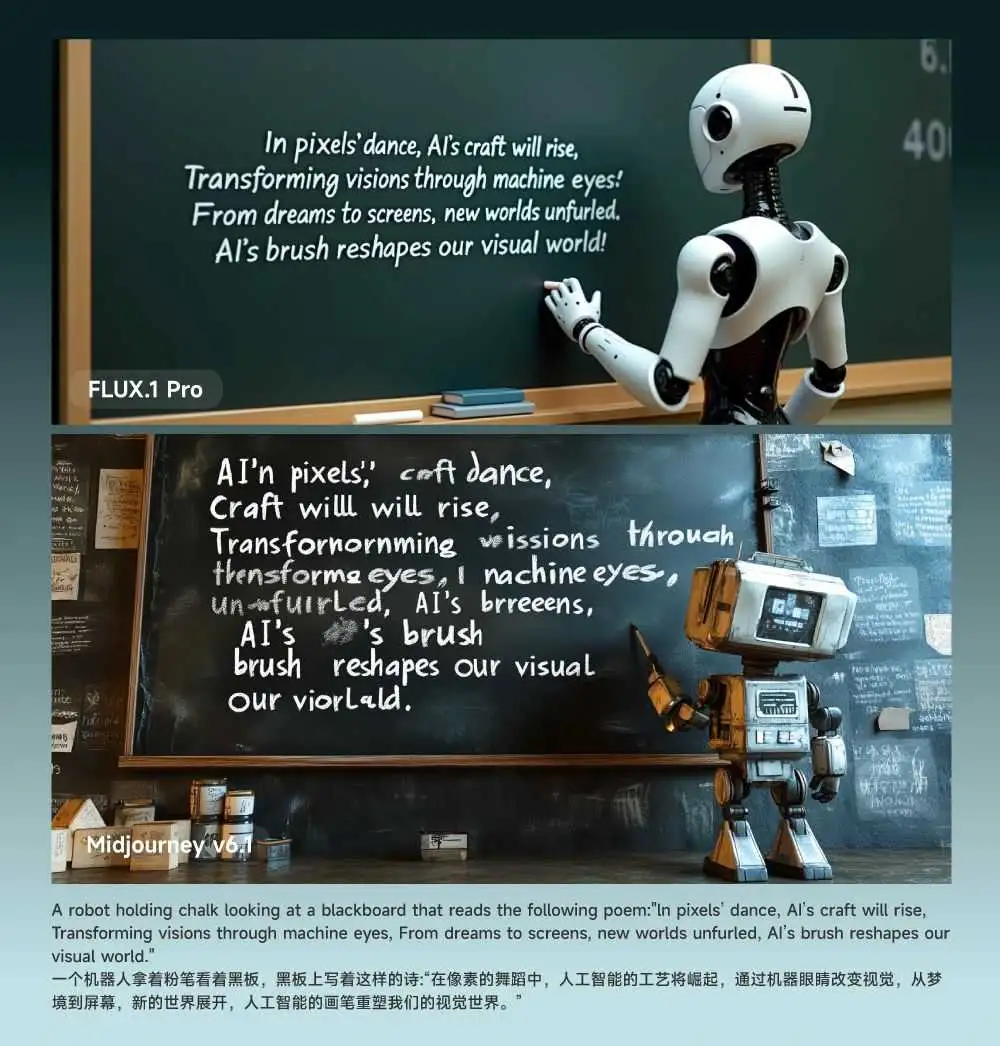
FLUX.1 ProとMidjourneyの最新v6.1モデルを比較しました。FLUX.1はアートスタイルや多様性ではMidjourneyに及びませんが、画像の鮮明さ、ディテールのリアルさ、複雑なシーン生成において、FLUX.1 Proの性能はv6.1と互角、あるいは一部の面でv6.1を超えています。特に複雑な英文テキスト、複数人のシーン、プロンプト理解の処理において、FLUX.1 Proの性能はv6.1を著しく上回っています。FLUX.1 Proは複数人のシーンを正確に処理し、顔や手のディテールの歪みを回避し、超長文テキスト生成時も内容とレイアウトが非常に標準的で、同時にプロンプト漏洩問題を効果的に防止します。








ワンクリック統合パッケージ
「FLUX.1」ワンクリック統合パッケージはStable Diffusion WebUI forgeをベースに、nf4量子化版軽量モデルを使用しています。nf8モデルと比較して、nf4はより小さなサイズでより良い生成効果を実現します。実測では、6GのVRAMでスムーズに動作し、1枚の画像生成に約30秒かかります。ダウンロード後、解凍して「起動webui.bat」ファイルを実行するだけで、自動的にwebuiインターフェースに遷移します。その後、FLUX.1のnf4モデルを選択して生成します。
オンライン体験
お使いのPC構成が「FLUX.1」モデルをサポートできない場合でも、オンラインプラットフォームを通じてこの画像生成ツールを体験できます。pro、dev、schnellいずれのバージョンでも、テキスト内容を入力し、画像比率を設定して、必要な画像を生成できます。
オンライン体験:
https://replicate.com/black-forest-labs
関連コース











