


PDF 내용 추출기 v1.0 버전
-

선착순 게임 노가다 돈벌기 계획, 일 1k+, 일반인 한가한 시간에 가능! (공개)
회원 참고 학습 자료 멤버십 가입











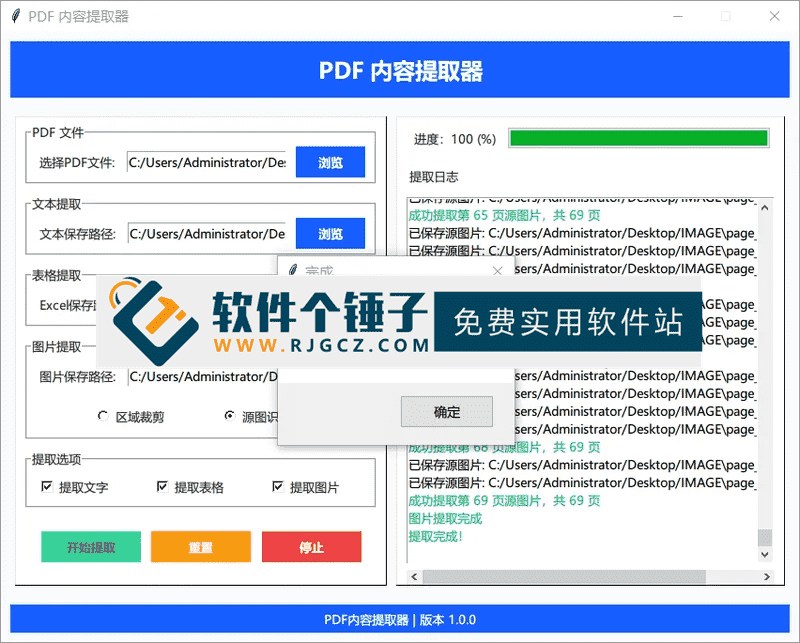
PDF 문서를 처리할 때 가장 번거로운 점은 그 안의 텍스트, 표 또는 이미지가 필요할 때 일일이 수동으로 복사 붙여넣기만 해야 한다는 것으로, 느릴 뿐만 아니라 오류가 발생하기 쉽습니다.PDF 내용 추출기 v1.0는 바로 이 문제를 해결하기 위해 탄생했습니다. 이것은PDF 파일에서 내용을 추출하는 데 전문화된 도구로, 다음과 같은 도움을 줍니다:텍스트, 이미지 등의 요소를 추출하고 표 추출도 지원. 이 도구의조작이 매우 간단하여 PDF 안의 필요한 정보를 빠르게 얻을 수 있으며, 번거로운 수동 복사 붙여넣기를 완전히 벗어나 업무 효율을 크게 높입니다. 기본적으로PDF 파일을 열고 추출 버튼을 클릭하면 내용이 추출됩니다.

편집자 요약: 사무 환경의 효율 보조 도구
종합하면,PDF 내용 추출기 v1.0은PDF 텍스트 내용을 빠르게 추출해야 하는 사용자에게 적합한 도구입니다. 이 도구는조작이 간단하고 기능이 실용적이며, 문서 처리 효율을 효과적으로 높일 수 있어특히 사무 환경에서의 다양한 텍스트 추출 요구에 적합합니다.
핵심 기능 상세 설명
1. 포괄적인 콘텐츠 추출 기능
소프트웨어의 핵심은PDF 파일에서 순수 텍스트 콘텐츠를 빠르게 추출하는 것으로, 이는 가장 자주 사용되는 기능입니다. 뿐만 아니라PDF 내의 복잡한 표 구조 추출도 지원하며, 그리고문서 내의 이미지를 개별적으로 추출할 수 있습니다. 이미지를 추출할 때필요에 따라 사용자 정의 이미지 추출 방식을 선택할 수 있습니다, 매우 유연합니다.
2. 편리한 출력 및 처리 방식
추출된 콘텐츠는범용 TXT 텍스트 형식으로 편리하게 저장할 수 있어이후 편집과 사용이 용이합니다. 처리할 PDF 파일이 많다면일괄 처리 기능이 기능이 유용하게 활용됩니다여러 PDF 파일을 동시에 추가하고 처리할 수 있어시간과 노력을 절약할 수 있습니다.
3. 친화적인 사용 경험과 무료 사용
전체 소프트웨어의인터페이스는 매우 간결하고 직관적으로 설계되었으며 조작 단계가 간단명료하여사용법을 익히는 데 어려움이 없습니다. 또한사용자 정의 추출 옵션, 여러분은전체 페이지 콘텐츠를 추출하거나 지정한 특정 페이지만 추출할 수 있어필요에 정확히 부합합니다. 가장 좋은 점은 이 소프트웨어가완전 무료로 사용할 수 있으며 계정 등록조차 필요 없어바로 실행하여 사용할 수 있고 아무런 부담이 없습니다.
요약
PDF 내용 추출기 v1.0은가볍지만 매우 실용적인 데스크톱 도구로, PDF에서 구조화된 정보를 얻는 빈번한 요구를 정확히 겨냥합니다. 수동 복사-붙여넣기와 비교하여원클릭 텍스트, 표, 이미지 추출 기능을 통해 효율성의 비약을 실현했습니다.표 콘텐츠 인식 및 추출은 PDF 처리의 흔한 문제점을 해결합니다.일괄 처리 능력과 페이지 범위 선택은 대량 문서나 장문 보고서를 처리할 때 여유롭게 대응할 수 있게 합니다.간결한 인터페이스와 완전 무료 특성은 사용 장벽을 더욱 낮추어 학생, 사무직 종사자, 연구원 등 광범위한 사용자층이 PDF 자료를 처리할 때 유용한 조력자가 되게 합니다. 버전 번호가 1.0이지만 제공하는 핵심 기능은 이미 충분히 성숙하여 일상 업무와 학습의 실제 문제를 확실히 해결할 수 있습니다.
관련 강의





후옌바오: 반려동물 휴식 알림이 있는 무료 블루라이트 눈보호 앱






