


-
Kursus Perniagaan
-
 Lain-lain
-
Tutorial Luar Negara
-
Fotografi & Penyuntingan
-
Komuniti & Domain Persendirian
-
Penulisan Media Sendiri & Penulisan Iklan
-
Projek Pendapatan Sampingan
-
E-dagang
-
Video Pendek & Penstriman Langsung
-
Kecerdasan Buatan (AI)
-
Perisian & Alatan
-
Sistem Pengendalian
-
Pemalam & Skrip
-
Perisian MacOS
-
Perisian Android
-
Perisian Windows
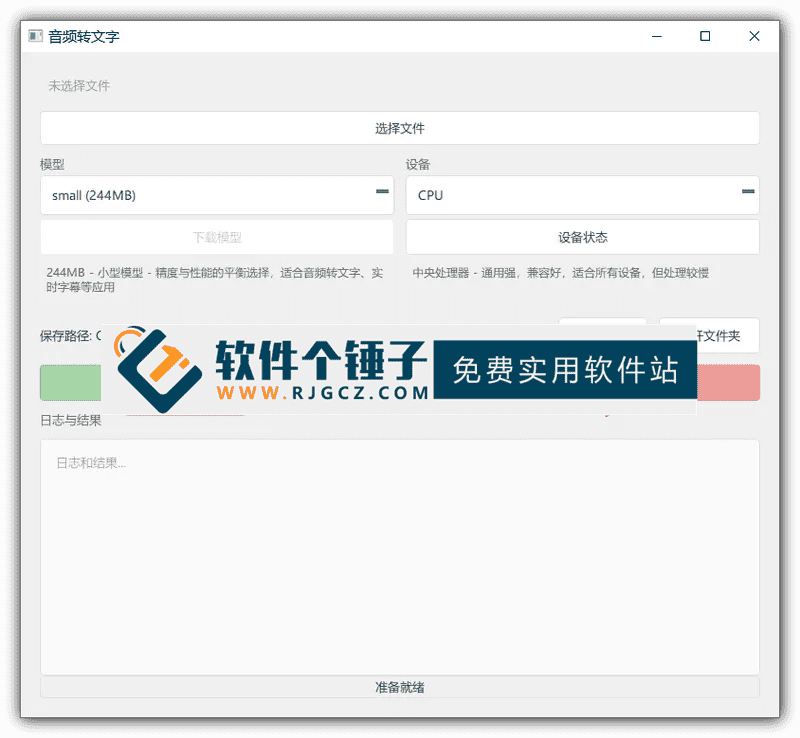
Perisian pengecaman suara AI AI suara ke teks versi v1.0 menyokong penjanaan sari kata SRT dengan satu klik【Perisian Ge Chuzi·R4744】
-
Pelan Buat Duit Farming Emas Permainan: Jana 1k+ Sehari, Projek Stabil 3 Tahun, Orang Biasa Boleh Buat Pada Masa Lapang
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pendapatan automatik sepenuhnya permainan popular: 500+ sehari, tiada pengalaman, operasi mudah - kerja sampingan pendapatan permainan jangka panjang paling stabil (didedahkan)
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Tikus berjasa kali ini! Jangan panik dengan masalah format Windows - alat penukaran format FlyingMouse sumber terbuka membantu, permata GitHub popular
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Bootcamp Jualan Produk Douyin Dengan Bimbingan: Tak Perlu Muncul Di Kamera, Pendatang Baharu Ikut Langkah Hasilkan Video Pendek Jualan
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pelan jana wang game terbitan pertama: 1K+ sehari, orang biasa boleh lakukan pada masa lapang
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli






-
Tikus berjasa kali ini! Jangan panik dengan masalah format Windows - alat penukaran format FlyingMouse sumber terbuka membantu, permata GitHub popular
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Master Lu v6.1024.4105.1121 versi fail tunggal yang diringkaskan [Perisian Ge Chuizi·R1880]
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Perisian Animasi Kartun 2D Moho Pro v14.3 [Perisian Ge Chuzi · R2355]
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Perisian penyuntingan dan pemprosesan video untuk komputer Aiseesoft Filmai v1.0.18 【Software Ge Chuizi·R2470】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Microsoft To Do v2.147 versi rasmi percuma【Software Ge Chuizi·R2618】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli -
Pemalam osiloskop pembetulan warna video PR/AE/DaVinci/FCPX Nobe OmniScope Win1.11.15 / Mac1.10.138【Perisian Ge Chui Zi·R2748】
Bahan belajar rujukan — termasuk dalam keahlian Jadi Ahli





Alat AI suara ke teks v1.0 ialah perisian suara ke teks setempat yang dibangunkan berdasarkan model Whisper sumber terbuka OpenAI, direka khas untuk pengguna yang perlu bekerja secara luar talian, mengejar ketepatan tinggi dan menyokong pengecaman pertuturan. Jika anda sering mencari "alat tempatan penukaran suara ke sari kata yang menyokong bahasa Cina", "perisian percuma antara muka grafik Whisper yang tidak perlu sambungan internet" atau "alat pengecaman suara yang boleh memproses MP3 ke SRT secara kelompok dalam sistem Win10", maka ia tepat sekali menyediakan penyelesaian yang sempurna untuk anda — tanpa sambungan rangkaian, tanpa memuat naik sebarang fail audio, semua pemprosesan dilakukan pada komputer anda sendiri. Sama ada menyusun rakaman mesyuarat, menambah sari kata untuk video kursus dalam talian, atau mentranskripsi bahan temu bual, pengguna boleh mendapatkan transkrip teks yang tepat dengan pantas tanpa sebarang risiko kebocoran privasi. Berbanding perkhidmatan dalam talian yang perlu memuat naik audio sensitif, atau alat baris arahan yang kurang mesra untuk pengguna biasa, perisian ini dengan ciri "operasi satu klik + antara muka sepenuhnya dalam bahasa Cina + permulaan tanpa konfigurasi" telah mengurangkan halangan penggunaan pengecaman suara AI dengan sangat besar.

Bagaimana ia menyesuaikan diri dengan komputer dan keperluan yang berbeza?
Perisian ini mengintegrasikan empat saiz model Whisper yang berbeza iaitu tiny, base, small dan medium, pengguna boleh memilih secara fleksibel mengikut prestasi komputer sendiri. Contohnya, komputer riba dengan konfigurasi rendah boleh memilih model tiny untuk mencapai tindak balas dalam beberapa saat; manakala komputer meja berprestasi tinggi boleh mengaktifkan model medium untuk mendapatkan ketepatan pengecaman tertinggi. Ia menyokong pengekstrakan suara secara automatik daripada fail audio dan video biasa seperti MP4, MOV, MP3, WAV, dan mengeluarkan fail sari kata SRT dengan garis masa yang tepat, atau dokumen TXT teks biasa, fail-fail ini boleh terus diimport ke dalam perisian penyuntingan video seperti Jianying, Premiere dan lain-lain. Ia sesuai untuk guru menghasilkan sari kata video pengajaran, pencipta media sendiri menjana teks video, wartawan menyusun rekod temu bual, atau pelajar menukar rakaman kuliah menjadi nota teks. Yang paling penting, semua proses pemprosesan dilakukan secara setempat, tiada permintaan rangkaian, tiada pendaftaran akaun, dan tidak menyimpan sebarang data anda, benar-benar merealisasikan janji privasi "suara anda, hanya milik anda".
Analisis penuh ciri fungsi teras
- Beroperasi sepenuhnya secara luar talian setempat: Seluruh proses pengecaman suara dilakukan dalam persekitaran luar talian, sama sekali tidak memuat naik fail audio ke mana-mana pelayan, menjamin keselamatan privasi anda dari akar umbi.
- Mengintegrasikan model Whisper rasmi: Menyokong empat tahap model iaitu tiny, base, small dan medium, boleh menyesuaikan diri dengan komputer yang berbeza dari konfigurasi rendah hingga tinggi.
- Menjana fail sari kata SRT secara automatik: Boleh mengeluarkan fail sari kata SRT standard dengan garis masa yang tepat, boleh terus digunakan dalam pelbagai perisian penyuntingan video.
- Menyokong format audio dan video biasa: Boleh mengekstrak audio secara automatik daripada fail format MP3, WAV, MP4, MOV dan lain-lain untuk pengecaman.
- Dioptimumkan untuk pengecaman bahasa Cina: Dioptimumkan khas untuk senario penggunaan bahasa Mandarin, ketepatan pengecaman suara bahasa Cina jauh lebih tinggi daripada model umum.
- Antara muka grafik yang mesra: Menyediakan antara muka operasi grafik yang intuitif, tidak perlu mempelajari baris arahan yang rumit, biasanya hanya perlu tiga langkah untuk menyelesaikan penukaran suara ke teks.
- Keupayaan pemprosesan kelompok yang cekap: Menyokong penambahan berterusan berbilang fail, perisian akan melaksanakan secara automatik mengikut urutan baris gilir di latar belakang, menjimatkan operasi berulang.
- Percuma sepenuhnya dan: Perisian, tanpa sebarang iklan, tanpa langganan berbayar, tiada tera air, dan tiada had fungsi.
Siapa yang paling sesuai menggunakannya?
Jika anda tergolong dalam salah satu kumpulan berikut, maka alat ini mungkin menjadi pembantu yang berguna untuk anda:
- Pencipta kandungan dan pengamal media sendiri: Perlu menjana sari kata atau teks untuk video dengan pantas.
- Pendidik dan pelajar: Perlu menukar rakaman kursus dan kandungan kuliah kepada nota teks atau sari kata.
- Wartawan dan penyelidik: Perlu menyusun rakaman temu bual atau bahan wawancara dengan cekap dan tepat.
- Pengguna yang mempunyai keperluan tinggi terhadap privasi dan keselamatan: Tidak mahu rakaman mesyuarat dan audio peribadi mereka dimuat naik ke awan.
- Pengguna komputer biasa yang tidak biasa dengan baris arahan: Mahukan antara muka grafik yang mudah digunakan untuk menggunakan model Whisper yang berkuasa.
Ringkasan mudah
Secara keseluruhannya, alat penukaran suara ke teks AI v1.0 telah "membungkus" model pengecaman suara Whisper terkemuka menjadi perisian Windows yang sangat mesra pengguna biasa. Ia menyelesaikan kebimbangan privasi perkhidmatan dalam talian dan kesukaran operasi alat baris arahan, membolehkan anda menikmati keupayaan pengecaman suara berketepatan tinggi sambil mengawal data anda sendiri. Sama ada untuk meningkatkan kecekapan kerja atau untuk keperluan perlindungan privasi, ia adalah alat praktikal yang patut dicuba.
Kurs Berkaitan

Kotak alat tempatan super! Rakaman skrin, potong & gabung audio/video, mampat & ekstrak video terbina dalam, percuma selamanya - Kedou Video Converter

Alat percuma sempurna 100%%! Perisian PDF serba boleh sehenti: penukaran, pemampatan, penyuntingan PDF dll., minimalis, tiada iklan, sangat bagus - JOPDF

Alat Desktop Jauh Sumber Terbuka, Mengatasi Versi Berbayar! Percuma untuk Kegunaan Peribadi dan Komersial Tanpa Had, Merentas Platform, HopToDesk

Alat Muat Turun Buku Teks Sekolah Terkini: Sokong Muat Turun Seluruh Tingkatan, Bahan Kursus·Video·Audio Satu Klik

HuyanBao: aplikasi penjaga mata cahaya biru percuma untuk komputer, dengan peringatan rehat haiwan peliharaan

Windows juga boleh ada Pulau Dinamik desktop! Pusat kawalan sistem moden, beri komputer anda takuk hitam tambahan, PyIsland

Penghasilan Drama Komik Realistik 3D: Kursus Amali Penuh Seedance2.0

Sokongan Win/Mac! Versi seumur hidup terkini, pemulihan foto lama, peningkatan imej tanpa kehilangan kualiti Aiarty Image Enhancer

Kursus video dalam talian: Github / B / 8K / Bilidown

Koleksi Alat Desktop Windows! 50+ Widget Desktop Minimalis Praktis Terbina, Termasuk Tangkapan Skrin, Rakaman Skrin, Terjemahan, Cuaca dsb. — DuoMi Toolbox

