


PDF自動処理ソフト Automatic PDF Processor v2.0 英語版
-

热門游戏全自動搬砖、日入500+、无需経験操作簡単、目前最稳定的長期搬砖副業「揭秘」
会員向け参考学習資料 会員になる






-
PC版 動画編集処理ソフト Aiseesoft Filmai v1.0.18
会員向け参考学習資料 会員になる -
Microsoft To Do v2.147 公式無料版
会員向け参考学習資料 会員になる





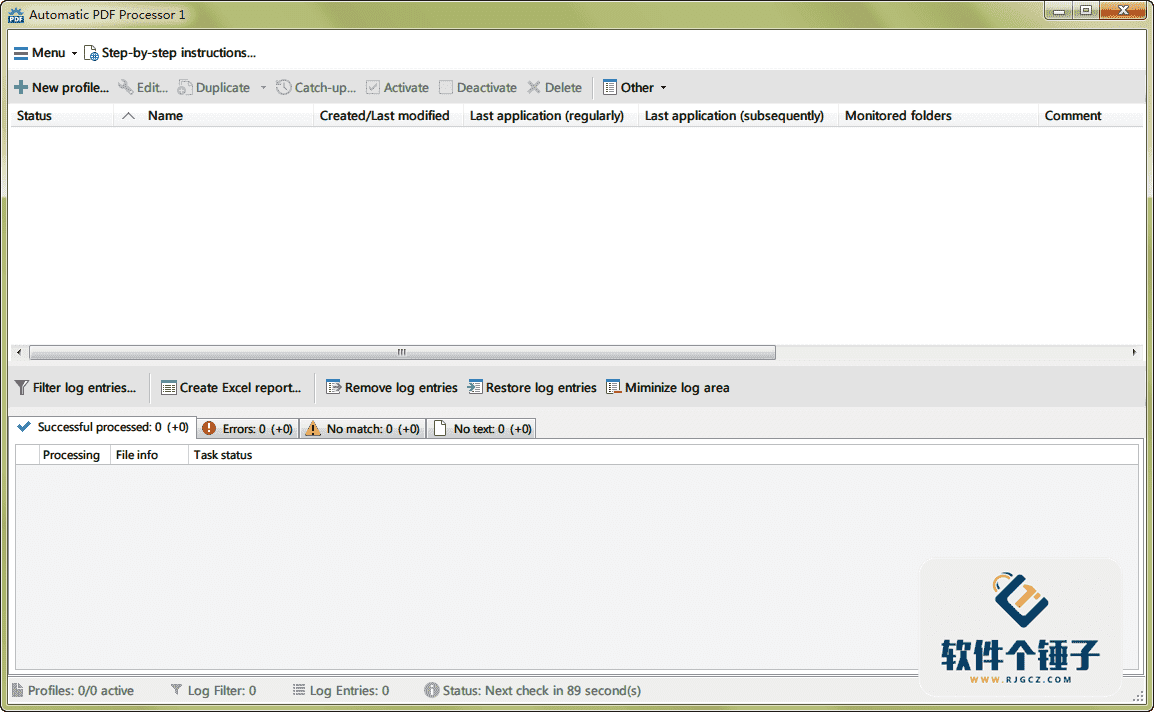
簡単に言えば、Automatic PDF Processorは疲れを知らないPDFファイル管理人のようなものです。指定した任意の数のフォルダ(一般に「ホットフォルダ」と呼ばれます)を自動監視できます。監視対象フォルダに新しいPDFファイルが置かれると、ソフトは事前設定したルールに従って、自動印刷、自動名前変更、ルールに基づいて動的に命名されたフォルダへのファイル移動など、一連の操作を自動実行します。
ファイル内容だけでなく、PDF文書の多くのメタデータ情報もスマートに活用できます。例えば、生成されるファイルパスに請求書番号や日付などの重要情報を含めることができます。処理範囲を正確に制御するために、文書内のテキスト、PDFメタデータ、一般的なファイル情報をフィルター条件として含められる各種ファイルベースのフィルターを使用できます。

核心データ処理能力
このソフトウェアはデータ抽出において特に優れた性能を発揮します。
1. 柔軟なテキストデータ抽出
PDFファイルのテキストから特定のデータを抽出することは、オプションでありながら強力な機能です。設定ファイル内に無制限の抽出ルールを作成できます。抽出されたデータは、オプションの検証とフォーマットを経た後、フォルダやファイル自体の命名に使用でき、またCSV形式のデータファイルとして個別に保存し、後の分析やデータベースへのインポートに利用できます。
2. PDF添付ファイルの自動抽出
さらに別の実用的なタスクも自動実行します。PDFファイルから埋め込まれた添付ファイルを抽出します。例えば、PDF請求書の一部として保存されたZUGFeRD XMLファイル、XRechnung添付ファイルまたは類似の内容を自動的に抽出し、同じフォルダまたは他の指定された場所に保存します。
機能特徴の完全解析
以下では、具体的にどのような作業を自動で完了できるのかを詳しく見ていきましょう:
1. 包括的な自動処理
ソフトウェアはPDFファイルに対する全方位的な自動操作をサポートしています。これには、自動印刷、自動リネーム、自動移動、自動コピー、PDF内の添付ファイルの自動保存、PDFから抽出したテキスト要約の自動保存が含まれます。
2. インテリジェントな「ホットフォルダ」監視
任意の数のフォルダを同時に監視でき、PDFファイルが入ると即座にプリセットされた処理フローがトリガーされます。
3. 強力なルールとフィルタシステム
異なる処理タスクごとに個別のルールを作成できます。ドキュメントテキスト、ファイル日付、添付ファイル名や数、ドキュメントタイトルなど、さまざまな条件でフィルタリングし、要件を満たすファイルのみが処理されるようにします。
4. 動的な保存パスの作成
ファイルの保存場所はもはや固定されていません。ソフトウェアはPDFドキュメントの属性(メタデータ)または抽出された内容に基づいて、保存フォルダとサブフォルダを動的に作成し、真のインテリジェントなアーカイブを実現します。
5. 充実した通知とスケジュール機能
電子メールでさまざまなファイル処理ステータスに関する通知を受け取ることができます。また、自動処理タスクを特定の日付と時間帯に限定して実行することもできます。例えば、営業時間内のみ自動印刷するように設定できます。
6. プロセス統合とバッチ処理
スキャン、OCR認識プロセスと、その後の自動メール処理、自動命名機能をシームレスに組み合わせ、完全な自動化パイプラインを形成できます。また、フォルダ内に既に存在する、ユーザー定義条件に合致するすべてのPDFファイルを処理でき、過去のドキュメントのアーカイブ問題も簡単に解決します。
7. 後続操作の実行とインテリジェントな並べ替え
主要な操作の実行後に後続アクションをトリガーできます。例えば、保存されたPDFファイルまたはその添付ファイルのパスをパラメータとして、他のアプリケーションを自動起動します。ソフトウェアはPDFファイルを自動的に並べ替えたり、ファイル属性に基づいて動的に作成された別のフォルダ構造に移動したりすることもできます。
まとめ
総じて、Automatic PDF Processorは企業向けアプリケーションと効率的なオフィスシーンに適したプロフェッショナルツールです。高度にカスタマイズ可能な自動化ルールにより、ユーザーを反復的で煩雑なPDFファイル操作(印刷、リネーム、分類、データ抽出など)から完全に解放します。その核心的価値は、PDFドキュメント処理フローの標準化、構造化、無人化を実現することにあり、大量の請求書、レポート、スキャンドキュメントを処理する必要がある財務、行政、法務などの部門に適しています。PDFドキュメントの管理効率と正確性を向上させる方法をお探しなら、この自動プロセッサは間違いなく強力な候補です。
関連コース











